Ассоциативный эксперимент: как проводят и обрабатывают
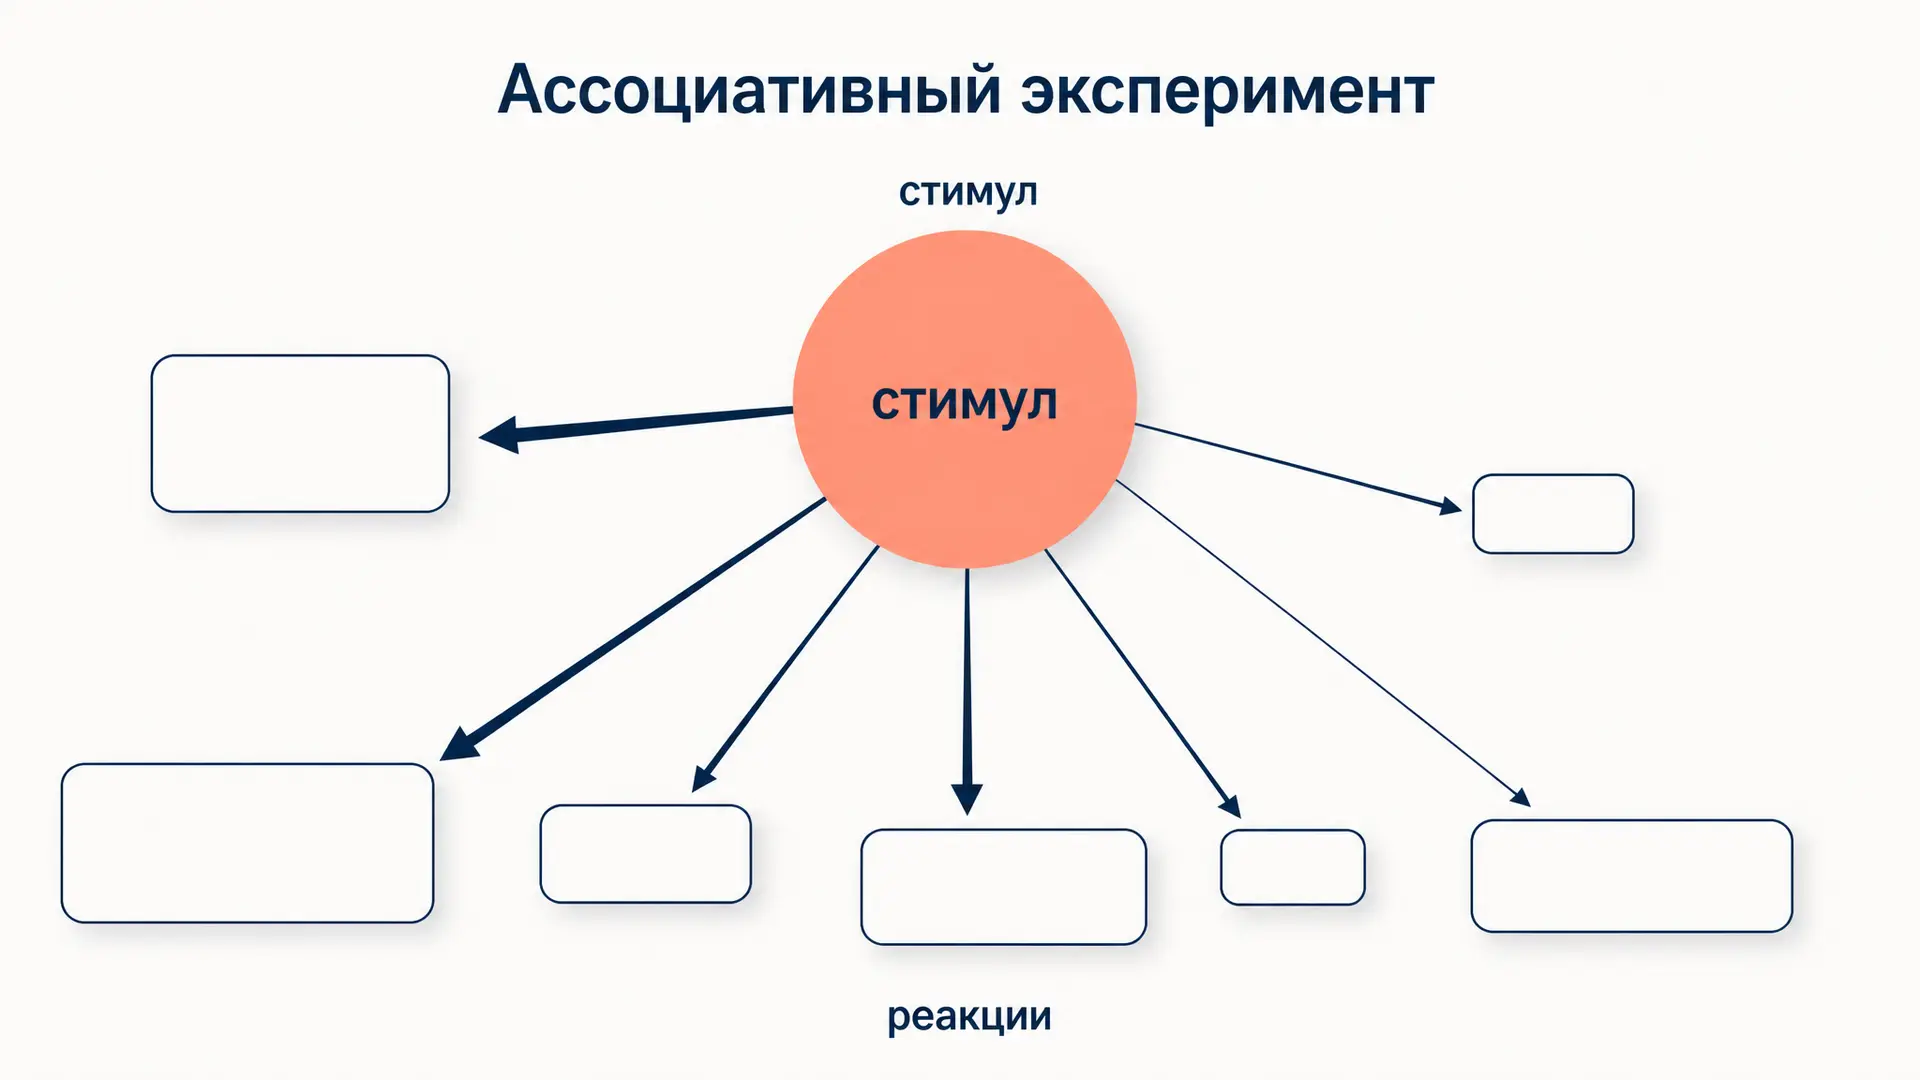
По технике ассоциативный эксперимент самый простой метод психолингвистики, а по обработке самый неудобный: испытуемому дают слово-стимул, он отвечает первым пришедшим в голову словом, и через полчаса у исследователя лежит стопка анкет, с которой непонятно что делать. Курсовые по этой теме разваливаются обычно не на сборе данных, а на этапе, где сырые реакции нужно превратить в ассоциативное поле, посчитать частоты и сказать что-то содержательное о языковом сознании. Ниже разберём, как устроен метод, чем различаются его виды, как считаются индексы и какие выводы из них корректны. Помощник под этим абзацем соберёт запрос под ваш набор стимулов и способ обработки.
Что такое ассоциативный эксперимент
Ассоциативный эксперимент это методика, при которой испытуемому предъявляют слово-стимул и фиксируют словесную реакцию , возникшую первой. Единица данных здесь пара «стимул, реакция», а материалом исследования становится не отдельный ответ, а распределение реакций по всей выборке.
Метод старше самой психолингвистики. Технику словесных ассоциаций описал Фрэнсис Гальтон в 1879 году, в лабораторную практику её ввёл Вильгельм Вундт, а клиническое применение нашёл Карл Юнг, искавший по задержкам ответа эмоционально нагруженные комплексы. В языкознание метод пришёл в середине XX века: сначала списки Кента и Розанова с ассоциативными нормами для английского, затем «Словарь ассоциативных норм русского языка» под редакцией А. А. Леонтьева (1977) и «Русский ассоциативный словарь» Ю. Н. Караулова с соавторами.
Ключевая идея: реакция не случайна. Она отражает связи, реально закреплённые в языковом сознании носителя: сочетаемость, оценку, культурный фон. Поэтому по массиву реакций судят не о личности отвечающего, а о структуре значения слова в коллективном сознании.
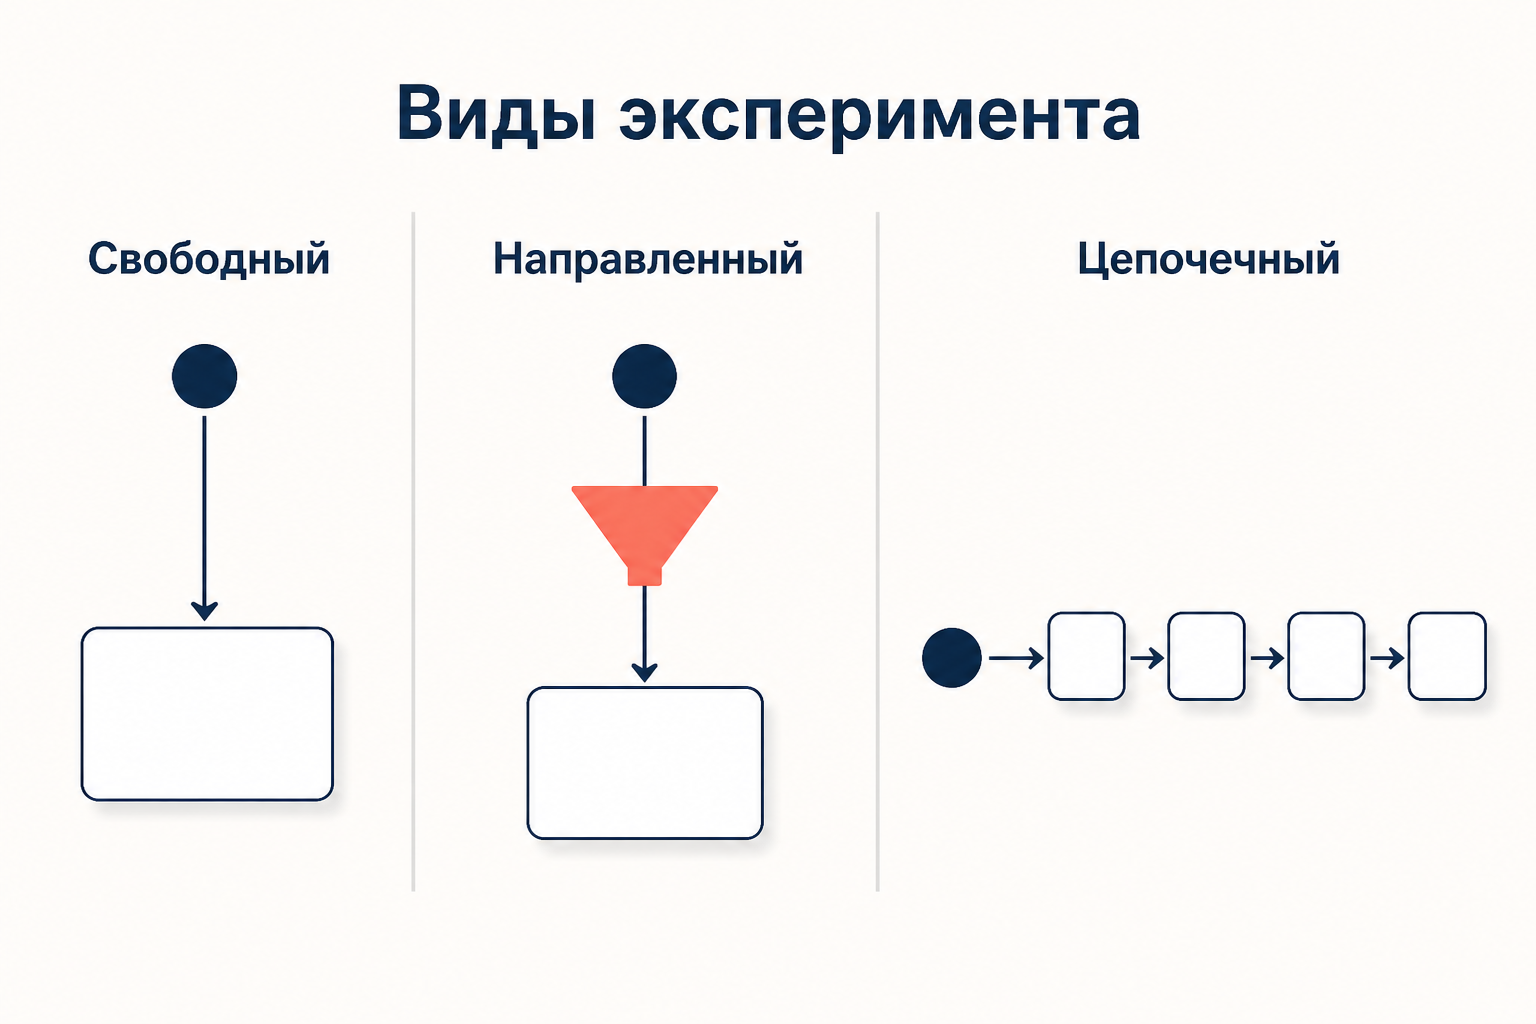
Три вида эксперимента
Свободный. Инструкция минимальна: ответьте первым словом, которое придёт в голову. Ограничений на часть речи и тип связи нет. Даёт самую широкую картину значения, но и самый шумный материал.
Направленный. Реакция ограничена условием: ответить прилагательным, назвать антоним, назвать целое к части. Поле сужается, зато ответы разных испытуемых сопоставимы и пригодны для проверки узкой гипотезы.
Цепочечный. Испытуемый выдаёт не одно слово, а серию: пять-десять реакций за фиксированное время, обычно одну-три минуты. Такой вариант показывает, как ассоциации постепенно уходят от стимула, и позволяет оценить продуктивность.
Отдельно стоит вариант с хронометражем: фиксируется латентное время реакции в миллисекундах. Затянутый ответ традиционно трактуют как признак смыслового конфликта или слабой освоенности слова, но измерить его можно только в индивидуальной компьютерной процедуре, в письменном групповом опросе времени нет.
Как провести: стимулы, инструкция, выборка
Порядок работы такой:
- Составить список стимулов. Обычно 20-100 слов: целевые стимулы, которые изучаются, и слова-филлеры, маскирующие тему исследования. Стимулы берут одной части речи и сопоставимой частотности, иначе различия полей объяснятся не смыслом, а употребительностью слов.
- Написать инструкцию. Она задаёт вид эксперимента и обязательно требует отвечать быстро и не редактировать ответ.
- Набрать выборку. Для учебной работы хватает 50-100 информантов на стимул, для устойчивого ядра поля нужно 300-500. Фиксируйте пол, возраст, родной язык и специальность: без паспорта выборки сопоставлять группы не с чем.
- Провести и очистить данные. Убираются пропуски, ответы не на том языке, повторы самого стимула. Реакции лемматизируются, то есть приводятся к начальной форме, иначе «книга», «книги» и «книгу» разойдутся по разным строкам.
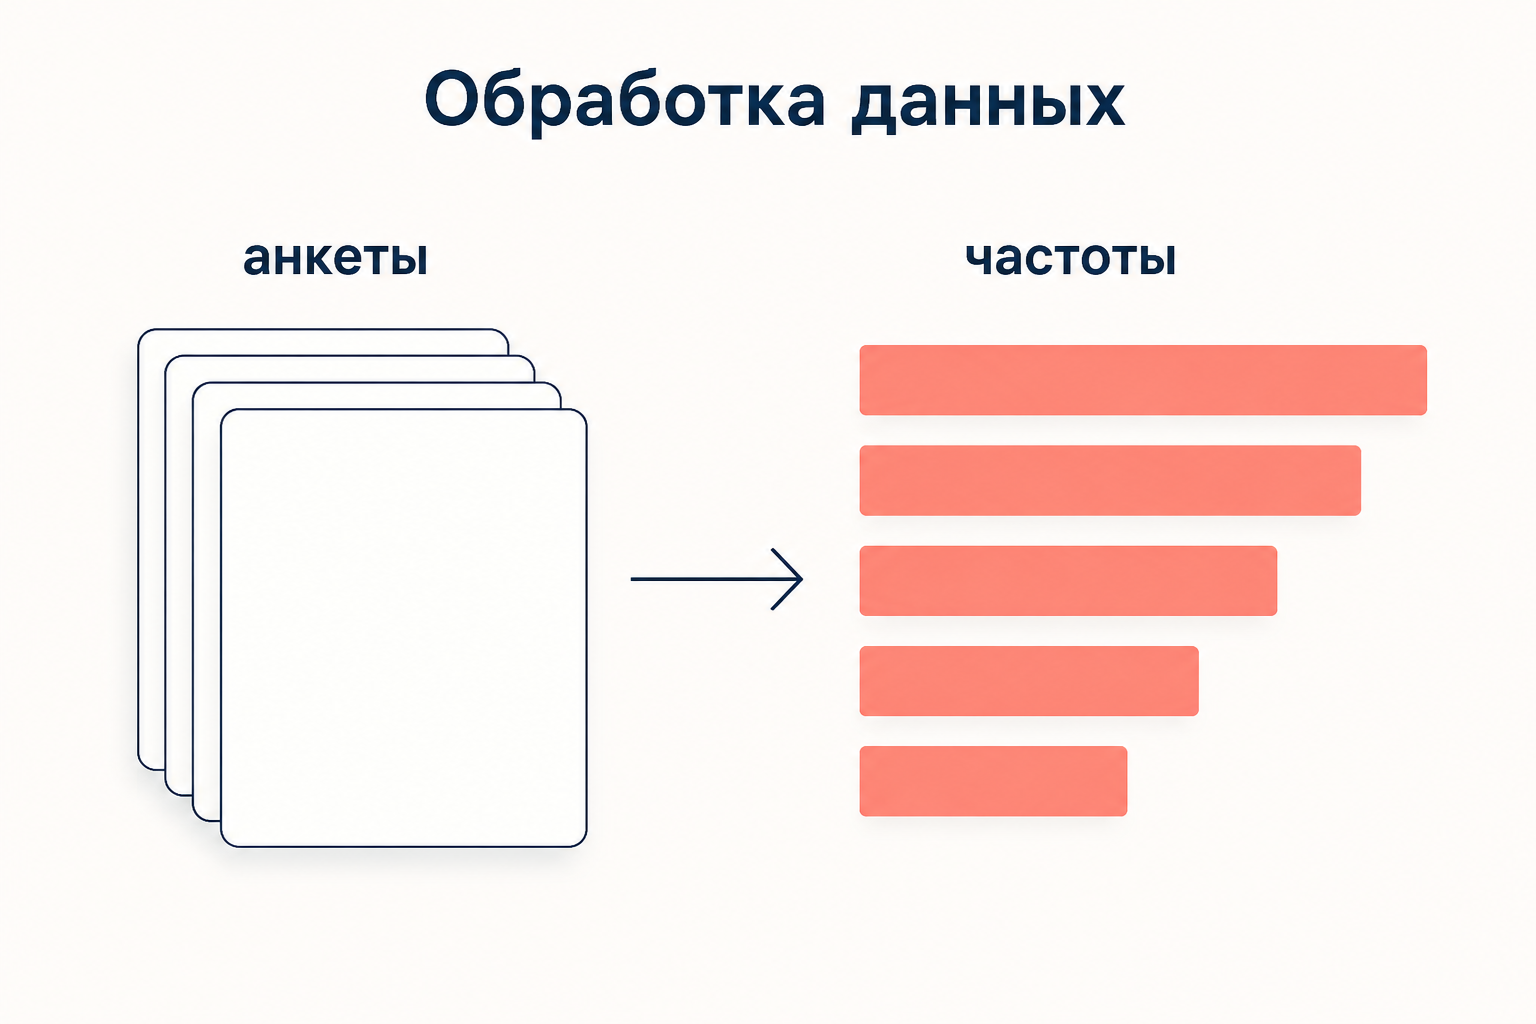
- Свести реакции в частотный список.
Рандомизируйте порядок стимулов и не ставьте рядом близкие по смыслу слова: предыдущий стимул подсказывает реакцию на следующий, и поле оказывается смещённым.
Ассоциативное поле: ядро и периферия
Все реакции на один стимул образуют ассоциативное поле, то есть упорядоченный по убыванию частоты список ответов. У него отчётливая структура: несколько высокочастотных реакций составляют ядро, а длинный хвост единичных ответов образует периферию, на которую нередко приходится половина и больше всех разных реакций.
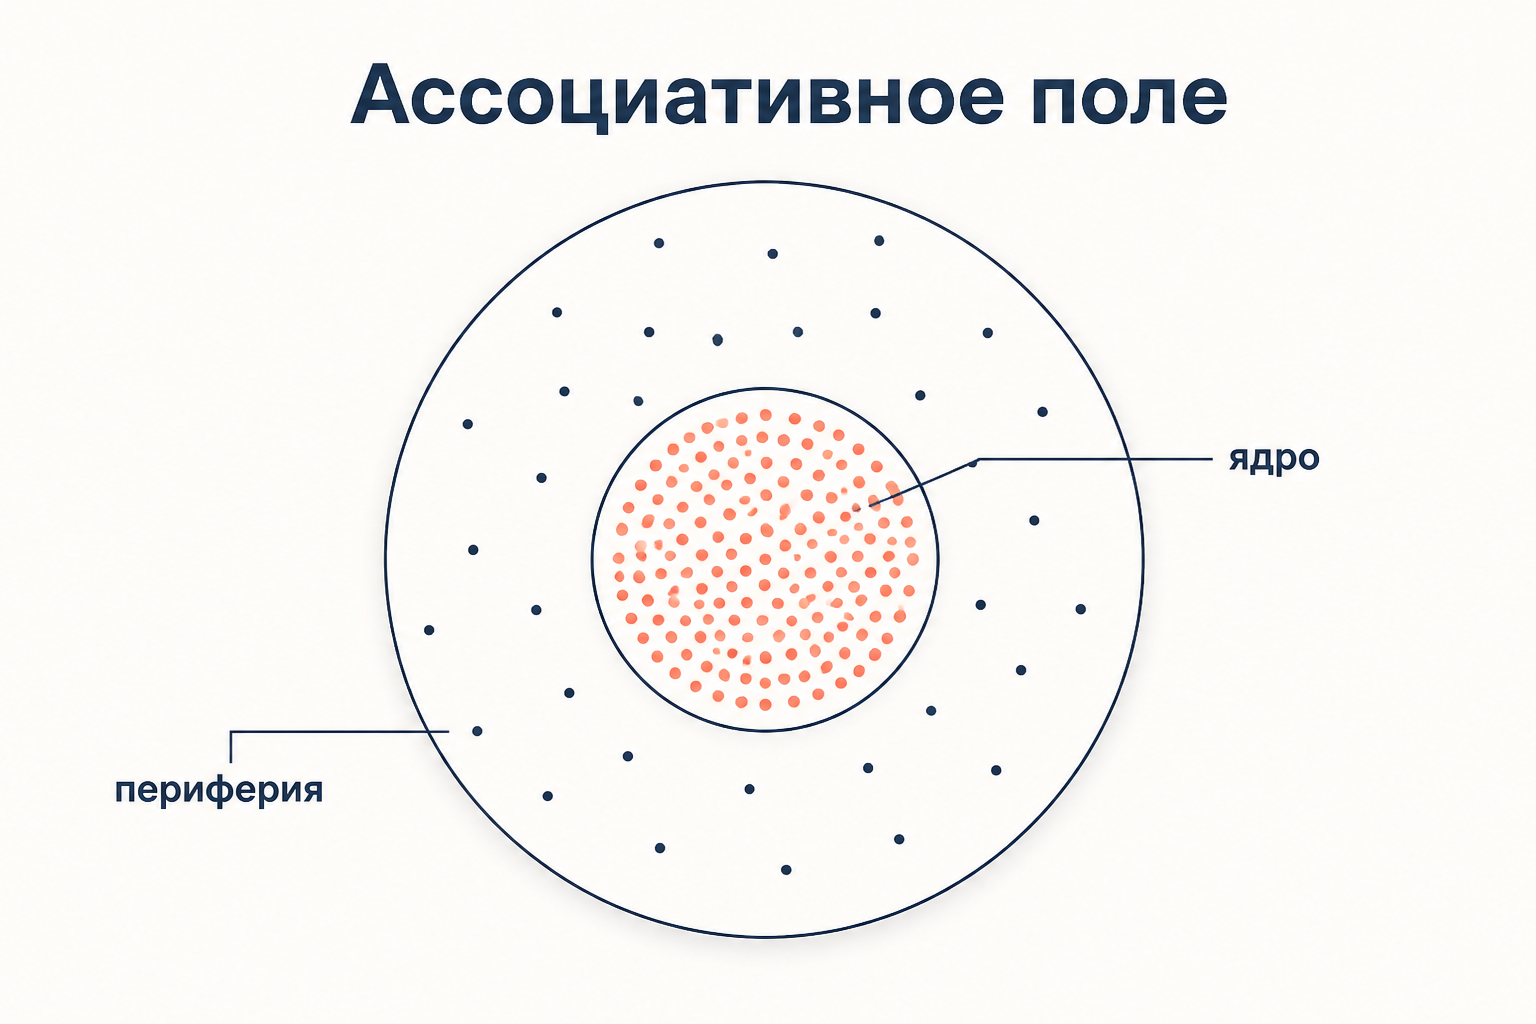
Ядро воспроизводимо и устойчиво, именно оно сопоставляется между группами и языками. Периферия остаётся зоной индивидуального опыта: отдельную единичную реакцию интерпретировать нельзя, она значима только в общей массе. Логика та же, что у семантического поля, но границы здесь задаёт не исследователь, а статистика ответов.
Обработка результатов и индексы
Обозначим через общее число реакций на стимул, через число разных реакций, через частоту -й реакции и через частоту самой частой из них. Базовые показатели считаются так:
- задаёт относительную частоту реакции, её вес в поле;
- называют индексом стереотипности, это доля самого частого ответа. Высокий означает жёсткую клишированную связь, низкий говорит о размытом значении;
- служит индексом разнообразия, рядом с ним обычно приводят долю единичных реакций.
Небольшой пример. На стимул «время» получено реакций, из них разных, самая частая реакция «деньги» встретилась раз. Тогда индекс стереотипности , а индекс разнообразия . Читается это так: ни один ответ не собирает даже шестой части реакций, зато больше половины ответов уникальны, то есть значение стимула размыто и сильно зависит от личного опыта. У стимулов с жёсткой сочетаемостью картина обратная: одна реакция забирает треть поля и выше. Именно такие пары чисел, а не пересказ списка реакций, составляют содержание аналитической части курсовой.
Обобщённо неопределённость поля описывает энтропия распределения реакций:
Чем выше , тем менее предсказуема реакция на стимул. Чтобы сравнить две группы информантов, например филологов и инженеров, считают пересечение ядер: долю общих реакций среди первых позиций каждого поля.
Дальше идёт качественная классификация реакций:
- парадигматические, того же класса, что стимул: синонимы, антонимы, гипонимы (день → ночь, стол → стул);
- синтагматические, продолжающие словосочетание (день → рабочий, стол → накрыт);
- тематические, из общей ситуации или известного текста (стол → гости).
Доля парадигматических реакций растёт с возрастом и уровнем образования: это классический показатель в исследованиях детской речи.
Словари, базы и применение
Готовые нормы избавляют от собственного сбора данных. Для русского это «Русский ассоциативный словарь» примерно на 7000 стимулов и миллион реакций и база СИБАС по сибирскому региону, для английского это Edinburgh Associative Thesaurus. В таких изданиях обычно есть и обратный словарь: от реакции к стимулам, которые её вызывают.
Готовый словарь и собственный сбор материала решают разные задачи. Словарь показывает норму, зафиксированную на своей выборке и в своё десятилетие, поэтому его данные не отменяют собственного эксперимента, а служат точкой отсчёта: собственное поле сравнивают со словарным и обсуждают именно расхождение ядер. Ссылаться при этом нужно на конкретное издание и год, а не на «данные РАС» вообще.
Результаты ассоциативного эксперимента используют, чтобы описать значение слова изнутри, сопоставить языковые картины мира двух культур, отследить сдвиг значения во времени, проверить понятность термина или коммерческого названия. Полученные связи полезно перепроверять по текстам: синтагматическая реакция почти всегда подтверждается коллокациями, которые изучает корпусная лингвистика.
Частые ошибки
- Интерпретация единичных реакций. Один ответ остаётся шумом, а не фактом о языковом сознании группы.
- Отсутствие паспорта выборки. Без данных о поле, возрасте и специальности информантов сопоставление групп ничем не обосновано.
- Сравнение полей разного объёма без нормировки. Сравнивают доли , а не сырые частоты .
- Нелемматизированные реакции. Одно слово дробится на словоформы, и ядро поля искусственно занижается.
- Подсказывающая инструкция. Формулировка вроде «какие чувства вызывает это слово» незаметно превращает свободный эксперимент в направленный.
FAQ
Сколько нужно испытуемых? Для курсовой достаточно 50-100 информантов на стимул: этого хватает, чтобы ядро поля стабилизировалось. Для выводов о языковом сознании целой группы берут 300-500. Важнее не сам объём, а однородность выборки по возрасту и специальности.
Чем ассоциативный эксперимент отличается от семантического дифференциала? Здесь испытуемый сам порождает слово, то есть отвечает свободно, а в семантическом дифференциале он оценивает стимул по заданным шкалам. Первый метод даёт содержание значения, второй показывает его оценочные координаты.
Можно ли проводить эксперимент онлайн? Да, онлайн-форма с таймером на вопрос вполне рабочая, и она же позволяет фиксировать время реакции. Минус в том, что невозможно проконтролировать, действительно ли информант отвечал не задумываясь.
Коротко
Ассоциативный эксперимент даёт распределение реакций на слово-стимул: свободный вариант показывает широкую картину значения, направленный проверяет узкую гипотезу, цепочечный оценивает продуктивность. Реакции лемматизируют, сводят в частотное ассоциативное поле и делят на ядро и периферию, а затем описывают числами: относительные частоты, индекс стереотипности , разнообразие, энтропию, доли парадигматических и синтагматических ответов. Выводы делают по ядру и по долям, а не по отдельным единичным реакциям.
Читайте также
Психолингвистика: предмет, методы и разделы
Психолингвистика: что она изучает, чем предмет отличается от объекта, как наука возникла в 1953 году, из каких разделов состоит, какими методами работает и что дала школа Леонтьева.
Комплекс по Юнгу: как работает автономное содержание психики
Комплекс по Юнгу это эмоционально окрашенная группа представлений, которая может автономно влиять на мысли и поступки. Разбираем ядро, архетипы и примеры.
Предложения садовой дорожки: как работает переанализ
Предложения садовой дорожки: разбор примера The horse raced past the barn fell, синтаксическая неоднозначность, поздняя привязка, минимальное присоединение и айтрекинг.
Гипотеза критического периода: язык, возраст и мозг
Гипотеза критического периода Леннеберга: что она утверждает о первом и втором языке, случай Джини, глухие дети, данные Джонсон и Ньюпорт и Хартсхорна, критика и выводы для обучения.
Компонент N400: смысл, ожидание и мозговой ответ
Компонент N400: опыт Кутаса и Хиллиард 1980 года, cloze-вероятность, семантическое ожидание, различие N400 и P600 и применение в психолингвистике для учебного эксперимента.
Порождение речи: модели от Выготского до Левелта
Разбор моделей порождения речевого высказывания: стохастические и трансформационные схемы, уровневые модели Выготского и Лурии, модель Левелта, лемма и лексема, оговорки как эмпирика.