Компонент N400: смысл, ожидание и мозговой ответ
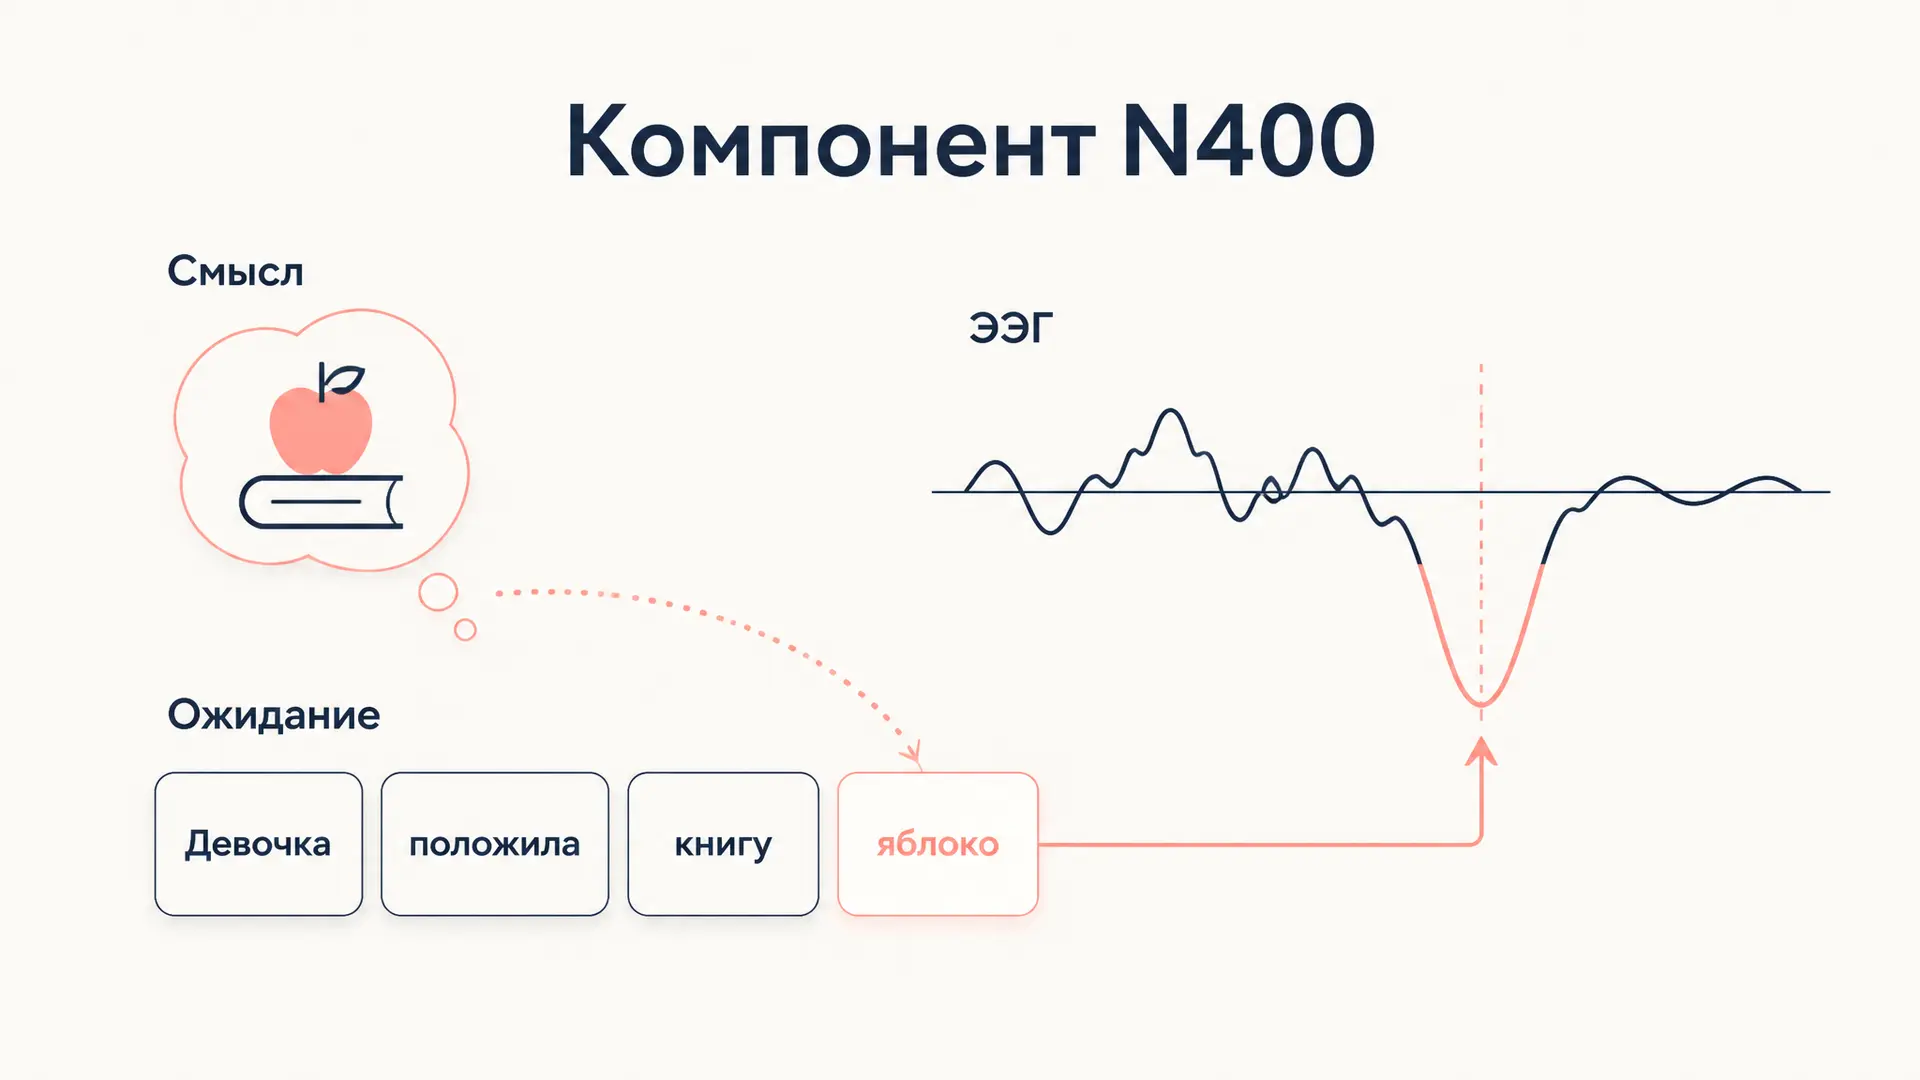
Когда человек читает фразу «Он намазал хлеб тёплыми…», слово «носками» не нарушает грамматику, но вызывает странное ощущение. В электроэнцефалограмме такая семантическая неожиданность часто сопровождается отрицательным отклонением с максимумом примерно через 400 мс после появления слова. Его называют компонентом N400. Это не «центр понимания смысла» и не диагноз по одной волне, а статистический эффект усреднённого ответа мозга на множество проб.
Ниже разберём, как N400 открыли Марта Кутас и Стивен Хиллиард, что измеряет cloze-вероятность, почему ожидаемое слово даёт меньшую негативность, чем неожиданное, и чем осторожно следует отделять N400 от более позднего P600. Для разбора собственной экспериментальной постановки соберите запрос в форме ниже.
Что именно называют N400
ERP (event-related potential, вызванный потенциал) получают, усредняя участки ЭЭГ, синхронизированные с началом стимула. Буква N означает отрицательную полярность, число 400 - примерное время пика в миллисекундах. Это название описывает форму и временное окно, а не отдельный анатомический орган. Полярность зависит от того, какая электродная схема и референт использованы, поэтому сравнивают прежде всего разность условий, а не абсолютную высоту одной записи.
В типичном языковом опыте критическим стимулом бывает слово. Его сравнивают с другим словом в том же месте фразы: «Он намазал хлеб маслом» против «Он намазал хлеб носом». Если вторая версия вызывает более выраженную негативность в окне около 300–500 мс, говорят об усилении N400. В зрительном чтении эффект обычно распределён широко над центрально-теменными областями, часто с заметным вкладом левой стороны; точная топография меняется с модальностью, возрастом и задачей.
Опыт Кутаса и Хиллиард 1980 года
В статье Kutas и Hillyard в Science испытуемые молча читали предложения, предъявленные по одному слову. В четверти предложений последнее слово было семантически неуместным, но оставалось грамматически правильным. В отдельных пробах слово делали физически необычным, например крупнее обычного, чтобы развести смысловую и зрительную неожиданность.
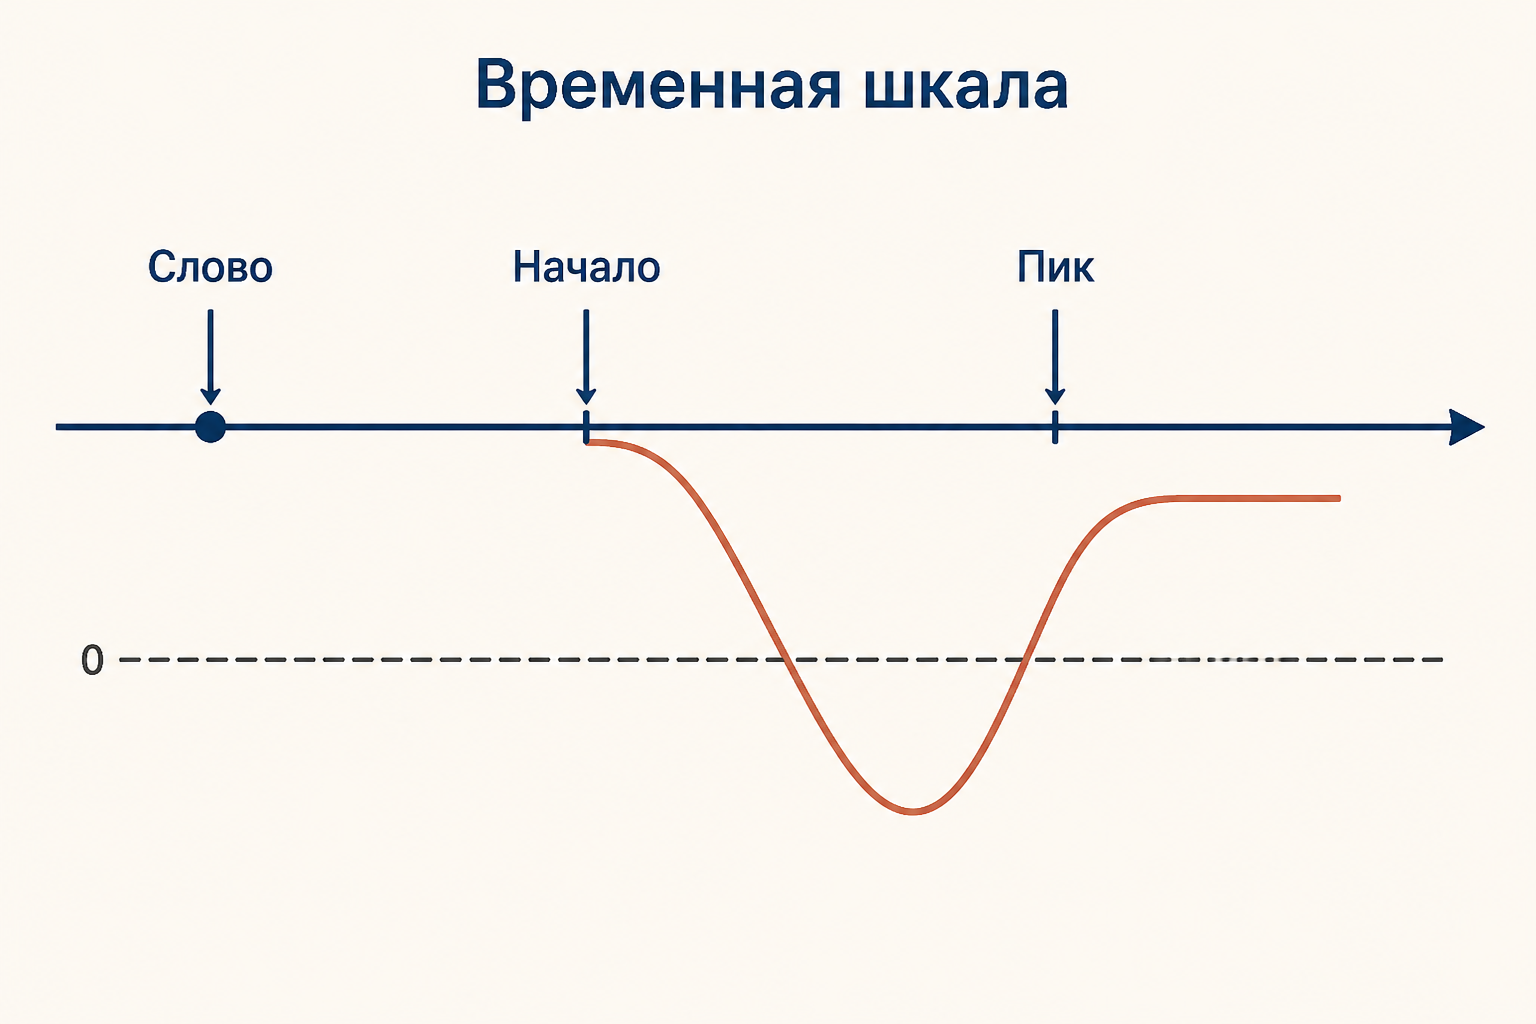
Семантически неуместные окончания сопровождались негативной волной: она начиналась примерно через 250 мс и достигала пика около 400 мс. Физически необычные слова давали иной поздний положительный комплекс, который авторы обозначали как P560. Это было важное наблюдение: мозговой ответ на «не подходит по смыслу» не сводится к общей реакции на редкий или крупный стимул. Позднее окно стало стандартом N400, хотя его границы в современных работах задают по дизайну и предварительной регистрации, а не по одному магическому числу.
Семантическое ожидание и cloze-вероятность
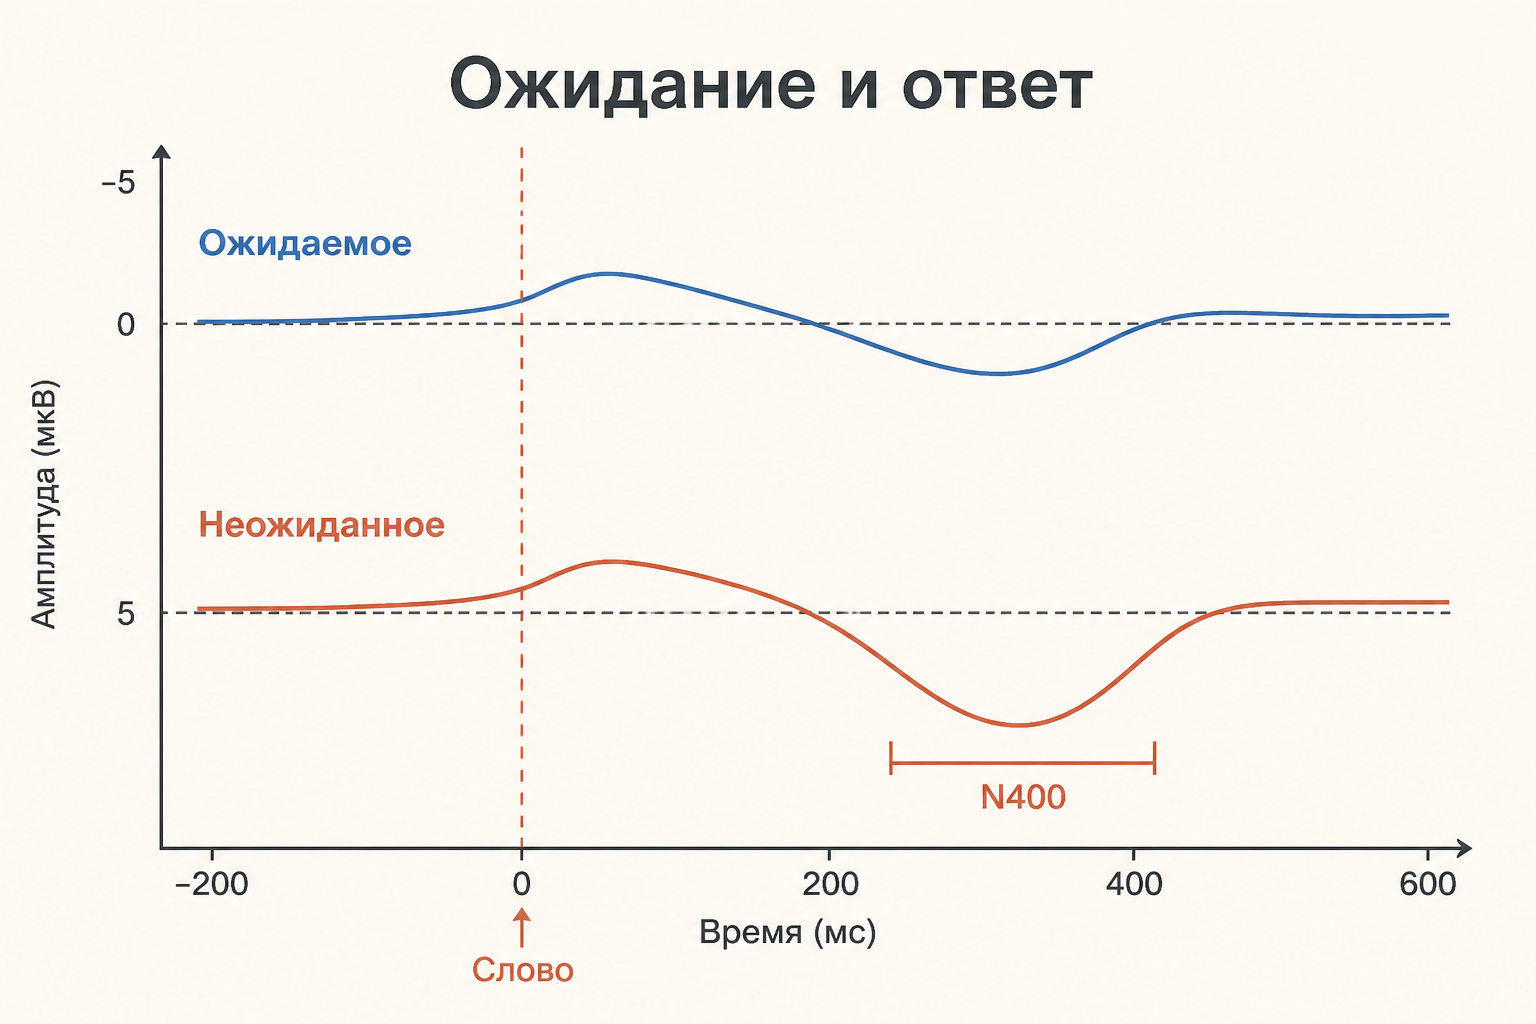
Cloze-вероятность - доля участников, которые вставляют данное слово в пропуск после предъявления фрагмента. Для «Он намазал хлеб тёплым…» слово «маслом» может иметь высокую cloze-вероятность, а «камнем» - низкую. Важен не только факт нарушения нормы: мозг заранее распределяет активацию между возможными продолжениями.
В среднем чем выше cloze-вероятность слова, тем меньше амплитуда N400, то есть тем менее отрицательным оказывается ответ. Низкая вероятность часто сопровождается большим N400. Это не означает, что компонент просто равен субъективной неожиданности: на него влияют частотность слова, ассоциации, повторение, модальность, задача и свойства контекста. Поэтому cloze-оценку собирают отдельно на независимой выборке, а стимулы уравнивают по длине и частотности.
Полезно различать сильный и слабый контекст. В сильном контексте одно продолжение почти неизбежно, в слабом подходят несколько слов. Два контекста могут давать одинаковую вероятность конкретного ответа, но различаться числом активированных смысловых кандидатов. Это позволяет проверять, отражает ли N400 только вероятность встретить слово или ещё и структуру активированного семантического пространства.
Доступ к значению или интеграция
Главный спор касается того, какой процесс ближе всего к источнику N400. Одна влиятельная линия связывает его с извлечением лексико-концептуальной информации из долговременной памяти: контекст заранее частично активирует признаки слова, и ожидаемое слово достаётся легче. В этой логике слово может вызвать N400 даже вне полноценного предложения - например, в семантическом прайминге, когда перед целью появляется связанный прайм.
Другая линия говорит о последующей интеграции: мозг сопоставляет значение слова с текущей моделью фразы и дискурса. Проблема в том, что доступ и интеграция идут быстро и частично перекрываются; один ERP-компонент не обязан соответствовать одному этапу обработки. Поэтому корректнее писать, что N400 чувствителен к лёгкости доступа к смыслу и к его согласованию с контекстом, а не объявлять его прямым измерителем единственной операции.
Это особенно ясно в дискурсе и при обучении новым словам. Слово может быть формально редким, но хорошо поддержанным контекстом; наоборот, знакомое слово иногда не вписывается в модель ситуации. В работе с N400 нужно описывать, какую именно переменную манипулировали: вероятность продолжения, семантическую связанность, правдоподобие мира или доступность лексикона.
N400 и P600: не простая пара «семантика против синтаксиса»
P600 - поздняя положительная волна, часто анализируемая примерно от 500 до 900 мс. Её первоначально связывали с синтаксическим нарушением и повторным анализом: например, с предложением, которое сначала разбирается одним способом, а затем требует перестройки. N400 появляется раньше и чаще реагирует на лексико-семантическое ожидание.
Но жёсткая формула «N400 - смысл, P600 - грамматика» слишком груба. Семантически аномальные предложения иногда вызывают P600, а грамматические манипуляции могут менять N400. Современные модели рассматривают P600 как возможный маркер более поздней интеграции, пересмотра или обновления интерпретации, а N400 - как более ранний доступ к концептуальным знаниям. Обзор Brouwer и коллег прямо показывает, что функциональные границы компонентов остаются дискуссионными.
Практическое различение строится не по названию, а по дизайну. Меняют семантическую связанность, оставляя синтаксис и физические свойства одинаковыми, - проверяют N400. Меняют структуру или создают необходимость повторного разбора, контролируя смысл, - проверяют P600. Если возникают обе волны, их анализируют раздельно по времени, топографии и взаимодействиям факторов.
Как поставить психолингвистический эксперимент
Сначала формулируют контраст: ожидаемое и неожиданное окончание, связанный и несвязанный прайм или слова с разной cloze-вероятностью. Затем предъявляют стимулы с одинаковым временем на экране и случайным порядком, записывают ЭЭГ и удаляют пробы с морганием и движением. После этого для каждого участника усредняют ответ в заранее выбранном окне, например 300–500 мс, и сравнивают условия статистической моделью с участниками и стимулами как случайными факторами.
Не следует подменять эффект N400 точностью классификатора или одной красивой кривой. Нужны независимые нормы cloze, контроль частотности, длины, позиции слова и количества повторений. Полезно добавить вопросы на понимание, но не превращать каждую пробу в тест: это меняет стратегию чтения. В прикладной психолингвистике N400 используют для изучения билингвизма, семантического прайминга, усвоения новых слов и нарушений понимания, включая афазию, однако интерпретацию всегда сопоставляют с поведенческими данными. Связь с имплицитной памятью помогает отделить автоматическую активацию от намеренного воспоминания.
Частые ошибки
- Считать 400 мс точной константой. Это ориентир пика, а не гарантия для любого языка, стимула и модальности.
- Называть N400 «ошибкой смысла». Компонент меняется и при нормальных, но менее ожидаемых словах, прайминге и повторении.
- Смешивать cloze и частотность. Частое слово может быть неожиданным в данном контексте; эти предикторы нужно контролировать отдельно.
- Разделять N400 и P600 только по полярности. Нужны временное окно, контраст и теория обработки, а не подпись на графике.
FAQ
N400 виден у каждого человека? Индивидуальные волны шумны. Обычно сравнивают усреднение по множеству проб и проверяют эффект на уровне участников и стимулов.
Большой N400 означает, что человек не понял слово? Нет. Он показывает изменение обработки в заданных условиях. Причиной может быть низкая ожидаемость, слабая связь с контекстом или трудный доступ к значению.
Можно ли по N400 читать мысли? Нет. Это групповой и вероятностный показатель, чувствительный к дизайну, артефактам и анализу. Он помогает сравнивать условия, но не расшифровывает содержание сознания отдельного человека.
Коротко
N400 - отрицательный ERP-компонент, обычно начинающийся около 250 мс и достигающий пика примерно к 400 мс после слова. Его усиливают низкая cloze-вероятность и трудный доступ к лексико-концептуальной информации, но сводить его к одной «ошибке смысла» нельзя. В отличие от более позднего P600, он раньше реагирует на семантическое ожидание; при этом оба компонента отражают перекрывающиеся процессы, поэтому выводы требуют строгого экспериментального контраста.
Читайте также
Гипонимия: гипероним, гипоним и согипонимы
Гипонимия в лексикологии: как различить гипероним и гипоним, построить родо-видовую иерархию и не спутать её с партонимией. Примеры для словаря и курсовой.
Предложения садовой дорожки: как работает переанализ
Предложения садовой дорожки: разбор примера The horse raced past the barn fell, синтаксическая неоднозначность, поздняя привязка, минимальное присоединение и айтрекинг.
Гипотеза критического периода: язык, возраст и мозг
Гипотеза критического периода Леннеберга: что она утверждает о первом и втором языке, случай Джини, глухие дети, данные Джонсон и Ньюпорт и Хартсхорна, критика и выводы для обучения.
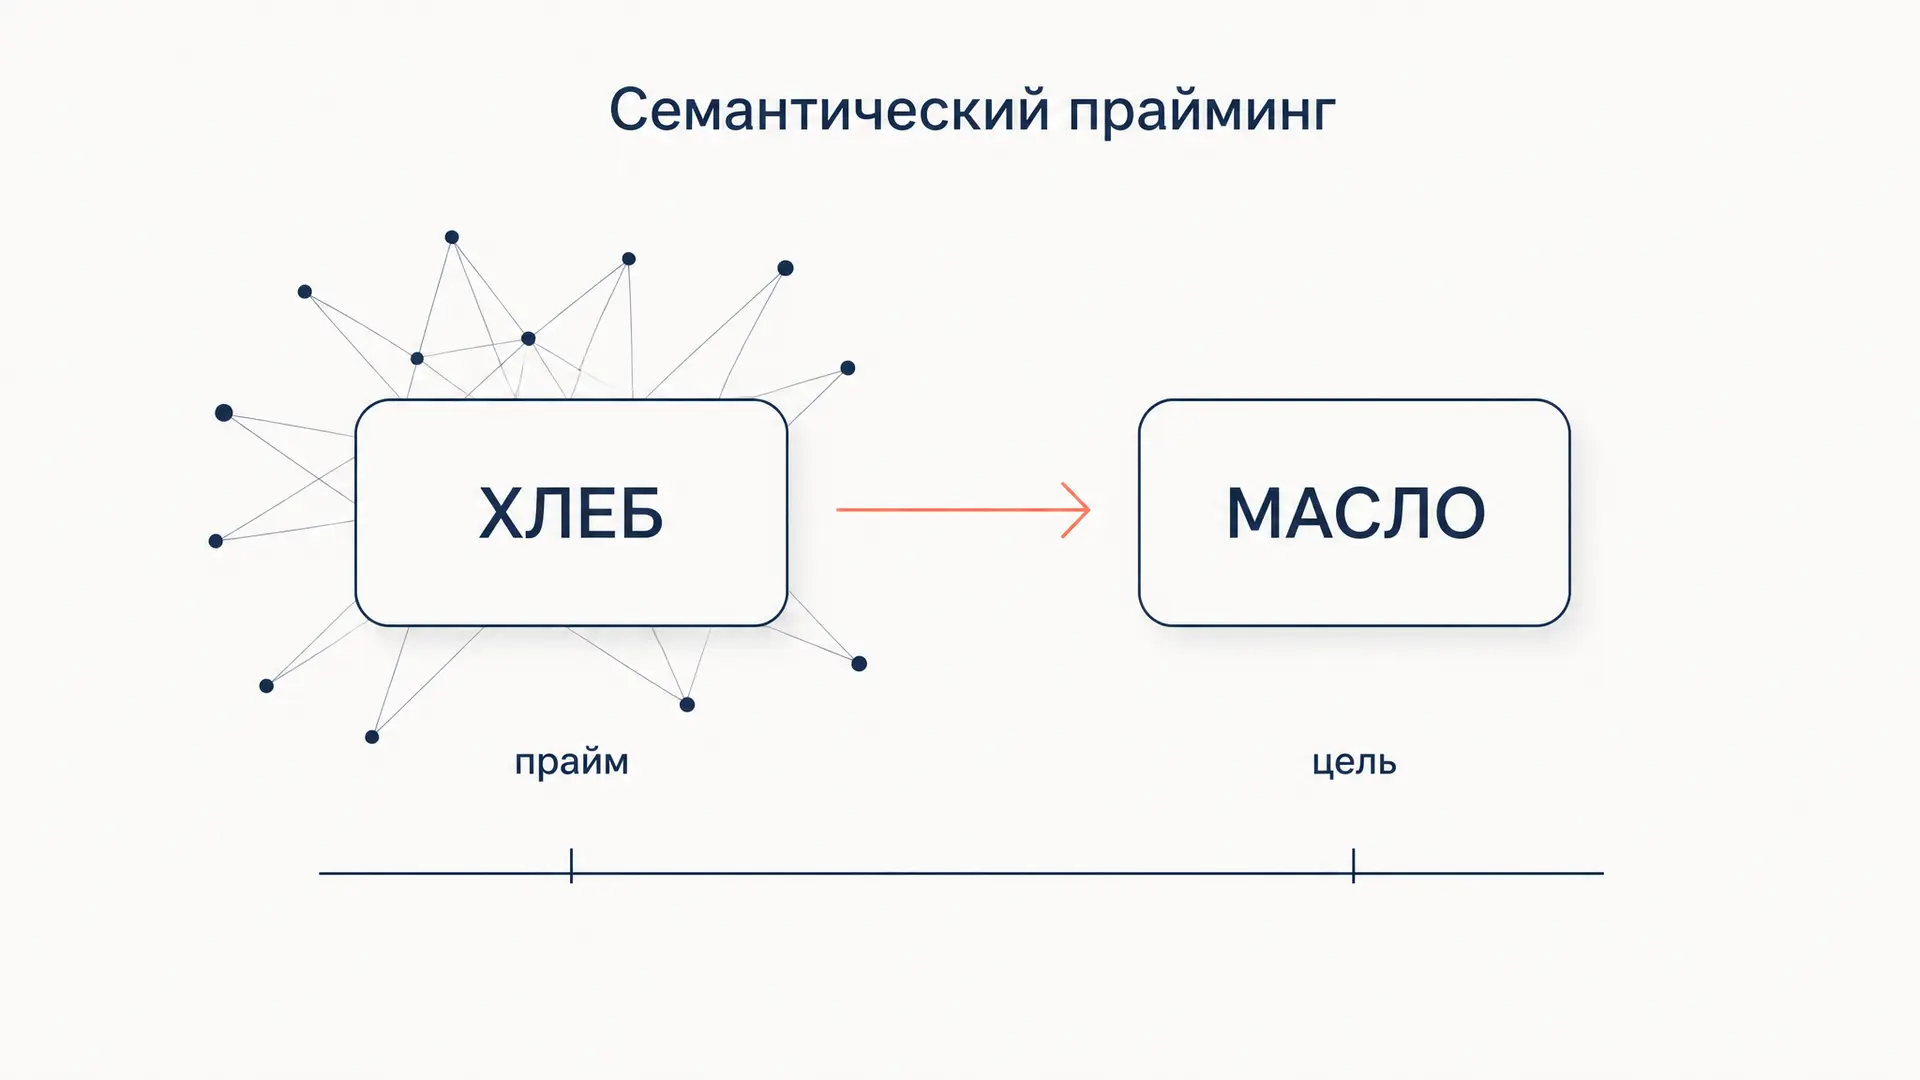
Семантический прайминг: эффект, SOA и механизмы
Семантический прайминг: опыт Мейера и Шваневельдта, задача лексического решения, роль SOA, автоматическая активация против стратегии, волна N400 и споры о воспроизводимости.
Условия истинности и значение: от Витгенштейна к Дэвидсону
Знать значение предложения значит знать условия его истинности: тезис раннего Витгенштейна, Т-схема Тарского и программа Дэвидсона, композициональность, семантика Монтегю, критика Даммита.
Порождение речи: модели от Выготского до Левелта
Разбор моделей порождения речевого высказывания: стохастические и трансформационные схемы, уровневые модели Выготского и Лурии, модель Левелта, лемма и лексема, оговорки как эмпирика.