Корпусная лингвистика: как изучают язык по корпусам
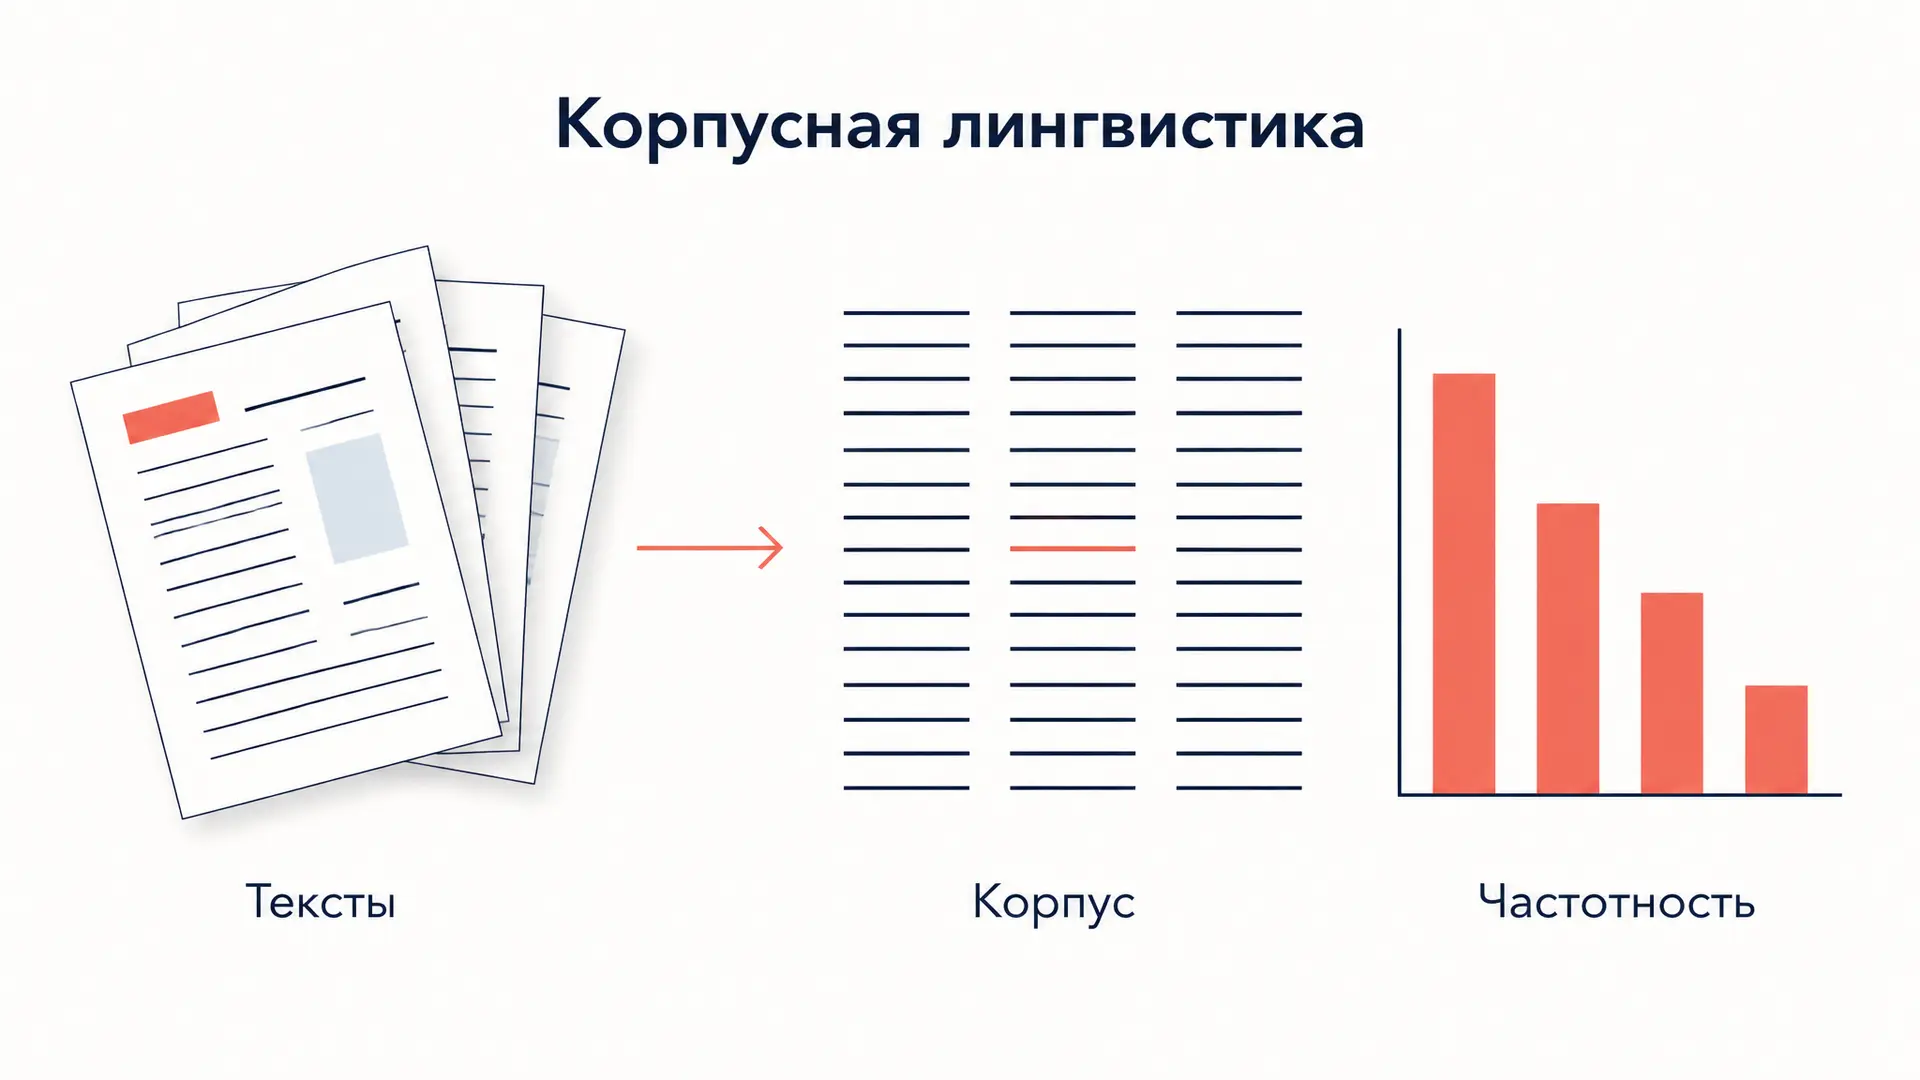
Корпусная лингвистика это раздел языкознания, который делает выводы о языке не из интуиции исследователя, а из больших собраний реальных текстов. Вместо вопроса «так можно сказать?» здесь задают вопрос «как часто и в каких контекстах так говорят?». Ответ дают три вещи: корпус, поисковый запрос и статистика по выдаче. Ниже разберём устройство корпуса, разметку, конкорданс и меры связи слов, а форма ниже соберёт точный запрос под вашу учебную задачу.
Что такое корпусная лингвистика
Корпус это не просто много текстов, а специально собранное и размеченное электронное собрание, предназначенное для лингвистического анализа. Корпусная лингвистика превращает такое собрание в источник проверяемых данных: любое утверждение о языке подкрепляется числом вхождений, распределением по жанрам и списком контекстов.
Отсчёт принято вести от Брауновского корпуса (1964), где впервые собрали миллион словоупотреблений американского английского по строгой схеме отбора. Дальше размеры росли: Британский национальный корпус это 100 миллионов слов, современные веб-корпуса измеряются миллиардами. Национальный корпус русского языка (НКРЯ) в основном подкорпусе превысил 300 миллионов словоупотреблений и включает отдельные устный, поэтический, диалектный и параллельный подкорпусы.
Внутри направления различают два подхода. Corpus-based проверяет на данных заранее сформулированную гипотезу: например, что вид глагола влияет на выбор союза. Corpus-driven, наоборот, идёт от данных: исследователь смотрит на частотные списки и устойчивые сочетания и уже из них выводит закономерность. В учебной работе чаще применяют первый подход, потому что он даёт понятную структуру рассуждения.
Как устроен корпус: репрезентативность и баланс
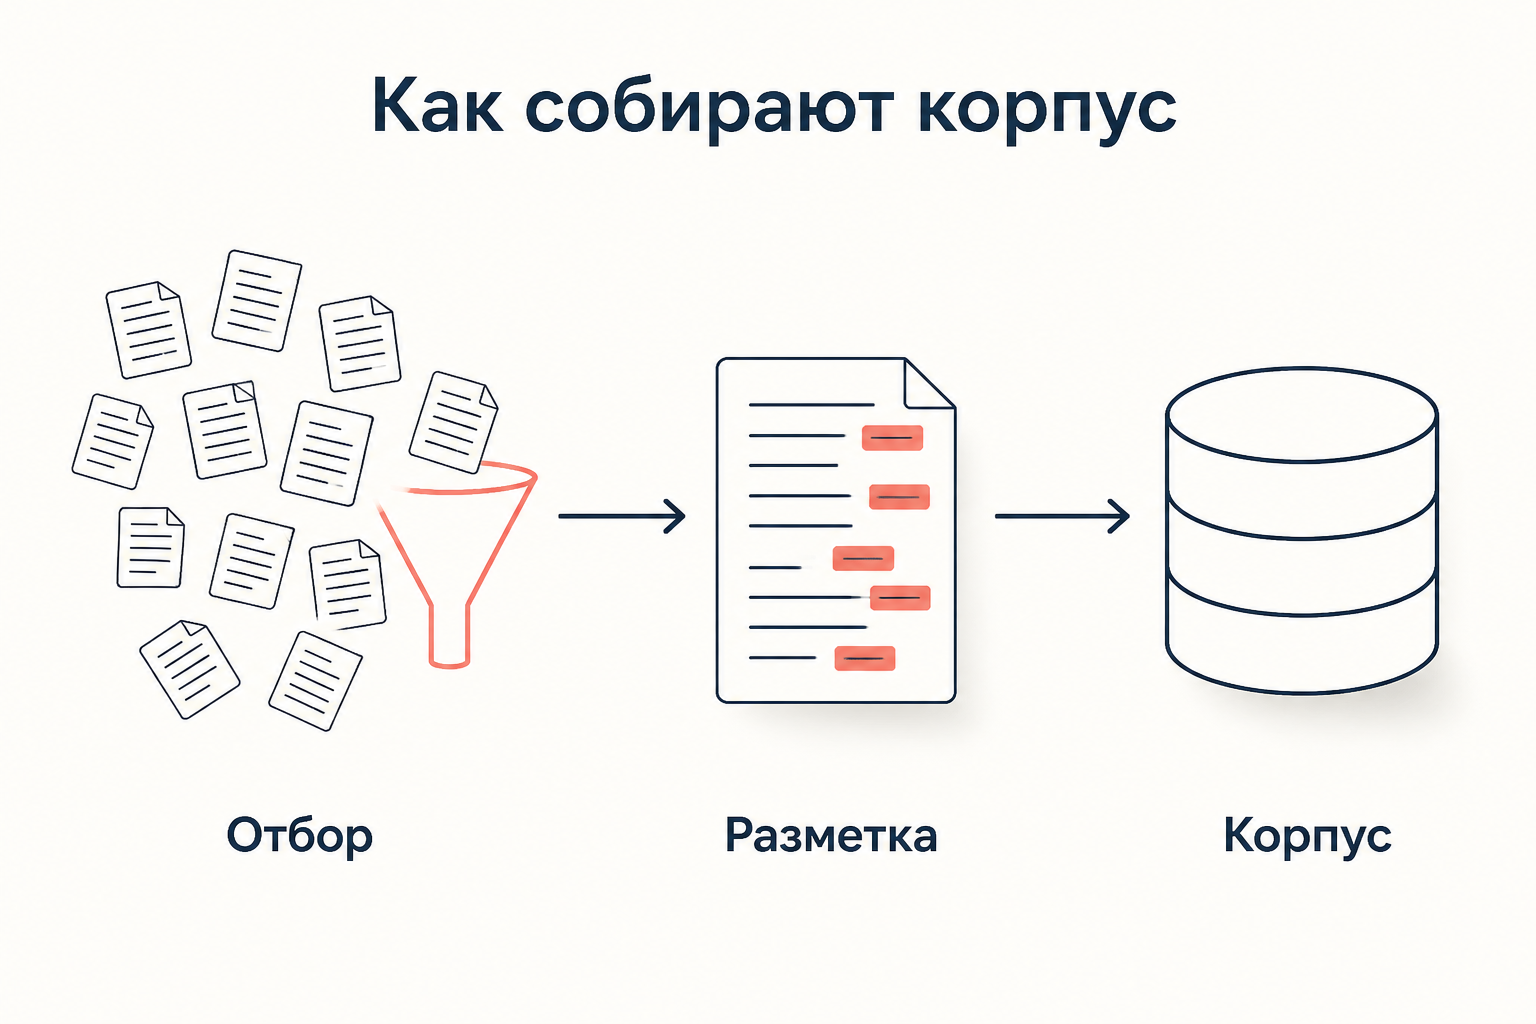
Ключевых свойств у корпуса три. Репрезентативность означает, что материал отражает ту разновидность языка, о которой делается вывод: по газетному подкорпусу нельзя судить о разговорной речи. Сбалансированность это заданные пропорции жанров и типов текста, а не случайная свалка того, что нашлось в сети. Размеченность означает, что к каждому тексту приписаны метаданные (автор, год, жанр, сфера функционирования), а к каждому слову лингвистические признаки.
По устройству корпуса делят на письменные и устные, синхронные и диахронические (следят за изменением языка во времени), одноязычные и параллельные (тексты с выровненными переводами), общие и специализированные. Отдельный класс это учебные корпуса (learner corpora) с текстами изучающих язык: по ним исследуют типичные ошибки.
Объём корпуса измеряют в токенах, то есть словоупотреблениях, а не в уникальных словах. Уникальные единицы называют типами, и их отношение к токенам (type-token ratio) служит грубой мерой лексического разнообразия текста.
Разметка корпуса: токены, леммы, части речи
Разметка это то, что отличает корпус от коллекции файлов. Первый уровень это токенизация: текст разбивается на единицы, а сложные случаи вроде «из-за», «т. е.», «5 кг» решаются правилами. Второй уровень это лемматизация: словоформам «читал», «читаю», «читающий» приписывается лемма читать, благодаря чему поиск по лемме находит все формы сразу.
Третий уровень это морфологическая разметка, или POS-tagging: каждому токену приписывается часть речи и грамматические признаки (падеж, число, вид, время). Для русского это делают анализаторы вроде mystem, pymorphy или UDPipe. Проблема омонимии здесь принципиальна: форма «стали» это и глагол, и существительное. Если корпус снял омонимию вручную или статистически, говорят о снятой омонимии, и такой подкорпус точнее, но обычно меньше.
Выше идут синтаксическая разметка (корпус с деревьями зависимостей называют трибанком), семантическая, а также разметка ошибок и просодии в устных корпусах. Чем богаче разметка, тем более тонкие запросы можно построить: например, найти все случаи, где творительный падеж зависит именно от краткого причастия.
Конкорданс и KWIC: главный инструмент
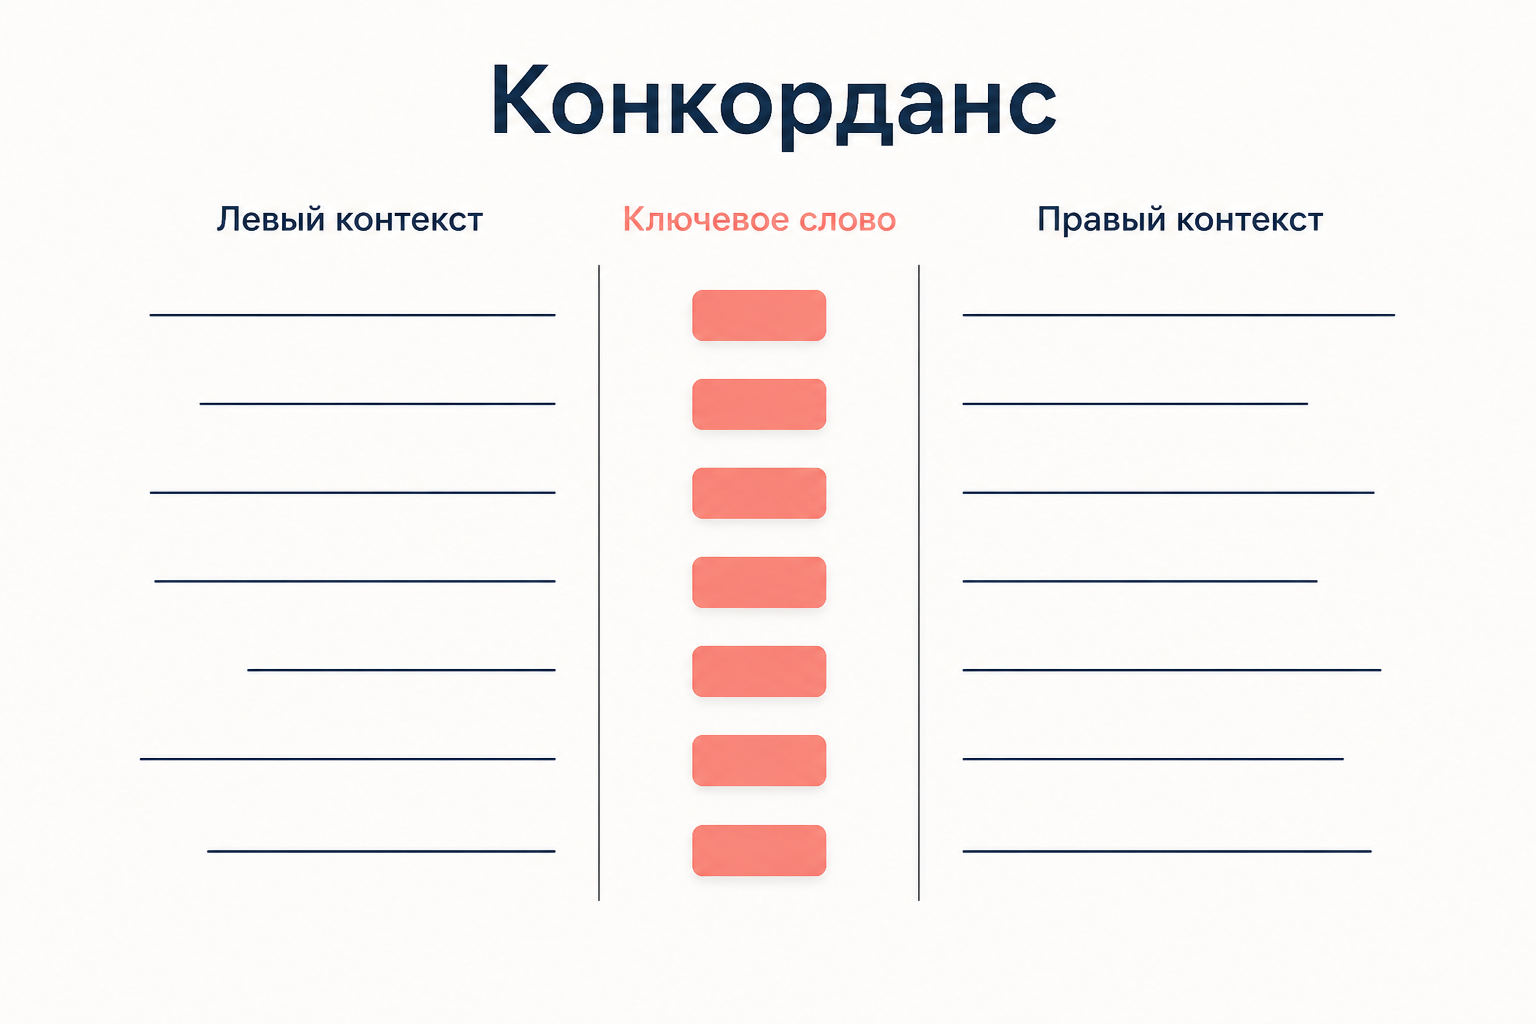
Основная форма выдачи корпусного поиска это конкорданс, список всех вхождений искомой единицы вместе с окружением. Стандартный формат называют KWIC (key word in context): ключевое слово выровнено по центру, слева и справа от него показан контекст фиксированной длины.
Ценность конкорданса в сортировке. Отсортировав строки по первому слову справа, исследователь мгновенно видит, какие дополнения и предлоги слово присоединяет чаще всего; сортировка по левому контексту показывает типичные определения и подлежащие. То, что при чтении подряд кажется случайным, в отсортированном конкордансе выстраивается в отчётливые группы.
Конкорданс это ещё и материал для качественного анализа. Из сотен строк формируется выборка (обычно 100 или 200 случайных вхождений), которая размечается вручную по интересующему признаку, и уже эта разметка идёт в подсчёты.
Частотность: почему нужны ipm
Абсолютные числа вхождений сравнивать нельзя: 500 употреблений в корпусе на 5 миллионов слов и в корпусе на 500 миллионов означают совершенно разное. Поэтому частоту нормируют на миллион словоупотреблений, ipm (instances per million):
где это число вхождений, это объём подкорпуса в токенах. Если слово встретилось 250 раз в подкорпусе объёмом 5 млн токенов, то его частота равна 50 ipm, и это число уже сопоставимо с любым другим подкорпусом.
Нормированная частота позволяет строить главный сюжет корпусного исследования: сравнение подкорпусов. Слово с частотой 12 ipm в публицистике и 0,4 ipm в художественной прозе явно закреплено за одной сферой. Сама структура частотного списка при этом устроена не случайно, а подчиняется степенной зависимости частоты от ранга, которую описывает закон Ципфа.
Коллокации и меры связи слов
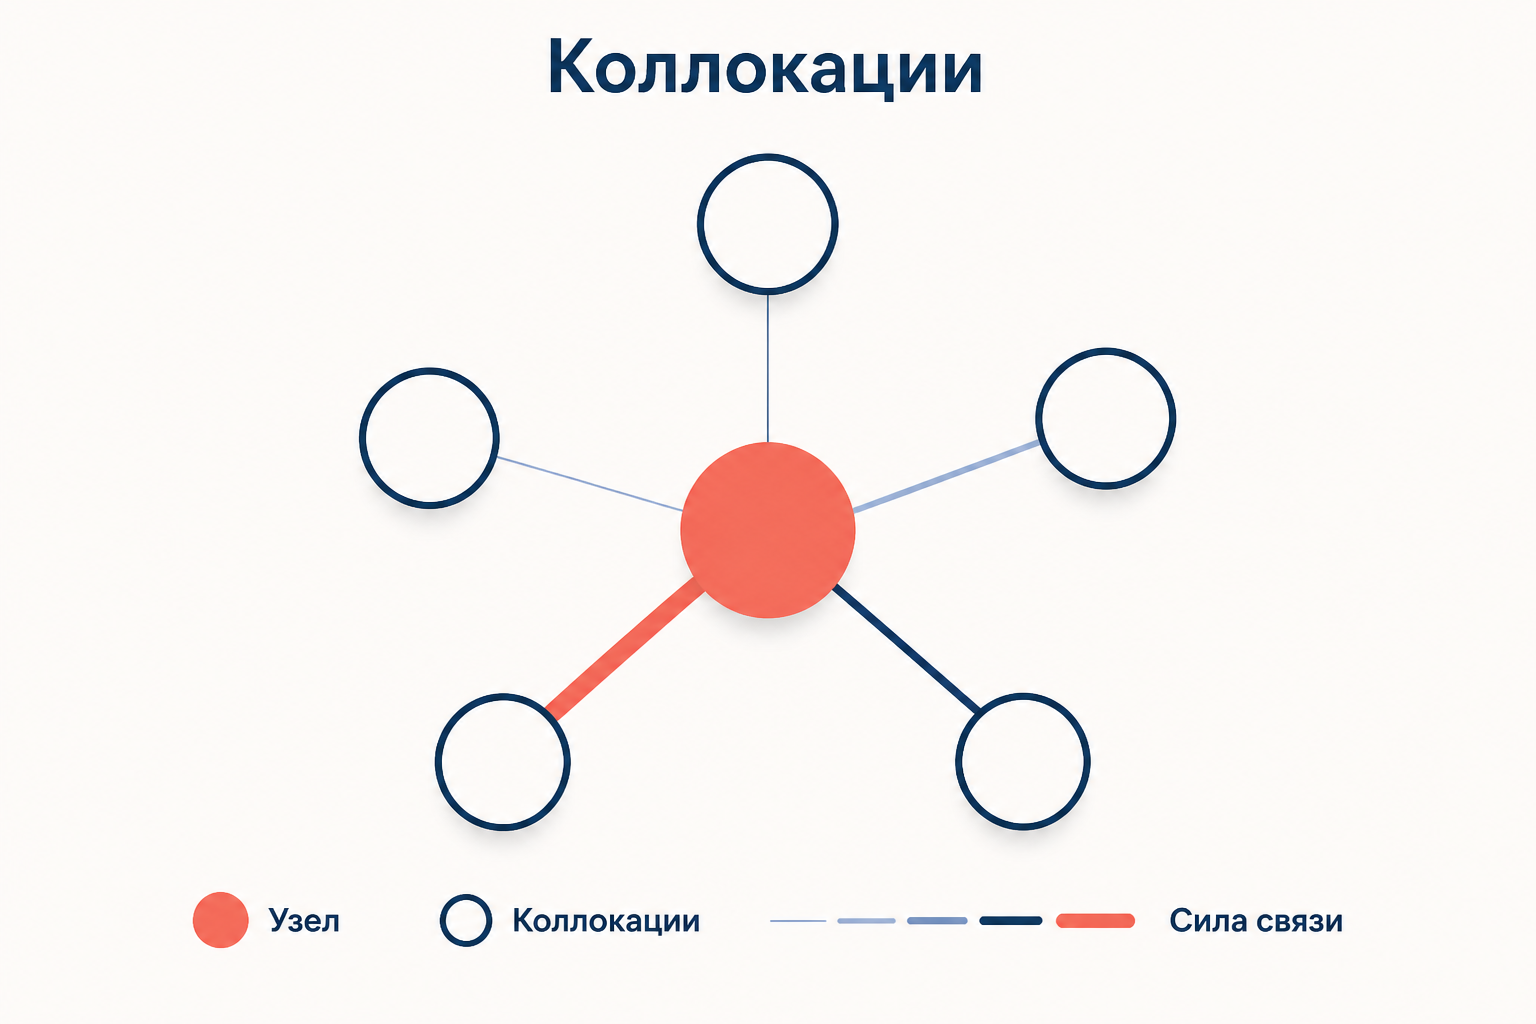
Коллокация это устойчивое сочетание, встречающееся вместе чаще, чем позволяет случай: «крепкий чай», «оказать влияние», «острая необходимость». Чтобы отделить такие пары от случайного соседства, считают меры ассоциации. Взаимная информация сравнивает наблюдаемую совместную частоту с ожидаемой при независимости:
t-score отвечает на другой вопрос, насколько мы уверены в связи с учётом объёма данных:
Меры дают разные списки, и это не дефект, а разделение труда. MI поднимает наверх редкие, но яркие пары (термины, идиомы), зато шумит на единичных вхождениях, поэтому её применяют с порогом . t-score тянет наверх частые сочетания со служебными словами. Компромисс даёт logDice, устойчивая к объёму корпуса мера:
Списки коллокатов удобно читать как эмпирическую карту сочетаемости слова, а группировка коллокатов по смыслу подводит к тем же построениям, что и семантическое поле в традиционной лексикологии.
Какие корпуса брать для учебной работы
Для русского языка базовый ресурс это НКРЯ: он бесплатен, размечен морфологически и синтаксически, содержит метаданные и позволяет строить сложные запросы с расстоянием между словами. Для больших статистических подсчётов берут веб-корпуса Araneum Russicum и ruTenTen в Sketch Engine, где счёт идёт на миллиарды токенов и есть готовые словесные эскизы (word sketches). Диахронические вопросы решает Google Books Ngram, для английского стандартом остаются BNC и COCA.
Свой корпус собирают, когда нужной коллекции не существует: тексты одного автора, отзывы, студенческие работы. Порядок такой: сбор, очистка от разметки и дублей, приведение к единой кодировке, автоматическая лемматизация и POS-разметка, добавление метаданных. Даже маленький собственный корпус на 200 тысяч токенов даёт защитимые выводы, если честно описаны источники и принцип отбора.
Как построить корпусное исследование
Схема работы почти всегда одна. Сначала формулируется лингвистический вопрос и гипотеза в проверяемом виде. Затем выбирается корпус и подкорпусы, между которыми пойдёт сравнение. Дальше составляется запрос: по лемме, по грамматическим признакам, по расстоянию между элементами. Полученный конкорданс превращают в выборку, вручную размечают её по нужному признаку и сводят в таблицу сопряжённости.
На последнем шаге считают статистику. Для сравнения долей в двух подкорпусах используют критерий хи-квадрат или log-likelihood ratio, а размер эффекта показывают через отношение нормированных частот. Вывод формулируют осторожно: корпус свидетельствует о употреблении в собранном материале, а не о языке вообще.
Частые ошибки
- Сравнивать абсолютные частоты. Пока числа не приведены к ipm, любое сравнение подкорпусов разного объёма бессмысленно.
- Делать вывод по десятку примеров. Выборка из 10 строк конкорданса не отличает закономерность от случайности, минимум это 100 размеченных вхождений.
- Путать словоформы и леммы. Поиск по форме «дела» и по лемме дело даёт принципиально разные множества.
- Доверять MI на единичных парах. Без порога по совместной частоте наверх списка выходят опечатки и имена собственные.
- Считать корпус зеркалом языка. Корпус отражает ровно тот материал, который в него отобрали, поэтому состав источников описывают в работе всегда.
FAQ
Чем корпус отличается от обычной коллекции текстов? Корпус специально отобран по схеме (репрезентативность и баланс), снабжён метаданными и лингвистической разметкой и доступен через поисковую систему с выдачей в виде конкорданса. Папка со скачанными файлами всем этим не обладает.
Какой корпус русского языка выбрать для курсовой? Для большинства тем достаточно НКРЯ: он бесплатен, позволяет ограничивать поиск жанром и годом и показывает нормированные частоты. Если нужны миллиарды токенов и словесные эскизы, берут Araneum Russicum или ruTenTen.
Как понять, что сочетание слов это коллокация, а не случайность? Посчитать меру ассоциации: MI выше 3 при совместной частоте не ниже 5 или высокий logDice говорят об устойчивой связи. Дополнительно проверяют, сохраняется ли пара в другом корпусе.
Коротко
Корпусная лингвистика заменяет интуитивные суждения о языке измеримыми: корпус даёт материал, разметка даёт возможность точного запроса, а конкорданс, нормированная частота в ipm и меры коллокаций MI, t-score и logDice превращают выдачу в аргумент. Учебное исследование строится по одной схеме: гипотеза, выбор корпуса и подкорпусов, запрос, размеченная выборка, статистика и осторожно сформулированный вывод о материале, а не о языке в целом.
Читайте также
Стилометрия: как находят автора по стилю
Стилометрия измеряет частотные слова, n-граммы и синтаксис, чтобы сравнить тексты и проверить авторство. Разбираем дельту Берроуза, атрибуцию и ограничения метода.
Адаптация первокурсников к вузу
Адаптация первокурсников к вузу: виды трудностей, этапы вхождения в учебную и социальную среду, роль куратора и тьютора, методы оценки и практические рекомендации.
Адвербиализация: как слова становятся наречиями
Адвербиализация в русском языке: переход существительных, прилагательных и деепричастий в наречия, критерии, спорные случаи и правила слитного написания.
Акт о супрематии 1534: церковь и власть
Акт о супрематии 1534 года: почему Генрих VIII стал главой церкви Англии, как присяга привела к казни Мора и Фишера, роспуску монастырей и появлению англиканства.
Александрийская поэзия: черты и представители
Александрийская поэзия эллинистической эпохи: Мусейон, Каллимах, Феокрит, эпиграмма и учёная работа со старой традицией, повлиявшая на римских поэтов.
Алкеста Еврипида: жертва, долг и возвращение
«Алкеста» Еврипида: почему жена умирает вместо Адмета, как Геракл спорит со Смертью и зачем трагедии счастливый финал. Сюжет, образы и темы для анализа пьесы.