Вторичная группировка: методы и пример расчёта
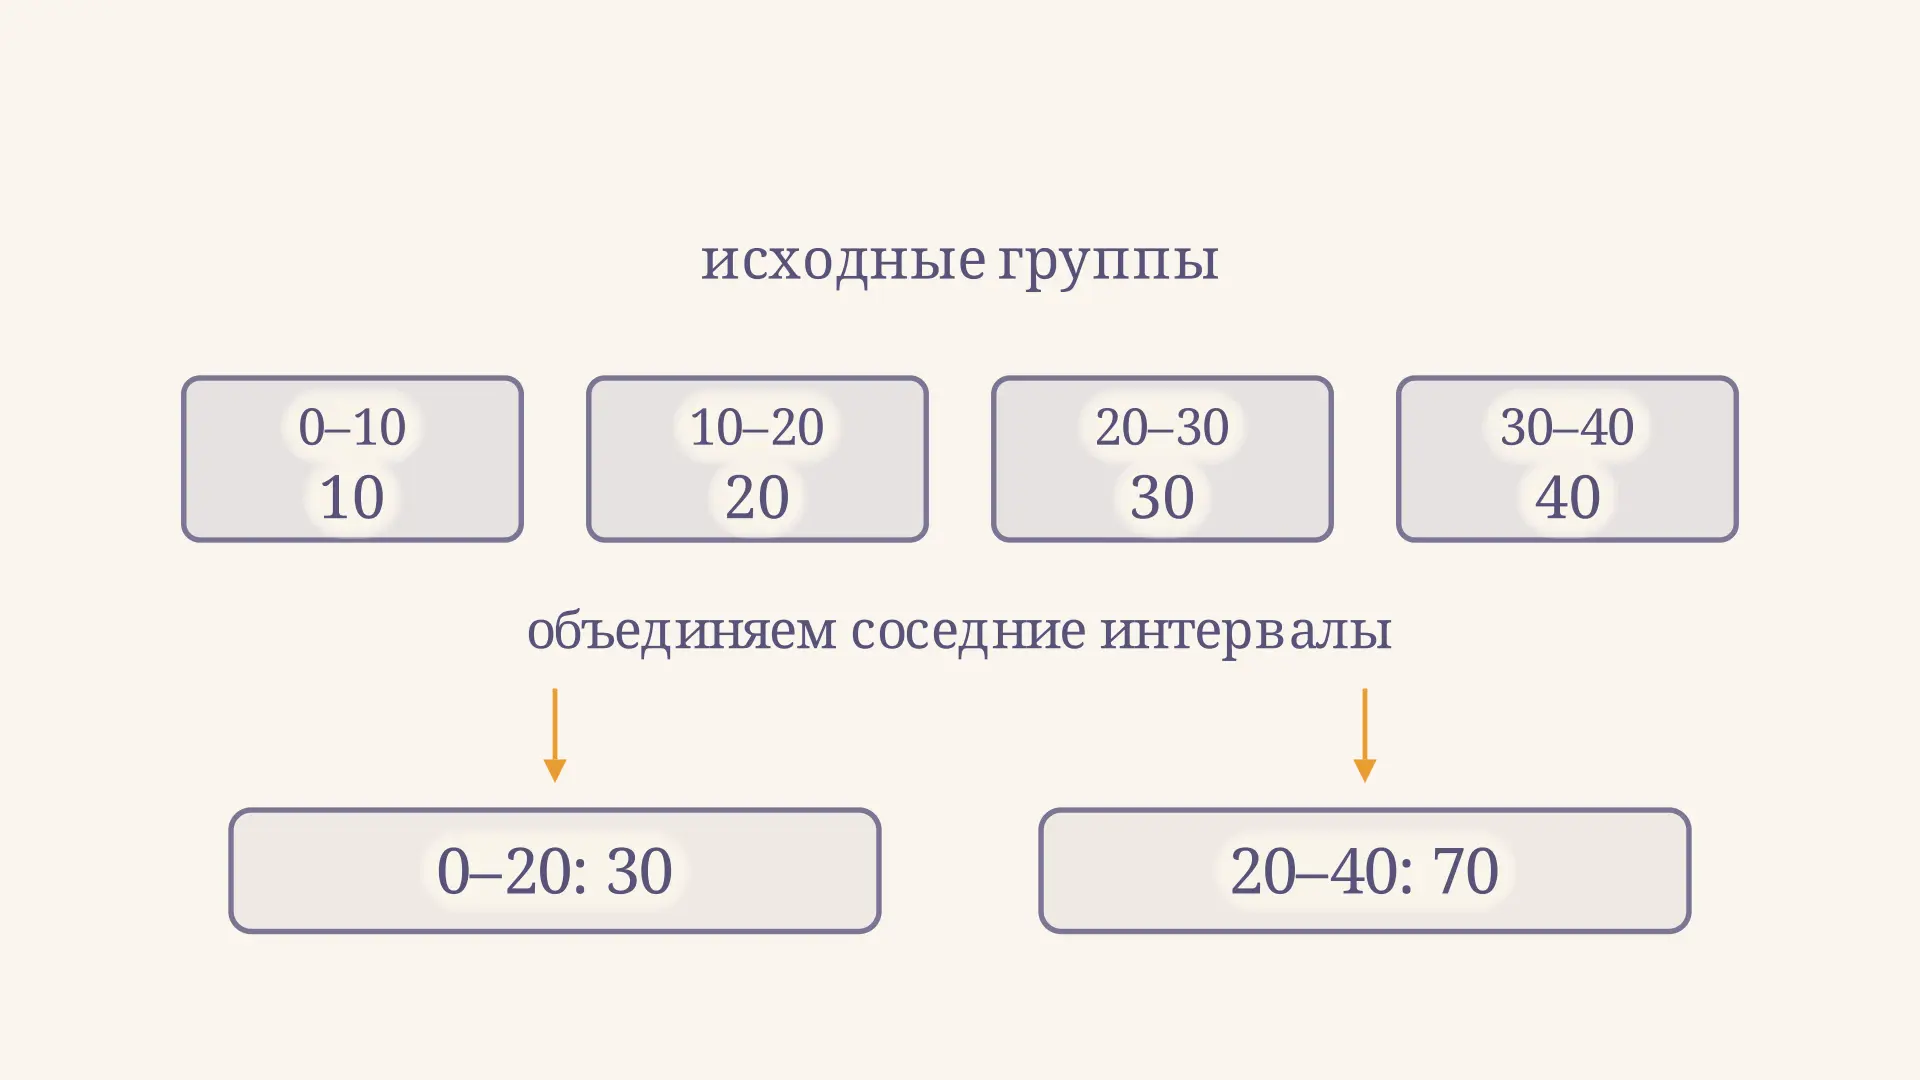
Вторичная группировка - это образование новых групп из уже сгруппированных статистических данных. Она помогает сопоставить таблицы с разными границами или сделать подробный ряд компактнее. Например, распределение предприятий по выручке можно свести из четырёх интервалов в два. Если новая граница проходит внутри старого интервала, понадобится допущение о распределении предприятий внутри него. Передвиньте границу в калькуляторе: он покажет, как меняются две частоты и когда результат становится оценочным.
Что меняется при вторичной группировке
Первичная группировка начинается с отдельных наблюдений: для каждого предприятия известна выручка, и его относят к подходящему интервалу. При вторичной исходным материалом служит уже готовая таблица частот. Сами значения отдельных предприятий могут быть недоступны. Поэтому важно отличать операции, которые дают точный результат по таблице, от операций, для которых таблицы недостаточно.
Представим два района, где число предприятий опубликовано по разным диапазонам выручки. Сравнение строк с одинаковым номером ничего не доказывает, если границы этих строк различаются. Сначала нужно согласовать признак, единицы измерения и интервалы. Сам группировочный признак должен означать одно и то же в обеих таблицах: например, годовую выручку, а не прибыль или месячный оборот.
Ролик показывает именно перенос границы, а не перемещение реальных предприятий. Их точное положение внутри интервалов исходная таблица не раскрывает. При такой перестройке сумма частот должна сохраняться, если новая сетка полностью покрывает старую и группы не пересекаются.
Исходная таблица для примера
Возьмём условные данные о 100 предприятиях. Выручка измеряется в миллионах рублей за одинаковый период; числа придуманы для расчёта и не описывают реальный район.
| Годовая выручка, млн руб. | Число предприятий |
|---|---|
| 0–10 | 10 |
| 10–20 | 20 |
| 20–30 | 30 |
| 30–40 | 40 |
| Итого | 100 |
Используем полуоткрытые интервалы: левая граница входит, правая не входит. Значит, предприятие с выручкой ровно 10 относится ко второй строке. Последнюю правую границу можно включить, если это оговорено при составлении исходного ряда. Одно правило должно действовать для всех сравниваемых таблиц. О построении исходного ряда подробнее рассказано в статье про группировку статистических данных.
Укрупнение интервалов: точное сложение
Пусть нужны группы 0–20 и 20–40 млн руб. Новые границы совпадают со старыми, поэтому достаточно сложить частоты целых соседних интервалов:
Проверка: . Никаких сведений о расположении предприятий внутри старых интервалов не требуется. Результат точен относительно исходной таблицы, хотя подробности внутри каждой укрупнённой группы исчезают. Из чисел 30 и 70 уже нельзя восстановить, что в первых двух строках было именно 10 и 20: такое же укрупнение дали бы и другие пары с суммой 30.
Укрупнение бывает полезно, когда группы слишком дробные или в другом источнике опубликованы лишь широкие диапазоны. Но оно не должно скрывать границу, которая важна для экономического вопроса. Если исследователя интересуют предприятия с выручкой от 10 млн, объединение 0–10 и 10–20 уничтожает именно нужное различие.
Новая граница внутри старого интервала
Теперь поставим границу на 15 млн руб. В левую группу целиком входят 10 предприятий из интервала 0–10, а интервал 10–20 приходится разделить пополам. Самого факта, что в нём 20 предприятий, недостаточно, чтобы узнать, сколько из них имеют выручку ниже 15. Они могут быть сосредоточены в одной или другой половине.
Для учебной оценки предположим равномерное распределение внутри каждого исходного интервала. Тогда доля частоты пропорциональна доле ширины. Левая часть интервала 10–20 имеет ширину 5 из 10, поэтому ей приписываем предприятий. Получаем:
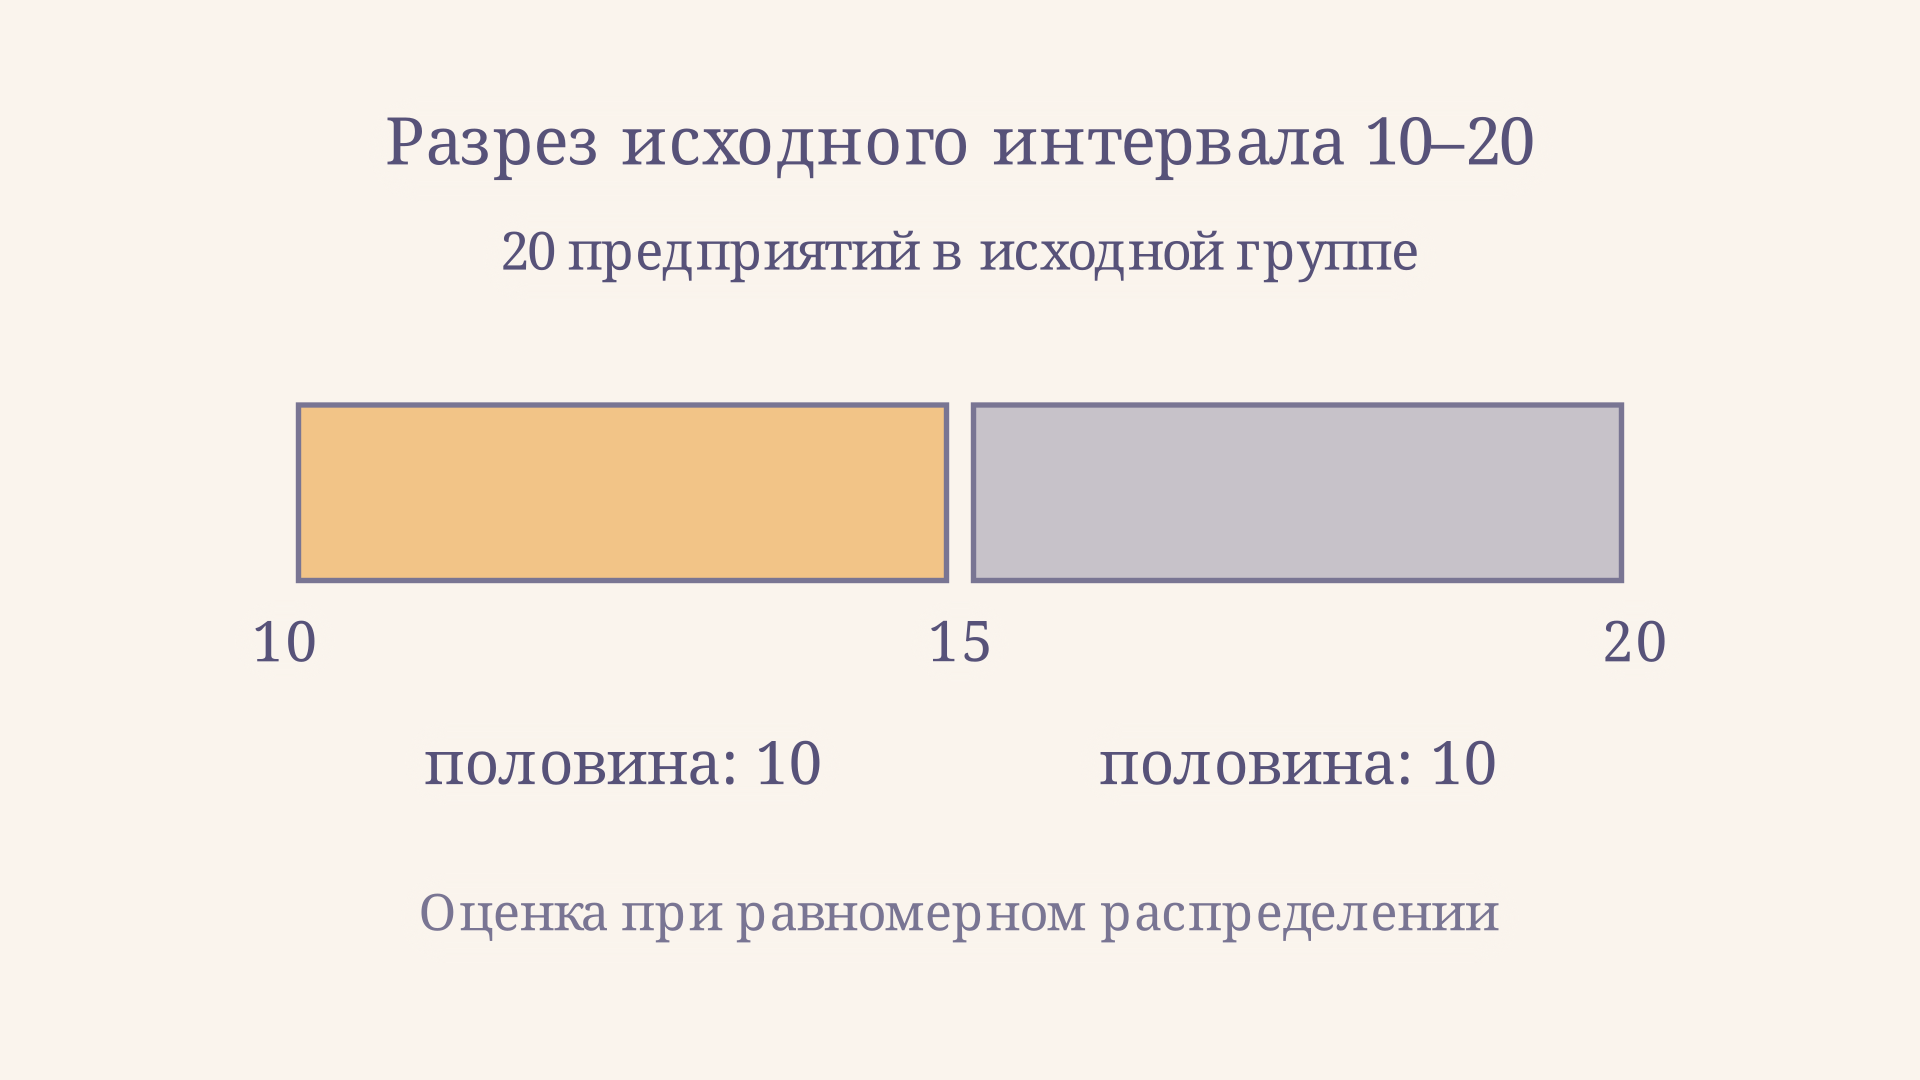
Знак шляпки напоминает об оценке. Итог совпадает с исходным, но это проверяет только сохранение общей численности, а не истинность допущения. При другой границе расчёт может дать дробное число предприятий: это ожидаемое значение по модели, а не заявление о существовании части предприятия. Округление отдельных строк способно изменить сумму, поэтому до итоговой проверки сохраняют неокруглённые значения.
Что исходная таблица позволяет узнать без модели
Посмотрим на границу 15 ещё раз. В первой группе точно находятся 10 предприятий, а в разрезаемой второй - ещё 20. Без сведений об их расположении число предприятий с выручкой ниже 15 может быть от 10 до 30 включительно. Все 20 предприятий второй группы могли оказаться ниже границы; столь же допустимо, что ни одно из них туда не попало. Оценка 20 лежит внутри этого диапазона, но исходные частоты не позволяют выбрать её как единственно верную.
Такой диапазон возможных значений полезен рядом с точечной оценкой. Например, если вывод исследования меняется в зависимости от того, равно искомое число 10 или 30, его нельзя уверенно обосновать только исходной таблицей. Нужно запросить более подробные данные. Если же исходная публикация содержит дополнительную разбивку именно по границе 15, используют её, а не предположение о равномерности.
Для любой внутренней границы аналогично складывают частоты групп, полностью лежащих слева, и добавляют от нуля до всей частоты пересечённой группы. Эти пределы не зависят от формы распределения внутри интервала. Они могут быть широкими, зато показывают, какая неопределённость осталась после первоначального сводного представления данных.
Общая формула и порядок действий
Для старого интервала с частотой и нового интервала найдём длину их пересечения . Если исходный интервал конечен и внутри него принята равномерность, вклад равен . Складывая вклады, получаем:
При полном включении старого интервала доля равна единице, при отсутствии пересечения - нулю. Это позволяет использовать одну запись и для точного объединения, и для оценочного разрезания. Практически удобно действовать так:
- Записать старые и новые границы с единицами измерения и правилом включения концов.
- Отметить, какие старые интервалы входят целиком, а какие пересекаются с новой границей.
- Сложить полные частоты; для разрезанных интервалов вычислить долю по ширине и явно указать допущение.
- Сверить сумму новых частот с исходной, а также проверить, что нет пропусков и двойного счёта.
Распределить по ширине открытый интервал, например «40 млн и более», этой формулой нельзя: его конечная ширина неизвестна. Нужны исходные наблюдения, дополнительная информация или другая обоснованная модель.
Как сравнить два распределения
Для сравнения районов сначала проверьте определение предприятия, период, валюту и единицы выручки. Затем выберите общую сетку интервалов. Если её границы совпадают с границами обеих исходных таблиц, частоты можно получить точным суммированием. Если нет, по возможности вернитесь к первичным данным. Оценки по равномерности используйте с явной оговоркой, особенно когда граница проходит через крупную исходную группу.
При разных размерах совокупностей сравнивайте также доли: частоту группы делят на итог по соответствующему району. Например, 30 из 100 - это 30 %, а 30 из 200 - 15 %. Одинаковая численность в строке не означает одинаковую структуру. Для последующего анализа различий полезно понимать правило сложения дисперсий, но перегруппировка сама по себе не устанавливает причину различий.
Выбор новой сетки зависит от задачи. Формула Стёрджесса может служить ориентиром для числа групп при построении ряда, но не восстанавливает скрытые значения внутри уже опубликованных интервалов и не делает несовпадающие границы точными.
Частые ошибки
- Считать оценку точной. Половина ширины интервала соответствует половине частоты только при принятом допущении равномерности.
- Сравнивать разные признаки. Годовую выручку нельзя напрямую сопоставить с месячной прибылью только потому, что подписи интервалов похожи.
- Потерять часть совокупности. Новые интервалы должны покрывать исходный диапазон без перекрытий; отдельно проверьте крайние группы.
- Пересчитывать открытый интервал по ширине. Без конечной границы доля ширины не определена.
- Округлять слишком рано. Сначала сложите неокруглённые оценки и проверьте итог; способ представления целых значений оговорите отдельно.
FAQ
Чем вторичная группировка отличается от первичной?
Первичная строится непосредственно по значениям отдельных единиц наблюдения. Вторичная использует уже составленные группы; при отсутствии исходных значений часть новых частот может быть лишь оценена.
Всегда ли нужна равномерность?
Нет. При объединении целых исходных интервалов достаточно сложить их частоты. Допущение нужно, когда новая граница делит интервал и точных наблюдений внутри него нет.
Почему сумма сохранилась, но результат всё ещё приблизительный?
Модель распределяет всю исходную частоту между новыми группами, поэтому итог сохраняется автоматически. Реальное расположение наблюдений внутри разрезанного интервала может отличаться от модели.
Коротко
Вторичная группировка перестраивает готовый статистический ряд для обобщения или сравнения. Совпадающие границы позволяют точно сложить частоты; граница внутри интервала требует данных об отдельных наблюдениях либо явно обозначенной оценки. Проверка общей численности необходима, но сама по себе не подтверждает точность такой оценки.
Читайте также
Дисперсия интервального вариационного ряда: расчёт
Как найти дисперсию интервального вариационного ряда по серединам и частотам: подробная таблица, две формулы, исправленная оценка и ограничения группировки.
Индекс Рябцева: формула и расчёт структурных различий
Индекс Рябцева измеряет различие двух структур. Разбираем формулу, пошаговый расчёт по долям, шкалу интерпретации и ограничения метода на наглядном примере.
Коэффициент изобретательской активности: расчёт
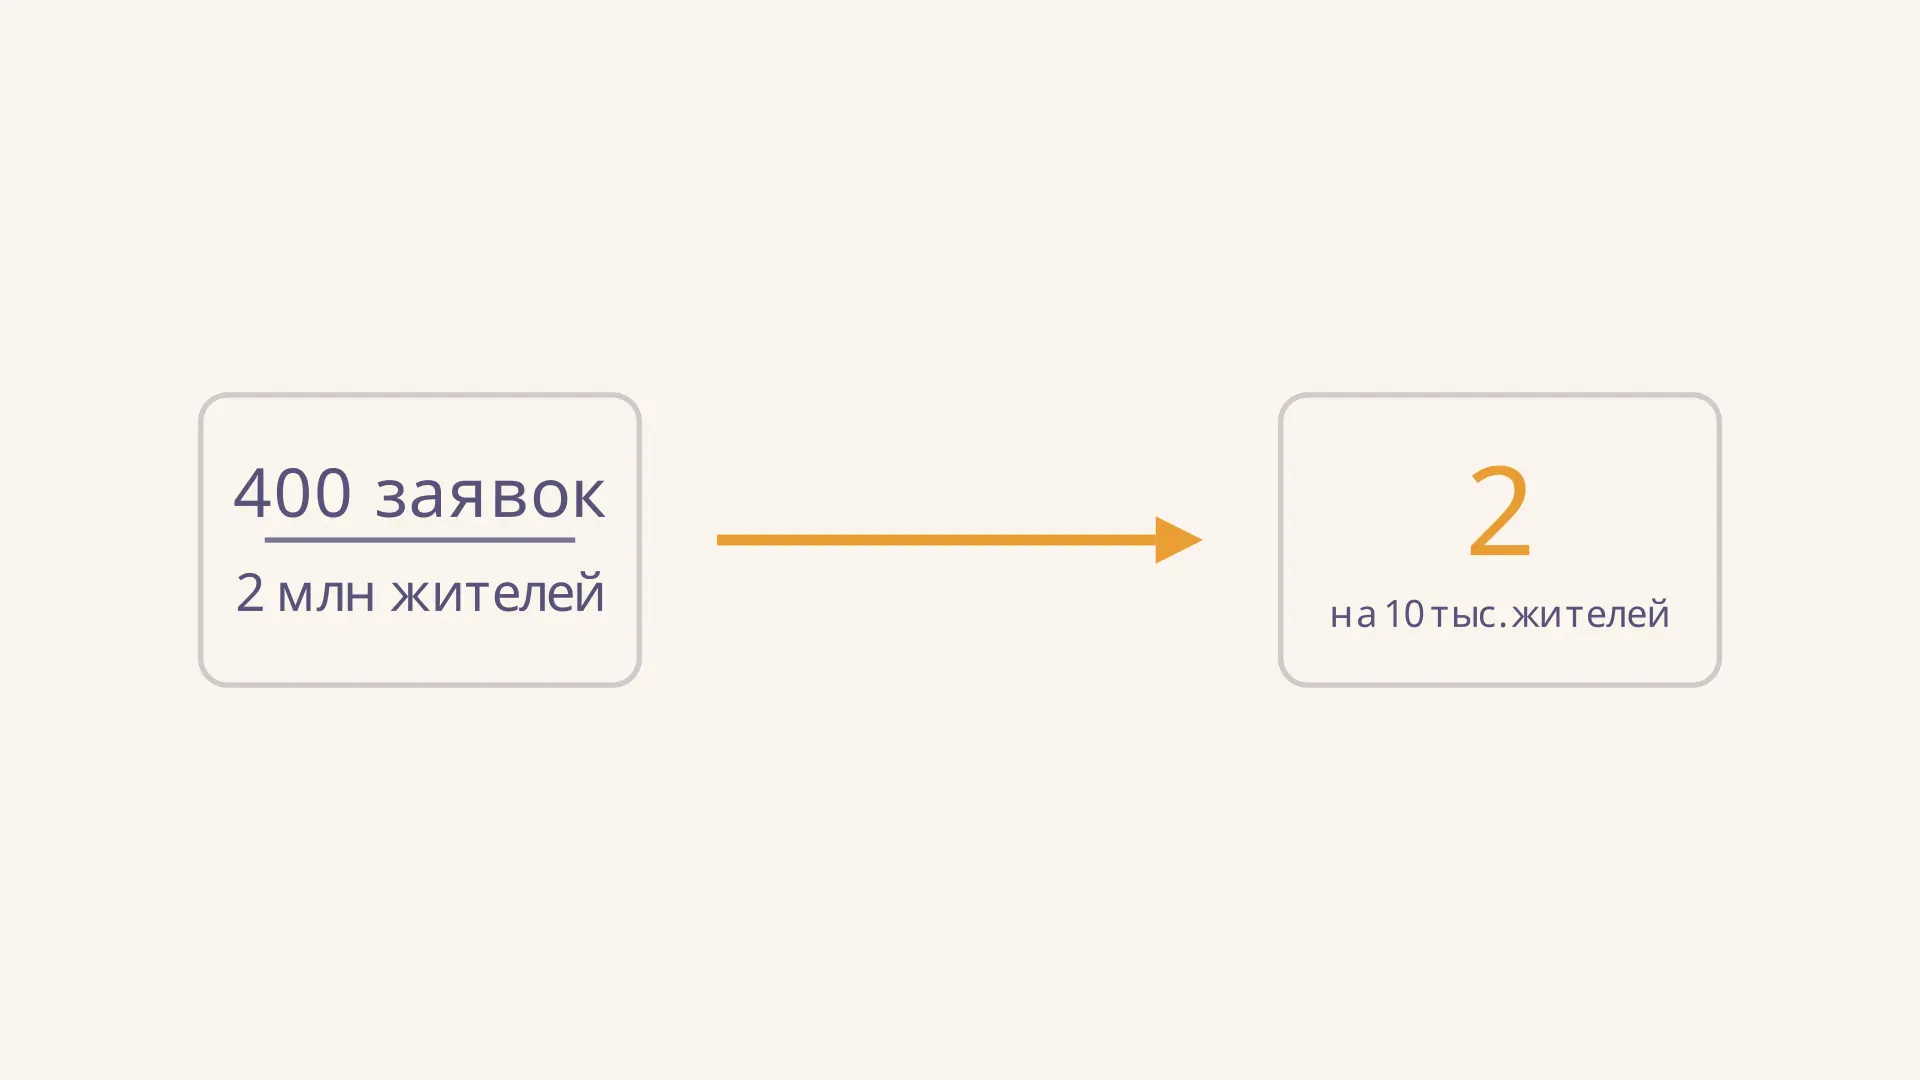
Коэффициент изобретательской активности: формула числа патентных заявок на 10 тысяч жителей, пример расчёта, сравнение регионов и ограничения показателя.
Корреляционная таблица: построение и расчёт
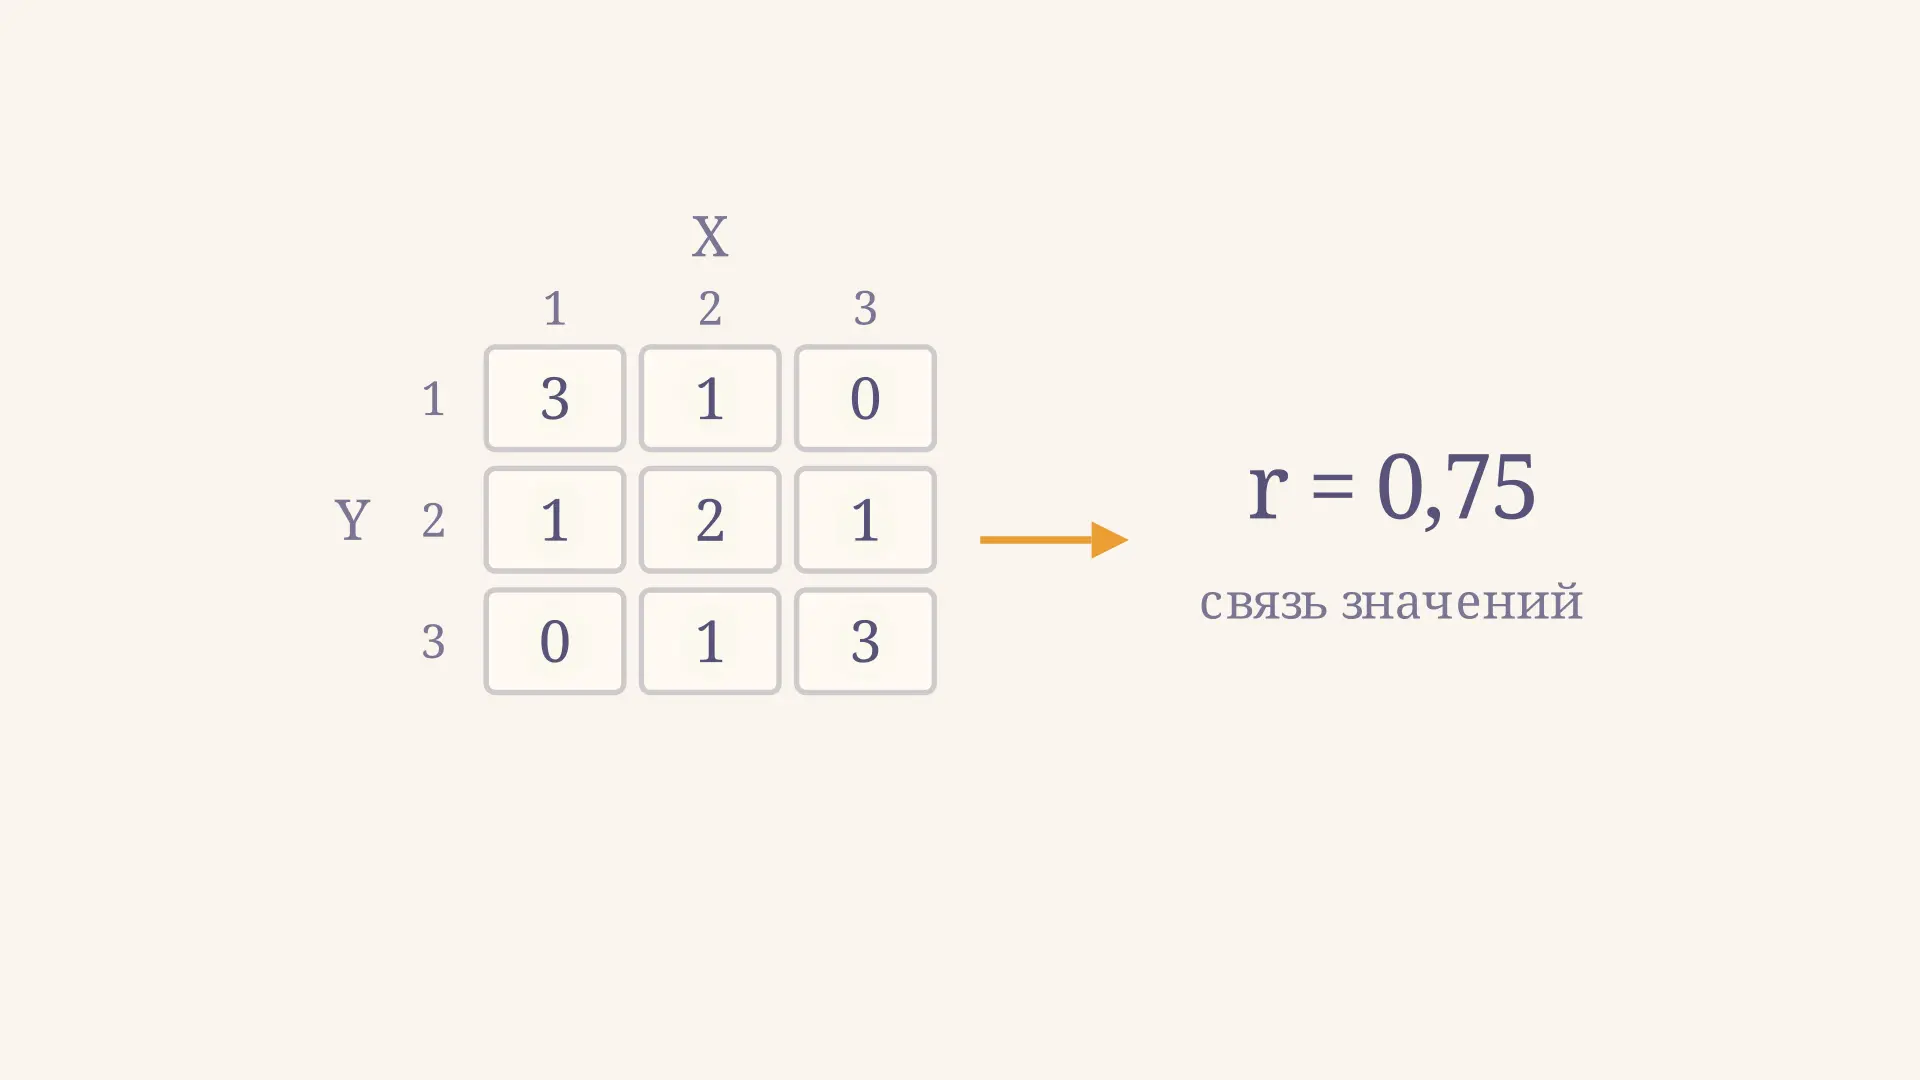
Корреляционная таблица показывает совместное распределение двух признаков. Разберём построение частот, суммы по строкам и столбцам и расчёт коэффициента Пирсона.
Относительная величина интенсивности: формула и примеры
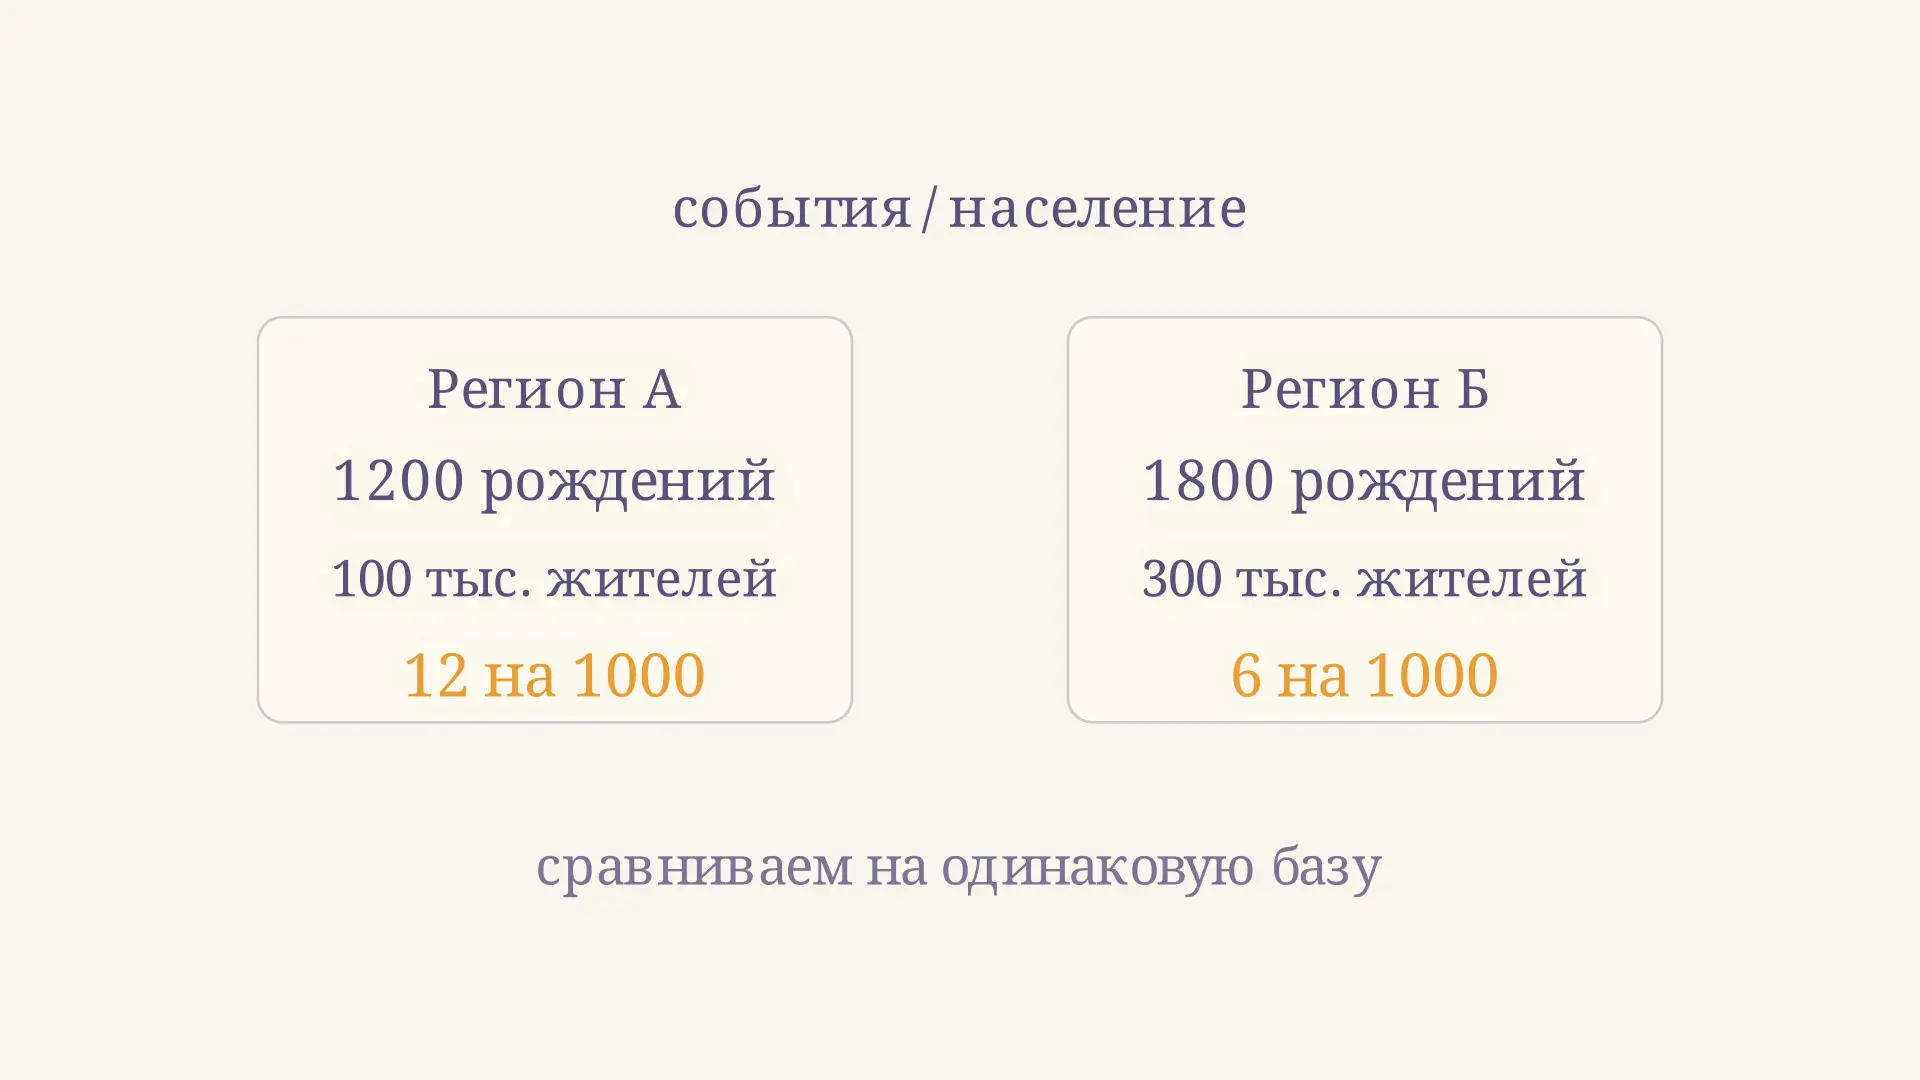
Относительная величина интенсивности показывает распространённость явления в среде. Разбираем формулу, единицы измерения и сравнение регионов на примерах.
Относительная величина координации: формула и пример
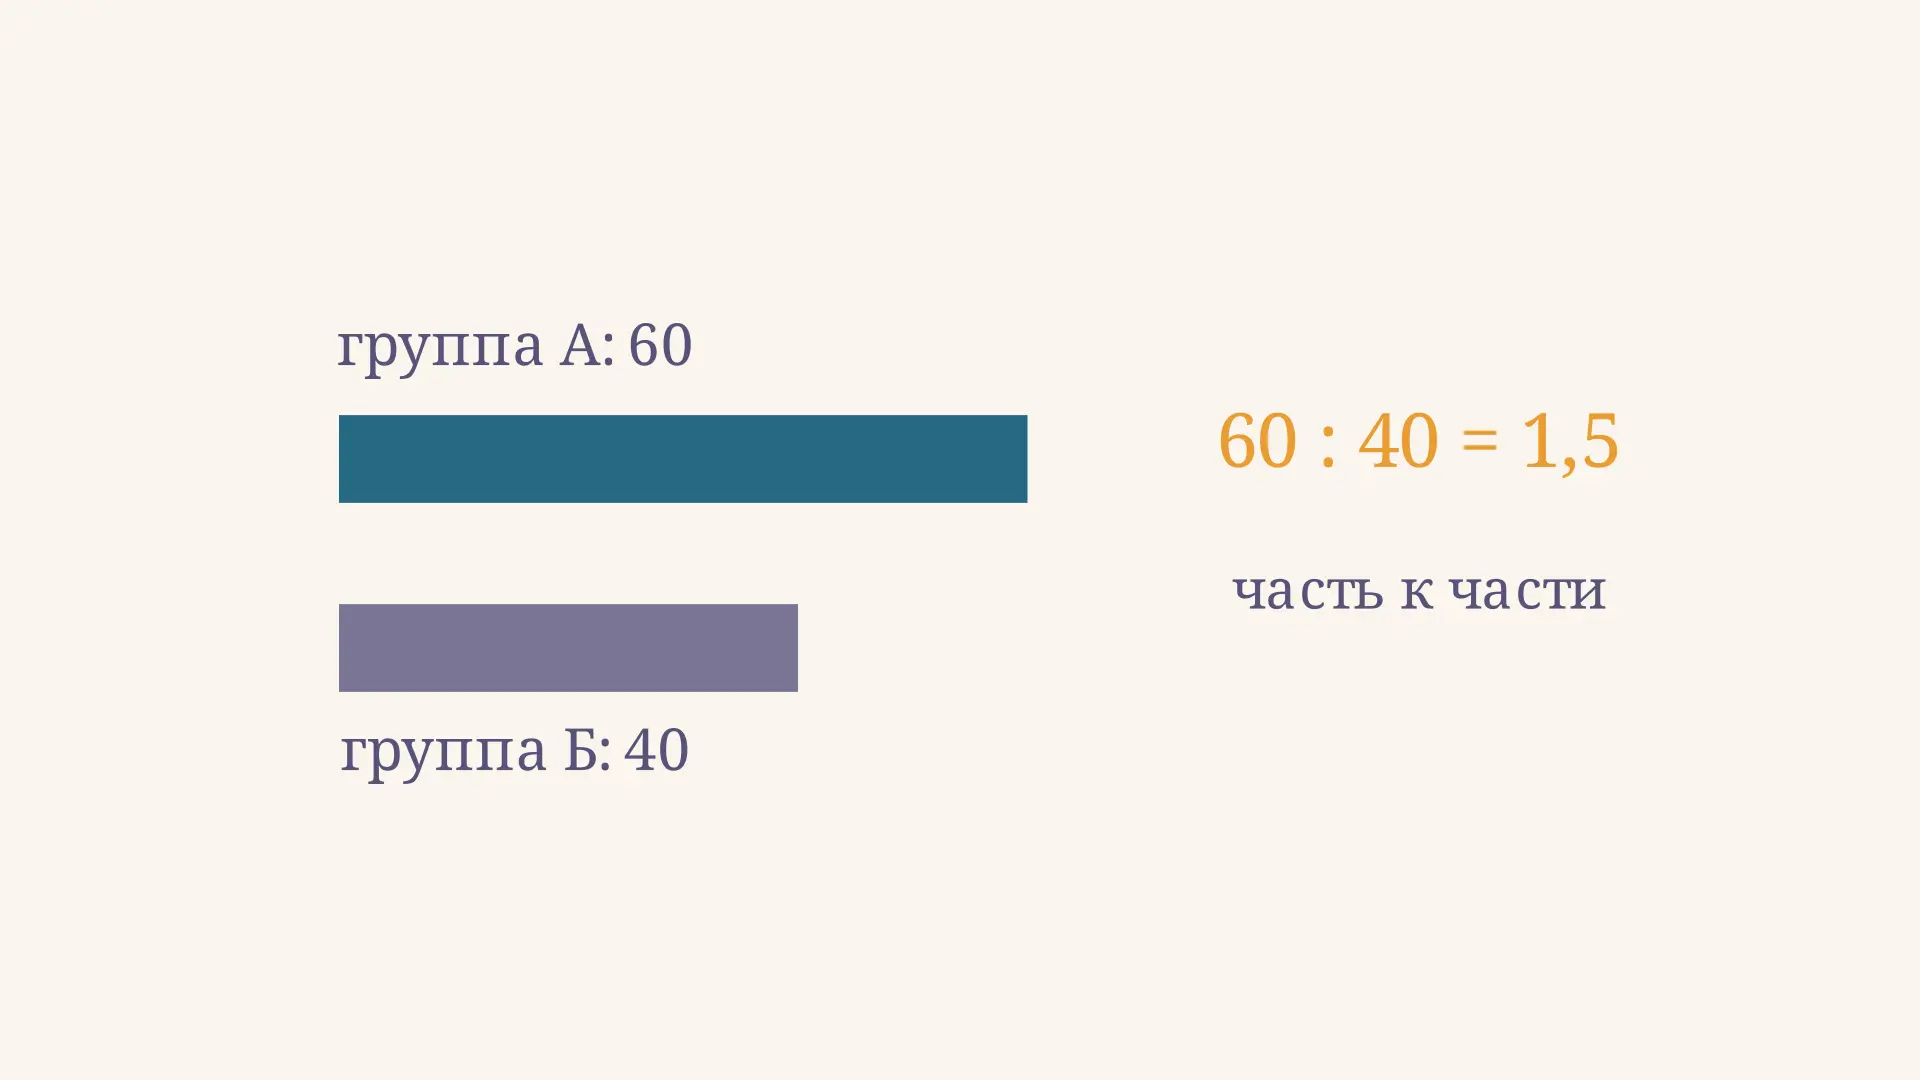
Относительная величина координации сравнивает части одной совокупности. Разбираем формулу, выбор базы, обратное отношение и отличие от доли на примерах.