Регулярная грамматика: правила, примеры и автомат
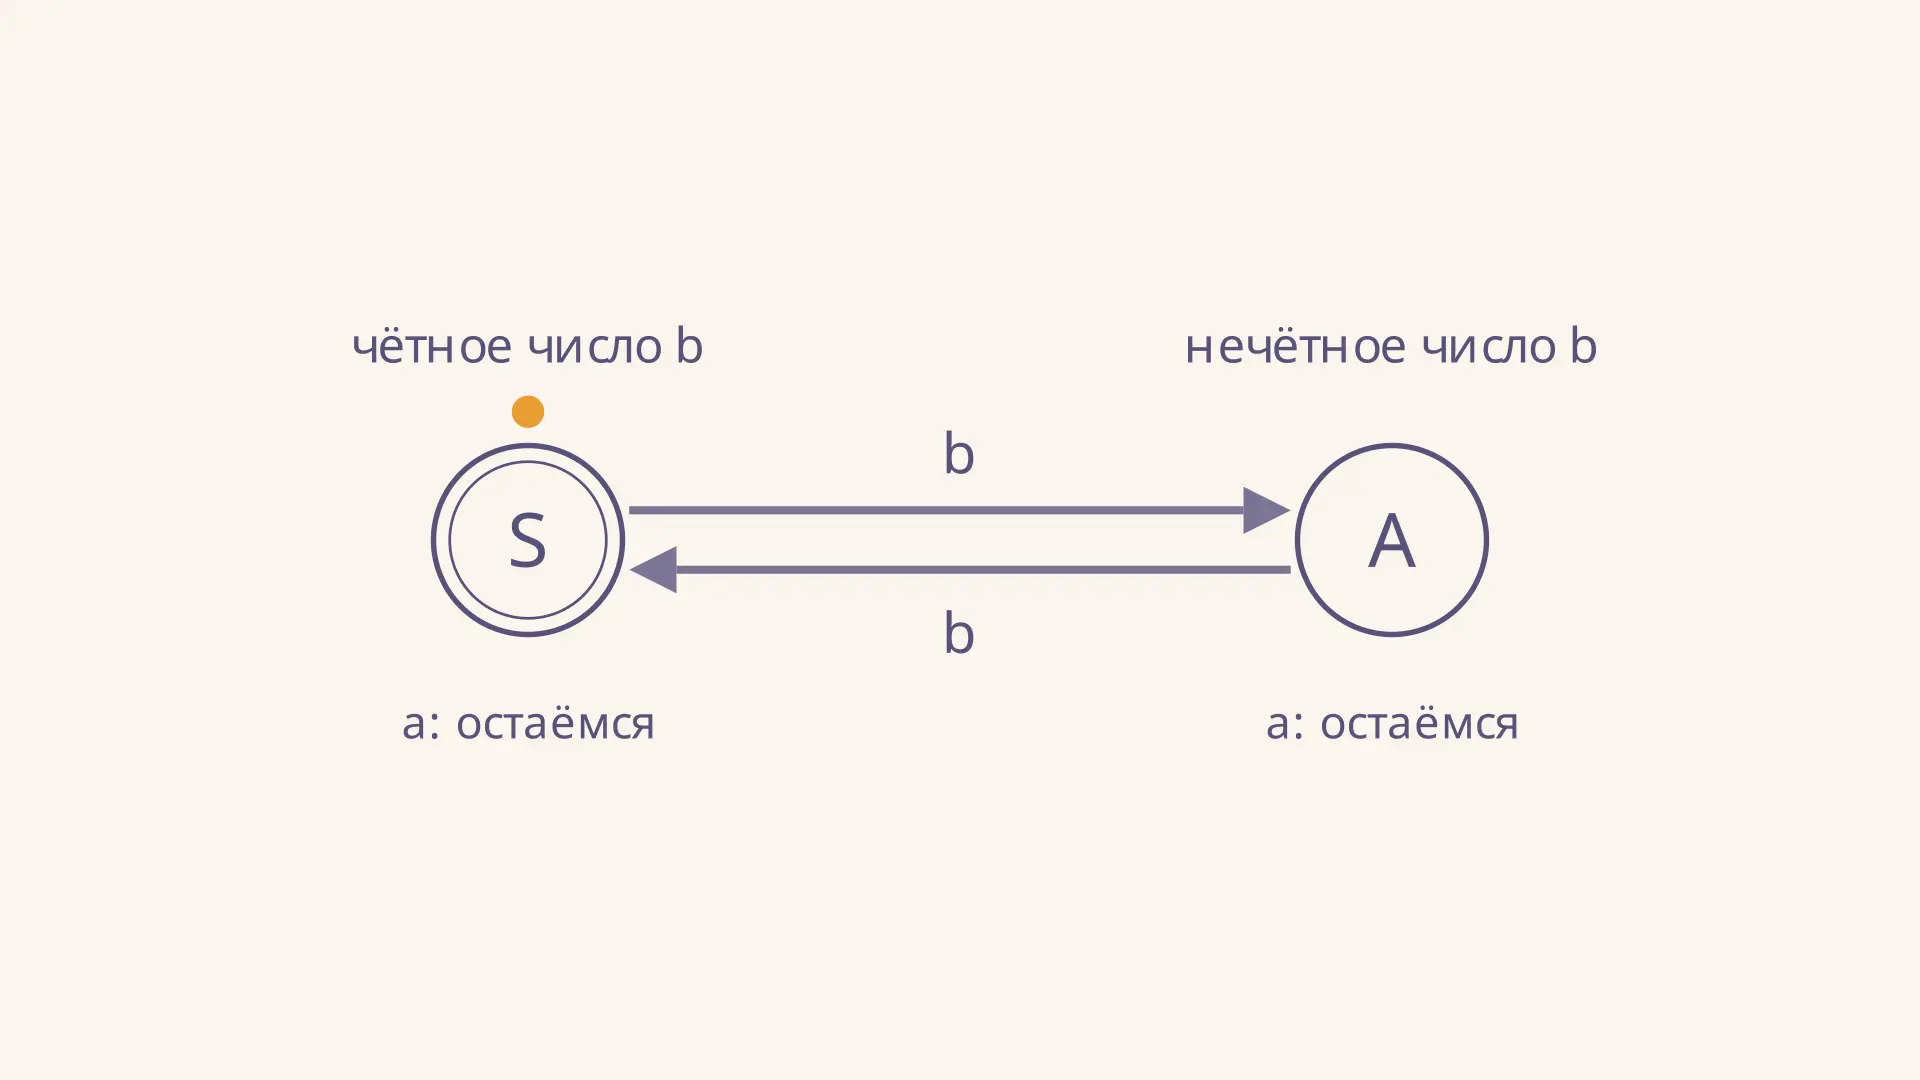
Регулярная грамматика - это набор правил, по которым из начального символа строят слова формального языка. Она ограничивает вид правил так, что процесс можно представить конечным числом состояний. Например, двух состояний достаточно, чтобы следить за чётностью числа букв : каждая новая переключает состояние, а буква его сохраняет. В интерактивном примере измените длину слова и проследите, когда вывод удаётся закончить.
Из чего состоит грамматика
Формальную грамматику записывают как четвёрку . Здесь - конечное множество нетерминалов, - алфавит терминалов, - конечное множество правил, а - начальный нетерминал. Нетерминалы обозначают промежуточные состояния построения, терминалы составляют готовое слово. Множества и не пересекаются.
Правило разрешает заменить на . Символ обозначает пустое слово, поэтому удаляет и завершает вывод, если других нетерминалов не осталось. Язык - множество всех слов из терминалов, которые можно получить из за конечное число применений правил. Промежуточная цепочка с нетерминалом ещё не является готовым словом.
Слово «грамматика» здесь означает математическую систему подстановок. Это другой предмет, чем описание строя естественного языка, например грамматика зависимостей. Термины похожи, но математический алфавит и правила задаются явно.
Какими бывают регулярные правила
В распространённой строгой записи праволинейной грамматики правила имеют вид , или , где - нетерминалы, а - терминал. После применения правила единственный оставшийся нетерминал стоит справа от выведенных терминалов. Последние два вида завершают соответствующую ветвь вывода. В более широкой записи справа разрешают целое слово терминалов, например ; его можно разбить на несколько переходов с дополнительным нетерминалом.
В леволинейной грамматике нетерминал, если он есть, стоит слева: например, . Допустимы и завершающие правила без нетерминала. Оба согласованных варианта задают регулярные языки, но произвольно смешивать леволинейные и праволинейные правила в одной грамматике нельзя, если требуется гарантировать регулярность. Например, , создаёт : эта грамматика линейна, но её язык не регулярен.
Достаточно одного нетерминала в каждой правой части для линейности, но для регулярной грамматики важно и его положение. Правило поэтому не праволинейно и не леволинейно: терминалы стоят по обе стороны от нетерминала.
Пример: слова с чётным числом b
Пусть алфавит равен , а правила таковы:
В состоянии уже построенный префикс содержит чётное число , в состоянии - нечётное. Изначально букв нет: ноль чётен, значит начинаем с . Буква не меняет чётность, а каждая меняет её на противоположную. Только из разрешено удалить нетерминал по правилу .
Например, слово получается так:
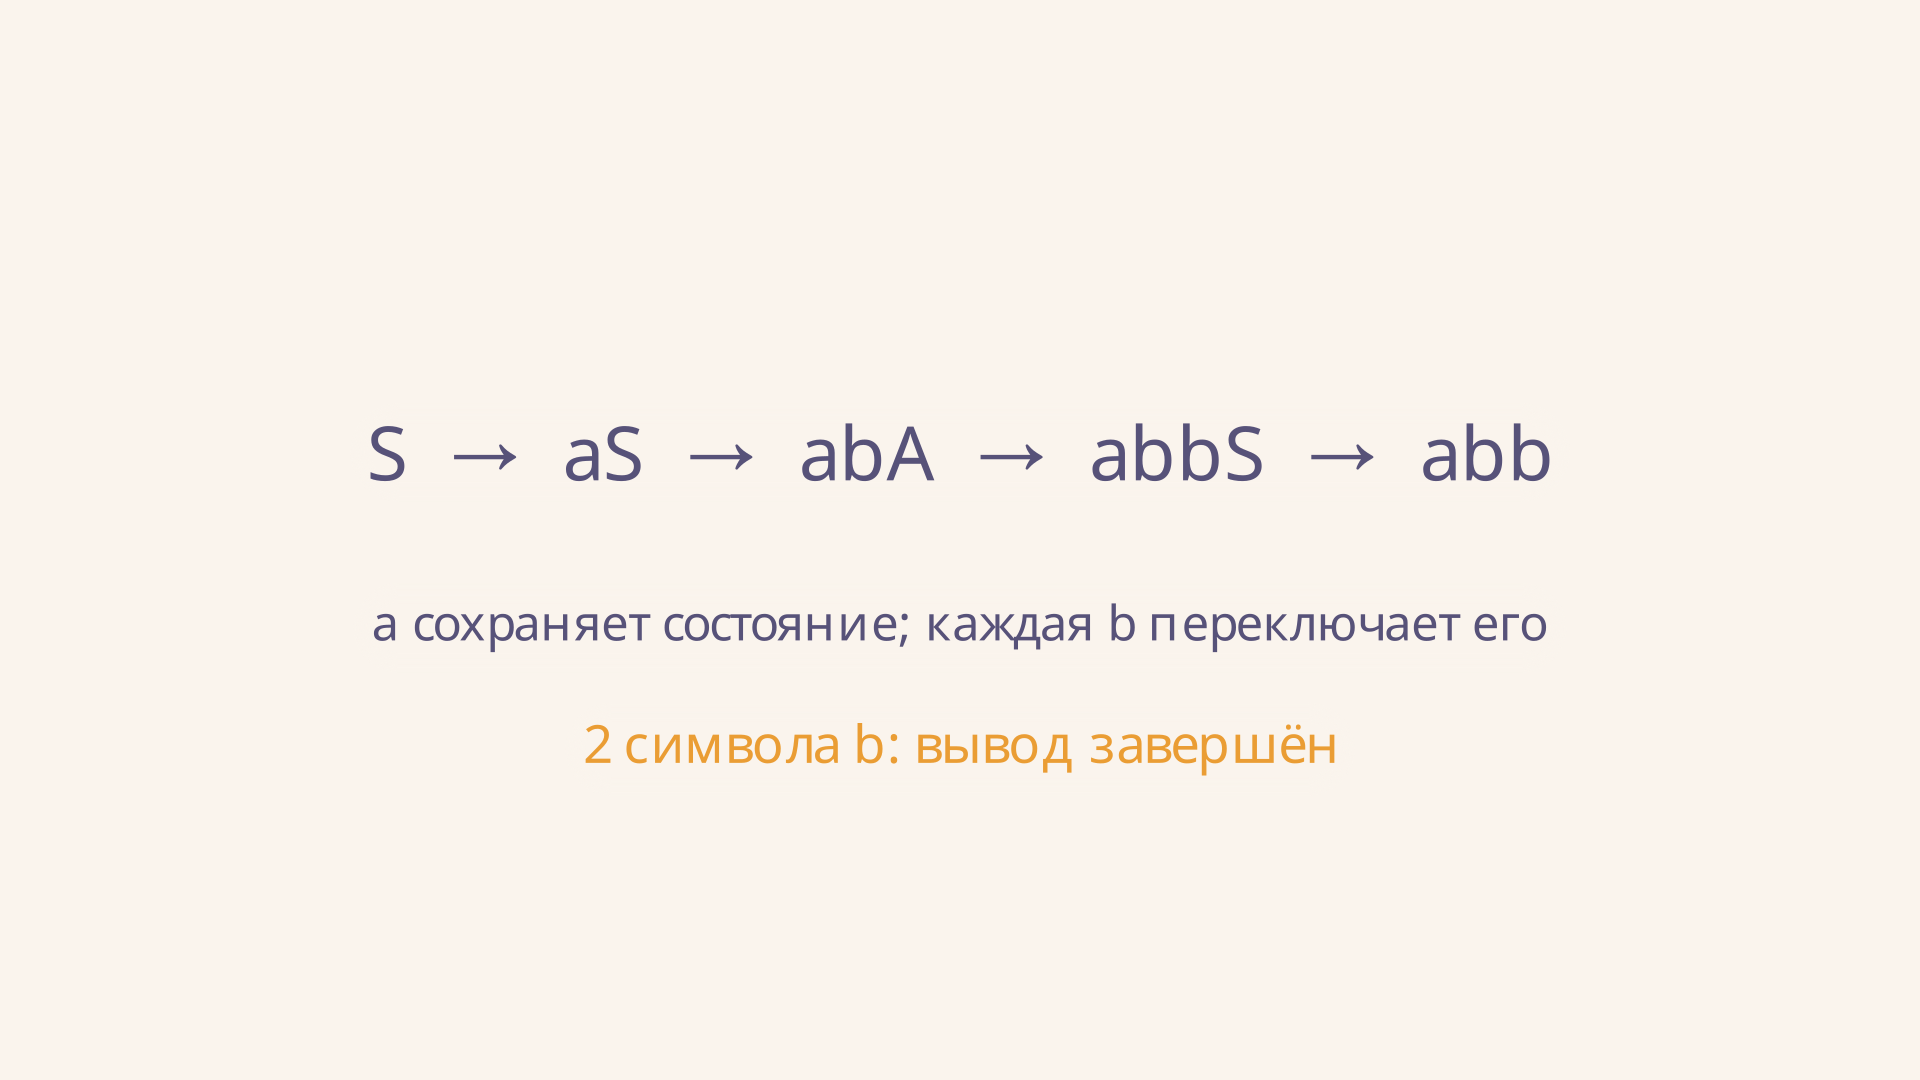
Слово не выводится до конца: после его символов получается , а правила нет. Пустое слово принадлежит языку благодаря . Эти примеры не просто иллюстрации: инвариант чётности после каждого шага доказывает, что грамматика не породит слово с нечётным числом . И наоборот, для любого слова с чётным числом можно последовательно выбрать правило для каждого символа и завершить вывод в .
В калькуляторе для наглядности рассматривается подмножество слов вида , где . Сама грамматика допускает буквы в любом порядке, например : важно только число .
Как проверять конкретное слово
Для ручной проверки удобно выписать слово и вести под ним текущий нетерминал. Начните с начального символа, затем для очередной буквы выберите правило, которое выводит именно эту букву. Полученный нетерминал станет отправной точкой следующего шага. Когда буквы закончились, проверьте, есть ли правило, удаляющее оставшийся нетерминал. Если его нет, цепочка пока не является выводом слова.
Для нашей грамматики такой проход однозначен: в каждом состоянии для каждой из двух букв есть ровно одно продолжающее правило. В других грамматиках вариантов может быть несколько. Тогда неудача одной ветви не доказывает, что слово исключено: достаточно хотя бы одного полного вывода. И наоборот, если подходящего правила для следующего символа нет ни в одной из возможных ветвей, продолжить построение невозможно.
Например, для слова из одной буквы первый шаг приводит к цепочке . Буквы кончились, но удалить нельзя. Для двух букв первый шаг тот же, второй возвращает в , после чего завершающее правило срабатывает. Пустое слово рассматривают отдельно: переходов по буквам нет, но в начальном состоянии разрешено сразу закончить вывод.
Как построить грамматику по условию
Начните с того, что системе нужно помнить о прочитанном или построенном префиксе. Для чётности достаточно двух случаев; обозначьте их и . Затем для каждого состояния и каждого символа спросите, в какое состояние он переводит процесс. Наконец, добавьте -правила только в состояниях, где слово разрешено закончить.
Применим приём к другому условию: слова над должны оканчиваться на . Можно использовать правила и . Циклы в строят произвольный префикс; выбор начинает последние два символа, а завершает слово. Например, получается как . Здесь для одной буквы из есть два варианта: грамматика может недетерминированно выбрать, является ли эта буква началом окончания.
Проверяйте обе стороны условия: всякий полученный результат должен подходить, и всякое подходящее слово должно иметь вывод. Проверка лишь нескольких примеров полезна для поиска ошибок, но не заменяет такого доказательства.
От правил к конечному автомату
Для праволинейной грамматики сделаем состояние для каждого нетерминала и начнём в состоянии . Правило превращается в переход из в по символу . Если есть , состояние становится допускающим. Для правила можно добавить отдельное допускающее состояние и провести в него переход по . Несколько правил с одной буквой дают недетерминированный автомат - это допустимо.
В примере с чётностью состояния называются и ; по автомат остаётся в текущем состоянии, по переключается, а единственное допускающее состояние - . Наоборот, по переходам автомата можно записать правила вида , а для каждого допускающего состояния добавить правило в . Эта связь объясняет, почему регулярным грамматикам достаточно конечной памяти. Подробное сравнение с регулярными выражениями дано в статье о теореме Клини.
Конечные автоматы также встречаются в задачах моделирования процессов. В автоматах Мура и Мили дополнительно изучают выходные сигналы; здесь же нас интересует, принимает ли автомат слово целиком.
При преобразовании важно сохранять смысл окончания. Сам факт, что переход вошёл в некоторое состояние, не означает приём слова: входная цепочка должна быть прочитана целиком, а последнее состояние - допускающим. В грамматике то же различие выражено наличием или отсутствием завершающего правила. На схеме двойной круг отмечает допускающее состояние, но не является отдельным символом алфавита.
Для практической проверки сопоставьте одну и ту же цепочку с обеих сторон. Каждому применению продолжающего правила соответствует переход по той же букве. Завершение по пустому слову соответствует остановке в допускающем состоянии; оно не потребляет входной символ. Такое пошаговое соответствие полезнее, чем просто сравнить рисунок автомата с таблицей правил.
Где предел и зачем это нужно
Конечное число состояний хорошо подходит для ограниченного набора признаков: чётности, наличия суффикса или допустимой последовательности состояний. Такую модель используют, например, при описании простых лексических шаблонов. При поиске подстрок полезно различать задачу распознавания языка и конкретный алгоритм поиска; в статье об алгоритме Кнута - Морриса - Пратта рассматривается другой способ отслеживать совпадения.
Но язык требует сравнивать сколь угодно большие количества двух букв. Конечному автомату не хватает различных состояний, чтобы запомнить любое число для последующего сравнения. Контекстно-свободное правило такую зависимость задаёт, но оно не является регулярным. Из того, что конкретная запись грамматики нерегулярна, ещё не следует, что её язык нельзя задать другой регулярной грамматикой: свойства грамматики и языка нужно проверять отдельно.
Частые ошибки
- Считать обычной буквой. Это слово длины ноль; его применение не добавляет символ в результат.
- Останавливать вывод с нетерминалом. Цепочка промежуточная, а не слово языка над .
- Смешивать направления правил без проверки. Левый и правый варианты по отдельности регулярны, но их смесь может породить нерегулярный язык.
- Забывать об обратном включении. Отсутствие лишних слов не доказывает, что все нужные слова выводимы.
- Путать грамматику с языком. Разные наборы правил могут порождать один и тот же язык.
FAQ
Обязательно ли в регулярной грамматике есть правило в ? Нет. Например, порождает непустые последовательности без такого правила.
Можно ли получить бесконечный язык из конечного числа правил? Да. Цикл можно повторять произвольное конечное число раз, а затем завершить вывод правилом .
Чем грамматика отличается от автомата? Грамматика порождает слова заменами, автомат читает слово переходами. Для регулярных языков эти способы эквивалентны по выразительной силе, хотя описывают процесс по-разному.
Коротко
Регулярная грамматика строит слова с помощью согласованных право- или леволинейных правил. В праволинейном варианте нетерминал играет роль состояния, а правило - перехода; завершающее правило отмечает допустимый конец слова. Это позволяет проверять построение на примерах и доказывать его через инвариант состояний.
Читайте также
Контекстно-свободная грамматика: правила и примеры
Контекстно-свободная грамматика простыми словами: терминалы и нетерминалы, вывод слова, дерево разбора, неоднозначность и применение при анализе синтаксиса.
Алгоритм LZW: сжатие данных с помощью словаря
Алгоритм LZW по шагам: как строится словарь фраз, выдаются коды и восстанавливается исходная строка. Разберём пример, особый случай декодирования и оценку размера.
Блок-схема алгоритма: условный оператор
Как построить блок-схему алгоритма с условным оператором: обозначения, полное и неполное ветвление, пример проверки чётности и трассировка двух путей.
Иерархия Хомского: типы грамматик и автоматы
Иерархия Хомского простыми словами: четыре типа формальных грамматик, вложенность классов языков, соответствующие автоматы и примеры для решения учебных задач.
Исчисление предикатов: язык, формулы и правила вывода
Исчисление предикатов описывает свойства объектов и отношения между ними. Разбираем устройство формул, пошаговый пример доказательства и поиск контрмодели.
Исполнитель Черепаха: алгоритм рисования фигур
Как исполнитель Черепаха рисует фигуры по командам: положение, направление и перо, пошаговая трассировка квадрата, циклы и углы поворота многоугольников.