Контекстно-свободная грамматика: правила и примеры
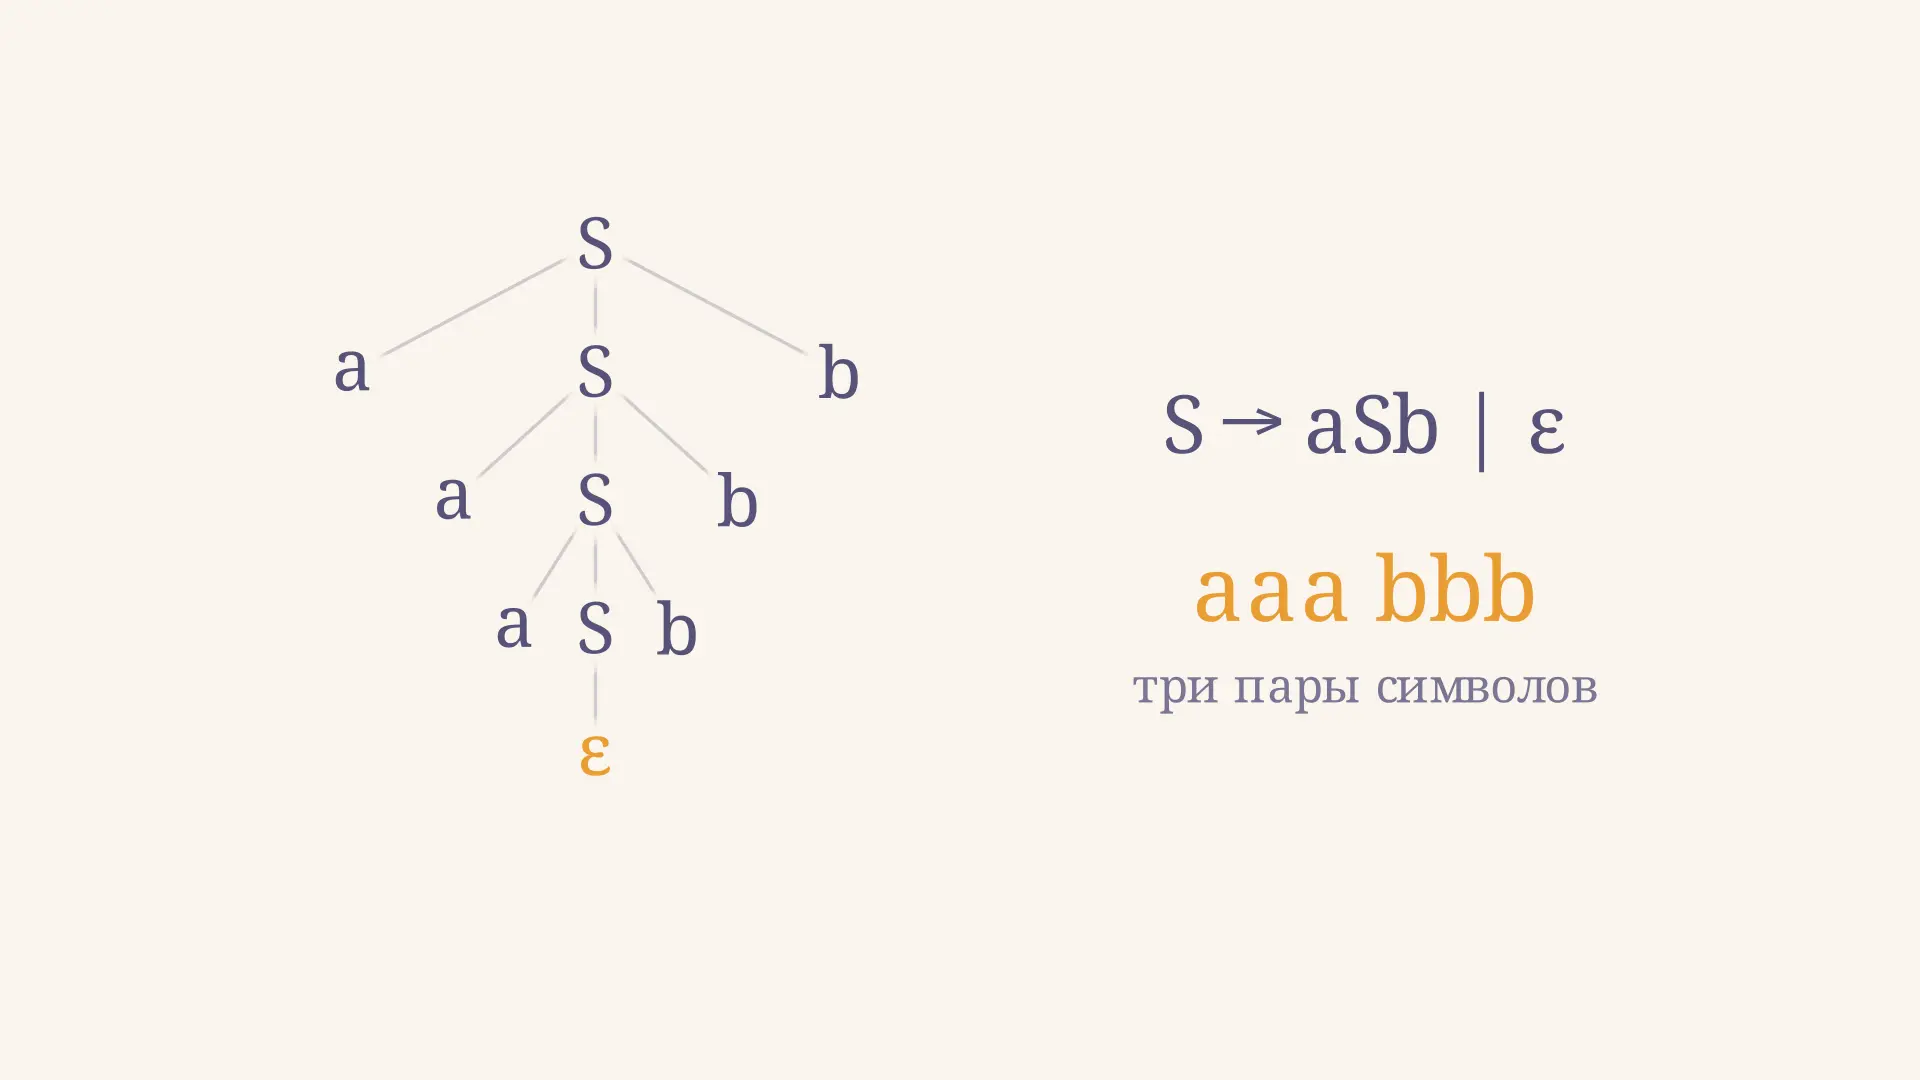
Контекстно-свободная грамматика - это набор правил, который строит строки из начального символа, последовательно заменяя отдельные нетерминалы. Она позволяет описать вложенные конструкции: например, поставить столько же букв после группы букв , сколько букв было в первой группе. Меняя число пар в инструменте, проследите, как рекурсивное правило создаёт слово, а завершающее правило убирает последний нетерминал.
Из чего состоит грамматика
Формально грамматику записывают как . В этой четвёрке:
- - конечное множество нетерминалов, промежуточных обозначений синтаксических категорий;
- - конечный алфавит терминалов, из которых состоят готовые слова; множества и не пересекаются;
- - конечное множество правил, или продукций;
- - начальный символ, с которого начинают вывод.
Каждое правило имеет вид : слева стоит ровно один нетерминал , справа - любая конечная последовательность терминалов и нетерминалов, в том числе пустая. Пустую строку обозначают . Символ не добавляет букву в результат: он означает отсутствие символов.
Грамматика задаёт язык - множество всех конечных строк из терминалов, которые можно вывести из . Промежуточная строка ещё может содержать нетерминалы; пока они остались, это не готовое слово языка. Например, - промежуточная форма, а - конечная строка нашего примера.
Почему грамматику называют контекстно-свободной
Правило можно применить к любому вхождению независимо от того, какие символы стоят по соседству. Если промежуточная строка имеет вид , замена даёт : части и остаются на месте и не влияют на допустимость правила. Именно в этом технический смысл слова «контекстно-свободная».
Это не утверждение, что значения слов в естественном языке независимы от ситуации. Здесь «контекст» - окружение нетерминала в формальной строке. Например, у замыканий JavaScript слово «контекст» связано с лексической областью видимости и обозначает другую идею. В грамматике же важно, что выбор правила для не проверяет его соседей.
Вывод языка с одинаковым числом букв
Возьмём , и два правила:
Вертикальная черта разделяет альтернативы: вместо разрешено подставить либо , либо пустую строку. Первое правило добавляет одну слева и одну справа, сохраняя посередине. Второе завершает вывод. Так для трёх пар получаем:
Если первое правило применено раз, перед завершением имеем , а после него - . При сразу получается . Грамматика задаёт в точности язык : все предшествуют всем , и их количества равны. Строка сюда не входит, хотя обеих букв в ней поровну: порядок тоже является условием.
Обоснование работает в обе стороны. Каждое рекурсивное применение добавляет ровно одну пару и сохраняет порядок; других способов добавить буквы нет. Наоборот, для любого неотрицательного достаточно раз выбрать первое правило и один раз второе. Поэтому ни лишних строк, ни пропущенных значений не возникает.
Ещё один способ увидеть устройство правила - сравнить соседние значения. Для двух пар вывод заканчивается словом , а для трёх - словом . Новая буква возникает перед центральным нетерминалом, новая - после него. Поэтому при добавлении очередной пары прежние буквы не перемешиваются. Это удобно проверять на графике: каждый шаг увеличивает суммарное число терминалов ровно на два, а завершающая замена на пустую строку его не меняет.
Завершение обязательно: бесконечная последовательность применений первого правила не является готовым словом. Даже если процесс можно продолжать сколь угодно долго, определение языка включает только результаты конечных выводов, в которых нет нетерминалов. С другой стороны, выбор завершения на первом шаге допустим и даёт слово длины ноль.
Дерево разбора и порядок замен
Вывод можно изобразить деревом: корень - , а дети каждого нетерминала соответствуют правой части выбранного для него правила. У узла , раскрытого по правилу , три потомка: , и . Последний раскрывается в . Читая терминальные листья слева направо и пропуская пустую строку, получаем .
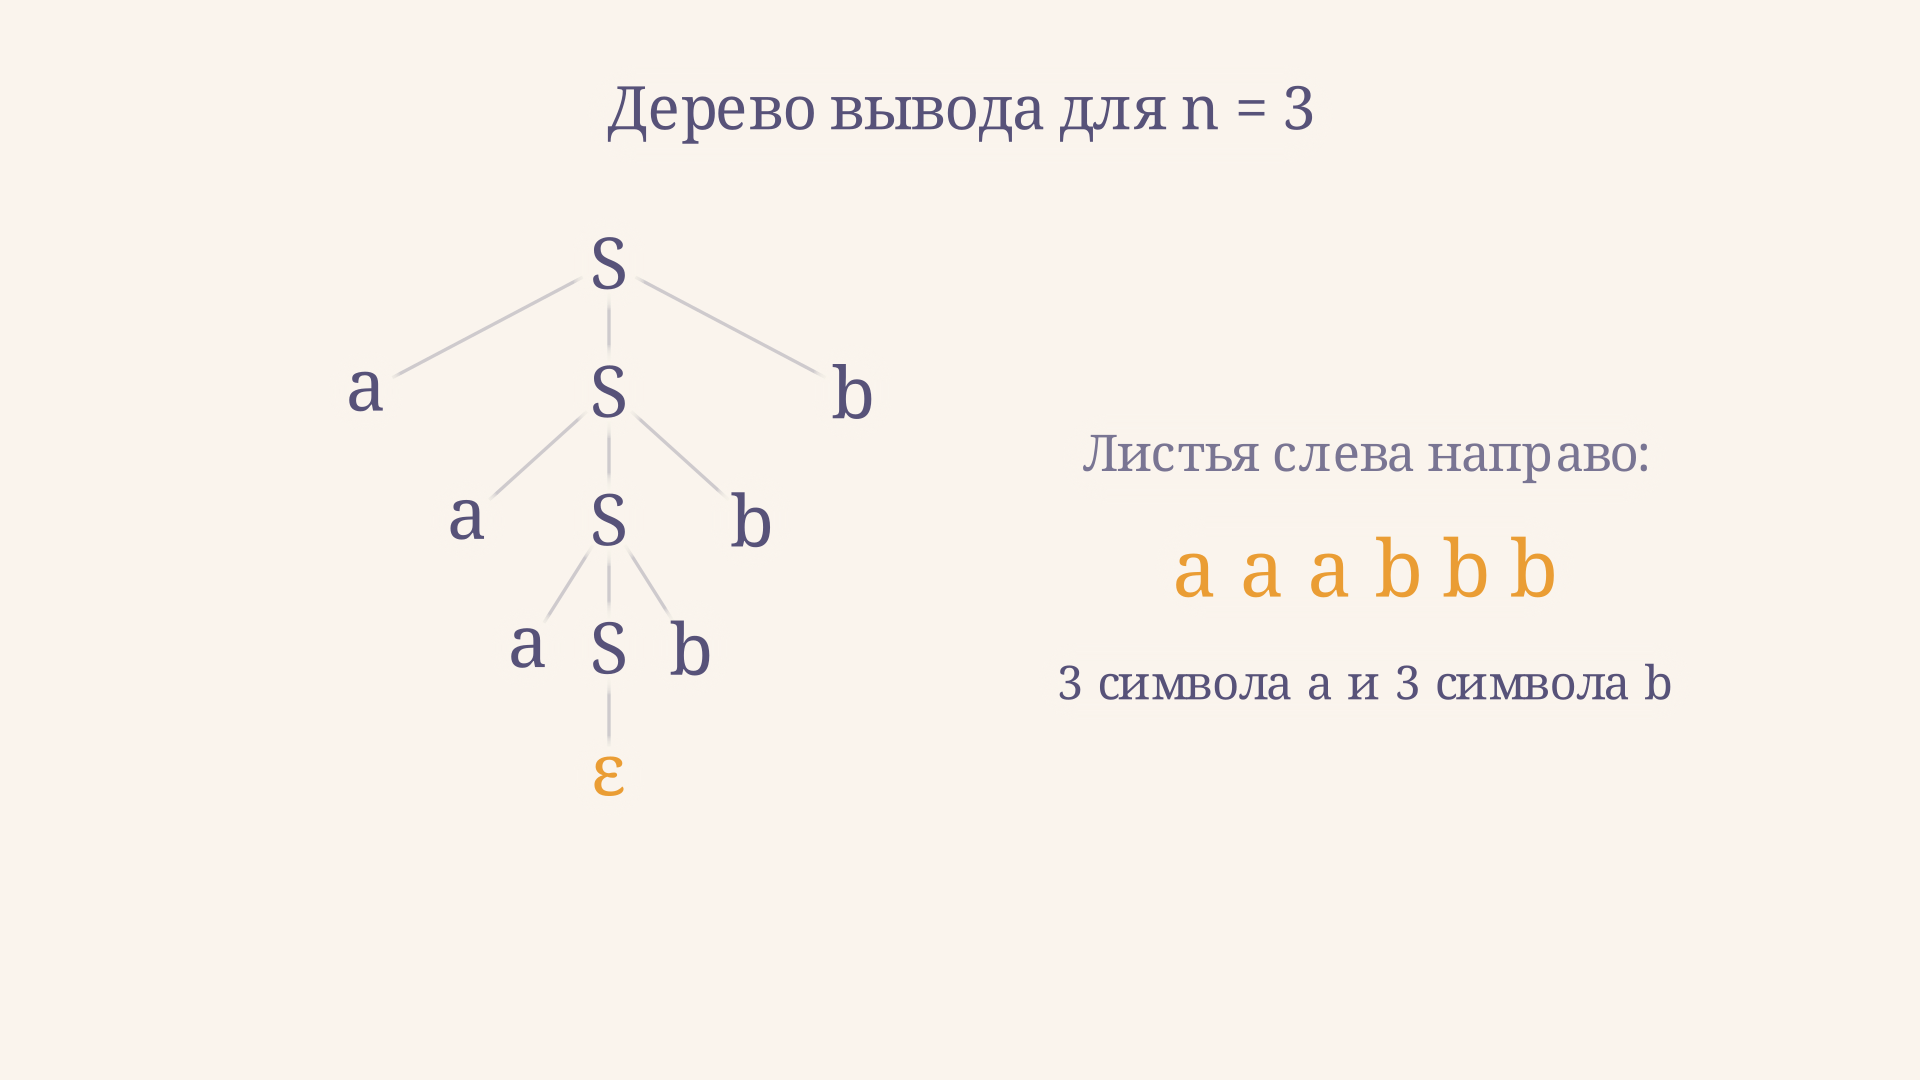
В этом дереве три рекурсивных узла добавляют по паре букв: итог содержит три , три и шесть терминалов. Корень, внутренние узлы и листья - общие понятия теории деревьев; отдельно разобраны высота и глубина дерева. В учебных рисунках часто показывают отдельным листом, хотя в самом слове символа для него нет.
Когда в промежуточной форме несколько нетерминалов, их можно раскрывать в разном порядке. Левосторонний вывод всегда выбирает самый левый, правосторонний - самый правый. Разный порядок замен сам по себе ещё не означает разные деревья: структуру определяют применённые правила и их связи, а не хронология независимых шагов.
Неоднозначность: одно слово, два дерева
Рассмотрим другую грамматику: . Для строки возможны два дерева. В одном корневое правило - сложение: получается структура . В другом корневое правило - умножение: структура . Исходная последовательность символов одинакова, но группировка различается.
Грамматику называют неоднозначной, если хотя бы одна строка её языка имеет два разных дерева разбора. Это свойство грамматики, а не просто утверждение о строке вне правил. Иногда ту же совокупность строк можно описать другой, однозначной грамматикой. Для арифметики обычно вводят отдельные уровни выражений и множителей, чтобы умножение связывалось сильнее сложения; ассоциативность также надо задать явно.
Проверка неоднозначности на примере требует именно двух разных деревьев для одной строки. Два вывода с разным порядком раскрытия независимых нетерминалов могут давать одно дерево и тогда ничего не доказывают. Этот критерий соответствует определению разбора в конспекте Корнеллского университета.
Зачем грамматика нужна анализатору
При обработке программы текст обычно сначала разбивают на токены: идентификаторы, числа, знаки операций. Затем синтаксический анализатор проверяет их последовательность по грамматике и строит структуру. Дерево помогает понять, какие части выражения относятся друг к другу; следующие этапы могут проверять типы и имена или выполнять преобразования.
КС-грамматика хорошо описывает рекурсивную вложенность, но одной грамматики часто недостаточно для всех правил языка программирования. Например, согласованность объявления и использования имени обычно проверяют дополнительными средствами. В естественном языке задача ещё сложнее: структура предложения может зависеть от лексики и смысла. Трансформационная грамматика рассматривает более широкую лингвистическую теорию, а универсальная грамматика - гипотезу о языковой способности; их не следует отождествлять с формальным определением КС-грамматики.
Регулярные языки тоже можно задавать грамматиками, но они образуют более узкий класс. Язык контекстно-свободен и не регулярен: конечному автомату с фиксированным числом состояний недостаточно памяти, чтобы для произвольно большого запомнить точное число букв . Связь регулярных выражений и конечных автоматов раскрывает теорема Клини. При этом не всякий формальный язык контекстно-свободен: у класса есть собственные ограничения.
Разбор идёт от готовой последовательности к возможной структуре, а вывод удобно читать в обратном направлении: от начального символа к строке. Это две постановки вокруг одних и тех же правил. Не следует считать, что любой выбранный алгоритм синтаксического анализа одинаково подходит для всех грамматик: при проектировании анализатора важно учитывать форму правил и возможную неоднозначность. Для учебной проверки принадлежности достаточно предъявить корректный конечный вывод; для отказа нужно обосновать, что ни один допустимый вывод данной строки не существует.
Как проверить грамматику в задаче
Сначала выпишите алфавит и условие для строк, включая пустую строку и граничные случаи. Затем найдите повторяющуюся структуру и базу рекурсии. В примере это добавление пары по краям и завершение через . После записи правил выведите несколько разрешённых строк и попытайтесь получить запрещённые: такая проверка помогает заметить ошибки, но конечного набора примеров недостаточно для доказательства.
Для полного обоснования покажите два включения: любой завершённый вывод удовлетворяет условию, и любую строку, удовлетворяющую условию, можно вывести. В первом направлении удобно доказать инвариант каждого шага; во втором - предложить конкретную последовательность правил для произвольной строки. Отдельно проверьте, не осталось ли нетерминалов и не изменился ли нужный порядок символов.
Частые ошибки
- Считать обычным символом. Он обозначает пустую строку и не входит в длину слова.
- Принимать промежуточную форму за слово языка. Строка с ещё не состоит только из терминалов.
- Проверять только равенство количеств. Для все буквы должны идти раньше всех .
- Путать два вывода с двумя деревьями. Разный порядок независимых замен может сохранить одну структуру.
- Делать вывод по нескольким примерам. Для совпадения языка грамматики с заданным множеством нужны оба включения.
FAQ
Может ли КС-грамматика породить пустую строку?
Да. В примере правило позволяет получить её сразу. Но наличие пустого слова зависит от конкретных правил и не обязательно для каждой грамматики.
Любая ли КС-грамматика рекурсивна?
Нет. Правила могут вообще не возвращаться к уже встреченному нетерминалу. Рекурсия полезна для компактного описания неограниченной вложенности, но не входит в определение.
Всегда ли у строки есть единственное дерево?
Нет. У строки, не принадлежащей языку грамматики, нет дерева разбора; у принадлежащей может быть одно или несколько. Последний случай свидетельствует о неоднозначности данной грамматики.
Коротко
Контекстно-свободная грамматика заменяет один нетерминал за шаг независимо от его окружения. Правила порождают ровно , а дерево разбора показывает вложенную структуру вывода. Чтобы обосновать решение задачи, проверяйте и отсутствие лишних слов, и возможность вывести каждое требуемое слово.
Читайте также
Магазинный автомат: стек, переходы и примеры
Магазинный автомат простыми словами: как состояние и стек управляют переходами, как разобрать скобки и язык aⁿbⁿ, чем различаются условия принятия и связь с грамматиками.
Регулярная грамматика: правила, примеры и автомат
Регулярная грамматика простыми словами: как устроены праволинейные правила, как вывести слово, построить конечный автомат и проверить границы модели на примерах.
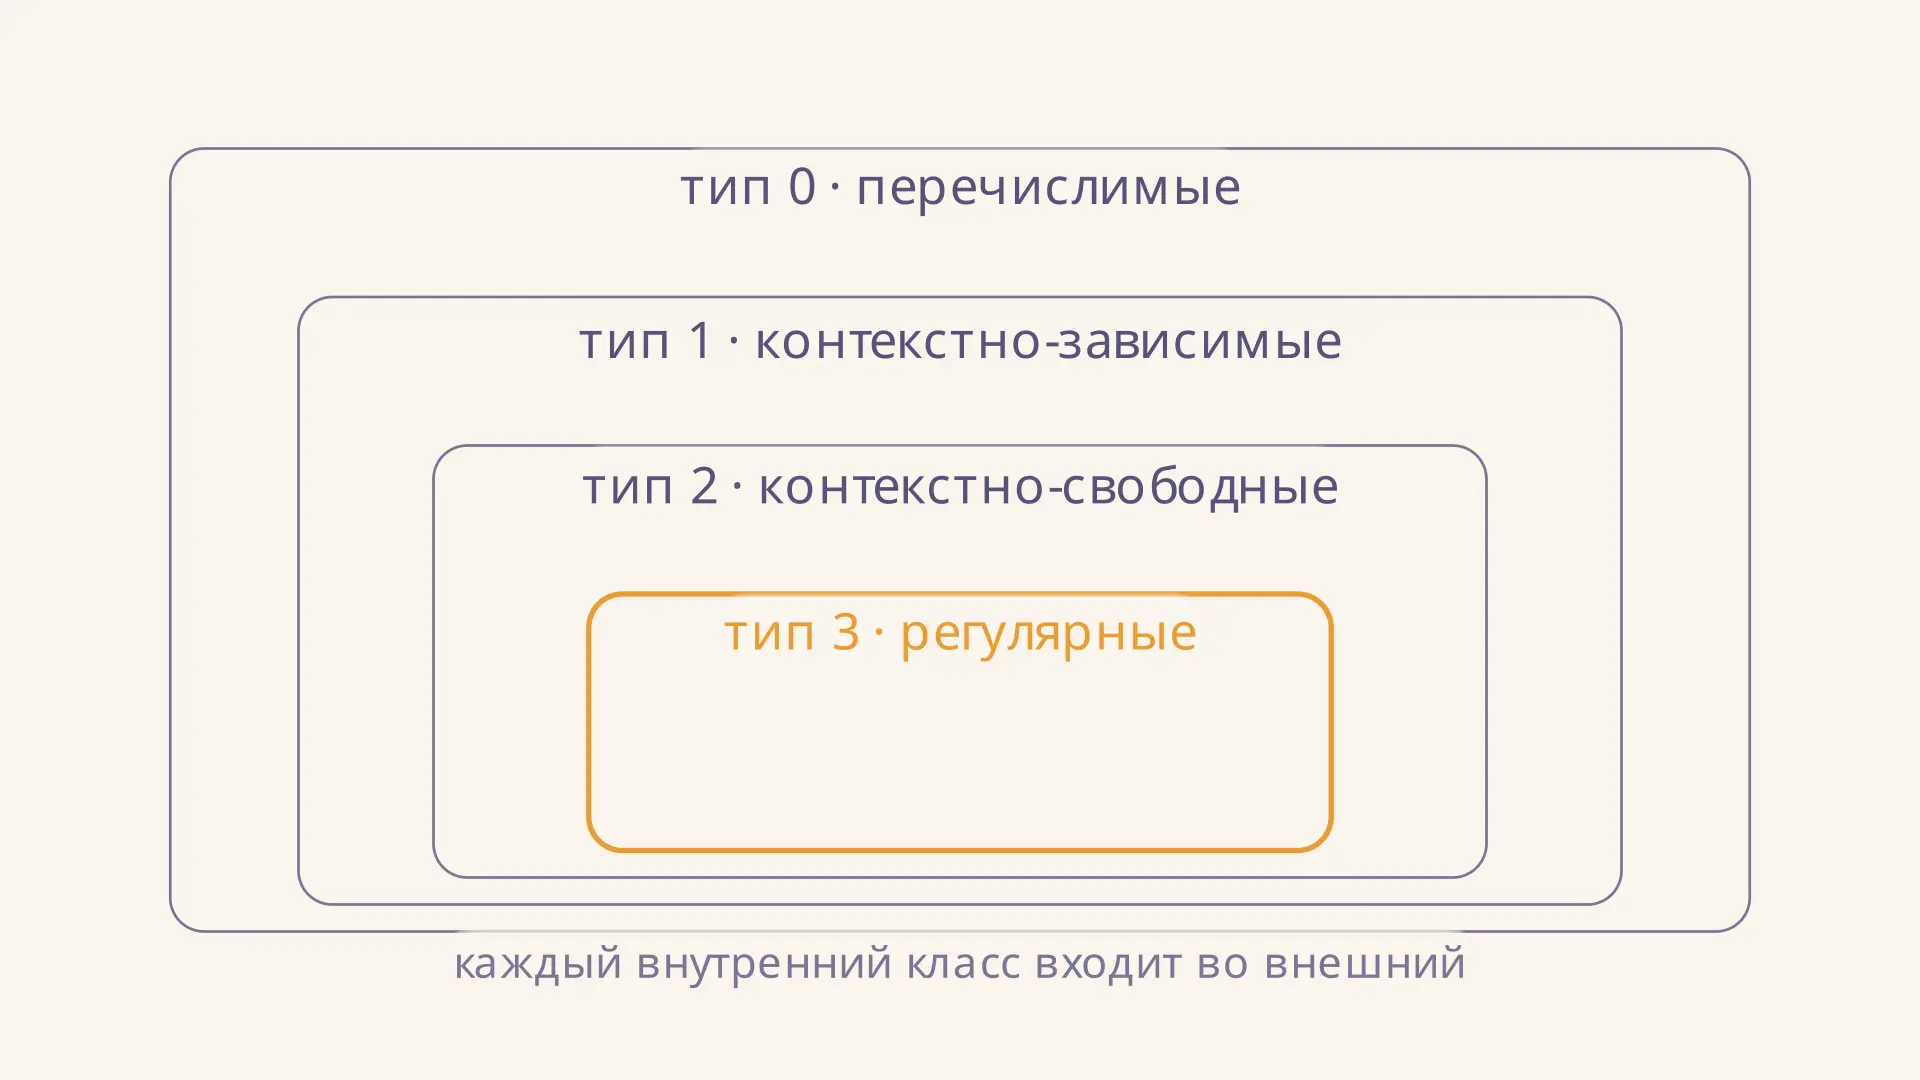
Иерархия Хомского: типы грамматик и автоматы
Иерархия Хомского простыми словами: четыре типа формальных грамматик, вложенность классов языков, соответствующие автоматы и примеры для решения учебных задач.
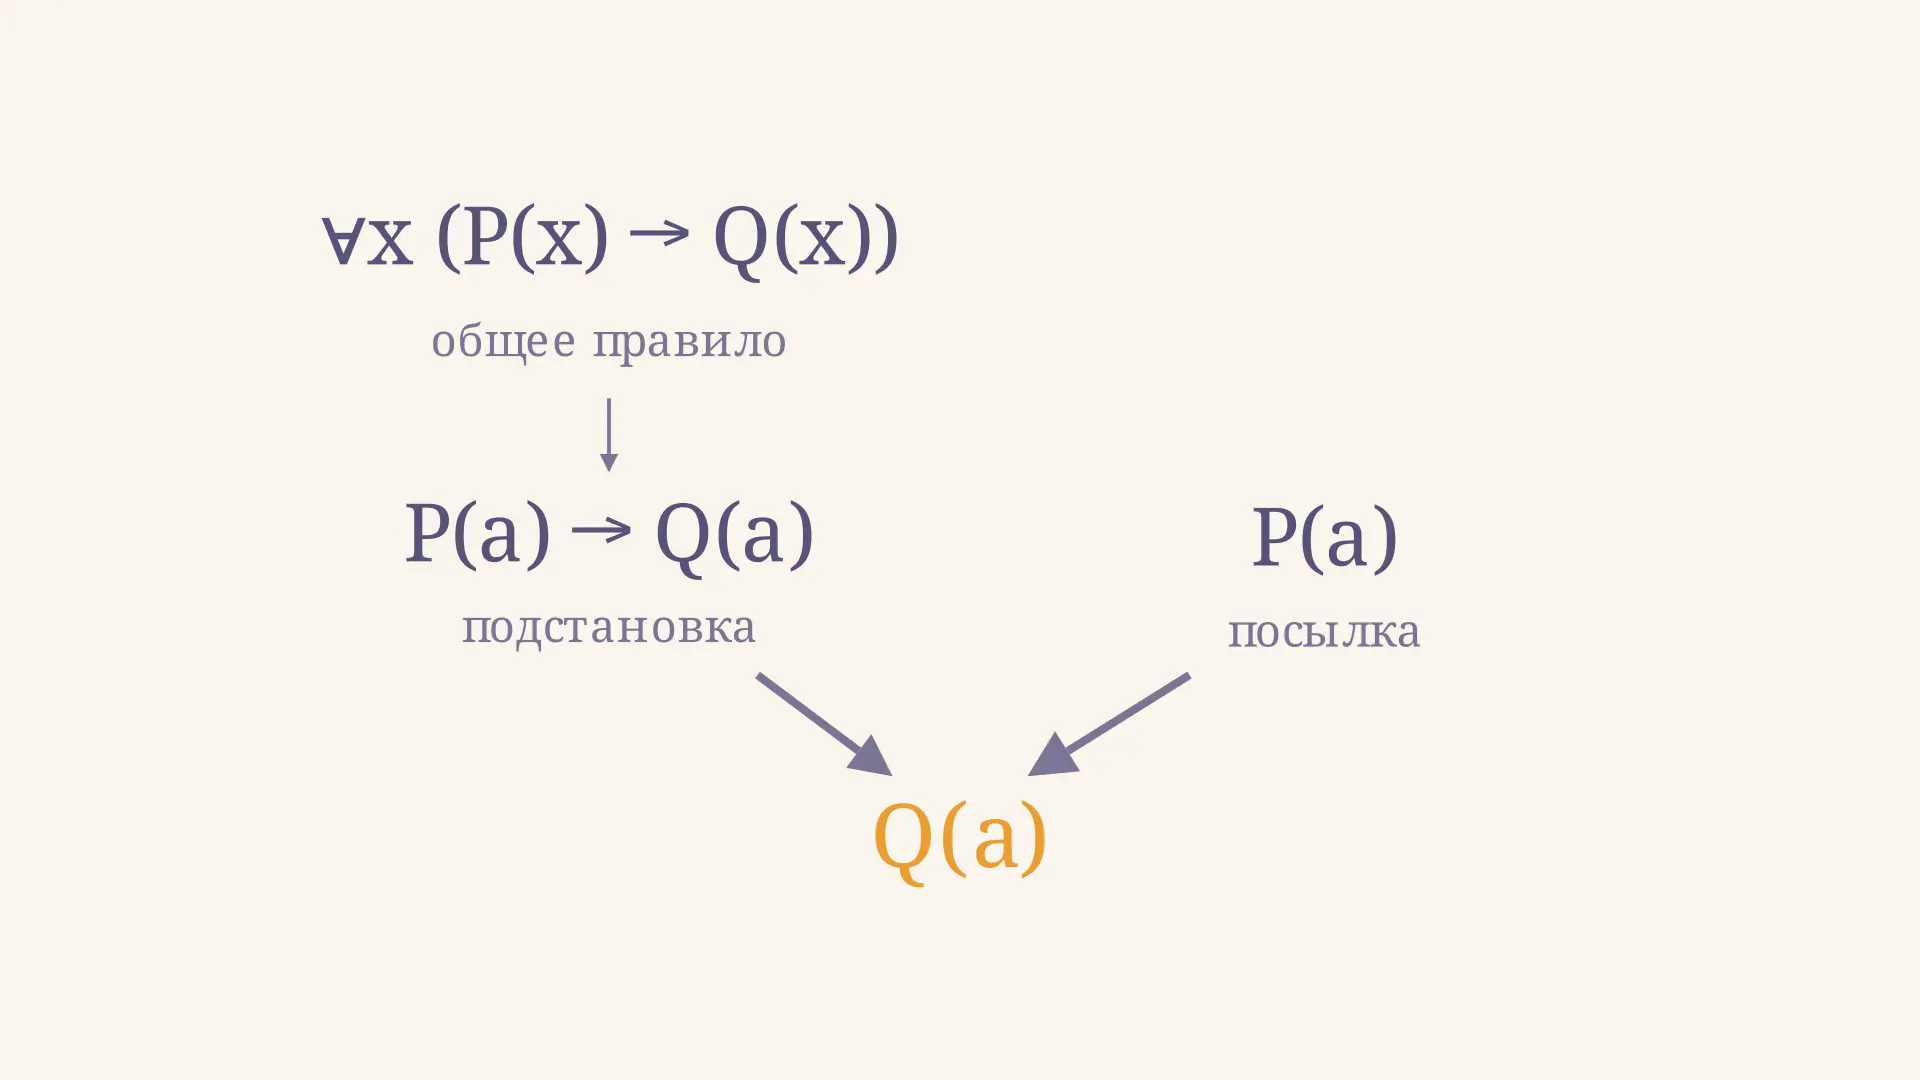
Исчисление предикатов: язык, формулы и правила вывода
Исчисление предикатов описывает свойства объектов и отношения между ними. Разбираем устройство формул, пошаговый пример доказательства и поиск контрмодели.
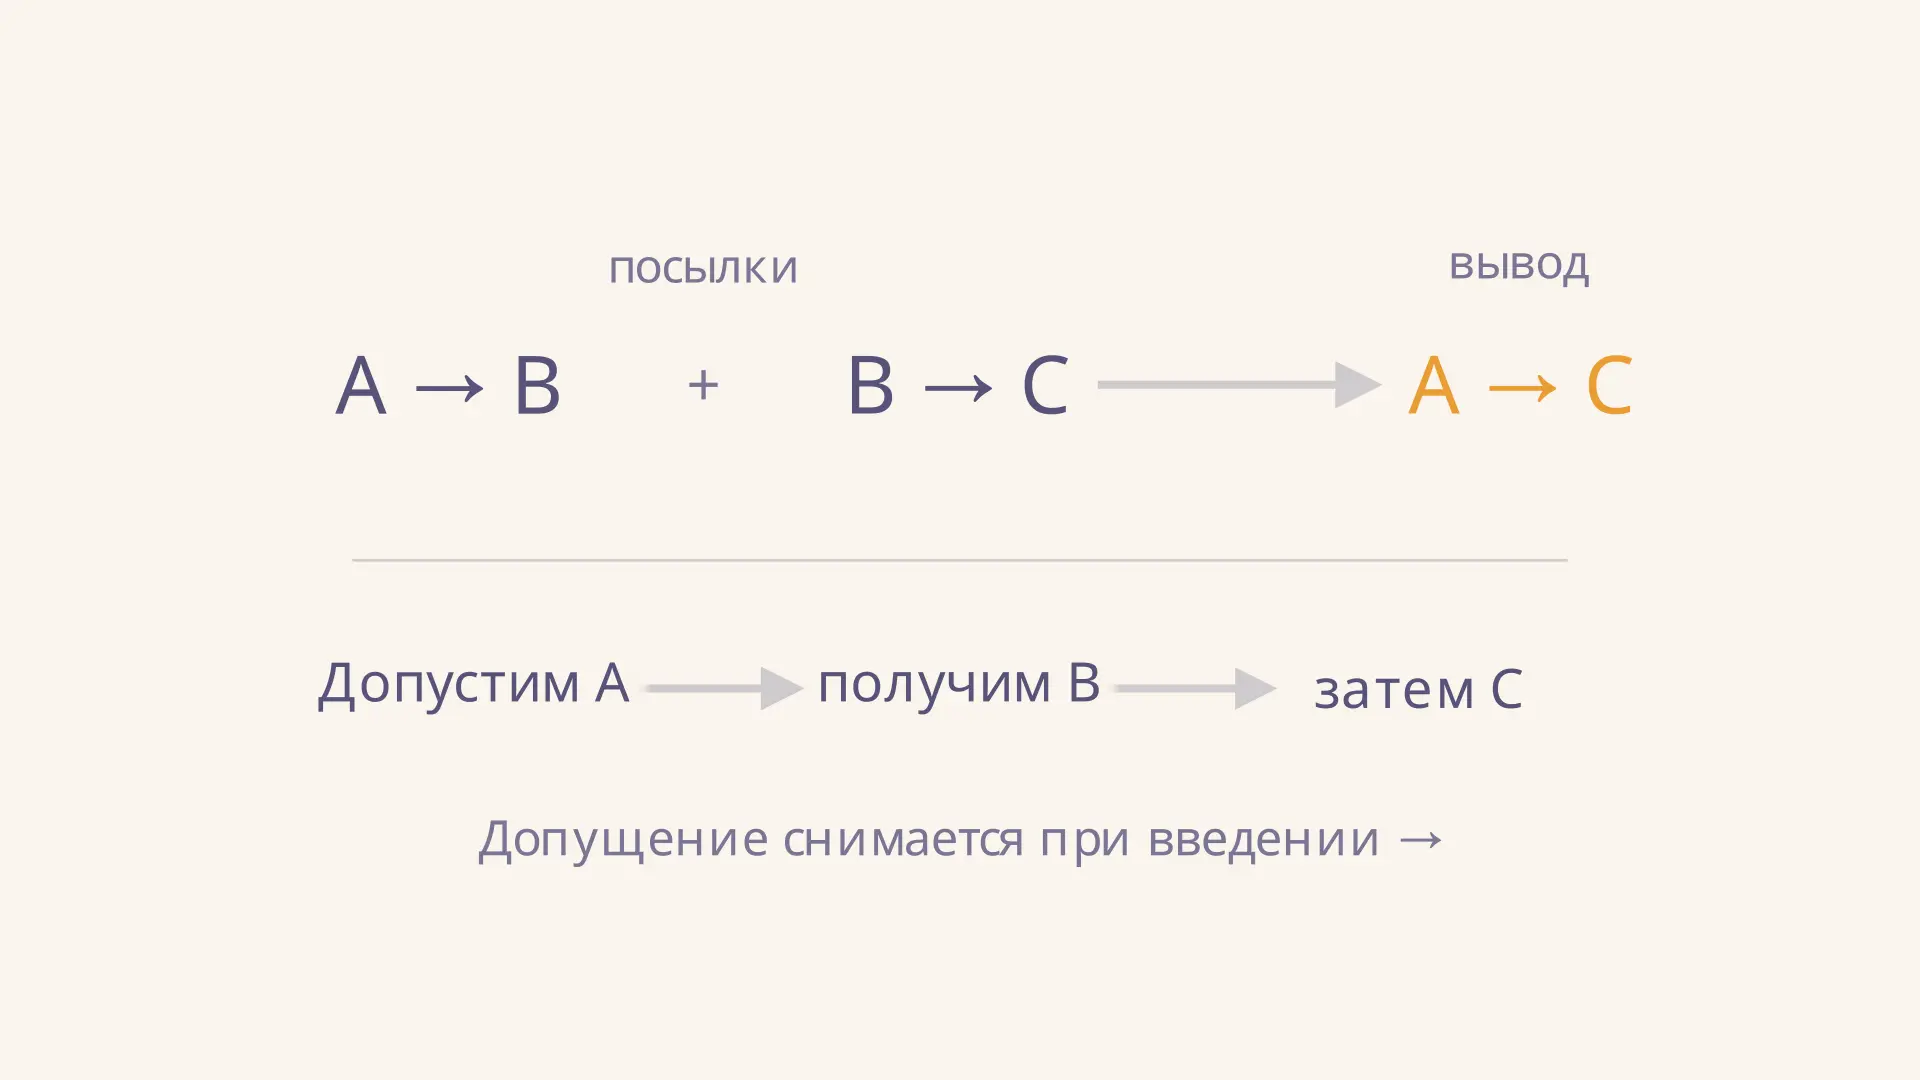
Система натурального вывода: правила и примеры
Система натурального вывода по шагам: правила введения и устранения связок, временные допущения, построение доказательства и типичные ошибки в логике.
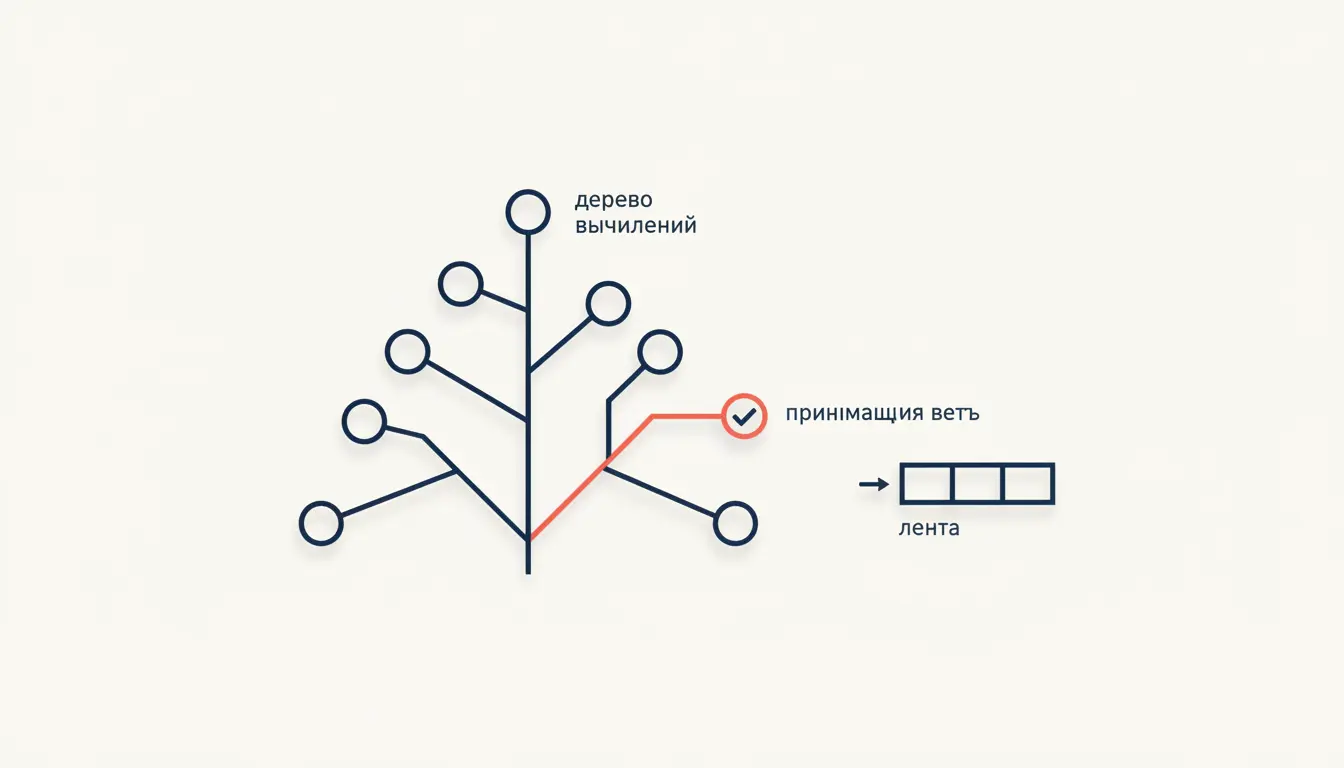
Машина Тьюринга недетерминированная: модель и сила
Машина Тьюринга недетерминированная (НМТ): чем отличается от детерминированной, как работает дерево вычислений, почему она не сильнее по разрешимости и при чём тут класс NP.