Иерархия Хомского: типы грамматик и автоматы
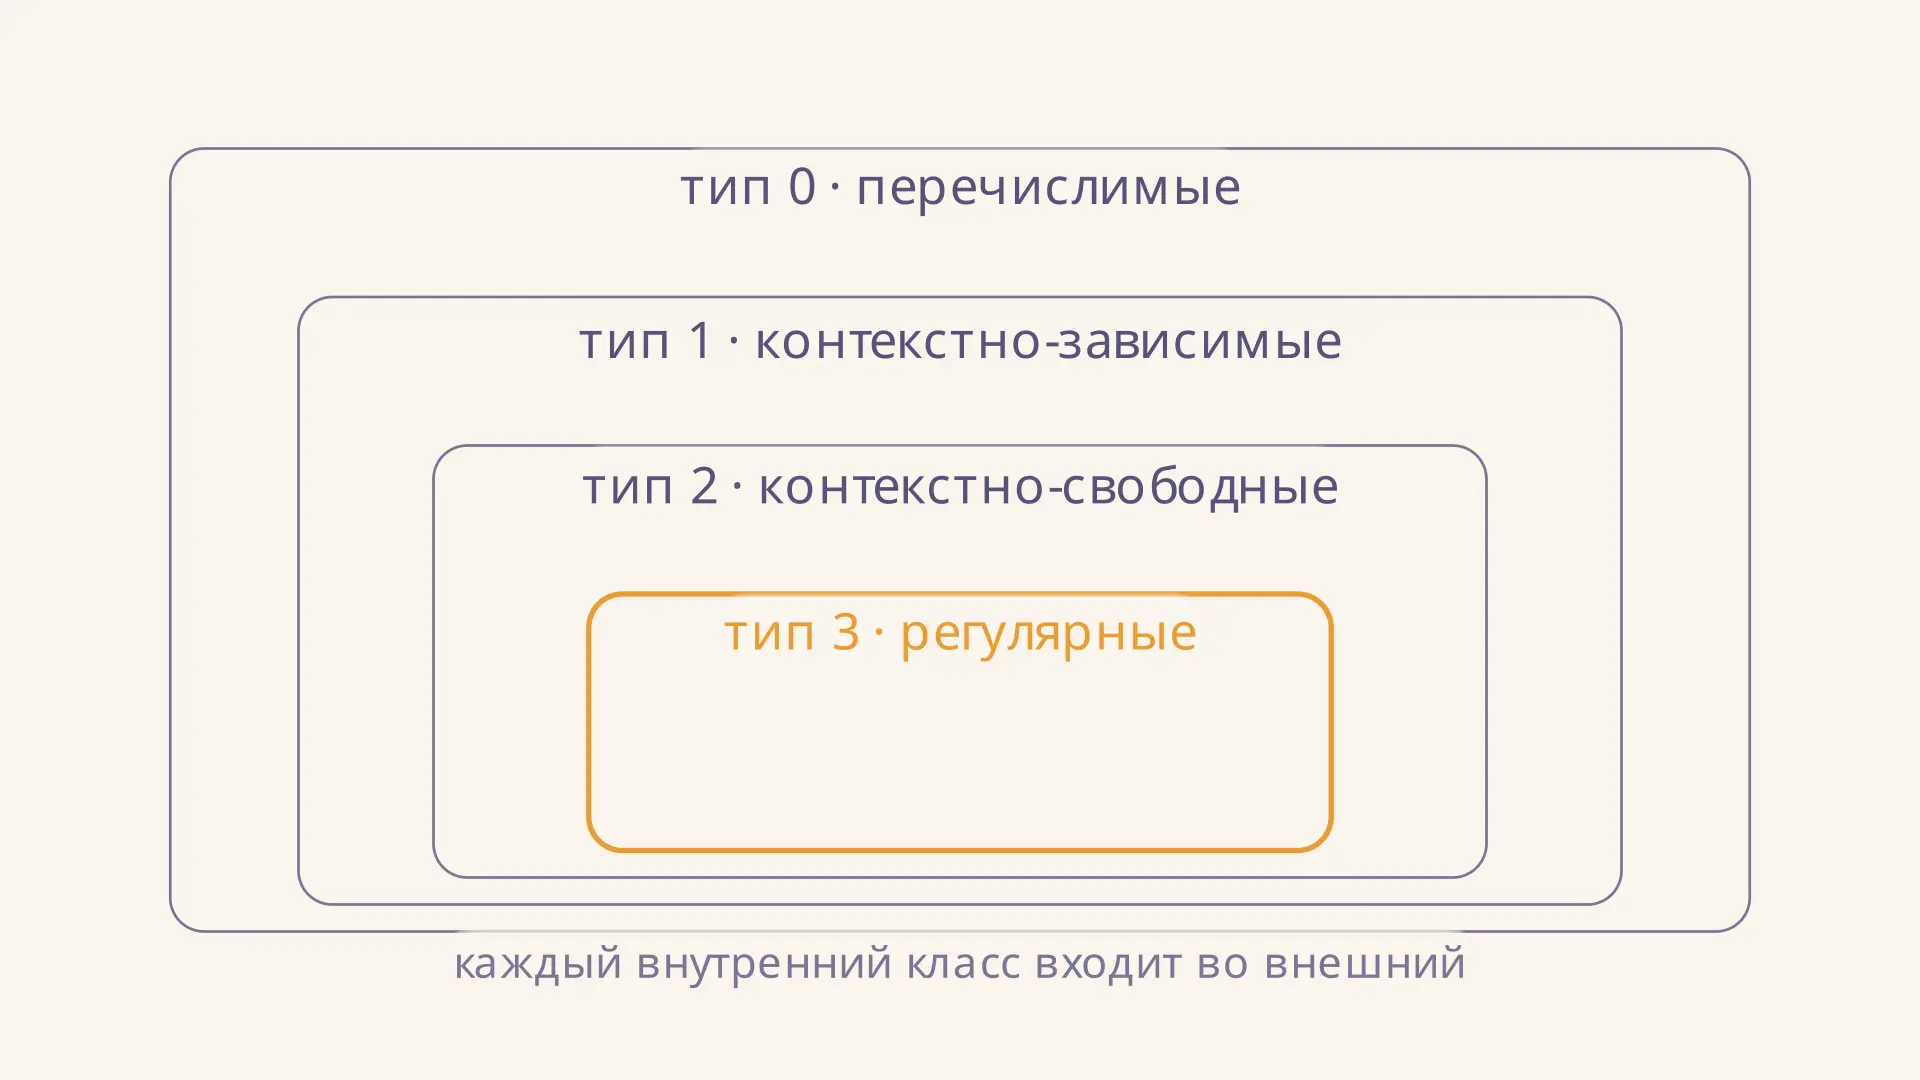
Иерархия Хомского делит формальные языки на четыре вложенных класса по тому, какие грамматики могут их порождать. Чем меньше ограничений на правила вывода, тем шире класс возможных языков. Ту же шкалу удобно читать через автоматы: конечного числа состояний хватает для регулярных языков, а для более сложных зависимостей нужна другая модель памяти.
Ниже сравним все четыре уровня и разберём, почему классификация конкретной грамматики и поиск минимального класса языка - разные задачи. Сначала выберите пример: инструмент поможет построить объяснение и проверить ход рассуждения.
Язык, грамматика и вложенность классов
Формальный алфавит - конечный набор символов, например . Слово - конечная последовательность этих символов; пустое слово обозначают . Язык - множество слов над алфавитом, в том числе, возможно, бесконечное. Например, состоит из любого числа букв , за которыми следует любое число букв .
Грамматика задаёт язык при помощи конечного набора правил. Помимо терминалов, которые остаются в готовом слове, она использует нетерминалы - вспомогательные символы, подлежащие замене. Вывод начинается со стартового символа и заканчивается, когда остаются только терминалы. Скажем, правила и порождают , , и другие слова вида при .
Четыре класса принято нумеровать в обратном порядке от ограниченного к общему: тип 3 ⊊ тип 2 ⊊ тип 1 ⊊ тип 0. Включения строгие: на каждом переходе появляются языки, которых на предыдущем уровне нет. Такую последовательность ограничений Хомский исследовал в работе 1959 года.
Тип 3: регулярные языки
В праволинейной грамматике правила имеют вид , и, в принятой конвенции, могут включать завершение . Здесь и - нетерминалы, - терминал. Леволинейные правила дают тот же класс, но смешивать направления произвольно нельзя: такая грамматика уже не обязательно регулярна.
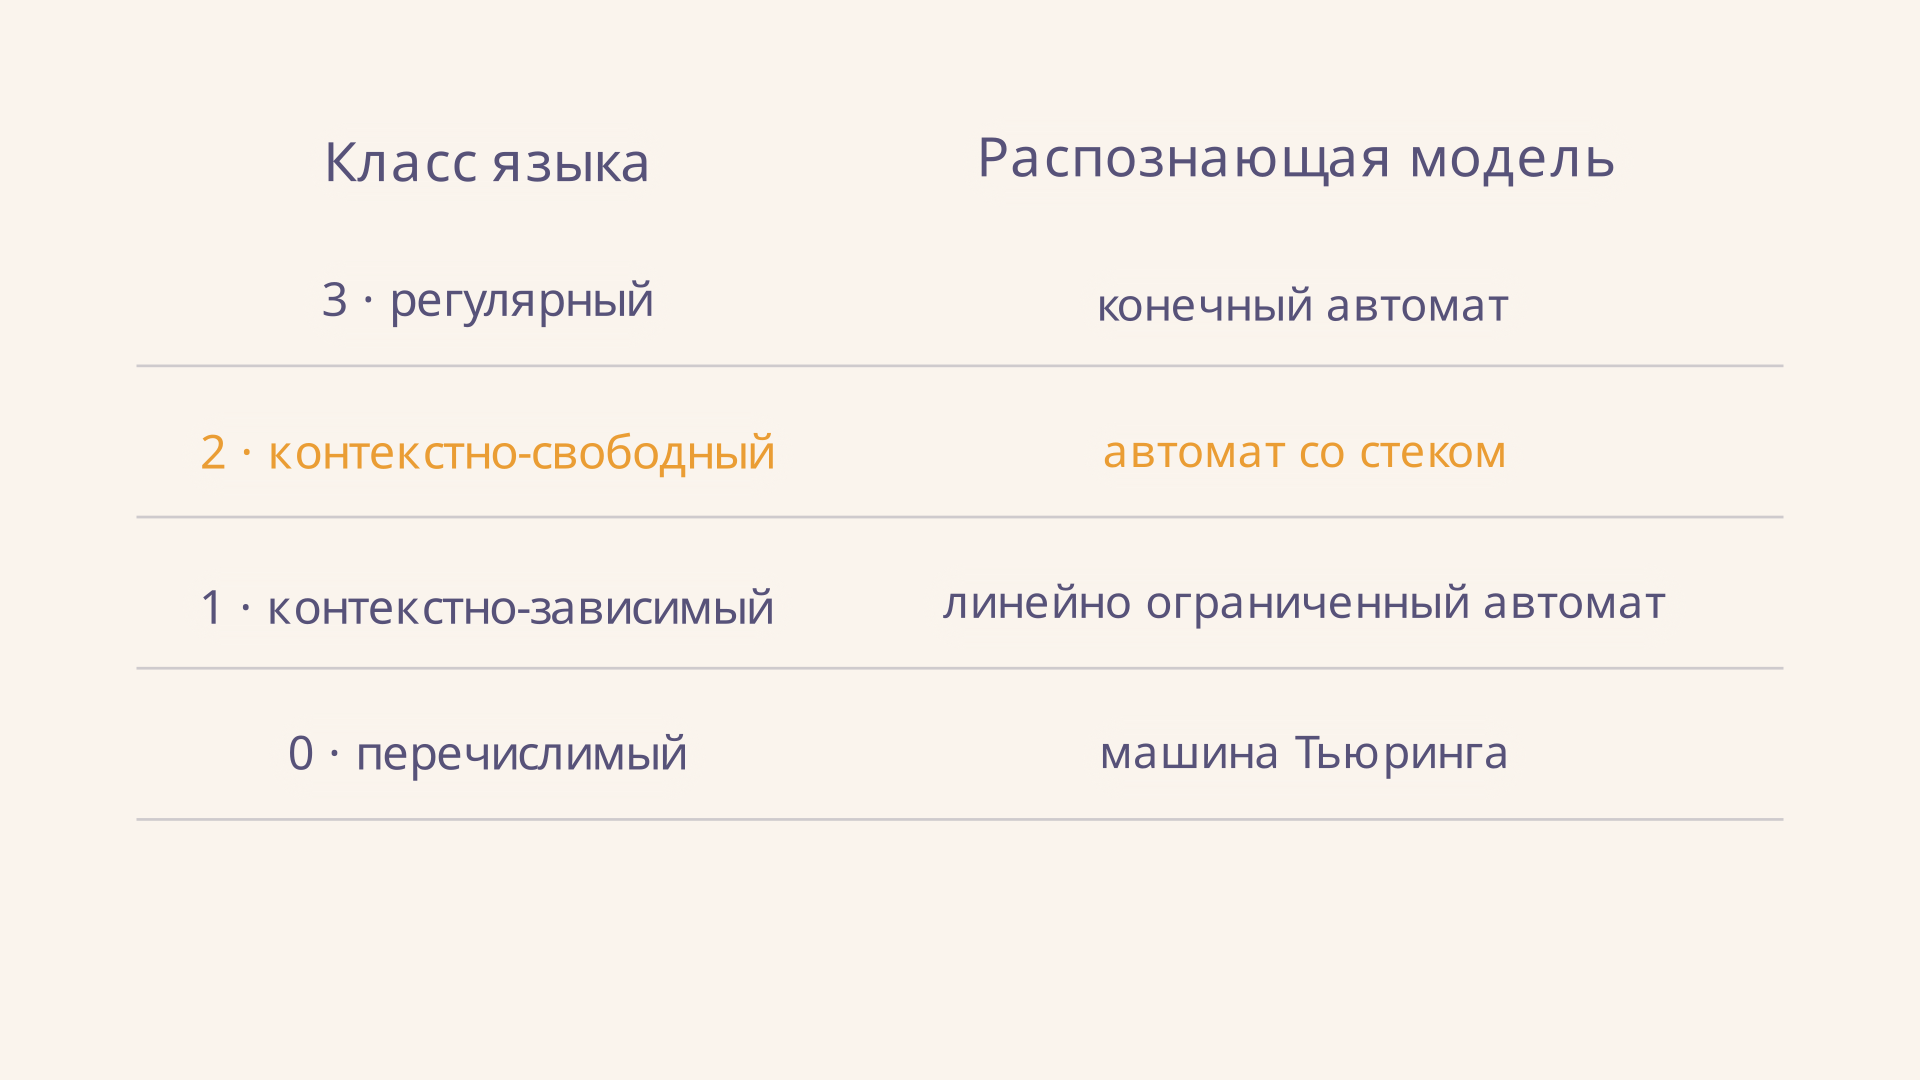
Регулярные языки распознаёт конечный автомат. Его состояние хранит лишь одно из конечного числа возможных состояний; отдельной неограниченной памяти у модели нет. Например, автомат для помнит, начались ли уже буквы , и отвергает после этого момента. Связь с регулярными выражениями раскрывает теорема Клини.
Тип 2: контекстно-свободные языки
У контекстно-свободного правила слева стоит ровно один нетерминал: , где - строка терминалов и нетерминалов, возможно пустая. Правило применимо независимо от соседей этого вхождения . Поэтому грамматика для выше относится к типу 2: правило не является праволинейным, но слева у него один нетерминал.
Язык не регулярен. Интуиция такова: число первых букв не ограничено, а конечному автомату нужно было бы различать сколь угодно много значений, чтобы проверить равное число вторых. Формально это доказывают, например, леммой о накачке или теоремой Майхилла - Нероуда; нескольких проверенных слов для доказательства недостаточно.
Соответствующая модель - недетерминированный магазинный автомат. В этом примере он кладёт символ в стек на каждой , затем снимает по одному на каждой . Порядок блоков и пустота стека помогают проверить равенство. Стек допускает вложенность, но доступен только с вершины; детерминированные магазинные автоматы распознают не все контекстно-свободные языки.
Как доказать, что примера типа 3 недостаточно
Для языка парных блоков можно провести короткое доказательство от противного с помощью леммы о накачке. Предположим, что он регулярен, и обозначим через соответствующую длину накачки. Выберем слово из букв , за которыми идут букв . Лемма утверждает, что его можно разбить на три части так, чтобы средняя часть была непуста, первые две вместе имели длину не более , а повторение средней части любое число раз оставляло слово в языке.
Но первые позиций заняты только буквами . Значит, средняя часть любого допустимого разбиения состоит только из них. Если удалить её, букв станет меньше, чем букв ; полученное слово уже не принадлежит исходному языку. Противоречие показывает, что конечного автомата для всего языка не существует. Порядок кванторов здесь важен: нужно исключить каждое допустимое разбиение выбранного слова, а не только одно удобное.
Это доказательство устанавливает нижнюю границу, а приведённая выше грамматика - верхнюю. Вместе они дают точный ответ: минимальный класс языка в рассматриваемой иерархии - тип 2. Для отдельного конечного набора слов рассуждение было бы другим: любой конечный язык регулярен, поскольку автомат может хранить достаточно состояний для всех его слов.
Тип 1: контекстно-зависимые языки
Типичное правило контекстно-зависимой грамматики имеет форму : заменить на непустую строку можно в указанном окружении и . Эквивалентная по порождаемым языкам формулировка использует неукорачивающие правила: правая часть не короче левой. Для пустого слова допускают специальное исключение , если стартовый символ не появляется справа.
Классический пример языка этого уровня - . В нём три последовательных блока одинаковой длины. Он контекстно-зависим, но не контекстно-свободен: для второго утверждения требуется доказательство, например лемма о накачке для контекстно-свободных языков. Просто указать, что «нужны два счётчика», полезно для интуиции, но недостаточно как доказательство.
Типу 1 соответствует недетерминированный линейно ограниченный автомат: вариант машины Тьюринга, использующий объём ленты, ограниченный линейной функцией длины входа. Его рабочая память растёт вместе со словом, но не произвольно. В отличие от одного стека, лента позволяет возвращаться к разным позициям и менять пометки.
Тип 0: перечислимые языки
Грамматики типа 0 называют неограниченными: в правилах левая часть содержит хотя бы один нетерминал, а правая может быть произвольной строкой. Они порождают вычислимо перечислимые языки. Их распознаёт машина Тьюринга: для слова из языка она когда-нибудь остановится с принятием, а для слова вне языка может отвергнуть его или работать бесконечно.
Это различие принципиально. Разрешимый язык имеет алгоритм, который останавливается с правильным ответом на любом входе. Каждый разрешимый язык перечислим, но не каждый перечислимый разрешим. Поэтому машина, распознающая язык типа 0, не обязана всегда выдавать ответ «нет». Об устройстве модели и кодировании вычислений рассказывает статья про универсальную машину Тьюринга; недетерминированная машина помогает отдельно разобраться с ветвлением вычислений.
Как определить тип в задаче
Сначала выпишите правила целиком и проверьте ограничения по порядку: праволинейность, один нетерминал слева, неукорачивание с учётом исключения для . Если вся грамматика удовлетворяет правилам типа 3, она подходит и под более общие классы. В учебном ответе обычно называют самый ограниченный подходящий тип и обосновывают его формой каждого правила.
Затем уточните, спрашивают ли о грамматике или о языке. Одна грамматика может не иметь регулярной формы, но порождать регулярный язык: например, , , - грамматика типа 2, а её язык конечен и потому регулярен. Вид имеющихся правил даёт верхнюю границу для класса языка, но сам по себе не доказывает минимальность. Для нижней границы понадобится отдельный аргумент о невозможности более простой модели.
Иерархия формальных языков связана с исследованиями Хомского, но не тождественна его гипотезам о врождённой способности к языку. Последние рассматриваются в статье об универсальной грамматике. В программировании же регулярные модели полезны для многих лексических шаблонов, а контекстно-свободные грамматики - для описания вложенного синтаксиса. Реальный компилятор дополнительно проверяет свойства, которые одна грамматика может не выразить удобно.
Что иерархия говорит о практике
Выбор класса описывает выразительные возможности модели, а не гарантирует одинаковое быстродействие всех реализаций. Две грамматики одного типа могут заметно различаться удобством разбора и размером описания. Даже если синтаксическую конструкцию можно выразить более общей моделью, разработчик часто выбирает ограниченную грамматику: её легче анализировать и сопровождать.
При этом семантические ограничения программы, например соответствие имён объявлениям, обычно проверяют отдельным этапом. Поэтому вопрос «какой класс у языка программирования целиком» нельзя решить одной ссылкой на грамматику синтаксиса: сначала нужно договориться, какие именно строки и какие проверки включены в определение языка. Для учебной задачи такая договорённость столь же важна, как выбор алфавита и указание, входит ли пустое слово.
Частые ошибки
- Переворачивать включения. Каждый регулярный язык контекстно-свободен, но не наоборот.
- Считать ограничение правила свойством языка. Другая грамматика может породить тот же язык и иметь более простой тип.
- Забывать пустое слово. При определении типа 1 нужно явно указать принятую конвенцию и исключение для .
- Путать распознавание с разрешением. Машина для языка типа 0 может не остановиться на слове вне языка.
- Доказывать неравенство классов набором примеров. Для отрицательного утверждения нужен общий аргумент, а не проверка нескольких длин.
FAQ
Все ли контекстно-свободные языки регулярны?
Нет. Язык контекстно-свободен, но не регулярен. При этом любой регулярный язык входит в контекстно-свободный класс.
Почему для типа 2 указан недетерминированный автомат?
Потому что именно недетерминированные магазинные автоматы распознают весь класс контекстно-свободных языков. Детерминированные распознают его собственный подкласс.
Всегда ли можно по правилам найти минимальный класс языка?
Нет. Проверка формы правил определяет тип данной грамматики и даёт верхнюю границу для её языка. Чтобы установить минимальный класс, может потребоваться другое представление языка и доказательство исключения более узких классов.
Коротко
Иерархия Хомского связывает ограничения грамматик с выразительной силой моделей: регулярные языки распознают конечные автоматы, контекстно-свободные - автоматы со стеком, контекстно-зависимые - линейно ограниченные автоматы, вычислимо перечислимые - машины Тьюринга. Для задачи важно отдельно классифицировать заданные правила и обосновать минимальный класс порождаемого ими языка.
Читайте также
Магазинный автомат: стек, переходы и примеры
Магазинный автомат простыми словами: как состояние и стек управляют переходами, как разобрать скобки и язык aⁿbⁿ, чем различаются условия принятия и связь с грамматиками.
Машина Тьюринга недетерминированная: модель и сила
Машина Тьюринга недетерминированная (НМТ): чем отличается от детерминированной, как работает дерево вычислений, почему она не сильнее по разрешимости и при чём тут класс NP.
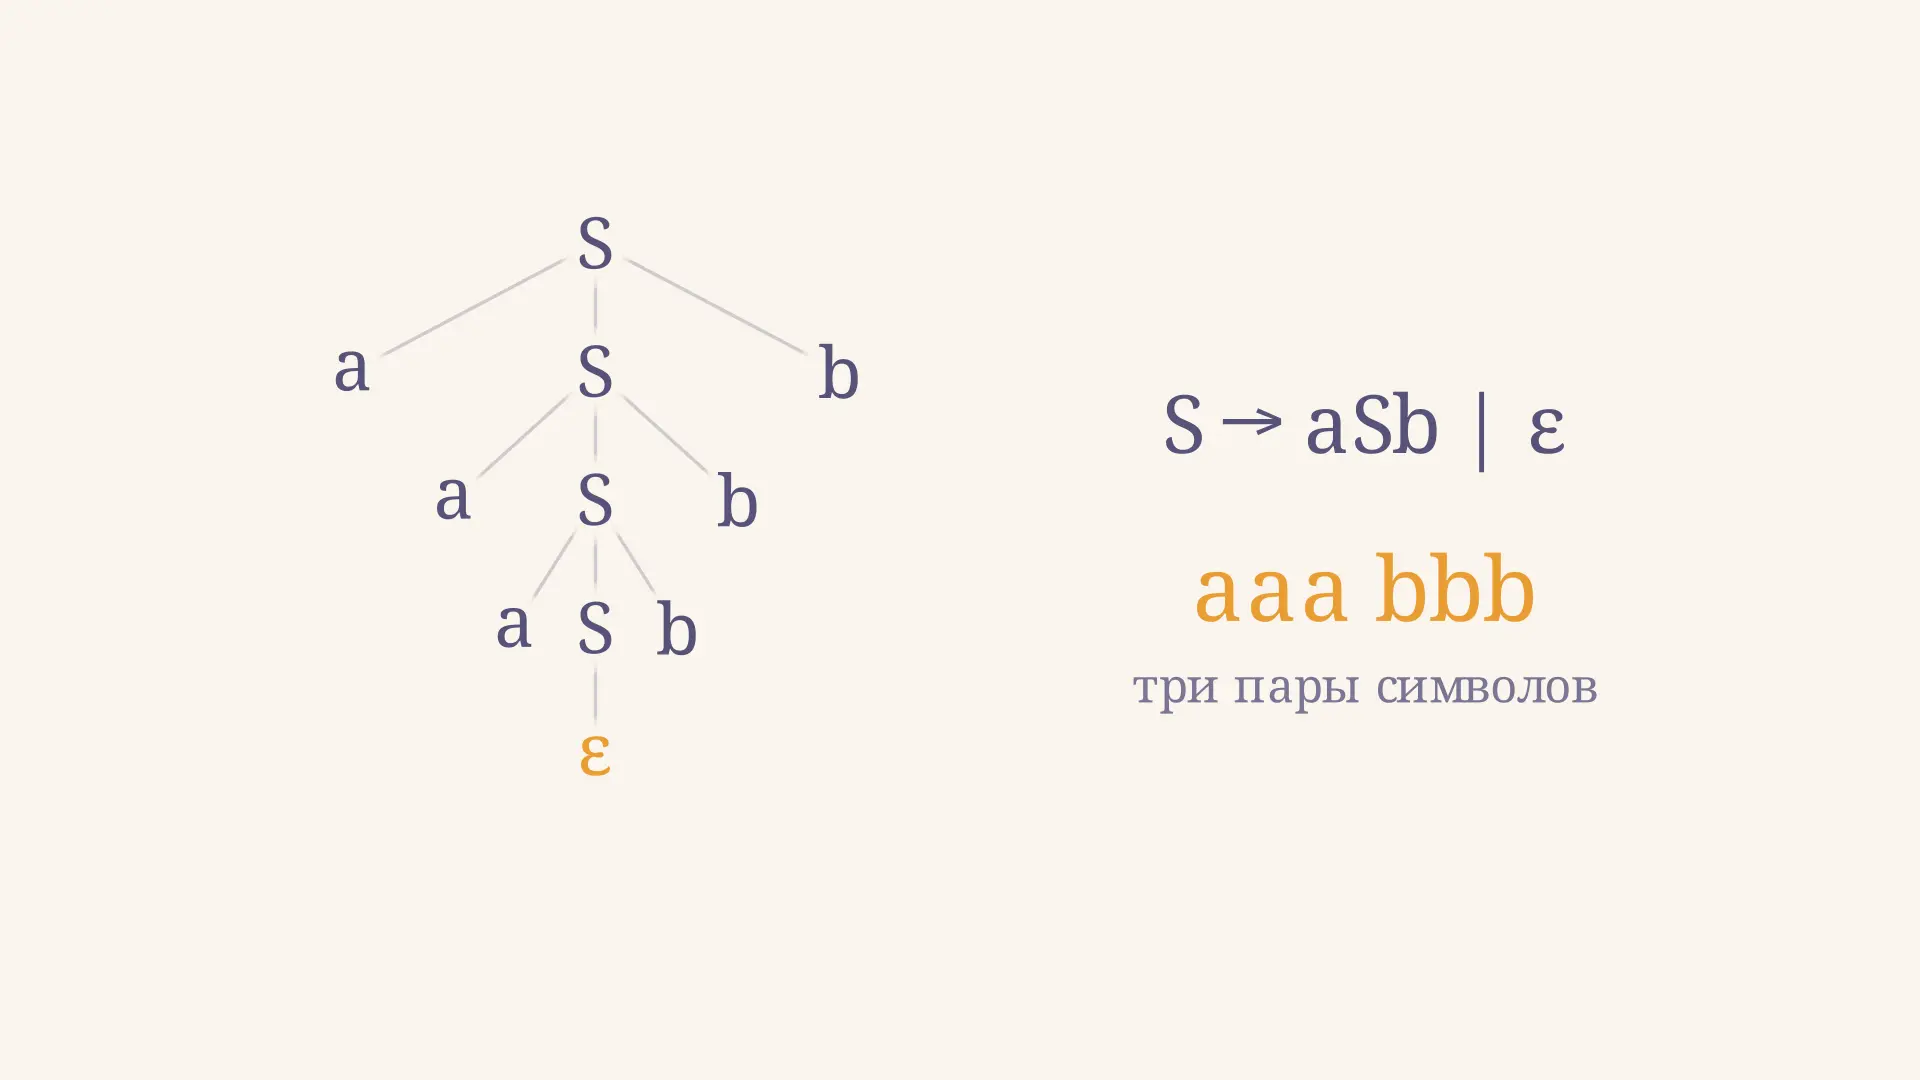
Контекстно-свободная грамматика: правила и примеры
Контекстно-свободная грамматика простыми словами: терминалы и нетерминалы, вывод слова, дерево разбора, неоднозначность и применение при анализе синтаксиса.
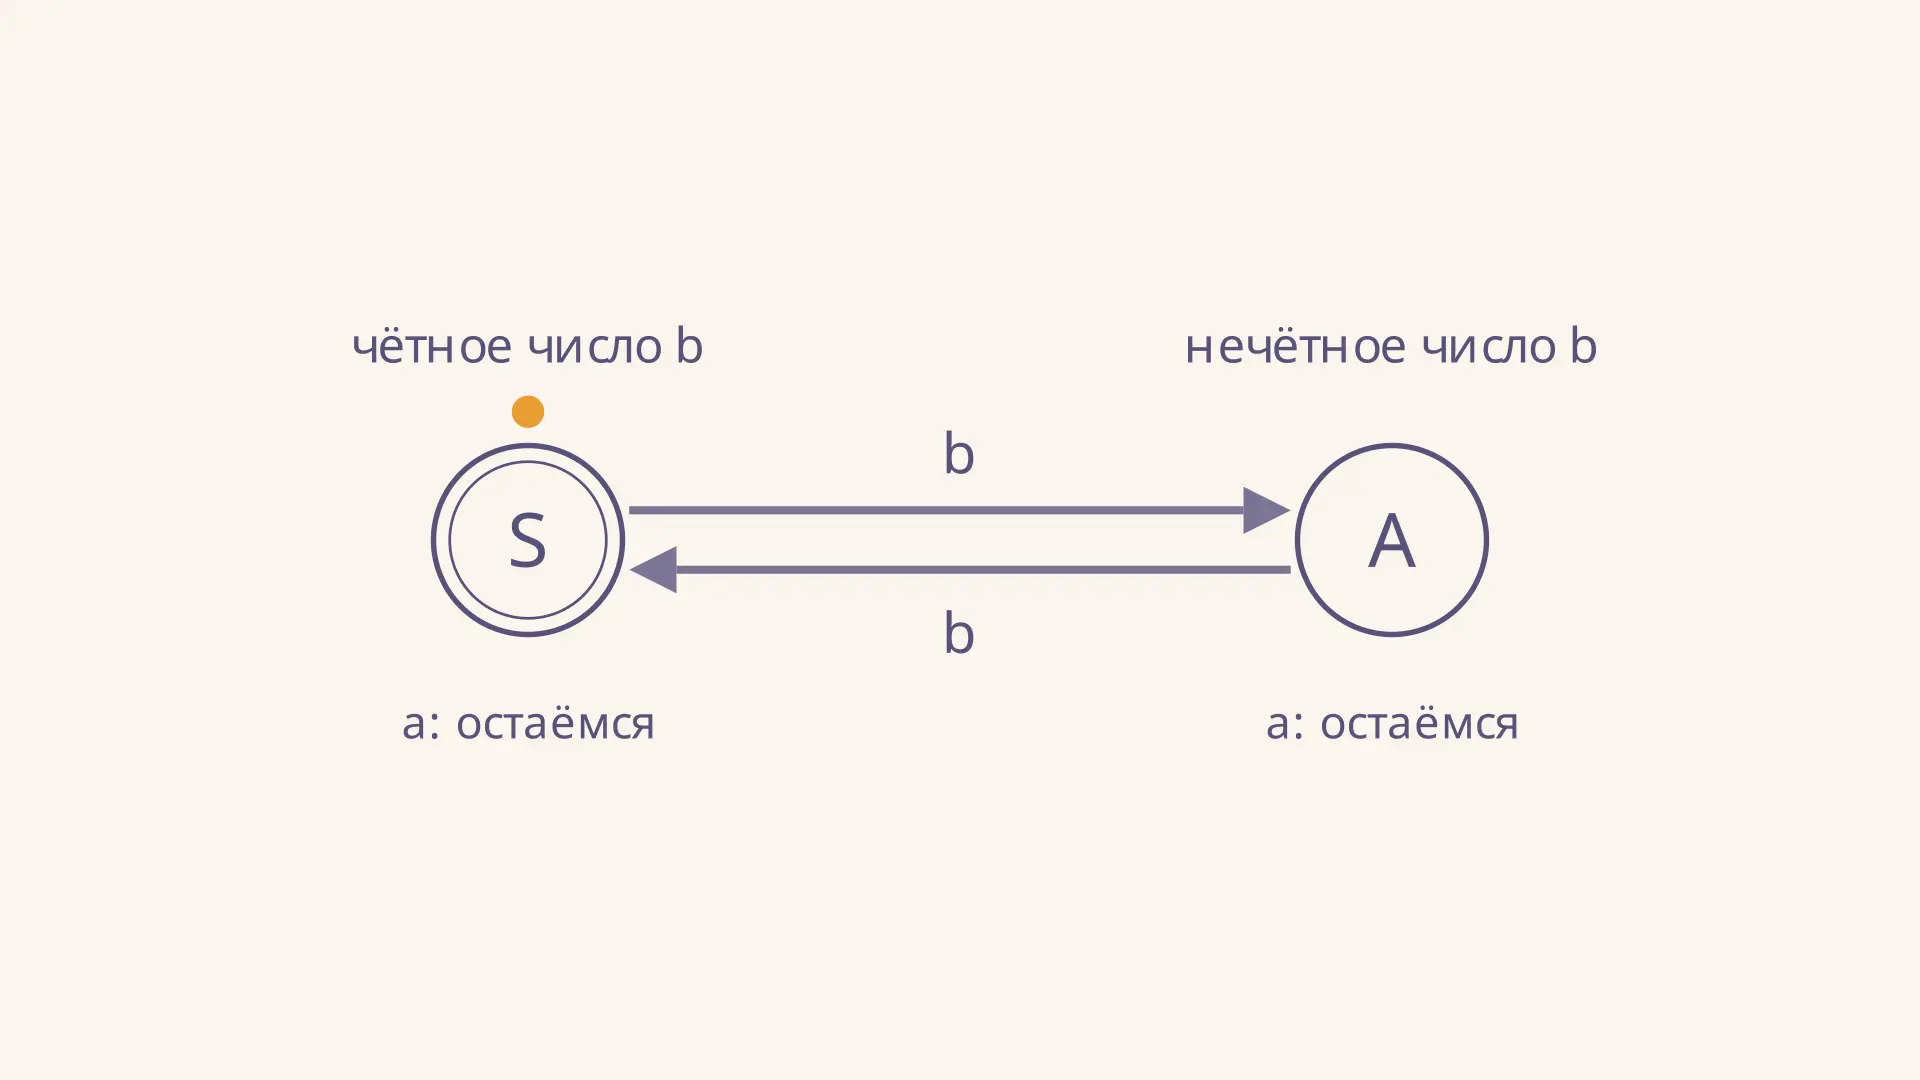
Регулярная грамматика: правила, примеры и автомат
Регулярная грамматика простыми словами: как устроены праволинейные правила, как вывести слово, построить конечный автомат и проверить границы модели на примерах.
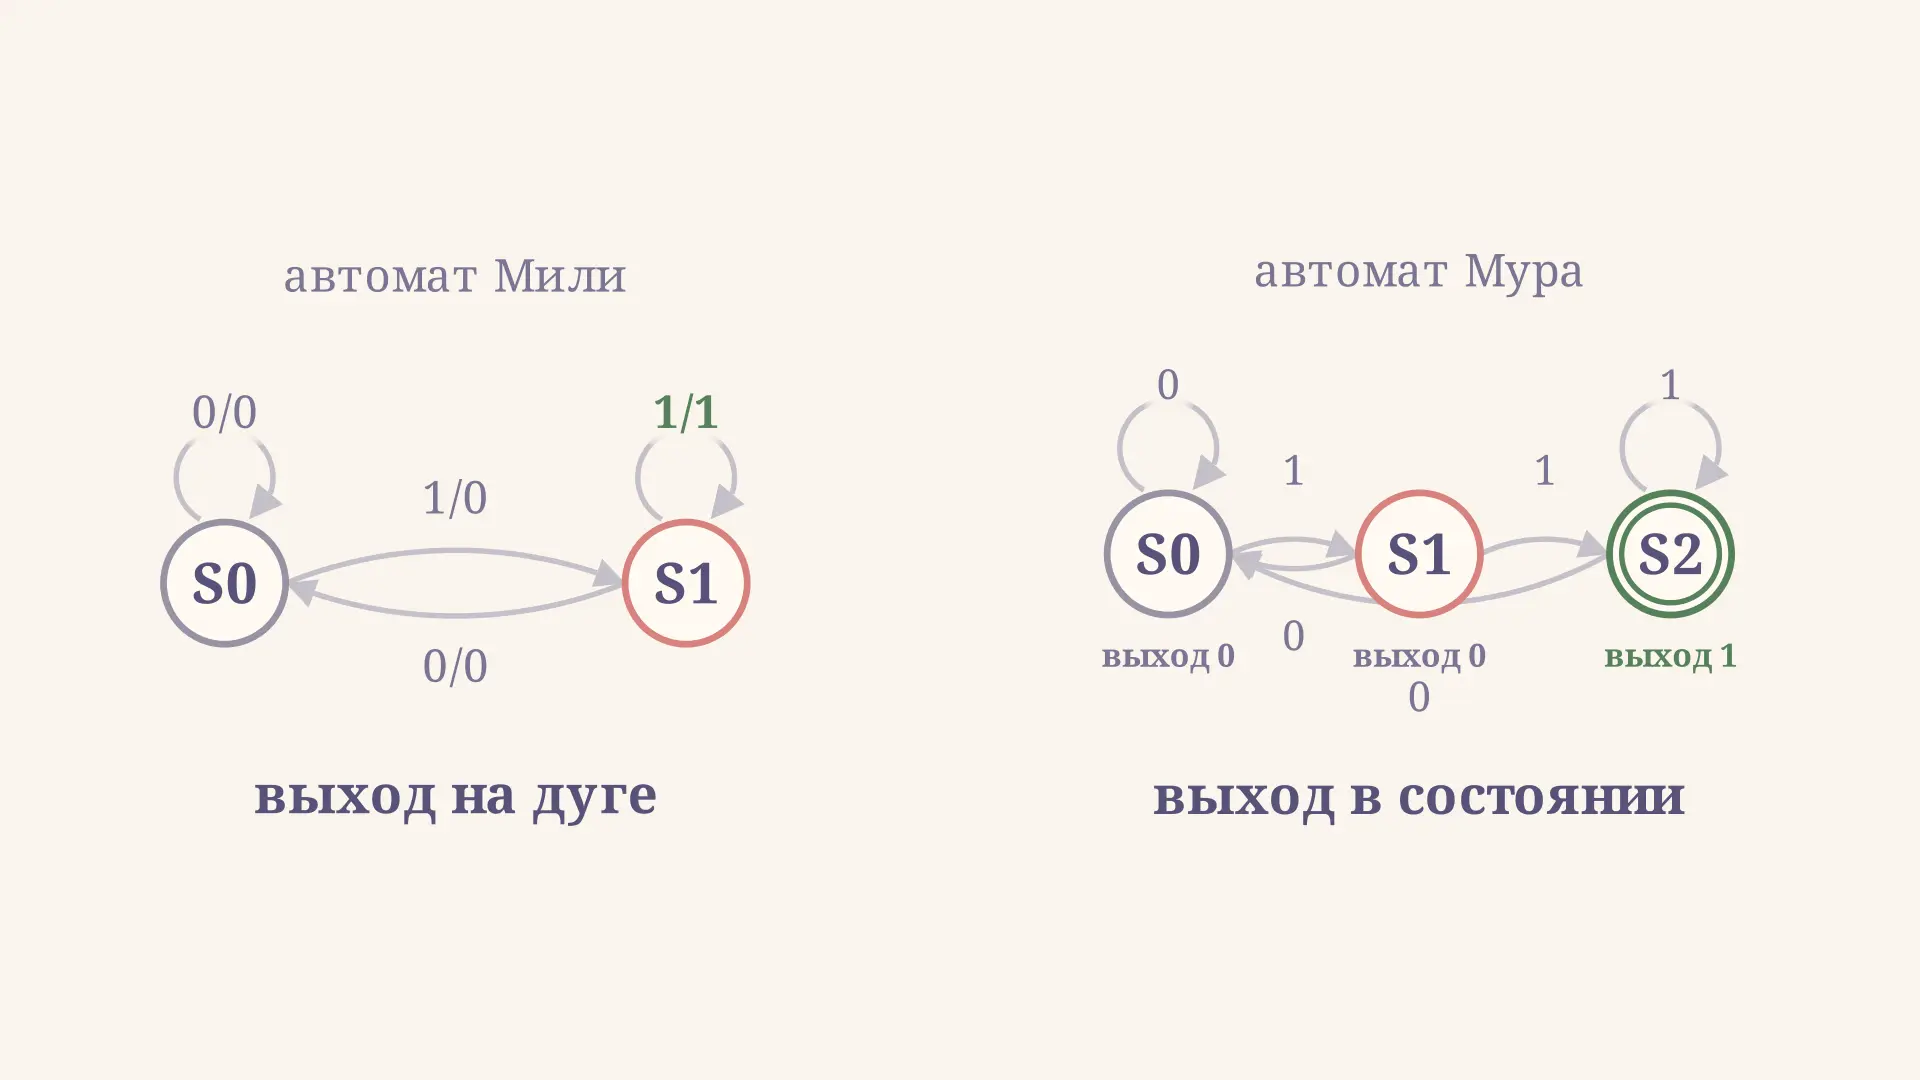
Автоматы Мура и Мили: отличия, формулы и примеры
Автоматы Мура и Мили простыми словами: чем отличаются выходы, как строить граф и таблицу переходов, как преобразовать один тип в другой и почему выходные строки сдвинуты на такт.
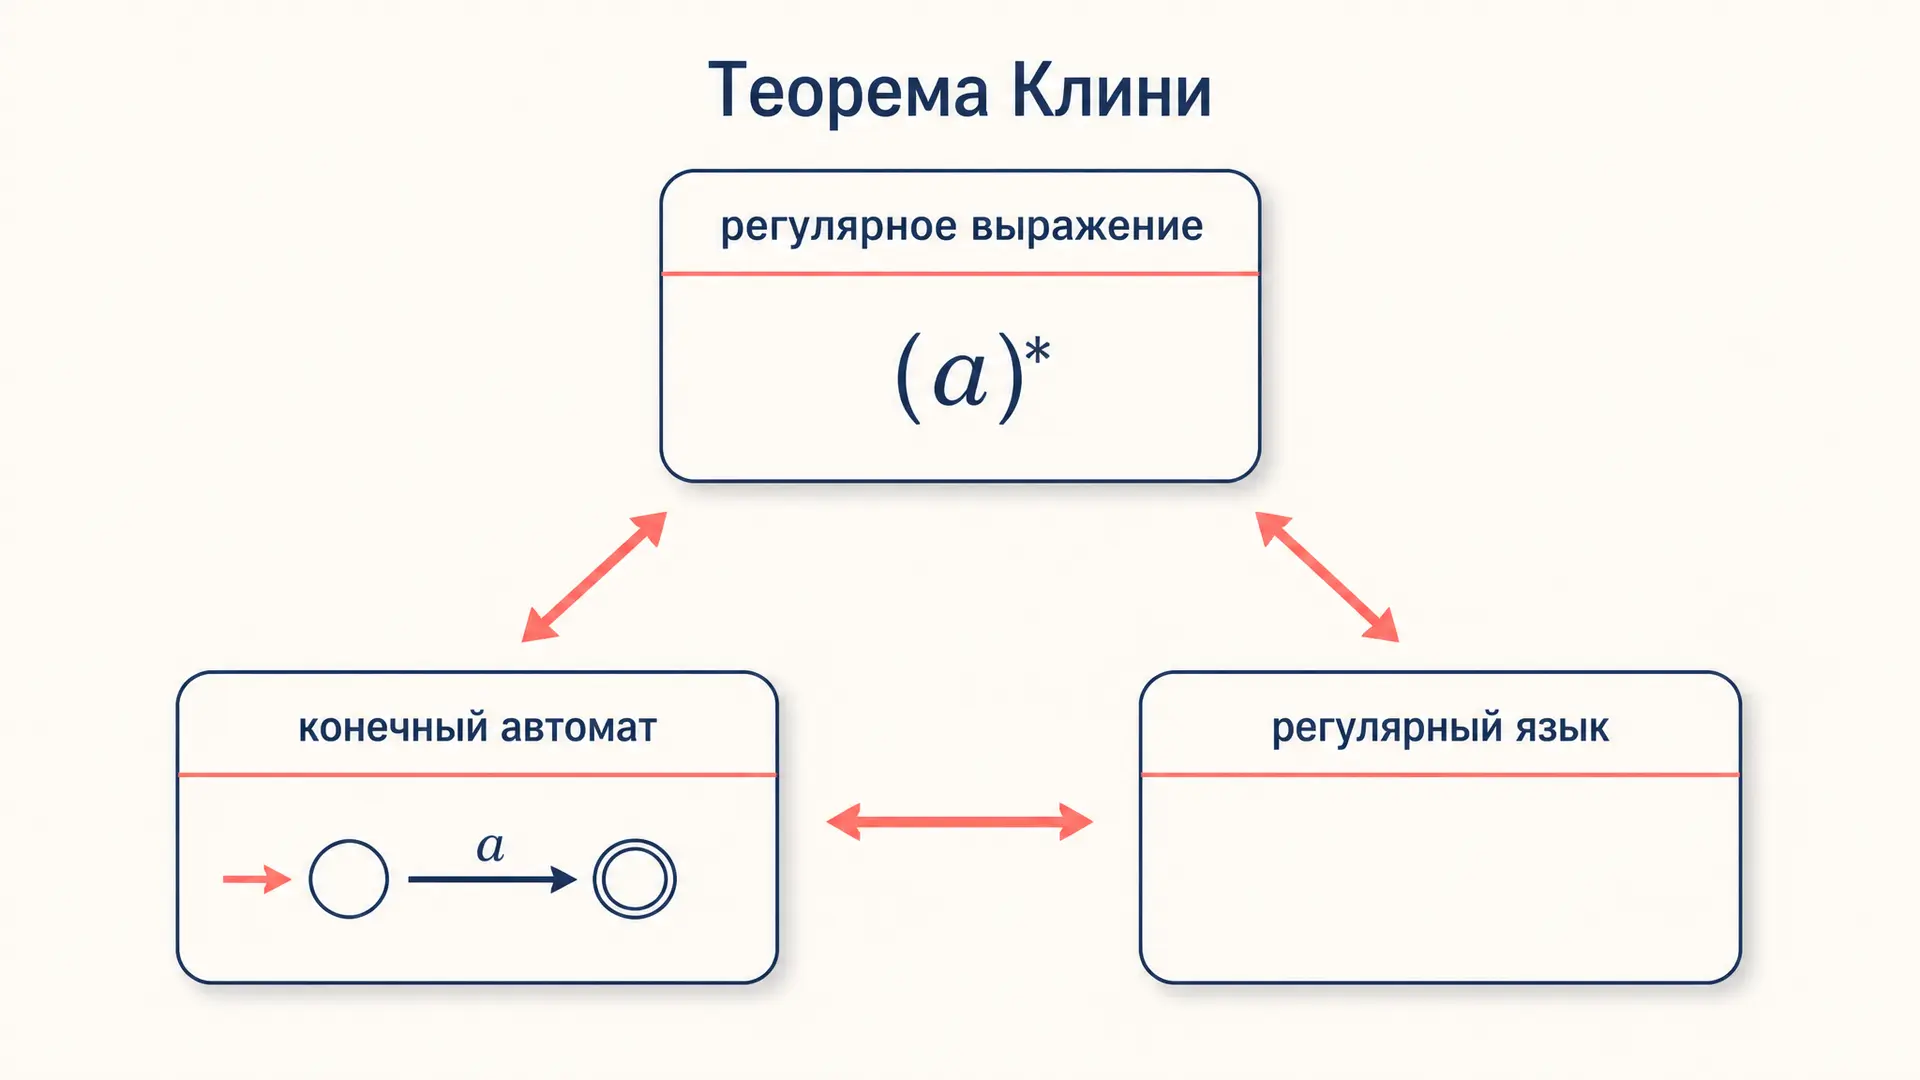
Теорема Клини: регулярные языки и автоматы
Теорема Клини простыми словами: почему регулярные выражения, конечные автоматы и регулярные языки описывают один и тот же класс, как доказывают эквивалентность и где это применяют.