Алгоритм LZW: сжатие данных с помощью словаря
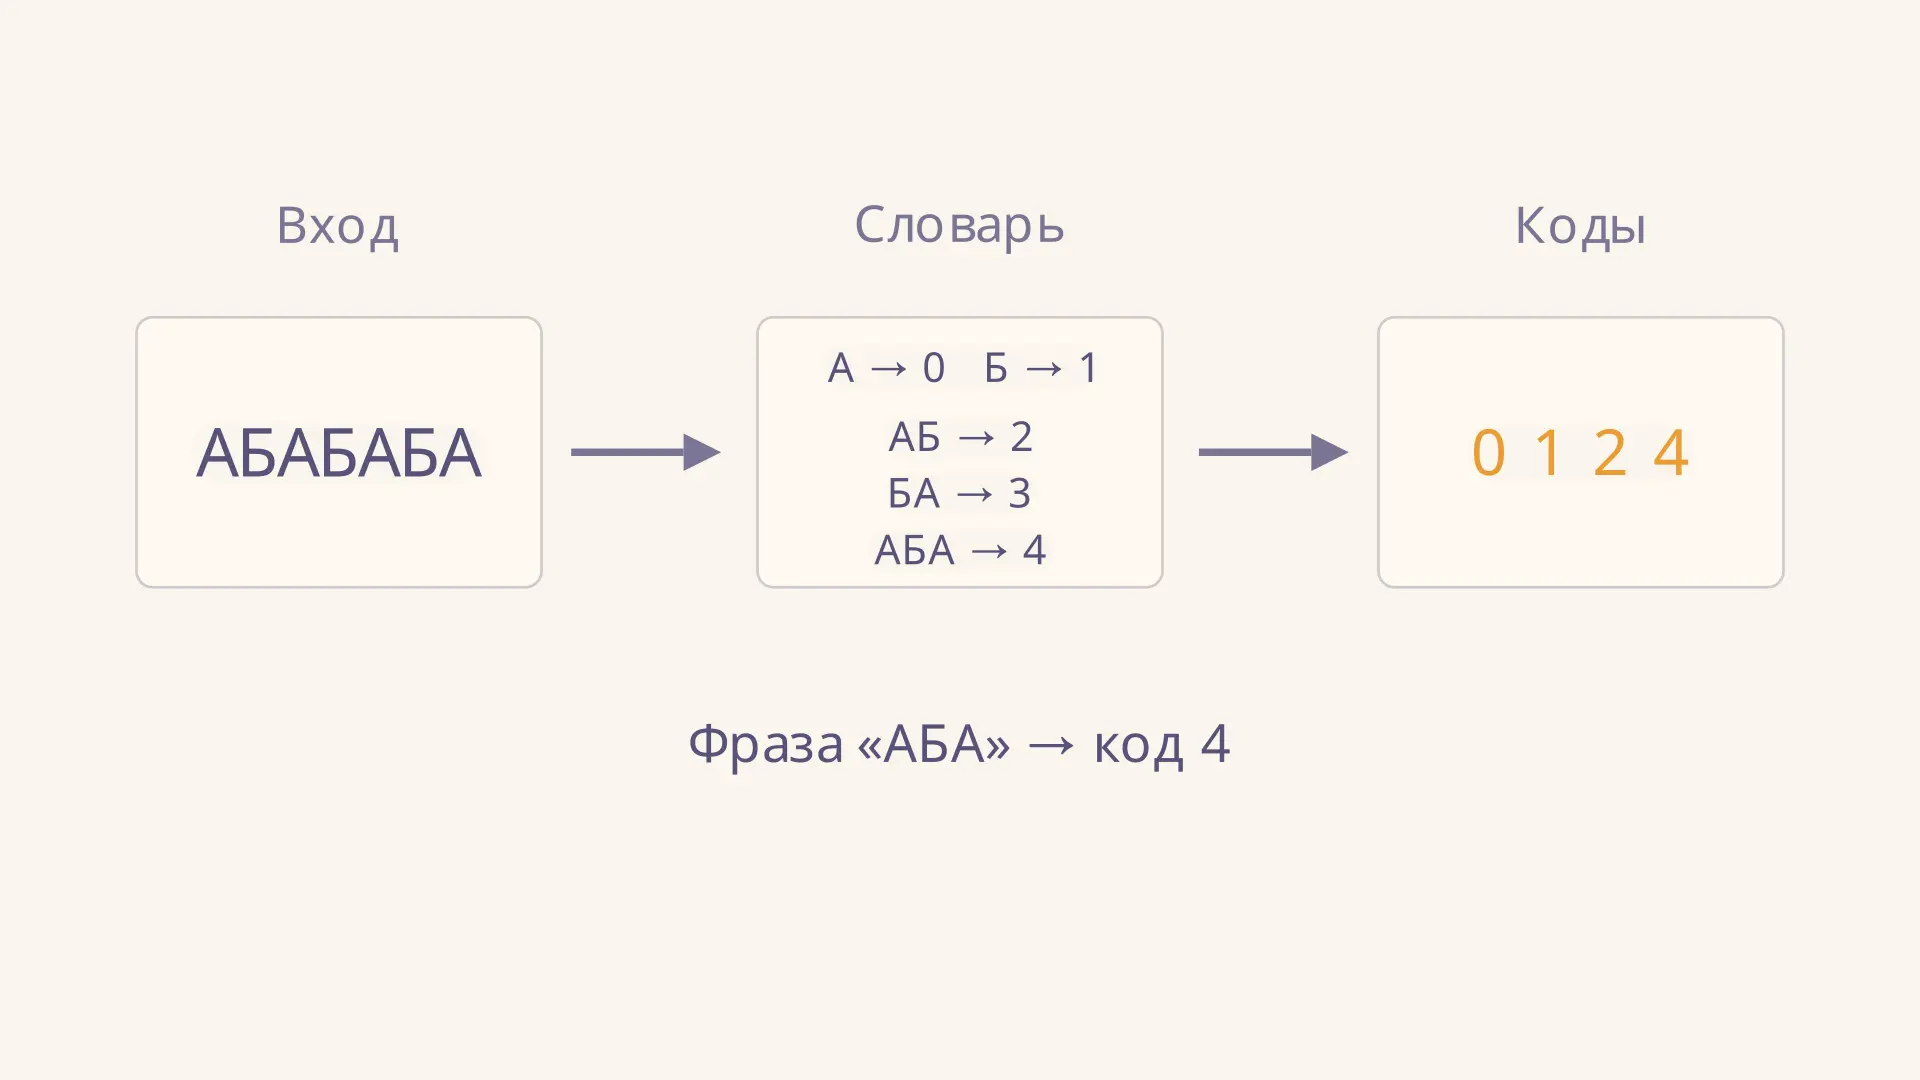
Алгоритм LZW сжимает данные без потерь: вместо уже встреченной цепочки символов он передаёт её числовой код. Словарь при этом не нужно целиком прикладывать к сообщению: кодировщик и декодировщик строят одинаковые записи по мере работы. Разберём этот механизм на короткой строке, проверим каждый код и выясним, почему меньшее число кодов ещё не гарантирует меньшего файла. В инструменте можно менять длину строки и наблюдать, как растёт словарь.
От отдельных символов к фразам
LZW относится к словарным методам сжатия. Изначально обе стороны знают один и тот же алфавит и коды его элементов. Пока кодировщик читает вход, он ищет самую длинную уже известную фразу, выдаёт её код и добавляет в словарь более длинную фразу. При следующем появлении этой последовательности можно использовать один код вместо нескольких отдельных символов.
Метод назван по фамилиям Лемпеля, Зива и Уэлча; словарь алгоритмов NIST относит его к алгоритмам сжатия и приводит статью Уэлча 1984 года. Сжатие без потерь означает, что декодер восстанавливает исходные данные точно. Оно не исправляет ошибки передачи: повреждённый код может повлиять на дальнейшую расшифровку.
В примере ниже алфавит состоит только из двух условных символов: А и Б. Такой алфавит удобен для проверки логики, но не означает, что кириллические буквы в реальном файле занимают по одному биту. О том, как текст превращается в байты, рассказывает статья про Unicode и UTF-8.
Правило кодирования
Пусть текущая фраза обозначена , а очередной входной символ - . В начале пустая. Если уже есть в словаре, удлиняем текущую фразу до и читаем дальше. Иначе выдаём код , добавляем новую запись со следующим свободным номером и начинаем новую фразу с . После последнего символа необходимо выдать код оставшейся непустой фразы.
словарь = начальные символы и их коды
w = пустая строка
для каждого символа c во входе:
    если w + c есть в словаре:
        w = w + c
    иначе:
        вывести код(w)
        добавить w + c в словарь
        w = c
если w не пуста:
    вывести код(w)
Это учебная версия без ограничений на размер словаря, управляющих кодов и упаковки битов. Пустой вход даёт пустой выход. Все символы входа должны присутствовать в начальном алфавите. В реальной программе алгоритм обычно работает с байтами, а таблицу и условия её сброса определяет конкретный формат.
Пример: строка АБАБАБА
Зададим начальные записи А → 0 и Б → 1, а новые коды будем назначать по порядку с 2. Длина входа равна семи символам. Запись в последнем столбце появляется именно после выдачи кода фразы; прочитанный символ, который вызвал добавление, остаётся началом следующей фразы.
| Фраза на выходе | Код | Новая запись |
|---|---|---|
| А | 0 | АБ → 2 |
| Б | 1 | БА → 3 |
| АБ | 2 | АБА → 4 |
| АБА | 4 | конец входа |
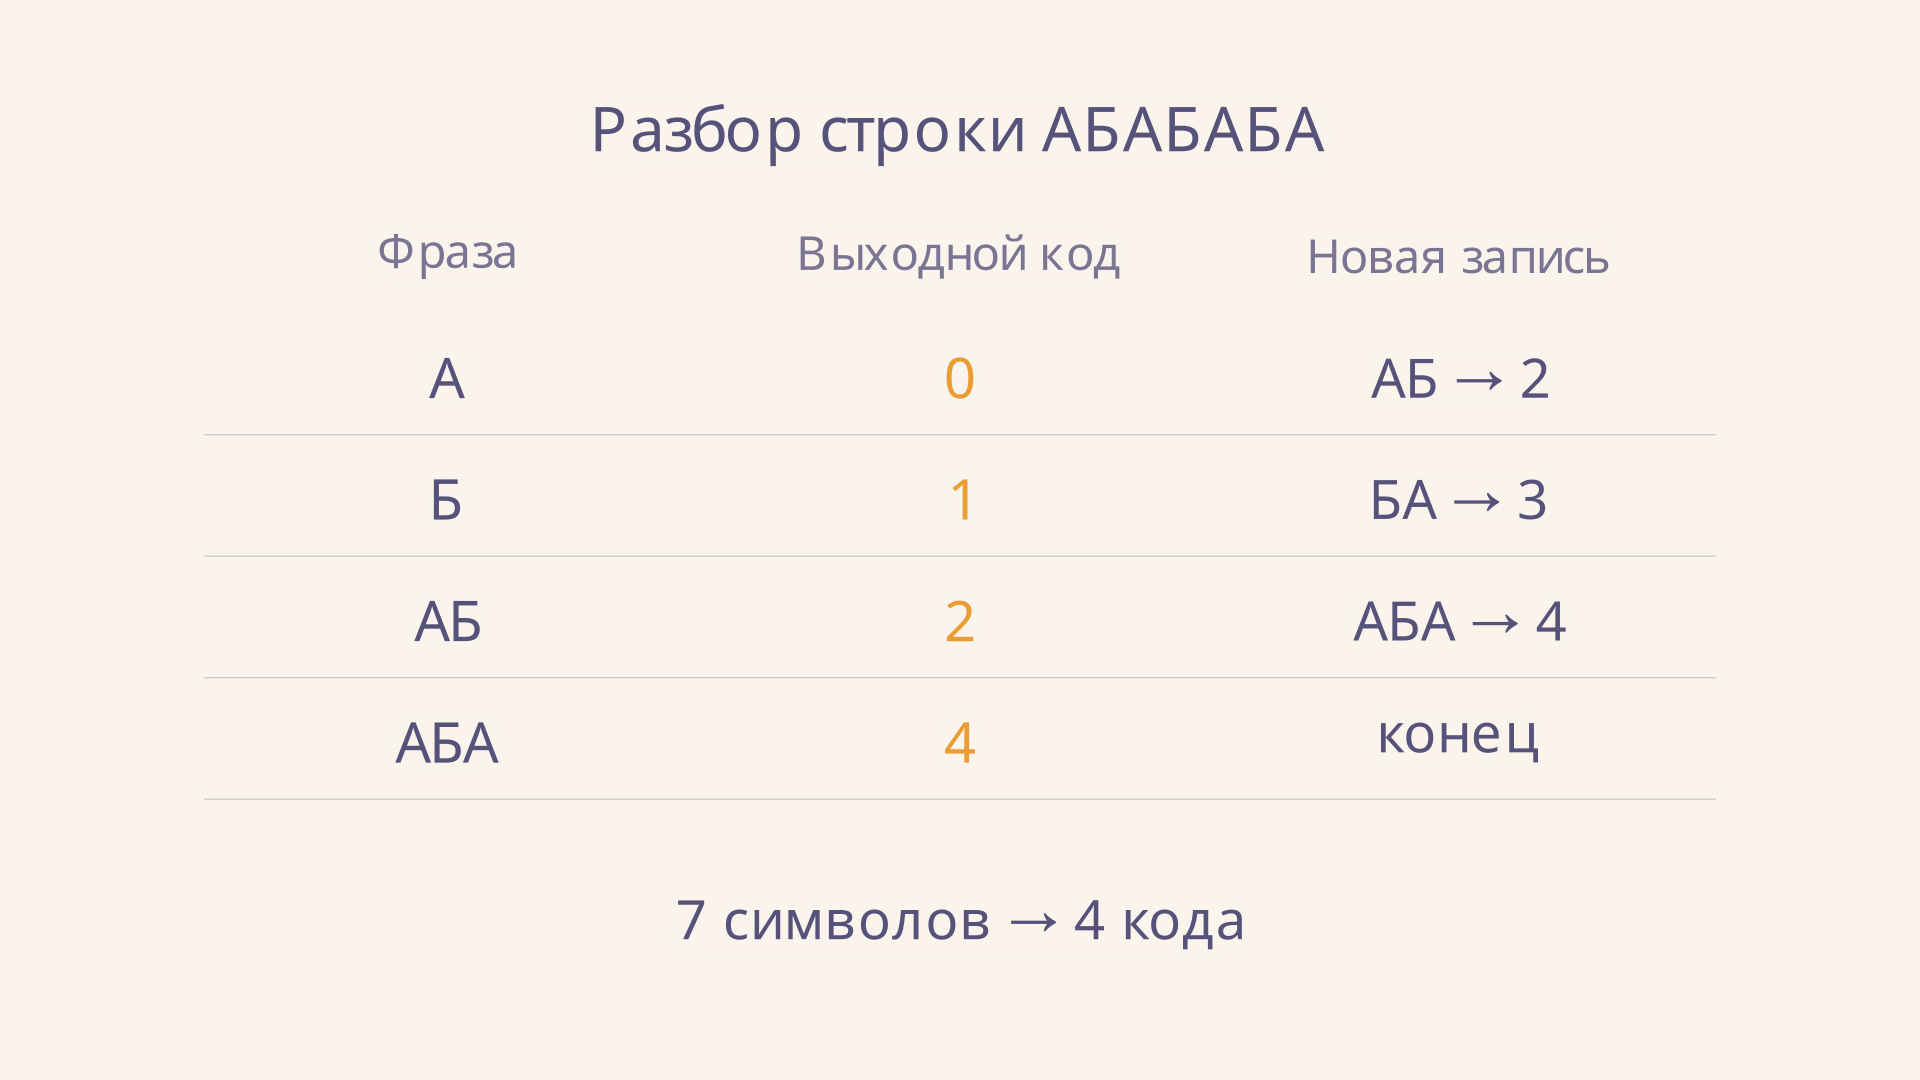
Проследим переходы. Сначала А известна, но АБ ещё нет: выдаём 0 и записываем АБ под номером 2. Затем Б известна, а БА пока нет: выдаём 1 и записываем БА под номером 3. Теперь АБ уже в словаре, поэтому наращиваем фразу; АБА ещё отсутствует, и после выдачи 2 добавляем её с кодом 4. В конце оставшаяся АБА уже известна, поэтому выдаём 4. Результат - 0, 1, 2, 4.
Обратите внимание: запись АБА добавляется не потому, что она уже полностью обработана как самостоятельная выходная фраза, а при первой неудачной попытке продолжить АБ. На следующем шаге вход действительно позволяет использовать эту запись. В калькуляторе можно увеличить строку и проследить, как появляются ещё более длинные фразы.
Как декодер восстанавливает словарь
Декодер начинает с того же словаря А → 0, Б → 1. Первый код 0 непосредственно даёт А. Затем код 1 даёт Б; декодер добавляет к предыдущей фразе первый символ текущей: А + Б = АБ, код 2. Следующий код 2 даёт АБ, а в словарь добавляется Б + А = БА, код 3. Правило работает потому, что первая буква новой фразы одновременно завершает запись, которую кодировщик создал на предыдущем переходе.
Последний код 4 - особый случай: декодер ещё не успел записать такую строку. Но он знает, что 4 - ровно следующий свободный номер, а предыдущая фраза равна АБ. Тогда искомая фраза получается как предыдущая фраза плюс её первый символ: АБ + А = АБА. Декодер выводит АБА и добавляет ту же запись под кодом 4. Собирая фразы А, Б, АБ и АБА, получаем исходную строку.
Это правило допустимо лишь для следующего свободного кода при наличии предыдущей фразы. Произвольный отсутствующий номер не следует подменять таким способом: он указывает на некорректный поток или несовпадающие настройки. Кодировщик и декодер обязаны согласовать начальный словарь, порядок нумерации, ширину кодов и обработку управляющих значений.
Меньше кодов не всегда значит меньше битов
В учебном примере семь символов представлены четырьмя кодами. Но для оценки размера нужно знать цену каждого кода. При фиксированной ширине три бита коды 0, 1, 2 и 4 занимают 12 бит. Если исходные два символа уже представлены оптимально по одному биту, вход занимает всего 7 бит: в таком сравнении результат больше, даже без заголовка. Если же исходный текст хранится в байтах, сравнение зависит от выбранной кодировки и реальных правил упаковки.
Практический коэффициент размера можно записать как , где обе величины измерены в битах и включают необходимые служебные данные. Значение меньше единицы означает уменьшение размера. Например, в условном сравнении выше , а не . На коротких или неповторяющихся данных расходы на коды и заголовки могут перевесить выигрыш. Для сопоставления с другими способами представления данных полезно разобрать равномерное и неравномерное кодирование.
Ширина кода в реальном потоке может меняться, когда словарь растёт. Упаковка битов, максимальный размер таблицы и сигналы её очистки задаются отдельно от общей идеи LZW. Так, спецификация GIF89a описывает переменную длину кодов и специальный код очистки; заполнение таблицы само по себе не заставляет кодировщик немедленно её очищать. Учебная таблица выше не является готовым GIF-потоком.
Где применяют и сколько ресурсов нужно
LZW используется, в частности, при кодировании данных изображения GIF. Он хорошо иллюстрирует адаптивное сжатие: словарь подстраивается под повторения самого сообщения и не требует заранее передавать все построенные фразы. Однако структуру формата, палитру и служебные блоки нельзя вывести из одной таблицы LZW.
При эффективном представлении словаря и поиске продолжения фразы за ожидаемое постоянное время проход кодировщика по входным символам занимает ожидаемо операций. На практике результат зависит от хеширования, ограничений словаря и структуры записей. Если каждый раз копировать длинные строки, время и память могут оказаться заметно больше. Словарь хранит записи до установленного предела; без предела его размер растёт вместе с числом добавлений.
Повторения важны и в других строковых задачах, но цель там иная. Например, алгоритм Кнута - Морриса - Пратта использует сведения о совпадениях для поиска образца, тогда как LZW присваивает фразам коды для представления данных. При работе с байтовым входом также полезно отличать сами числа байтов от символов таблицы ASCII.
Частые ошибки
- Добавлять в словарь только выданную фразу. Добавляется сочетание этой фразы и следующего символа, которого не хватило для продолжения.
- Забывать последнюю фразу. После завершения цикла её код нужно выдать отдельно, если фраза непустая.
- Считать каждый код одним байтом. Ширина и упаковка зависят от формата и могут изменяться по ходу потока.
- Передавать декодеру полный словарь как обязательное условие. При согласованных правилах он восстанавливает новые записи самостоятельно.
- Игнорировать особый случай. Следующий свободный код может встретиться до добавления соответствующей фразы в словарь декодера.
FAQ
Нужно ли заранее знать весь текст?
Нет. Кодировщик последовательно читает символы и строит словарь в процессе; он лишь хранит текущую фразу и состояние таблицы. Конкретная упаковка и заголовок формата могут накладывать дополнительные требования.
Почему декодер знает новую фразу без передачи словаря?
Он видит предыдущую и текущую декодированные фразы. Первый символ текущей завершает запись, которую кодировщик создал на предыдущем переходе. Для следующего свободного кода применяется описанное выше специальное правило.
LZW всегда уменьшает файл?
Нет. На коротких, случайных или уже сжатых данных повторений может не хватить для компенсации широких кодов и служебных полей. Сравнивайте итоговые размеры в битах, а не только количество выходных кодов.
Коротко
LZW заменяет известные фразы кодами и одновременно расширяет словарь. На строке АБАБАБА с начальным словарём А → 0, Б → 1 он выдаёт 0, 1, 2, 4. Декодер строит тот же словарь и точно восстанавливает вход; реальный выигрыш зависит от повторений, ширины кодов и правил формата.
Читайте также
Блок-схема алгоритма: условный оператор
Как построить блок-схему алгоритма с условным оператором: обозначения, полное и неполное ветвление, пример проверки чётности и трассировка двух путей.
Исполнитель Черепаха: алгоритм рисования фигур
Как исполнитель Черепаха рисует фигуры по командам: положение, направление и перо, пошаговая трассировка квадрата, циклы и углы поворота многоугольников.
Кодирование длин серий RLE: примеры и расчёт
Как работает кодирование длин серий RLE: пошаговый разбор кодирования и декодирования, расчёт размера в байтах, условия эффективности и ограничения метода на примерах.
Колмогоровская сложность: длина кратчайшего описания
Что такое колмогоровская сложность строки, как связаны программы и сжатие, почему большинство строк несжимаемы и нельзя вычислить точное значение сложности.
Обратная польская запись: как вычислять со стеком
Обратная польская запись простыми словами: как перевести выражение в постфиксную форму, вычислить его со стеком, сохранить порядок операндов и найти ошибку.
Перевод битов в байты и других единиц информации
Как перевести биты в байты и обратно, учитывать остаток, различать килобайты и кибибайты и пошагово решать задачи на размер файла и скорость передачи данных.