Колмогоровская сложность: длина кратчайшего описания
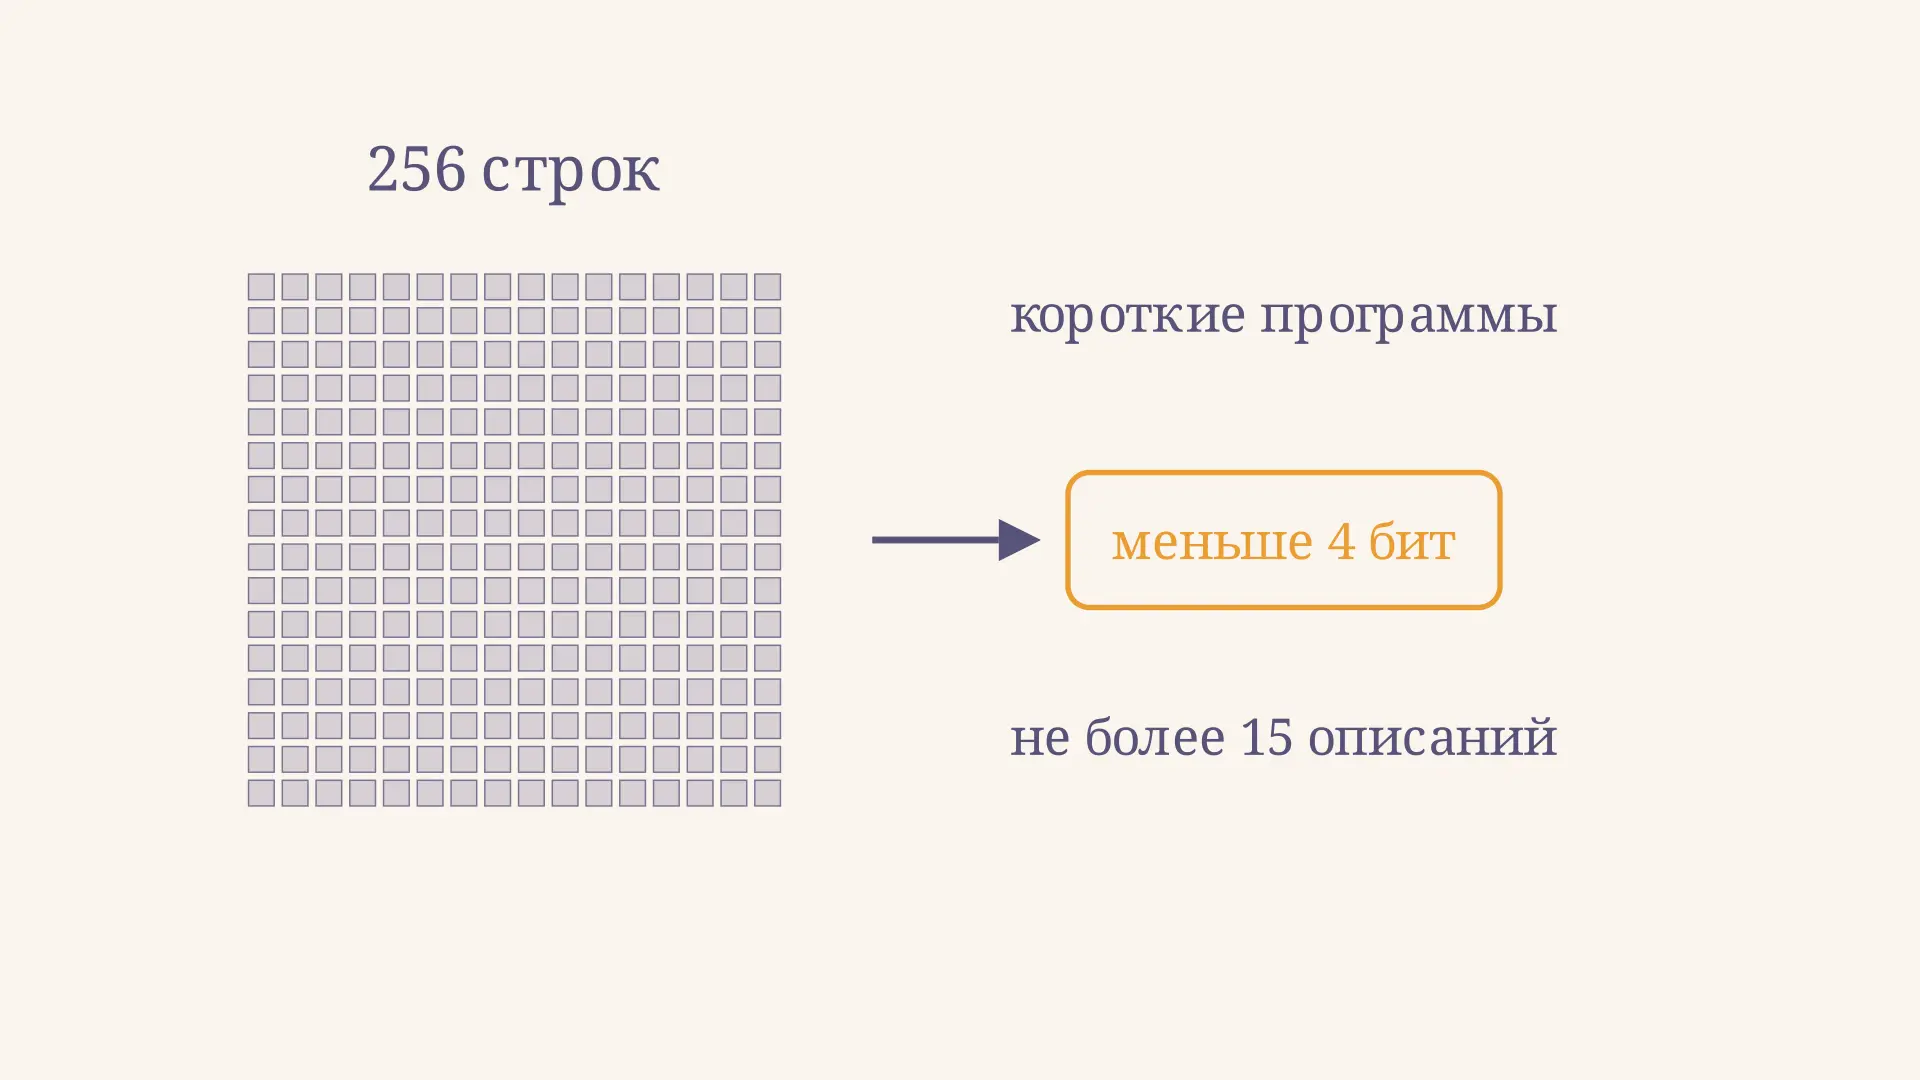
Колмогоровская сложность измеряет, насколько кратко можно точно описать отдельный объект с помощью программы. Для длинной строки из нулей достаточно указать правило повторения и длину; для другой строки столь короткого правила может не существовать. Мера определяется длиной кратчайшей программы, которая выдаёт строку и останавливается. Она помогает рассуждать о сжатии и алгоритмической случайности, хотя общего способа вычислить её точное значение нет. Калькулятор ниже иллюстрирует доказательство подсчётом: меняйте длину строк и порог описания, чтобы увидеть гарантированное число строк без слишком коротких программ.
Определение: программа как описание
Зафиксируем универсальную вычислительную машину , принимающую двоичную программу . Простая колмогоровская сложность конечной двоичной строки определяется так:
Здесь - длина программы в битах, а равенство означает, что машина выводит в точности и останавливается. В литературе для разных вариантов сложности встречаются обозначения и ; ниже для краткости используем для определённой выше простой сложности. Вводимая отдельно префиксная сложность использует самоделимитирующиеся программы и имеет другие технические оценки.
Слово «программа» не обязательно означает код на привычном языке. Важно зафиксировать способ записи битов и исполнитель, а также учитывать всю информацию, необходимую для восстановления строки. Если программа получает на вход бесплатно, она уже описывает другую величину - условную сложность. Нельзя спрятать часть исходных данных в невидимой библиотеке и назвать описание коротким без указания этого условия.
Подход к информации через алгоритмическое описание изложен в работе А. Н. Колмогорова 1965 года. Он относится к конкретному объекту, а не требует заранее задавать вероятностное распределение источника. Кодирование символов в реальном сообщении обсуждается отдельно в статье о равномерном и неравномерном кодировании.
Повторы, описания и размер программы
Представим две строки длиной миллион бит. Первая состоит только из нулей. Её можно задать инструкцией «вывести ноль миллион раз», добавив к инструкции двоичную запись числа повторений. Длина такого описания растёт примерно как число бит для записи длины, плюс постоянные затраты на саму программу. Это лишь верхняя оценка: мы нашли описание, но не доказали, что более короткого нет.
Вторая строка может выглядеть беспорядочной. Для некоторых строк действительно не найдётся программы существенно короче них самих. Но по виду конкретной последовательности это не доказать: даже длинный фрагмент с неочевидным узором может порождаться коротким правилом. Например, первые миллион двоичных знаков числа, заданного коротким алгоритмом, могут выглядеть случайно и всё же иметь компактное описание при условии, что в программе указана нужная длина.
Обратная тривиальная стратегия - включить саму строку в программу и вывести её. Для фиксированной универсальной машины простая сложность не превосходит длину строки более чем на некоторую константу: . Константа зависит от выбранного исполнителя и способа записи, поэтому для коротких строк накладные расходы особенно важны.
Почему коротких программ не хватает
При длине существует ровно двоичных строк. Программ длины строго меньше не больше, чем всех битовых слов такой длины, включая пустое слово:
Каждая остановившаяся программа выдаёт только один результат. Значит, не более разных строк могут иметь описание короче . Некоторые программы не остановятся, а несколько программ могут дать одну строку, поэтому равенство здесь не гарантируется. При отсюда следует нижняя граница:
Движение показывает предельный случай: каждой короткой программе условно сопоставлена отдельная строка длиной восемь бит. Это не поиск конкретных сложных строк и не утверждение, что отмеченные программы останавливаются. Реальных разных результатов может быть меньше, а число оставшихся строк - больше.
Пример: восемь бит и порог четыре
Пусть , а . Всего есть строк. Возможных программ длины от нуля до трёх бит - . Поэтому не менее строки имеют сложность не меньше четырёх бит. Это примерно всех восьмибитовых строк.
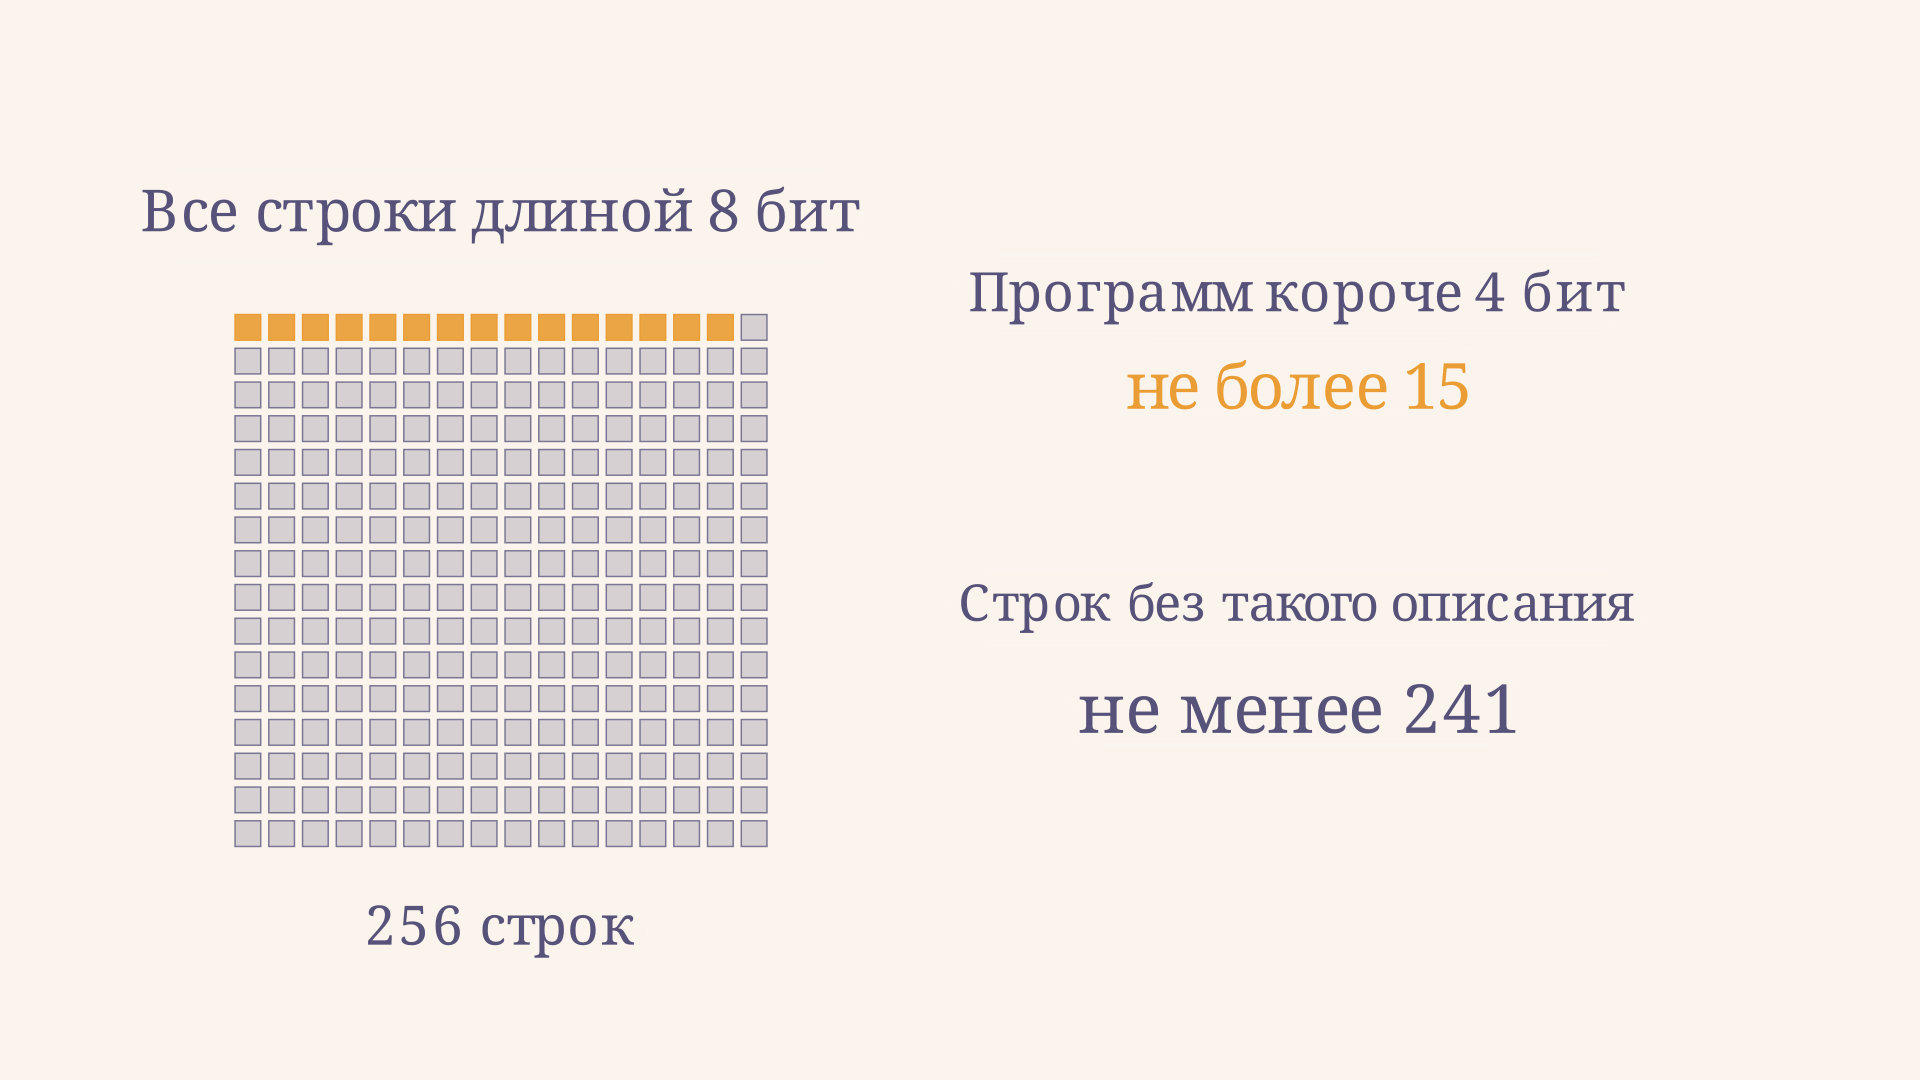
Более общий вывод получают, положив для целого от нуля до . Доля строк, описываемых программой короче , меньше . При увеличении требуемого выигрыша на один бит эта верхняя граница доли уменьшается вдвое. Это утверждение о множестве строк; оно не говорит, какие именно строки в нём находятся.
Зачем фиксировать универсальную машину
На разных языках одна и та же строка может иметь программы разной длины. Однако универсальная машина способна имитировать другую машину: достаточно добавить фиксированный переводчик к её программе. Теорема инвариантности утверждает, что для двух фиксированных универсальных машин значения простой сложности отличаются не более чем на постоянную, зависящую от пары машин, но не от строки.
Эта постоянная может быть большой. Теорема не обещает одинаковых значений в битах для короткого примера и не позволяет сравнивать числа без указания модели. Её смысл асимптотический: при рассмотрении всё более длинных объектов выбор универсальной машины добавляет ограниченную поправку, а не произвольную функцию длины.
Условная сложность , в свою очередь, измеряет длину кратчайшей программы для , если уже доступно исполнителю. Так можно отдельно спросить, сколько нового нужно сообщить о строке при известной длине или при наличии другой строки. Условие должно быть явно названо: иначе сравнение с безусловной сложностью вводит в заблуждение.
Почему точное значение не вычислить
Можно запускать программы и сохранять длины тех, что уже выдали нужную строку. Если нашлась программа длины 100 бит, это доказывает верхнюю оценку . Позднее может найтись ещё более короткая. Но для точного ответа нужно исключить все короткие программы, которые пока не завершились. Общий алгоритм не умеет определить для каждой из них, остановится она когда-нибудь или работает бесконечно.
Невычислимость можно увидеть и через противоречие. Предположим, что существует алгоритм точного вычисления . Тогда для любого достаточно большого можно перебрать строки и выбрать первую со сложностью больше : такая строка существует по приведённому подсчёту. Но сама процедура выбора вместе с записью задаёт эту строку программой длины порядка плюс постоянная. При больших это меньше , что противоречит условию выбора. Следовательно, предполагаемого алгоритма нет.
Это не запрет на любые оценки. Конкретная программа даёт проверяемую верхнюю границу, а математическое доказательство иногда даёт нижнюю. Просто универсальный метод, который всегда выдаёт точный минимум для произвольной строки, невозможен.
Сжатие, энтропия и сложность алгоритма
Архиватор строит практически полезное описание данных для определённого декодера. Если он действительно восстанавливает исходную строку без потерь, размер архива вместе с нужным фиксированным декодером даёт верхнюю оценку сложности. Плохое сжатие конкретным архиватором не доказывает высокую сложность: другой алгоритм может обнаружить структуру, которую первый пропустил. Кроме того, в практических форматах существенны заголовки и служебные данные.
Количество информации по Шеннону связано с вероятностями исходов, а энтропия - со средним по распределению. Колмогоровская сложность характеризует отдельную строку относительно машины. Теории связаны результатами о средних длинах описаний, но подставлять энтропию вместо сложности одной конкретной строки нельзя.
Слово «сложность» также не означает время исполнения кратчайшей программы. Короткое описание может потребовать очень долгого вычисления. Напротив, временная и пространственная сложность изучает ресурсы алгоритма при росте входа, а цикломатическая сложность описывает структуру ветвлений программы. Эти меры отвечают на разные вопросы и не выражаются друг через друга простым равенством.
Частые ошибки
- Считать сжатый архив точным значением . Он даёт описание и тем самым верхнюю оценку, но не доказывает оптимальности.
- Объявлять строку случайной по внешнему виду. Неочевидный шаблон всё равно может задаваться короткой программой.
- Забывать длину и декодер. Их стоимость либо включают в описание, либо явно оговаривают как условие и фиксированную машину.
- Принимать оценку подсчётом за точное число. Не все программы останавливаются и не все дают разные результаты нужной длины.
- Путать сложность описания со скоростью. Кратчайшая программа может работать очень долго.
FAQ
Можно ли вычислить сложность для конкретной строки?
Иногда точное значение удаётся доказать относительно заданной машины. В общем случае алгоритма, который точно отвечает для любой строки, не существует. Найденная программа всегда даёт верхнюю оценку.
Является ли строка из случайных битов несжимаемой?
Среди всех строк одной длины доля существенно сжимаемых мала, поэтому равномерный случайный выбор с высокой вероятностью даст строку без сильно короткого описания. Для отдельного результата это вероятностное рассуждение не указывает его точную сложность.
Зависит ли сложность от языка программирования?
Да. Для двух фиксированных универсальных машин разница ограничена константой, но на коротких строках она может существенно влиять на результат. Поэтому конкретные значения имеют смысл только с указанной машиной и правилами записи.
Коротко
Колмогоровская сложность - длина кратчайшей останавливающейся программы, выводящей объект. Подсчёт показывает существование большого числа строк без короткого описания, но не даёт общего алгоритма для нахождения точной сложности конкретной строки. Практическое сжатие предоставляет полезные верхние оценки; его результат зависит от выбранного метода и не удостоверяет минимальность.
Читайте также
Алгоритм LZ77: сжатие с помощью ссылок назад
Алгоритм LZ77 на пошаговом примере: как скользящее окно находит повторы, что означают расстояние и длина, как работает перекрытие и от чего зависит размер результата.
Алгоритм LZW: сжатие данных с помощью словаря
Алгоритм LZW по шагам: как строится словарь фраз, выдаются коды и восстанавливается исходная строка. Разберём пример, особый случай декодирования и оценку размера.
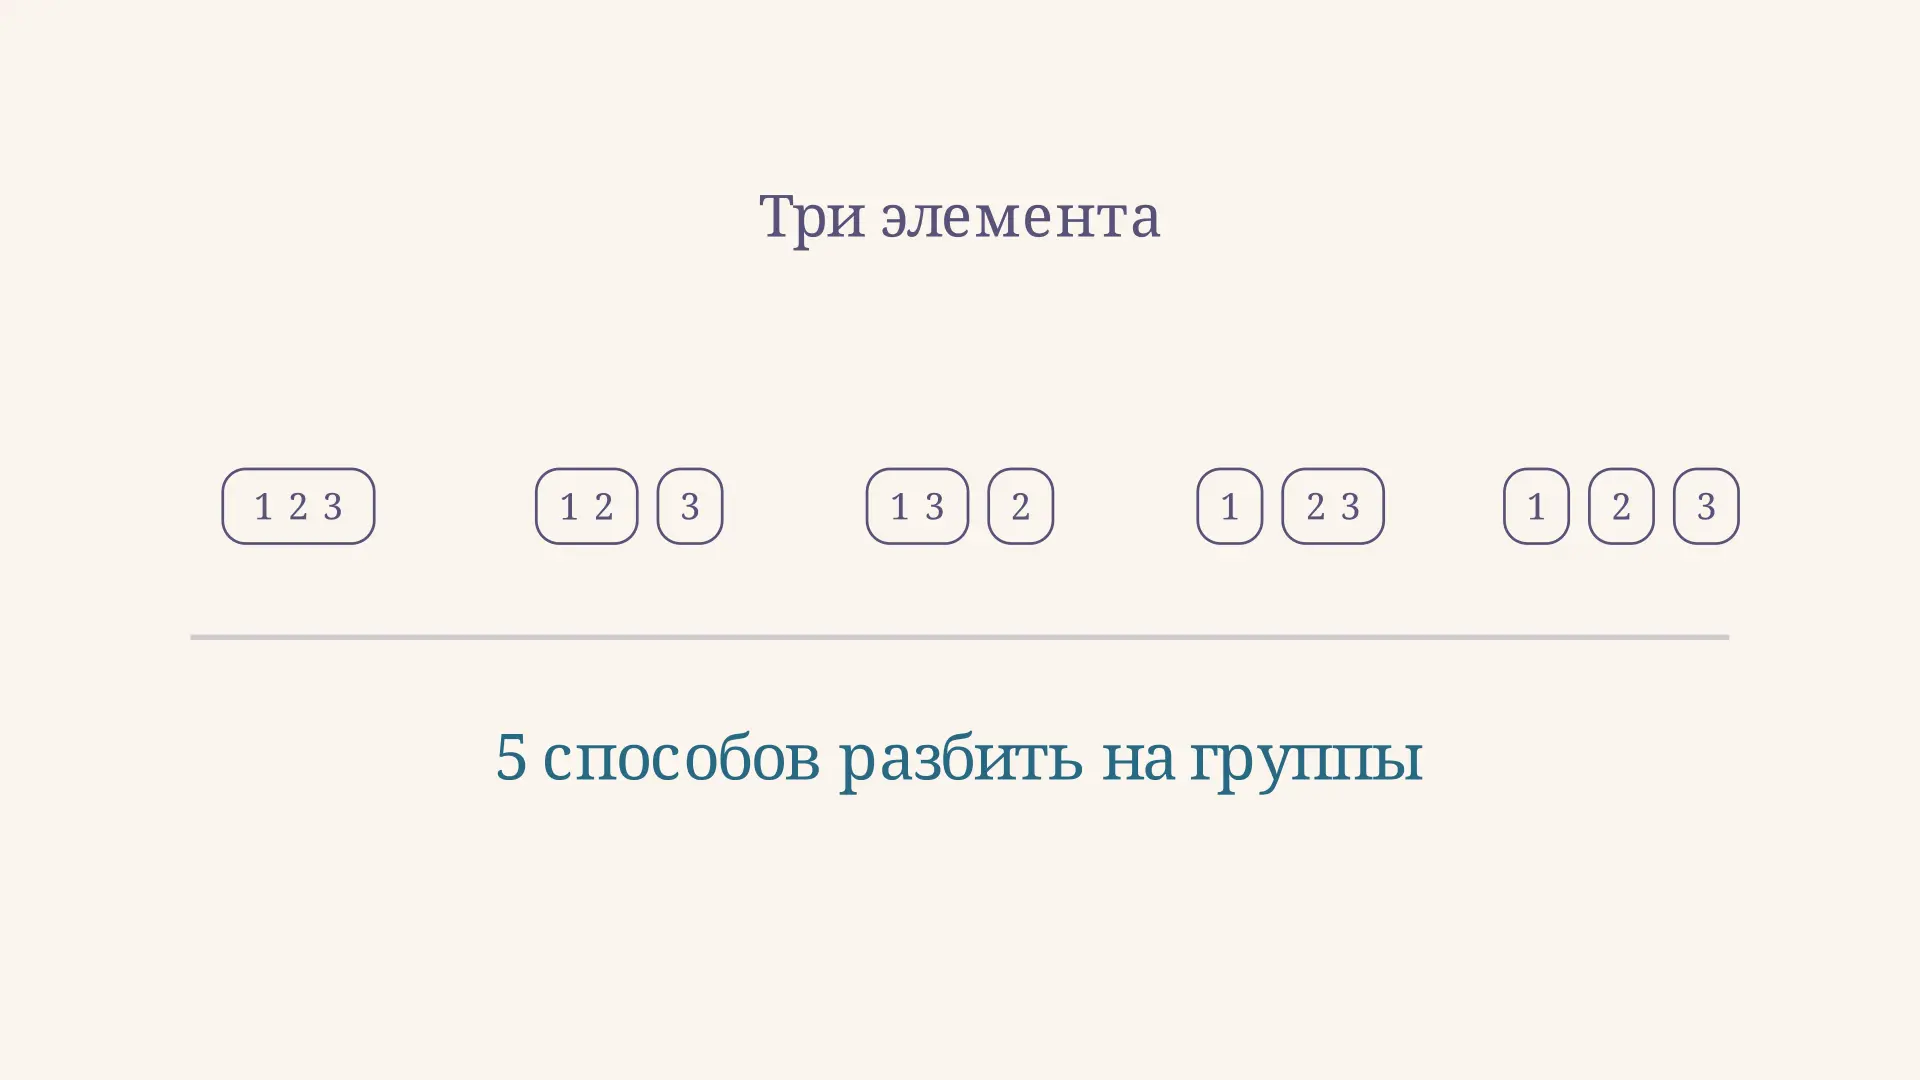
Числа Белла: разбиения множества и формула
Числа Белла считают разбиения множества на непустые группы. Разбираем подробные примеры, рекуррентную формулу, связь с числами Стирлинга и алгоритм вычисления.
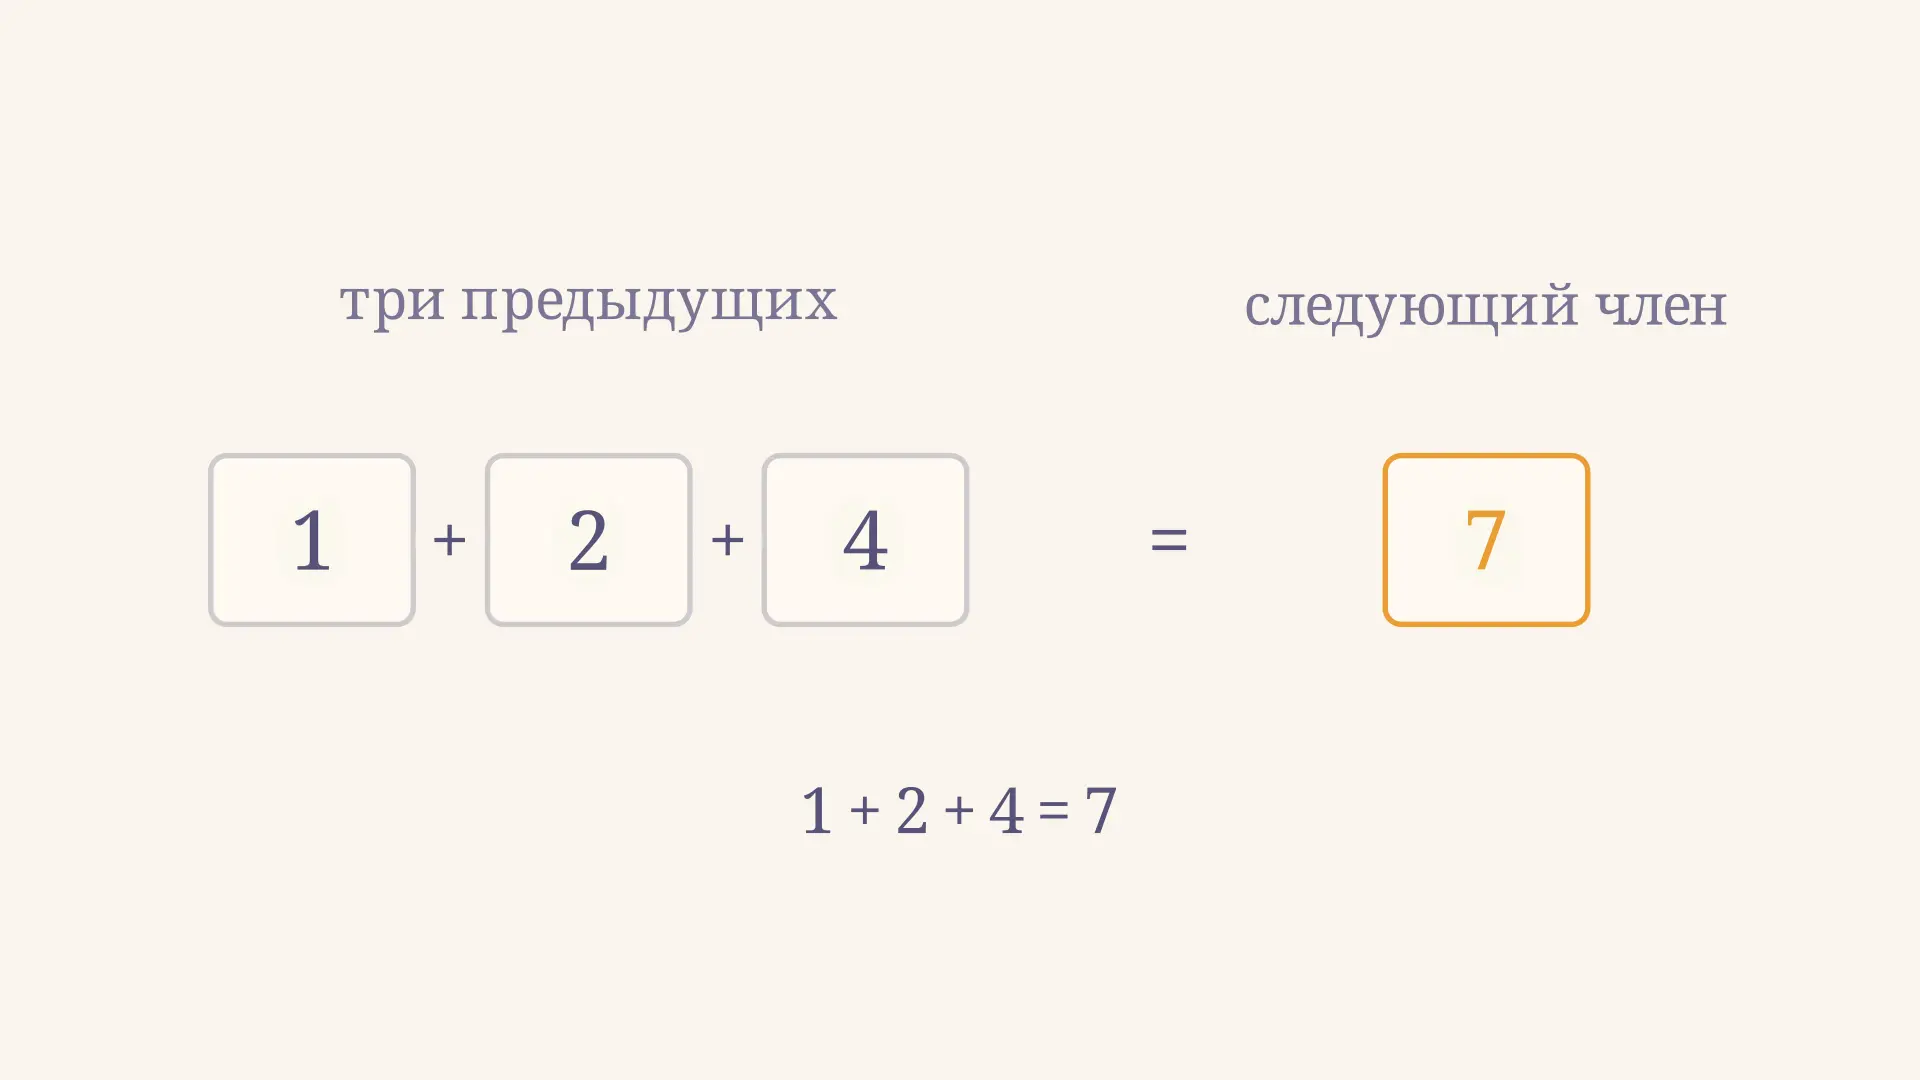
Числа трибоначчи: формула и примеры вычисления
Числа трибоначчи: три начальных значения, рекуррентная формула и расчёт по шагам. Как последовательность считает пути по ступенькам и как написать эффективный алгоритм.
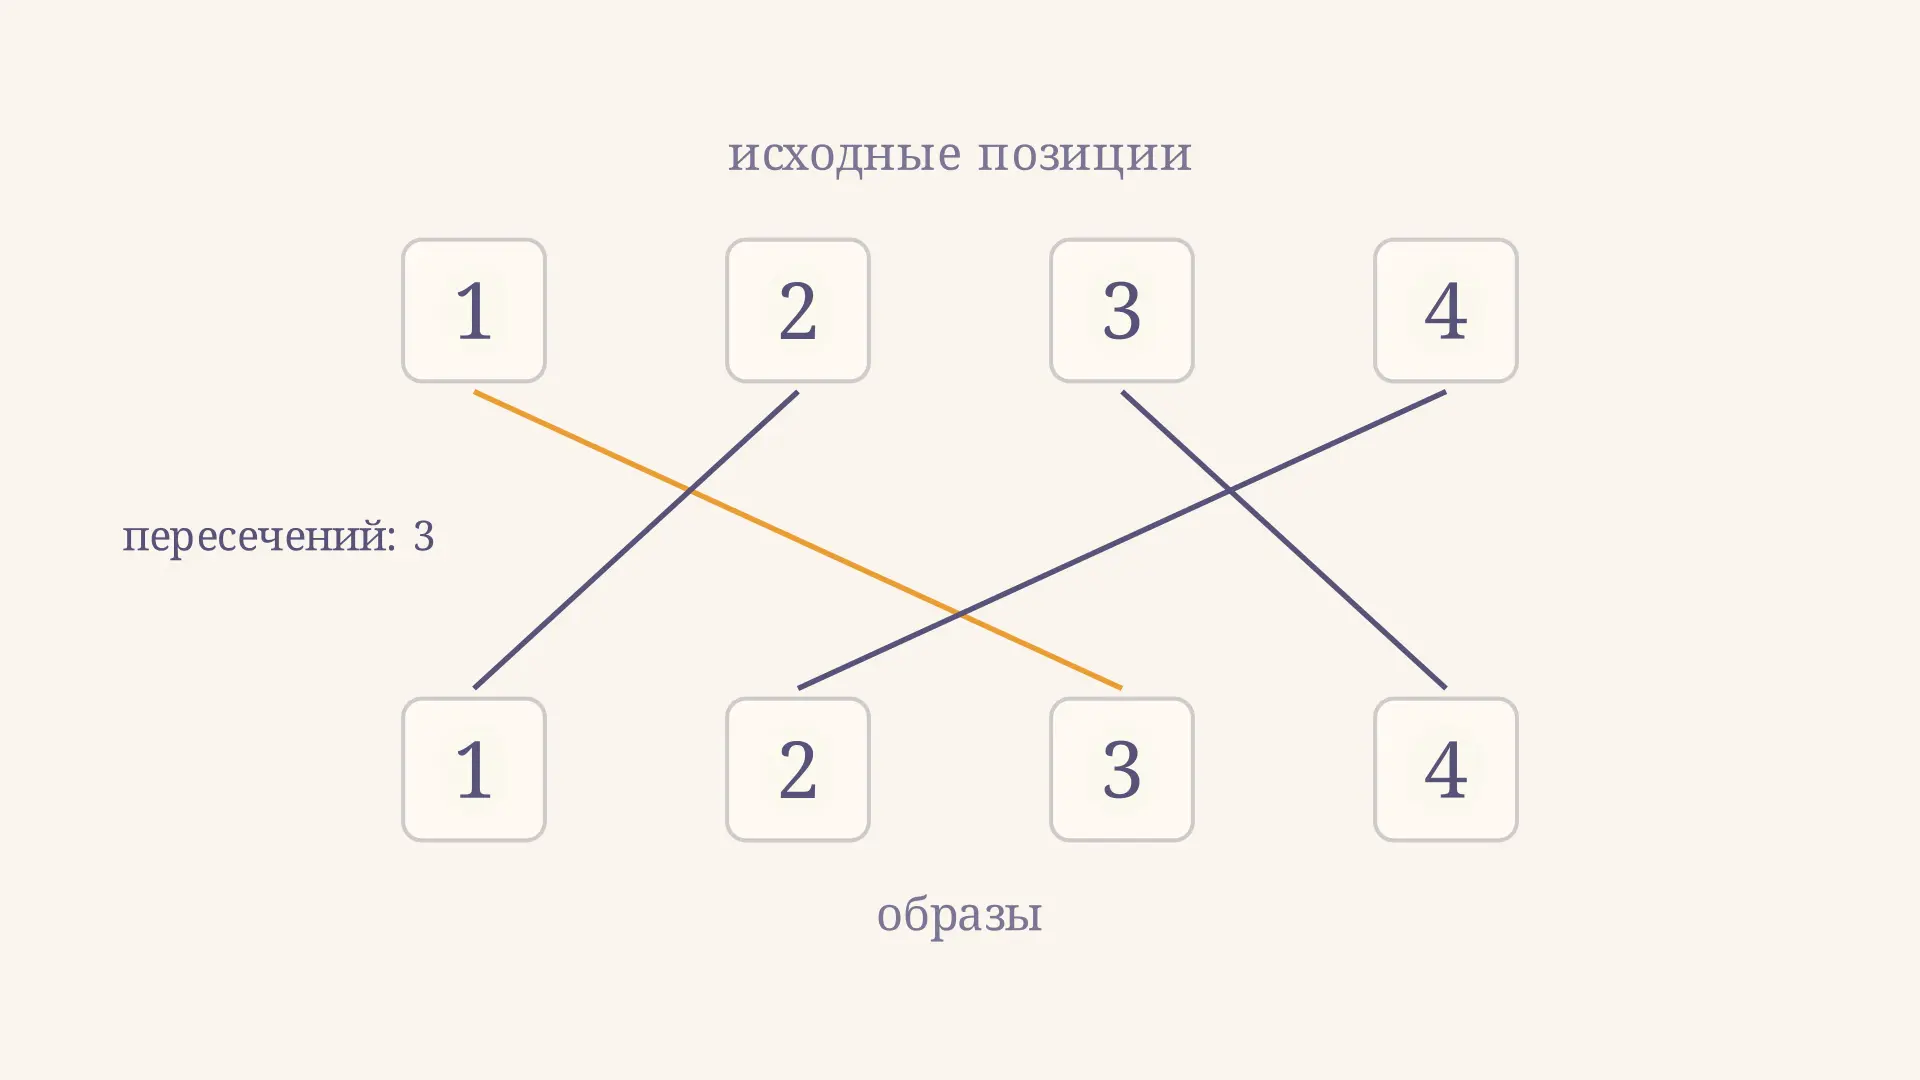
Чётность подстановки: инверсии и знак
Чётность подстановки через инверсии, транспозиции и циклы: пошаговый подсчёт, доказательство независимости разложения и применение в алгоритмах и определителях.
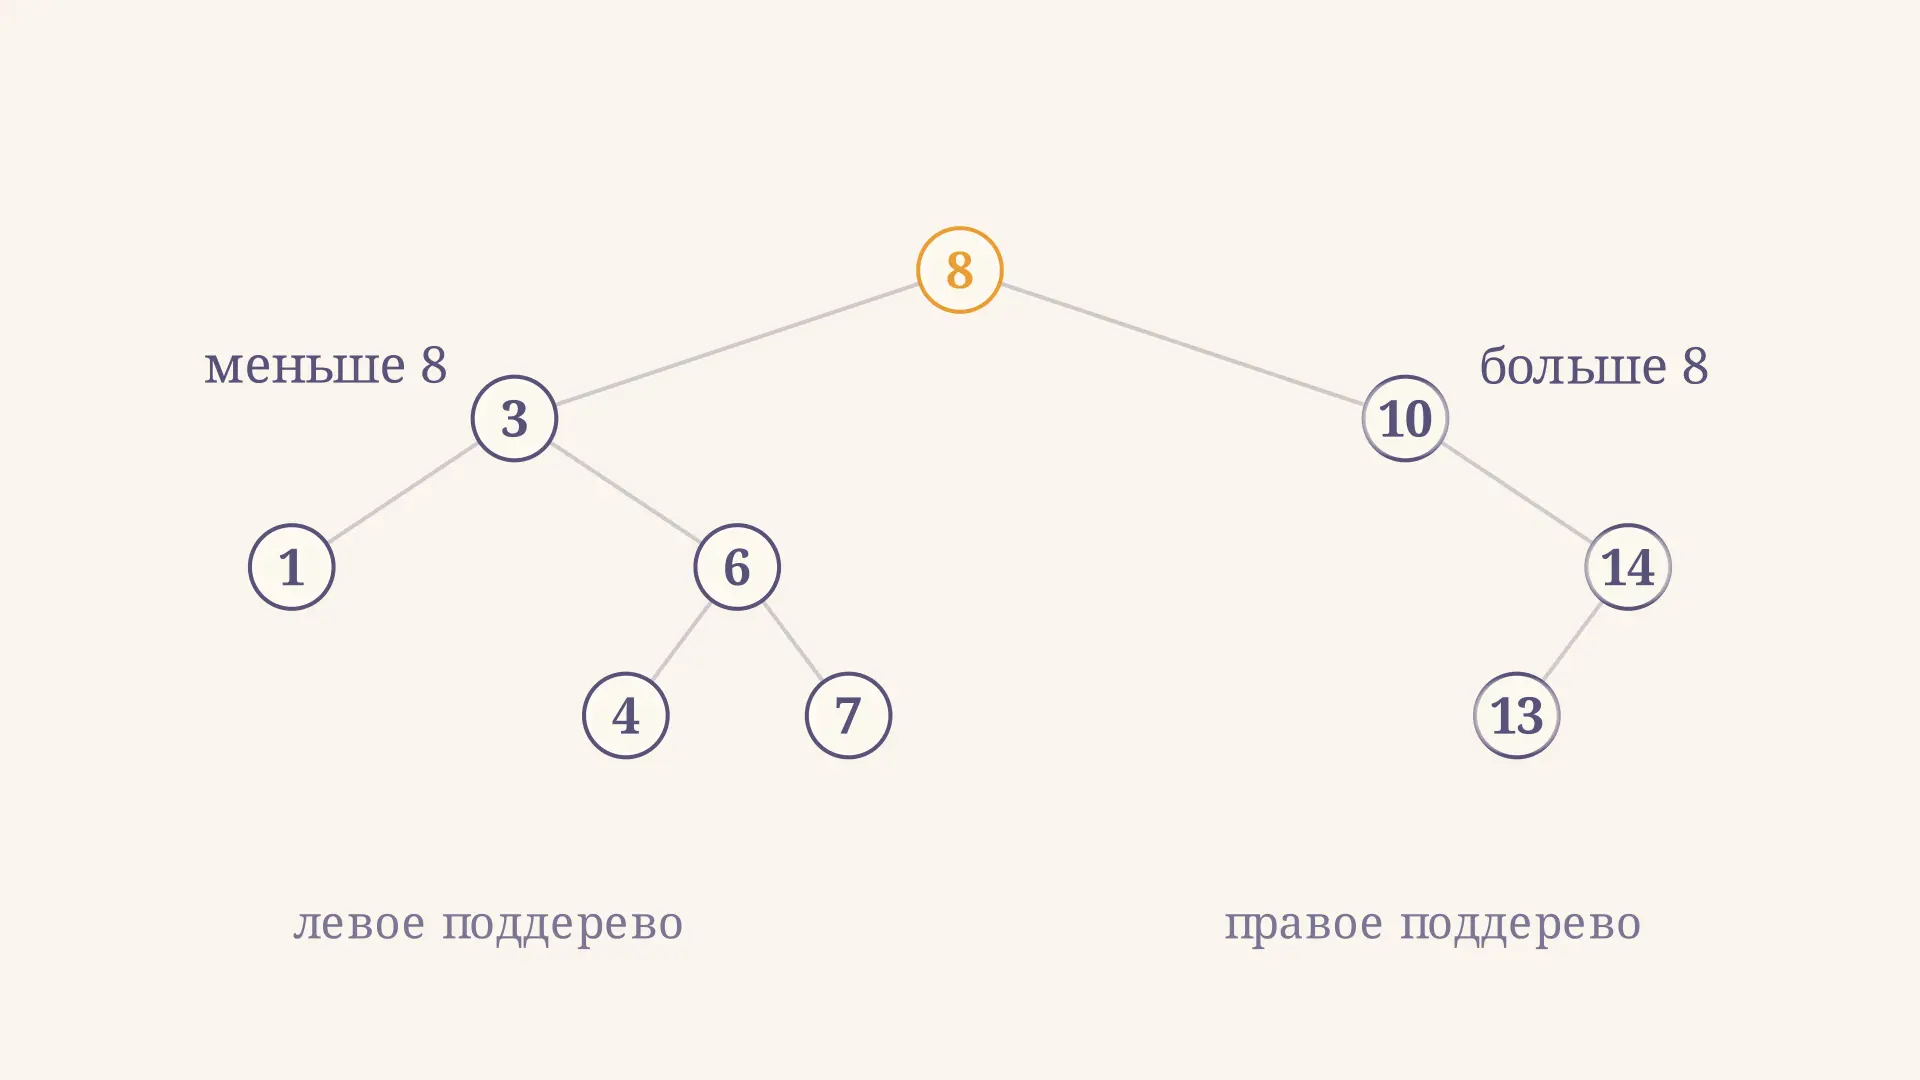
Дерево двоичного поиска: построение и операции
Дерево двоичного поиска: как устроены узлы, как построить BST по ключам, выполнить обход и удалить элемент, от чего зависит высота и сложность операций.