Алгоритм LZ77: сжатие с помощью ссылок назад
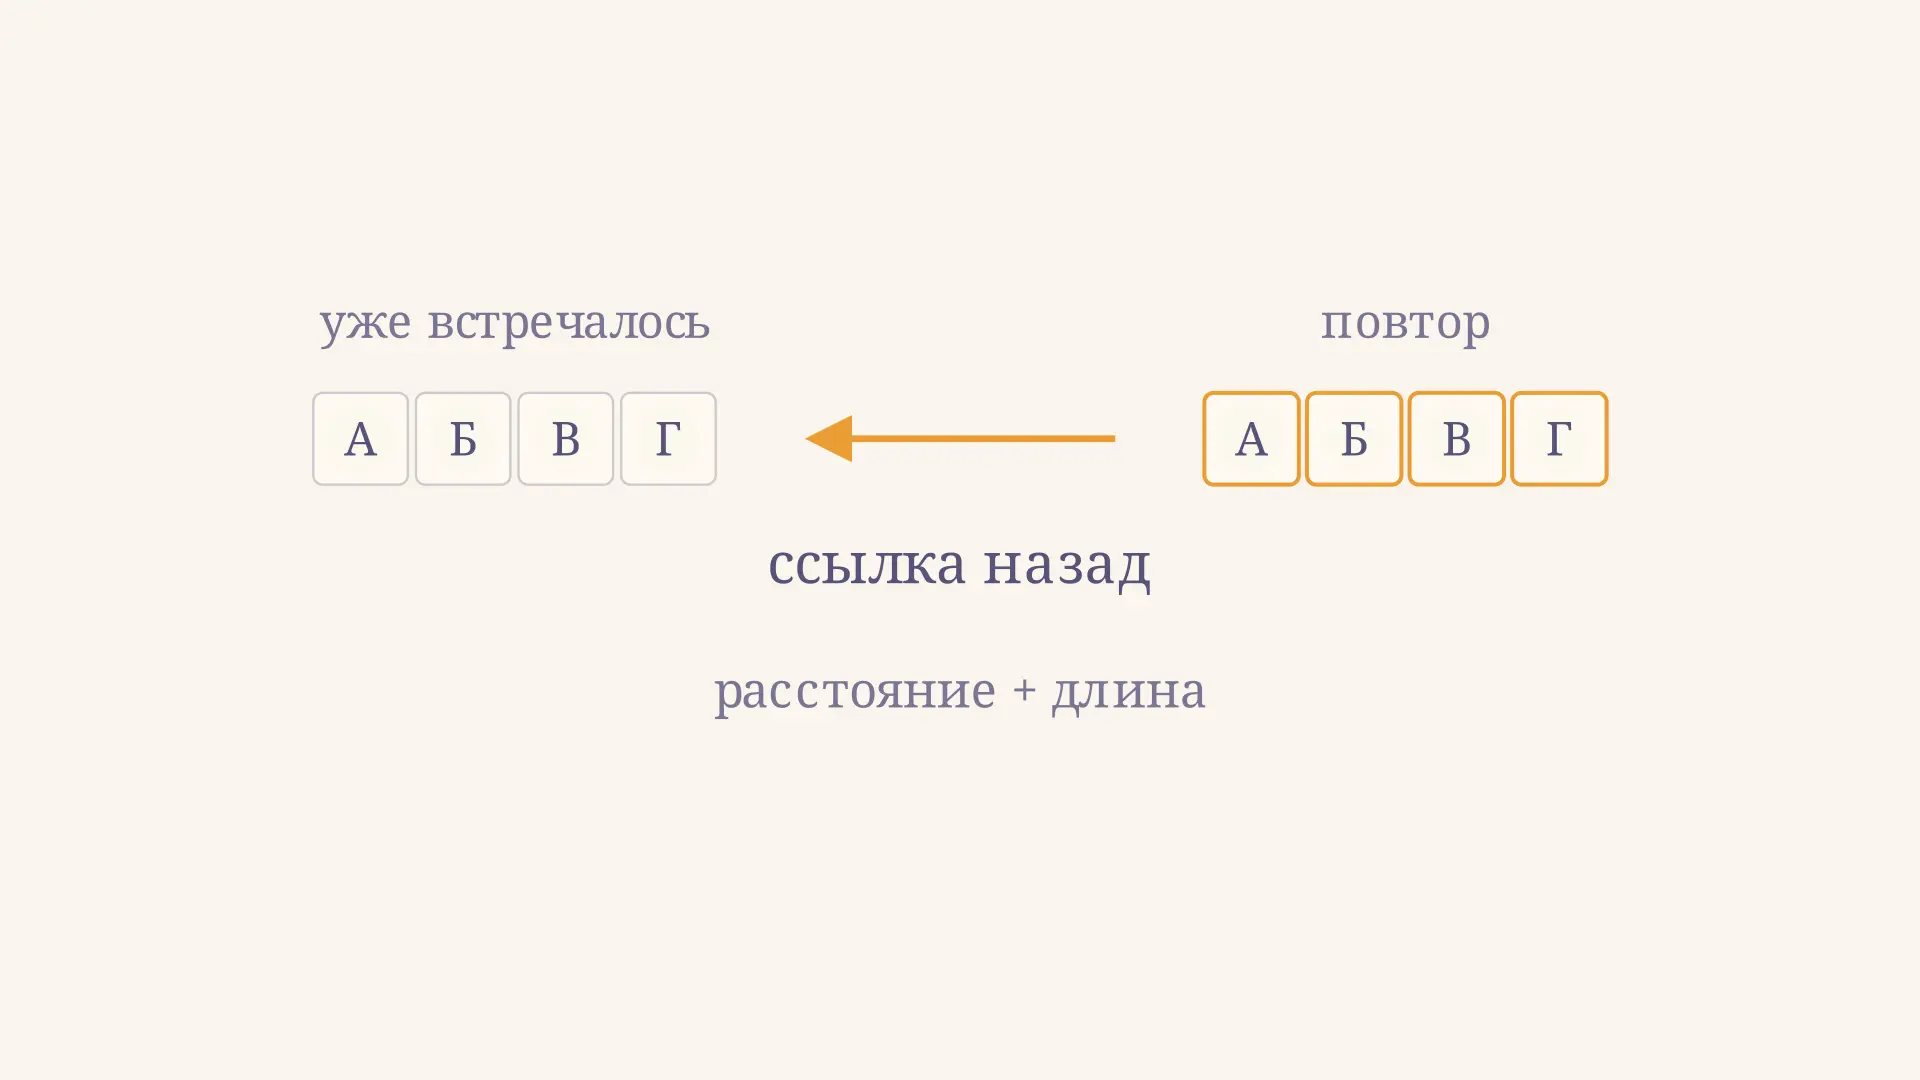
Алгоритм LZ77 сжимает данные без потерь, заменяя повторяющийся фрагмент ссылкой на то, что уже встретилось раньше. Вместо второй записи последовательности можно сообщить декодеру, насколько вернуться назад и сколько символов скопировать. При восстановлении данные собираются точно в исходном порядке. Попробуйте изменить размер истории и максимальную длину ссылки в примере ниже: сразу видно, какие повторы алгоритм способен заметить.
Идея: повтор уже находится в истории
Представим строку как ленту, по которой слева направо движется указатель. Слева от него находится уже обработанная история, справа начинается необработанный остаток. Если начало остатка совпадает с фрагментом истории, кодировщик может выдать ссылку вместо повторных символов. Если совпадения нет или оно слишком короткое, он выдаёт очередной символ как литерал.
История ограничена размером окна: старые данные постепенно выходят из него. Поэтому алгоритм использует саму последовательность как словарь, а не хранит заранее подготовленный список слов. Якоб Зив и Абрахам Лемпел описали принцип последовательного сжатия в работе 1977 года.
В ролике движение показывает именно порядок восстановления. На обратном ходе показанные состояния повторяются в обратном порядке, чтобы цикл начинался с того же кадра; настоящий декодер при этом не удаляет данные.
Из чего состоит ссылка
В этой статье используем учебный вариант с двумя видами токенов: отдельный литерал и пара , где - расстояние назад от текущей позиции, а - число копируемых символов. Если совпадение короче двух символов, выдаём литерал. При равной длине выбираем ближайшее совпадение. Это конкретные правила примера: другие варианты LZ77 могут оформлять токены иначе.
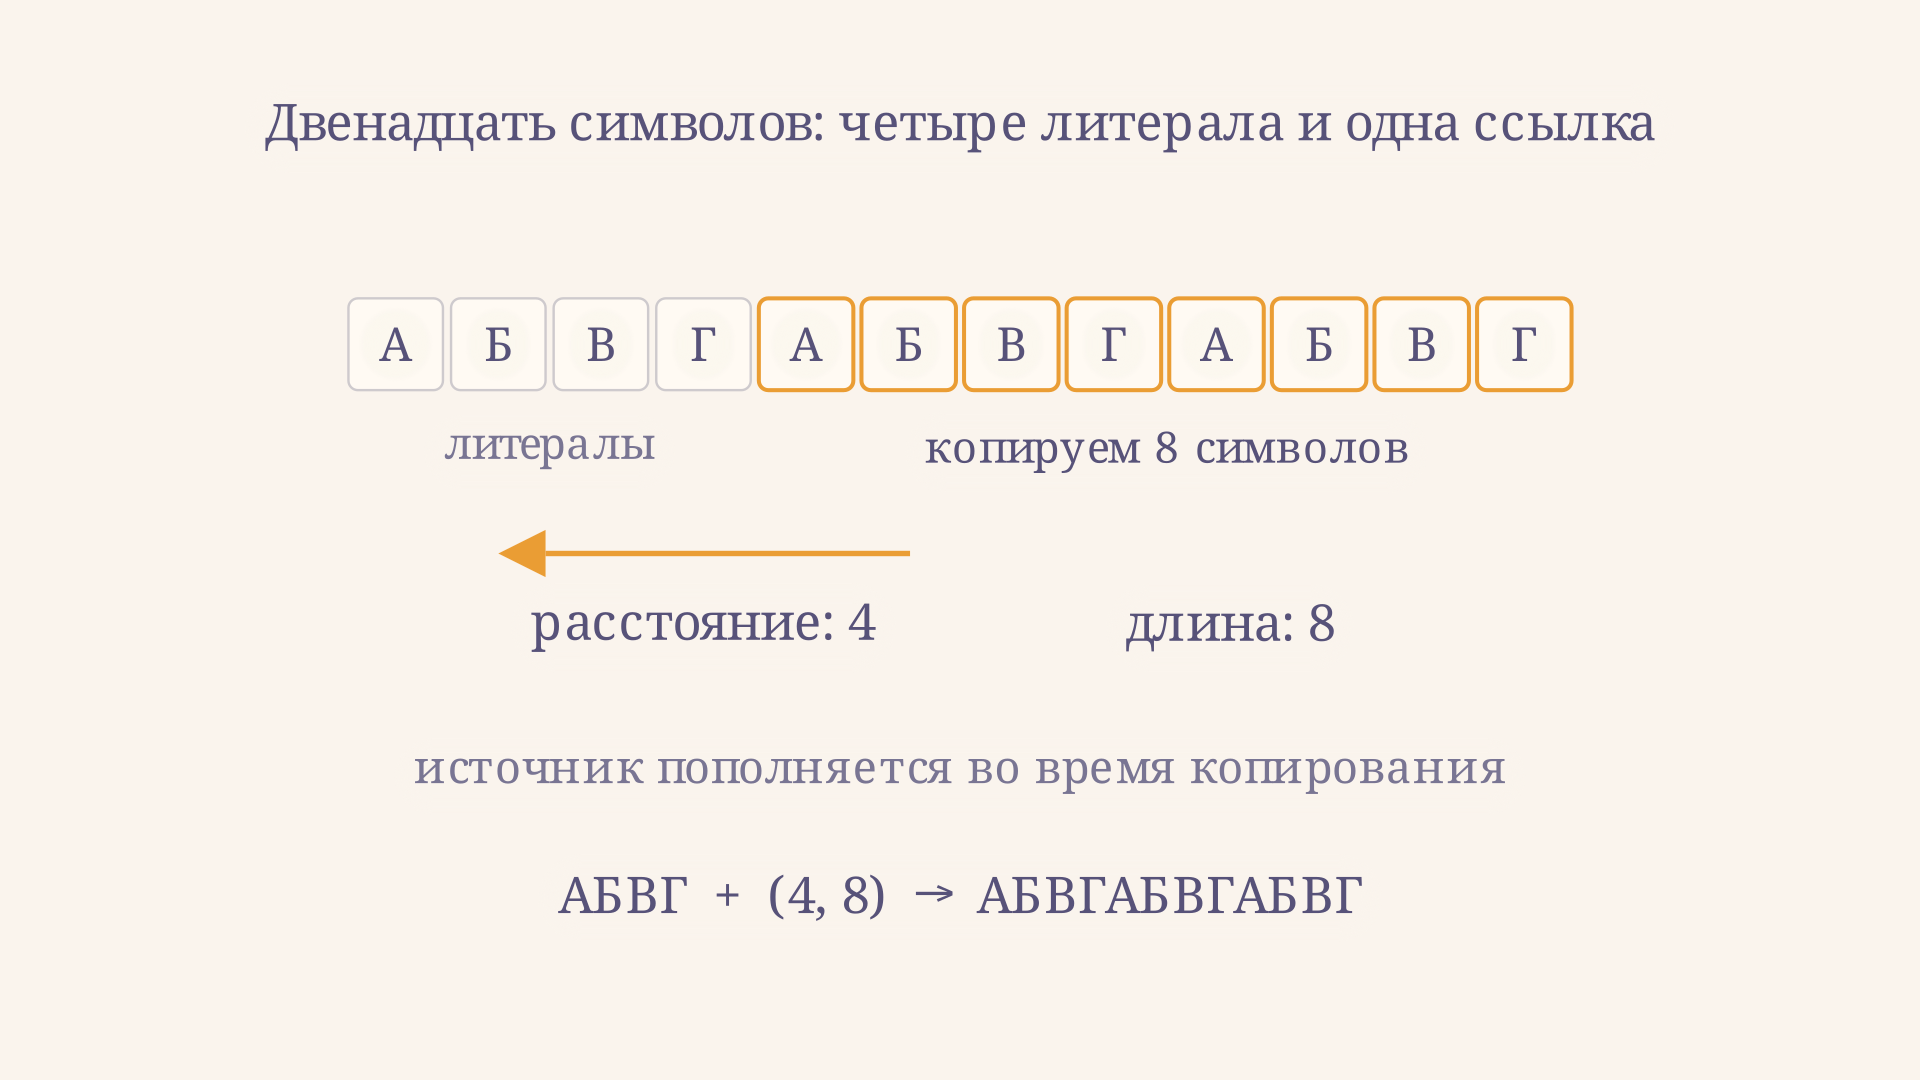
Например, означает: отступить на четыре символа от конца уже восстановленного вывода и последовательно дописать восемь символов. Расстояние считается в символах нашей учебной строки. Реальные архиваторы обычно работают с байтами, а способ представления литералов и ссылок задаётся форматом.
История и буфер просмотра вперёд выполняют разные задачи. Размер истории ограничивает возможное расстояние; предел просмотра ограничивает длину искомого совпадения. Увеличение окна позволяет найти более далёкий повтор, но может сделать поиск и представление расстояния дороже. Увеличение предела длины позволяет одной ссылке описать более длинный фрагмент, если он действительно совпадает.
Пошаговый разбор строки
Возьмём строку АБВГАБВГАБВГ, историю до восьми символов и максимальную длину совпадения восемь. Декодер в начале ничего не знает, поэтому первые четыре разных символа передаются буквально. После этого кодировщик видит, что остаток начинается теми же четырьмя символами и продолжает повторяться.
| Шаг | Выданный токен | Восстановлено после шага |
|---|---|---|
| 1 | А | А |
| 2 | Б | АБ |
| 3 | В | АБВ |
| 4 | Г | АБВГ |
| 5 | (4, 8) | АБВГАБВГАБВГ |
Получилось пять токенов для двенадцати исходных символов. Четыре литерала дают начальную историю; ссылка покрывает оставшиеся восемь символов. При окне истории три предыдущий блок АБВГ уже недоступен целиком: в этом примере ни один из его символов не повторяется в трёх непосредственно предшествующих позициях, поэтому получится двенадцать литералов. При окне четыре и более ссылка становится доступна.
Количество токенов удобно для понимания разбора, но это не размер сжатого файла. В настоящем потоке литерал, расстояние, длина, служебные признаки и заголовки занимают определённое число битов. Пока эти правила не заданы, делать вывод о коэффициенте сжатия в байтах нельзя.
Почему копирование может перекрываться
В примере длина восемь больше расстояния четыре. Кажется, что в истории есть только четыре нужных символа. Но декодер копирует не весь фрагмент одним независимым блоком, а последовательно: каждый новый символ сразу попадает в конец вывода и может стать источником следующего.
После первых четырёх копирований получается АБВГАБВГ. Теперь ещё четыре шага берут символы из только что дописанной части. Так восстанавливается вся строка. Общее правило для каждого шага: взять символ на расстоянии от текущего конца вывода и дописать его. Оно также позволяет ссылке после литерала А добавить ещё пять букв А.
Этот механизм родственен кодированию длин серий RLE: оба подхода используют повторяемость. Но RLE обычно описывает серию одного и того же значения, а ссылка LZ77 может повторять и многосимвольный шаблон. Корректный декодер должен проверять, что расстояние положительно и не превышает доступную историю; иначе ссылка указывает на несуществующие данные.
Как кодировщик выбирает совпадение
Простой жадный вариант начинает с текущей позиции и перебирает допустимые расстояния от единицы до размера доступной истории. Для каждого расстояния он сравнивает символы до первого несовпадения, конца входа или предела длины. Выбирается самое длинное совпадение; если несколько одинаковы, в нашем примере побеждает ближайшее. Затем указатель сдвигается на длину ссылки или на один символ литерала.
При перекрытии сравнение может заходить за текущую позицию: кодировщик проверяет исходный текст, а декодер затем порождает такие символы постепенно. Оба должны следовать одним правилам. Для ручной проверки полезно выписать позицию, допустимые расстояния и выбранную длину на каждом шаге, а затем отдельно восстановить результат из токенов.
Поиск повтора связан с задачей поиска подстрок, хотя цель другая: здесь нужна ссылка на уже виденный фрагмент. Для сравнения можно изучить алгоритм Кнута - Морриса - Пратта, который ищет заданный образец в тексте. У LZ77 набор возможных образцов и граница истории меняются вместе с позицией.
От окна к потоку токенов
Скользящее окно удобно представить как ограниченную память между кодировщиком и декодером. После выдачи токена позиция кодировщика продвигается вперёд, а история пополняется всем обработанным фрагментом. Если её размер превысил предел, самые старые символы исключаются из области поиска. Декодер делает то же самое по мере восстановления. Поэтому обе стороны могут работать последовательно, не храня весь исходный файл в памяти.
Рассмотрим конец нашего примера при пределе длины четыре. После первых четырёх литералов кодировщик выдаст две ссылки вместо одной . Восстановленный текст не изменится, но токенов станет шесть. Если разрешить длину восемь, достаточно пяти токенов. Сравнение показывает влияние ограничения просмотра, однако экономия в битах всё равно зависит от формата представления ссылок.
Сложность и реальное сжатие
Пусть длина входа равна , размер истории - , а максимальная длина сравнения - . Наивный перебор в каждой позиции имеет верхнюю оценку сравнений; это оценка простого варианта, а не свойство любой реализации. На практике используют структуры для быстрого поиска кандидатов и ограничивают число проверок. Большее окно может находить более далёкие совпадения, но требует больше ресурсов.
Жадный выбор самой длинной ссылки не всегда даёт минимальный поток битов: цена ссылки зависит от её полей, а выбор влияет на следующие позиции. Поэтому кодировщик может учитывать стоимость токенов или сравнивать несколько вариантов. Формат DEFLATE, например, сочетает ссылки семейства LZ77 с кодами Хаффмана; его поля и ограничения описаны в RFC 1951. Учебная пара выше объясняет идею, но не является побайтовой записью DEFLATE. Принцип назначения кодовых слов разной длины разобран отдельно в статье про равномерное и неравномерное кодирование.
Сжатие без потерь не обязано уменьшать любой файл. Неповторяющиеся или уже сжатые данные могут дать мало полезных ссылок, а служебная информация добавит размер. Разница между символами и байтами также важна: в кодировании ASCII символы и их числовые коды рассматриваются отдельно, тогда как наша кириллическая строка намеренно служит абстрактным примером по символам.
Частые ошибки
- Считать расстояние от начала строки. Оно отсчитывается назад от текущего конца восстановленных данных.
- Запрещать длине превышать расстояние. В выбранной модели перекрытие допустимо благодаря последовательному копированию.
- Приравнивать число токенов к числу байтов. Поля и служебные данные нужно сначала закодировать.
- Забывать ограничение окна. Совпадение за пределами истории недоступно даже при полном совпадении текста.
- Смешивать варианты записи. В некоторых учебных схемах используют тройку с дополнительным символом; здесь литералы и пары идут отдельно.
FAQ
LZ77 всегда восстанавливает данные точно?
Да, если поток корректен, а кодировщик и декодер используют согласованный формат. Это сжатие без потерь: каждый литерал и каждая допустимая ссылка однозначно восстанавливаются в исходной последовательности.
Что делать, если совпадения нет?
В нашей модели выдать один литерал и сдвинуть позицию на один символ. То же делаем, если совпадение есть, но его длина меньше двух.
Чем LZ77 отличается от LZ78?
LZ77 ссылается на фрагменты недавней истории через расстояние и длину. LZ78 строит словарь отдельных фраз и передаёт ссылки на его записи; конкретное представление зависит от реализации.
Коротко
LZ77 ищет повторы в скользящей истории и заменяет подходящие фрагменты ссылками назад. Расстояние задаёт источник, длина - число копирований, а посимвольное восстановление допускает перекрытие. Эффективность зависит от данных, параметров окна и реальной цены токенов в выбранном формате.
Читайте также
Алгоритм Рабина-Карпа: поиск подстроки за O(n+m)
Разбираем алгоритм Рабина-Карпа: как полиномиальный хеш и скользящее окно ускоряют поиск подстроки до O(n+m) в среднем, почему бывают ложные совпадения и при чём тут плагиат.
Числа Белла: разбиения множества и формула
Числа Белла считают разбиения множества на непустые группы. Разбираем подробные примеры, рекуррентную формулу, связь с числами Стирлинга и алгоритм вычисления.
Числа трибоначчи: формула и примеры вычисления
Числа трибоначчи: три начальных значения, рекуррентная формула и расчёт по шагам. Как последовательность считает пути по ступенькам и как написать эффективный алгоритм.
Чётность подстановки: инверсии и знак
Чётность подстановки через инверсии, транспозиции и циклы: пошаговый подсчёт, доказательство независимости разложения и применение в алгоритмах и определителях.
Дерево двоичного поиска: построение и операции
Дерево двоичного поиска: как устроены узлы, как построить BST по ключам, выполнить обход и удалить элемент, от чего зависит высота и сложность операций.
Доминирующее множество в графе: определение и примеры
Как проверить доминирующее множество графа и найти число доминирования: разбираем путь из шести вершин, полный перебор, жадный подход и типичные ошибки.