Кодирование длин серий RLE: примеры и расчёт
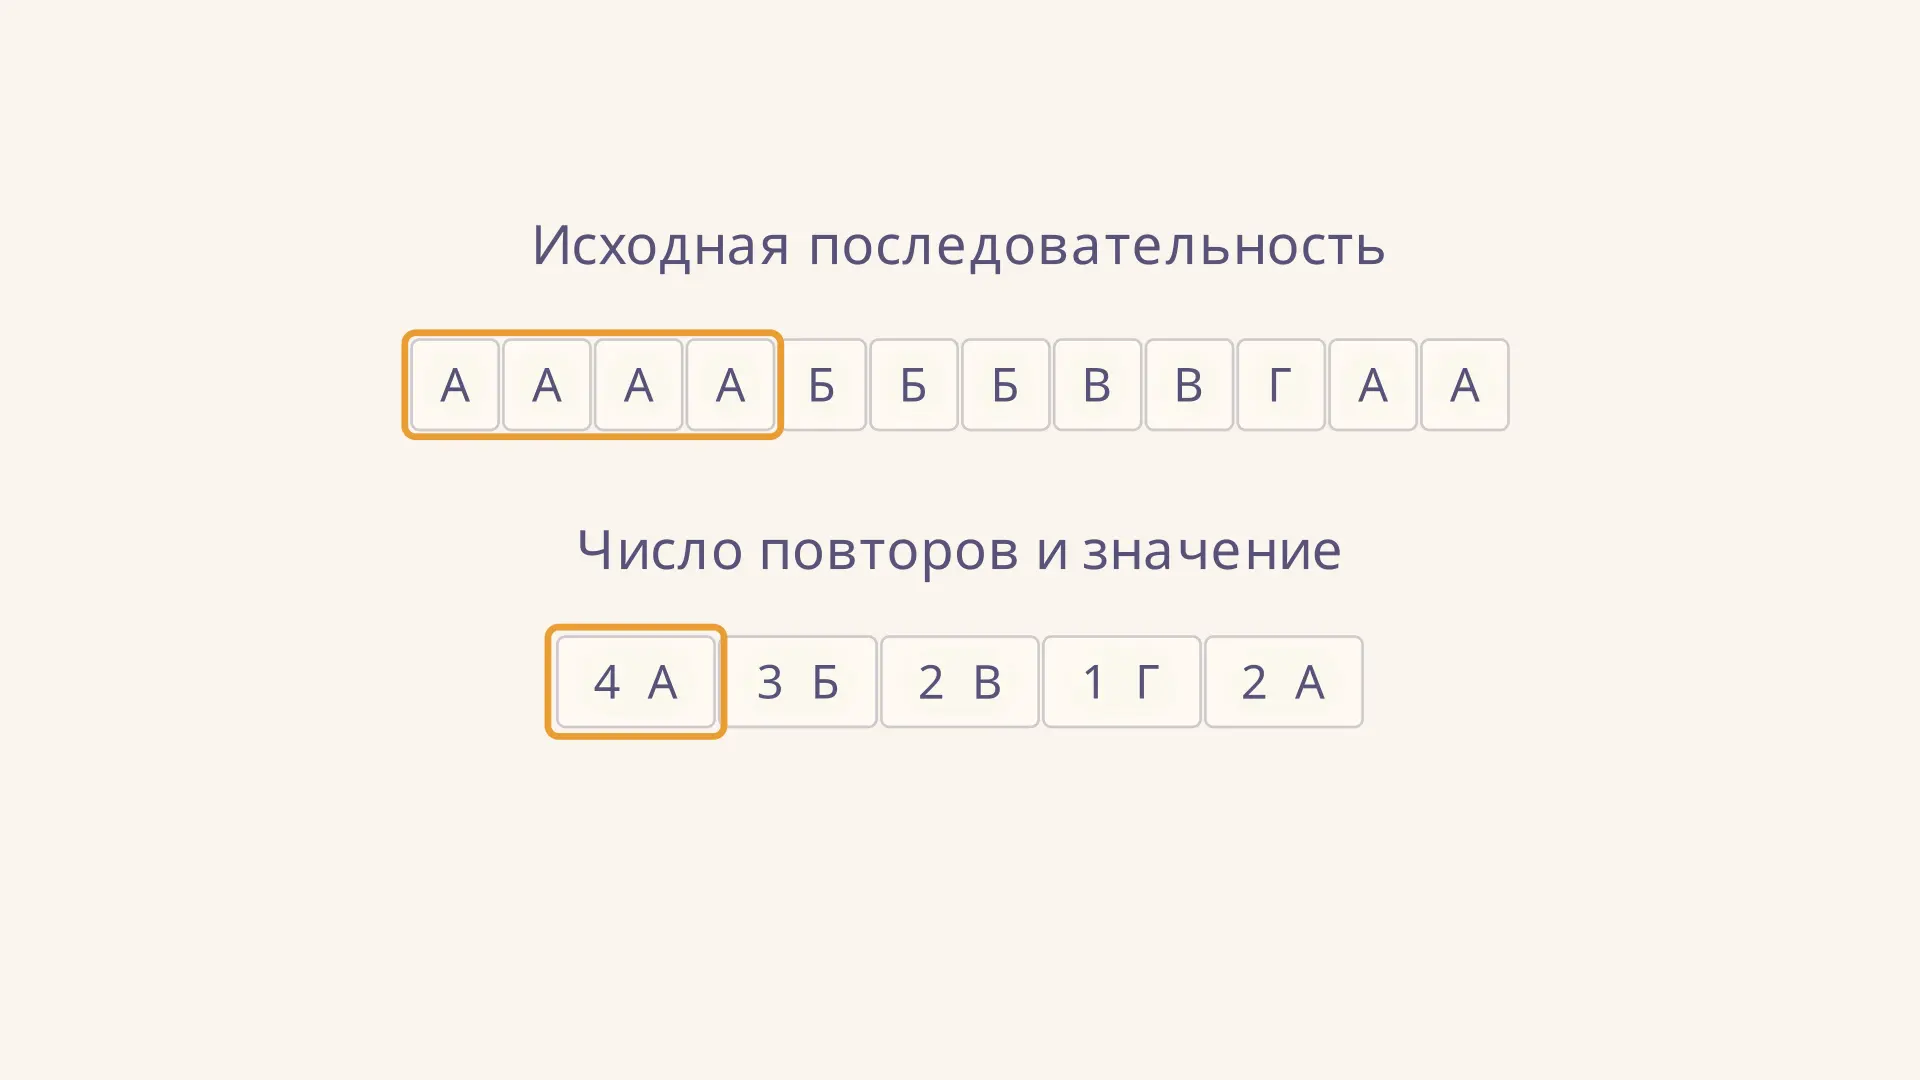
Кодирование длин серий, или RLE, заменяет цепочку одинаковых соседних значений одним значением и числом его повторений. Например, четыре одинаковых пикселя можно описать парой «4, цвет», а при чтении повторить цвет четыре раза. Метод относится к сжатию без потерь: при правильном декодировании исходная последовательность восстанавливается точно.
Но короткая запись на бумаге ещё не гарантирует меньший файл. Размер зависит от того, сколько бит выделено на счётчик и значение, как оформлен поток и есть ли заголовок. Попробуйте менять длину первой серии в калькуляторе: он использует простой учебный формат и сразу показывает момент, когда выигрыш появляется или исчезает.
Что считается серией
Серия - это максимальная непрерывная группа одинаковых элементов. В последовательности ААААБББВВГАА первая серия содержит четыре А, за ней идут три Б, две В, одна Г и ещё две А. Две группы А разделены другими значениями, поэтому объединять их нельзя: иначе порядок элементов изменится.
В этом примере серия длины один тоже получает пару. Договоримся записывать сначала количество, затем значение:
Скобки и запятые здесь только помогают человеку читать пары. В учебном двоичном формате ниже они не записываются. Коды А, Б, В и Г считаем условными однобайтовыми значениями: это не утверждение о длине русских букв в UTF-8. Различие символа и его байтового представления подробно разобрано в статье о кодировании текста в ASCII.
Золотая рамка показывает сразу две связанные части: сколько одинаковых элементов нашли и какую пару записали. При обратном ходе рамки пары не меняются: движение назад позволяет снова проследить соответствие в зацикленном видео.
Как закодировать последовательность
Работайте слева направо и храните текущее значение со счётчиком. Для первого элемента счётчик равен единице. Если следующий элемент совпадает с текущим, увеличьте счётчик; если отличается, выведите пару и начните новую серию со счётчиком один. В конце обязательно выведите последнюю пару: без неё хвост последовательности потеряется.
На нашем примере счётчик растёт от единицы до четырёх, пока встречается А. При появлении Б записываем и начинаем считать Б. После трёх Б встречаем В и записываем . Так продолжаем до конца, где для последних двух А получаем .
На практике элементом последовательности может быть байт, индекс цвета или другое значение фиксированного размера. До начала расчёта важно выбрать единицу: четыре одинаковых пикселя не обязательно занимают четыре байта. Если пиксель хранится в трёх байтах, а метод сравнивает целые пиксели, значение в паре может занимать три байта. Если же кодируются отдельные байты, серии определяются по соседним байтам и могут получиться другими.
Сканирование элементов требует операций: каждый элемент рассматривается один раз. Если выдавать пары сразу, дополнительная рабочая память для текущего значения и счётчика постоянна; место для результата в эту оценку не включено. Практическая реализация также должна учитывать вместимость счётчика: при верхнем пределе 255 серию из 300 одинаковых байтов можно разбить на серии 255 и 45, если формат допускает такие пары.
Как декодировать RLE
Декодер читает очередную пару и повторяет значение указанное число раз. Для он выводит АААА, для - БББ. После обработки всех пяти пар снова получается ААААБББВВГАА. Проверка обратным преобразованием помогает обнаружить пропущенную последнюю серию и перепутанный порядок полей.
Правила записи должны быть известны обеим сторонам. Если данные хранятся в виде текста без разделителей, строка вроде «12А» требует оговорить, что 12 - один счётчик, а не два отдельных поля. Ещё сложнее, когда сами значения могут быть цифрами. Фиксированные поля или однозначные разделители снимают эту неоднозначность, но их размер тоже нужно учитывать при подсчёте.
При ручной проверке удобно сначала выписать границы серий вертикальными чертами: АААА | БББ | ВВ | Г | АА. Затем сравните сумму всех счётчиков с длиной входа: . Это необходимая проверка, но её одной недостаточно: она не обнаружит перестановку двух серий. Поэтому после подсчёта лучше развернуть пары и сравнить полученную строку с исходной посимвольно.
Пустой вход в нашем учебном варианте даёт пустой выход: серий нет. В реальном файле при этом всё равно может понадобиться служебный заголовок. Декодер должен проверять допустимость счётчика и границы ожидаемого результата, чтобы повреждённый поток не запросил произвольный объём памяти.
Расчёт объёма и экономии
Пусть каждый исходный элемент занимает один байт, счётчик серии - один байт, значение в паре - тоже один байт. Заголовок и разделители не сохраняются. Для исходных элементов и серий получаем:
В примере , , следовательно, до кодирования 12 байт, после - 10. Экономия равна байтам, или . Отношение исходного размера к сжатому составляет . В разных задачах термин «коэффициент сжатия» могут определять и обратным отношением, поэтому саму дробь лучше записать явно.
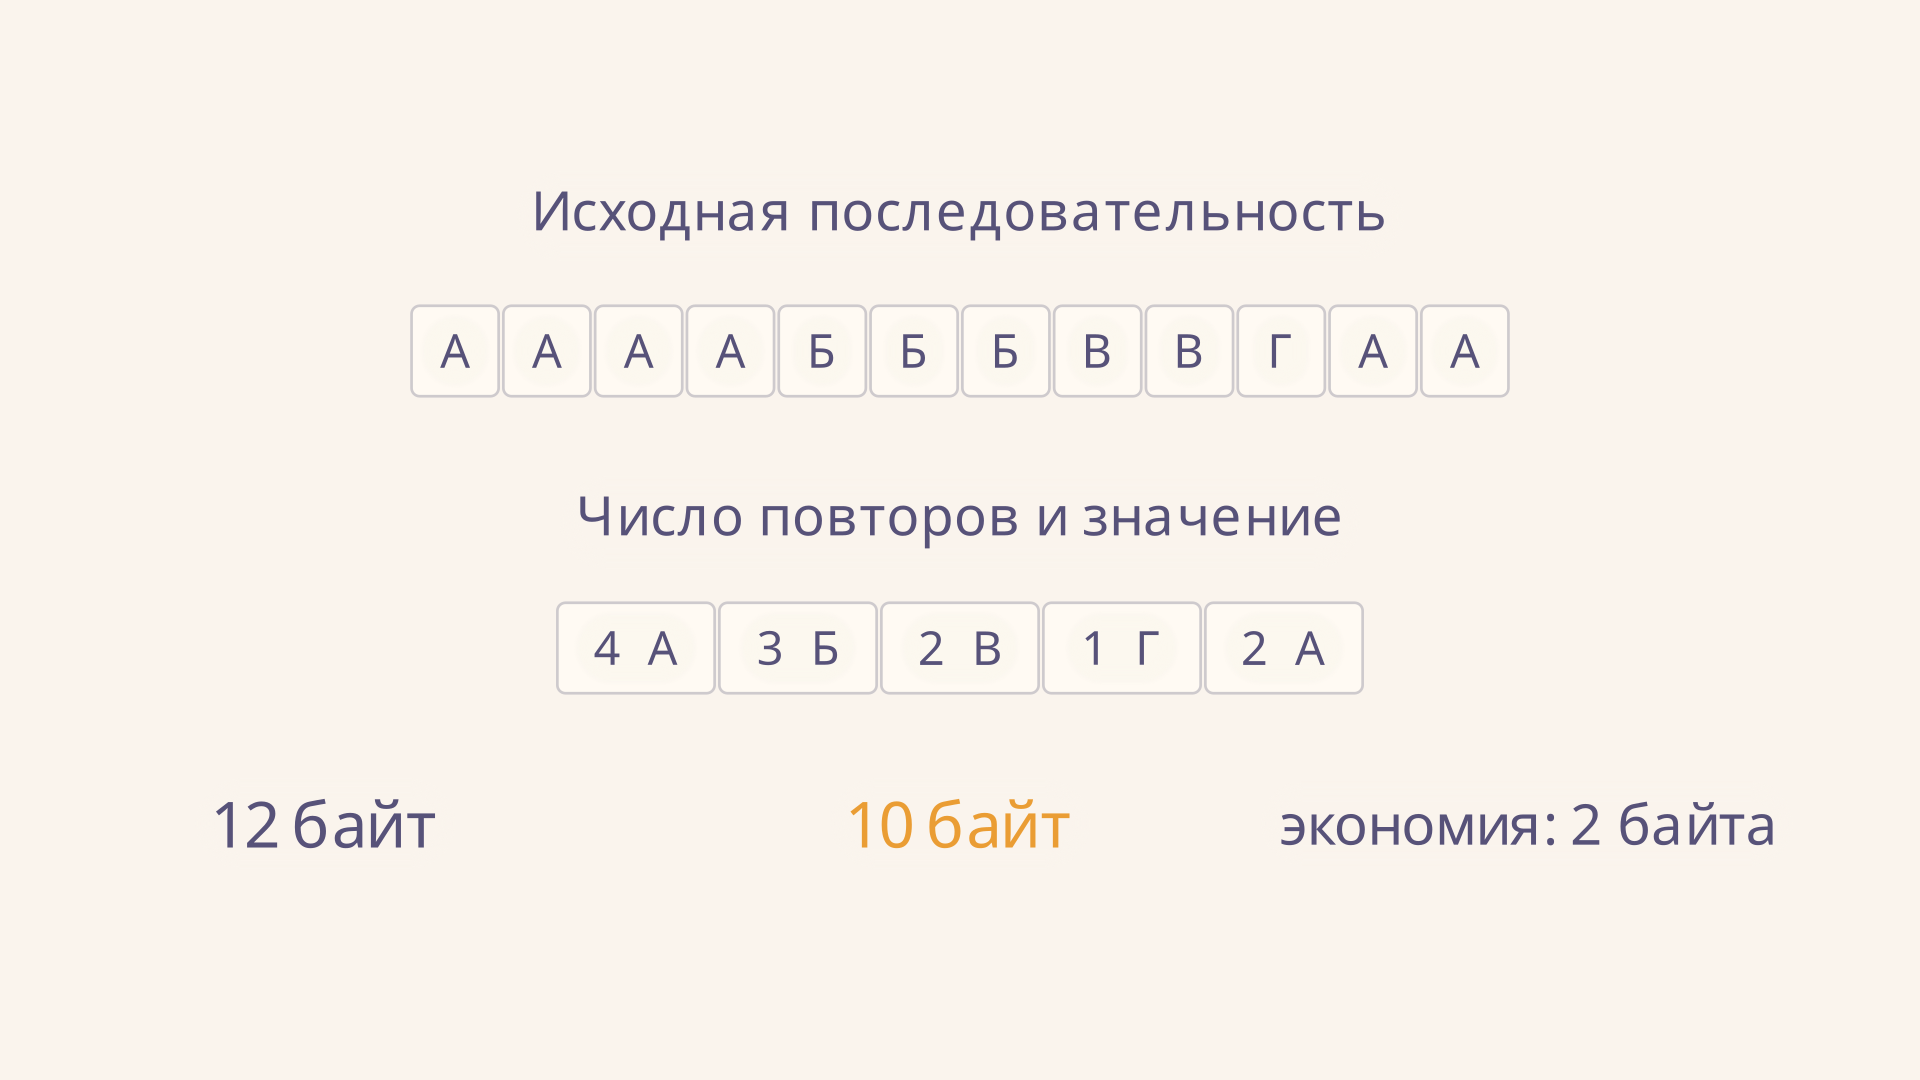
При этих условиях сжатие выгодно, когда , то есть средняя длина серии больше двух. При равенстве размер не меняется; если средняя длина меньше двух, результат увеличится. Калькулятор показывает обе ситуации: при первой серии из одного А исходный объём равен 9 байтам, а пары занимают 10; при двух А оба объёма равны 10 байтам.
Это условие зависит от выбранного формата. Если значение занимает бит, а счётчик бит, без заголовка сравнивают и . Если счётчики ограничены, сначала нужно разбить длинные серии и пересчитать . При наличии заголовка его размер добавляют к правой части. В задачах о растровой графике полезно отдельно вычислить исходный размер по глубине цвета, а затем применять заданные правила сжатия.
Где RLE помогает, а где мешает
Метод хорошо работает на данных с длинными непрерывными повторами: например, на маске изображения с крупными однотонными областями или на простой пиксельной схеме. Важно не только количество одинаковых значений, но и их расположение. У строк ААААББББ и АБАБАБАБ одинаковые наборы символов, однако в первой две серии, а во второй восемь. В нашей модели их размеры после кодирования составят соответственно 4 и 16 байт вместо 8 исходных.
На фотографии или шумном сигнале соседние значения часто различаются, и пары для коротких серий добавляют служебные байты. Частота дискретизации звука и разрядность отсчётов влияют на исходное представление сигнала, но сами по себе не гарантируют длинных одинаковых серий.
Порядок обхода изображения тоже влияет на результат. При построчном чтении горизонтальная полоса одного цвета может образовать длинные серии, а вертикальные чередующиеся полосы - много коротких. Условия конкретного формата определяют, можно ли продолжать серию через границу строки. Если нельзя, даже одинаковые крайние пиксели соседних строк придётся учитывать отдельно. Поэтому оценка по одной только площади однотонной области может оказаться неверной.
Реальные форматы могут кодировать одиночные значения отдельными блоками, ограничивать длину серии и применять специальные управляющие байты. Например, стандарт DICOM описывает RLE на основе схемы PackBits; её нельзя считать тождественной учебной записи «один байт счётчика плюс один байт значения». Для реального файла нужны правила конкретного формата, а не только число серий.
Частые ошибки
- Объединять одинаковые значения из разных мест. Серия непрерывна: последние две А в примере отделены от первых четырёх.
- Не записывать последнюю серию. Она заканчивается вместе с входом, даже если нового отличающегося значения уже нет.
- Считать символы записи парами за байты файла. Скобки и пробелы в примере - пояснение; другой формат может хранить их или не хранить вовсе.
- Ожидать уменьшения любого набора данных. Короткие серии при нашей схеме могут сделать результат больше исходного.
- Игнорировать размер счётчика и заголовка. При сравнении объёмов учитывайте их и ограничение максимальной длины серии.
FAQ
Теряются ли данные при RLE?
Нет, при корректном кодировании и декодировании восстанавливаются все исходные значения в прежнем порядке. Это сжатие без потерь.
Можно ли закодировать серию из одного элемента?
Да. В нашей модели Г представлена парой . Другие форматы могут хранить одиночные элементы иначе.
Всегда ли RLE уменьшает файл?
Нет. Для модели двух байтов на пару выигрыш есть только при средней длине серии больше двух и отсутствии дополнительных расходов. Правило для конкретного формата может отличаться.
Коротко
RLE заменяет каждую непрерывную серию парой «длина, значение», сохраняя возможность точно восстановить последовательность. В выбранном примере 12 однобайтовых элементов превращаются в пять двухбайтовых пар: 10 байт и экономия около 16,7 %. Эффективность определяется длинами серий и устройством формата, включая счётчики, ограничения и заголовки.
Читайте также
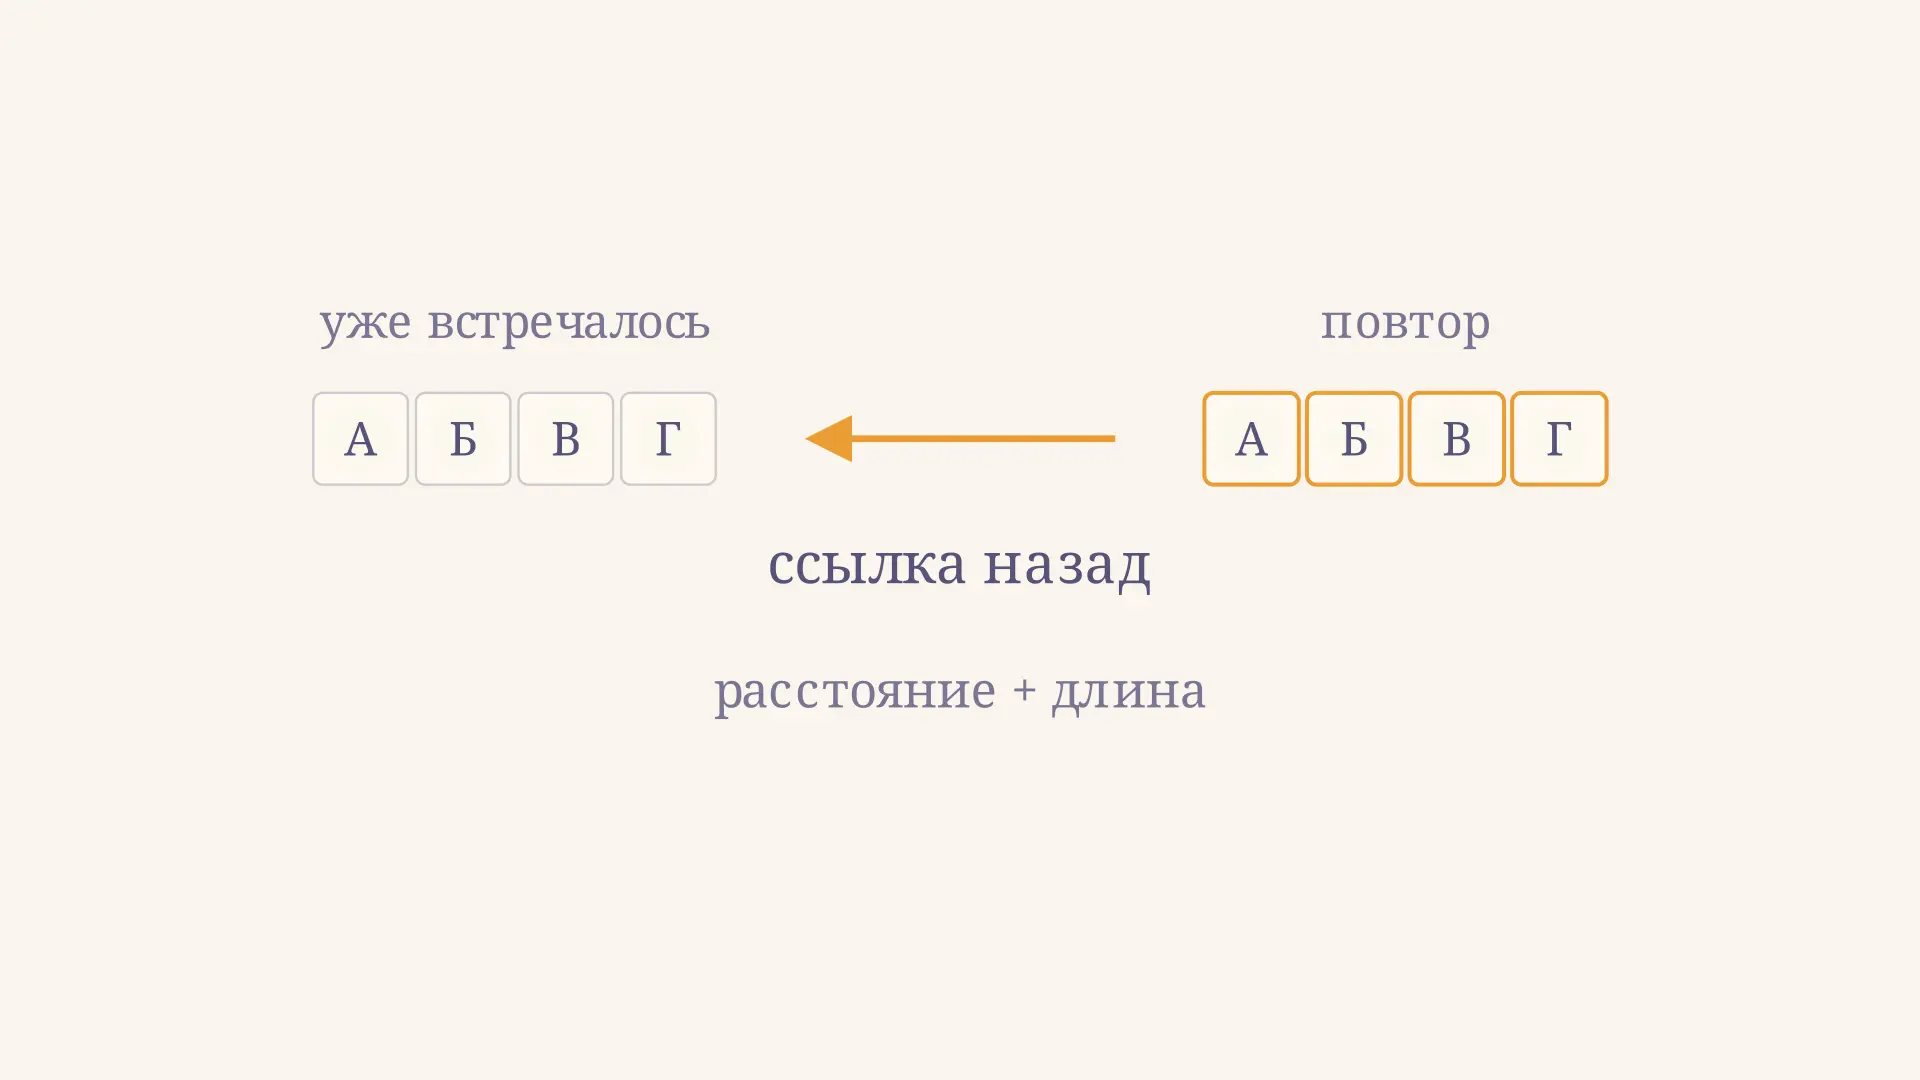
Алгоритм LZ77: сжатие с помощью ссылок назад
Алгоритм LZ77 на пошаговом примере: как скользящее окно находит повторы, что означают расстояние и длина, как работает перекрытие и от чего зависит размер результата.
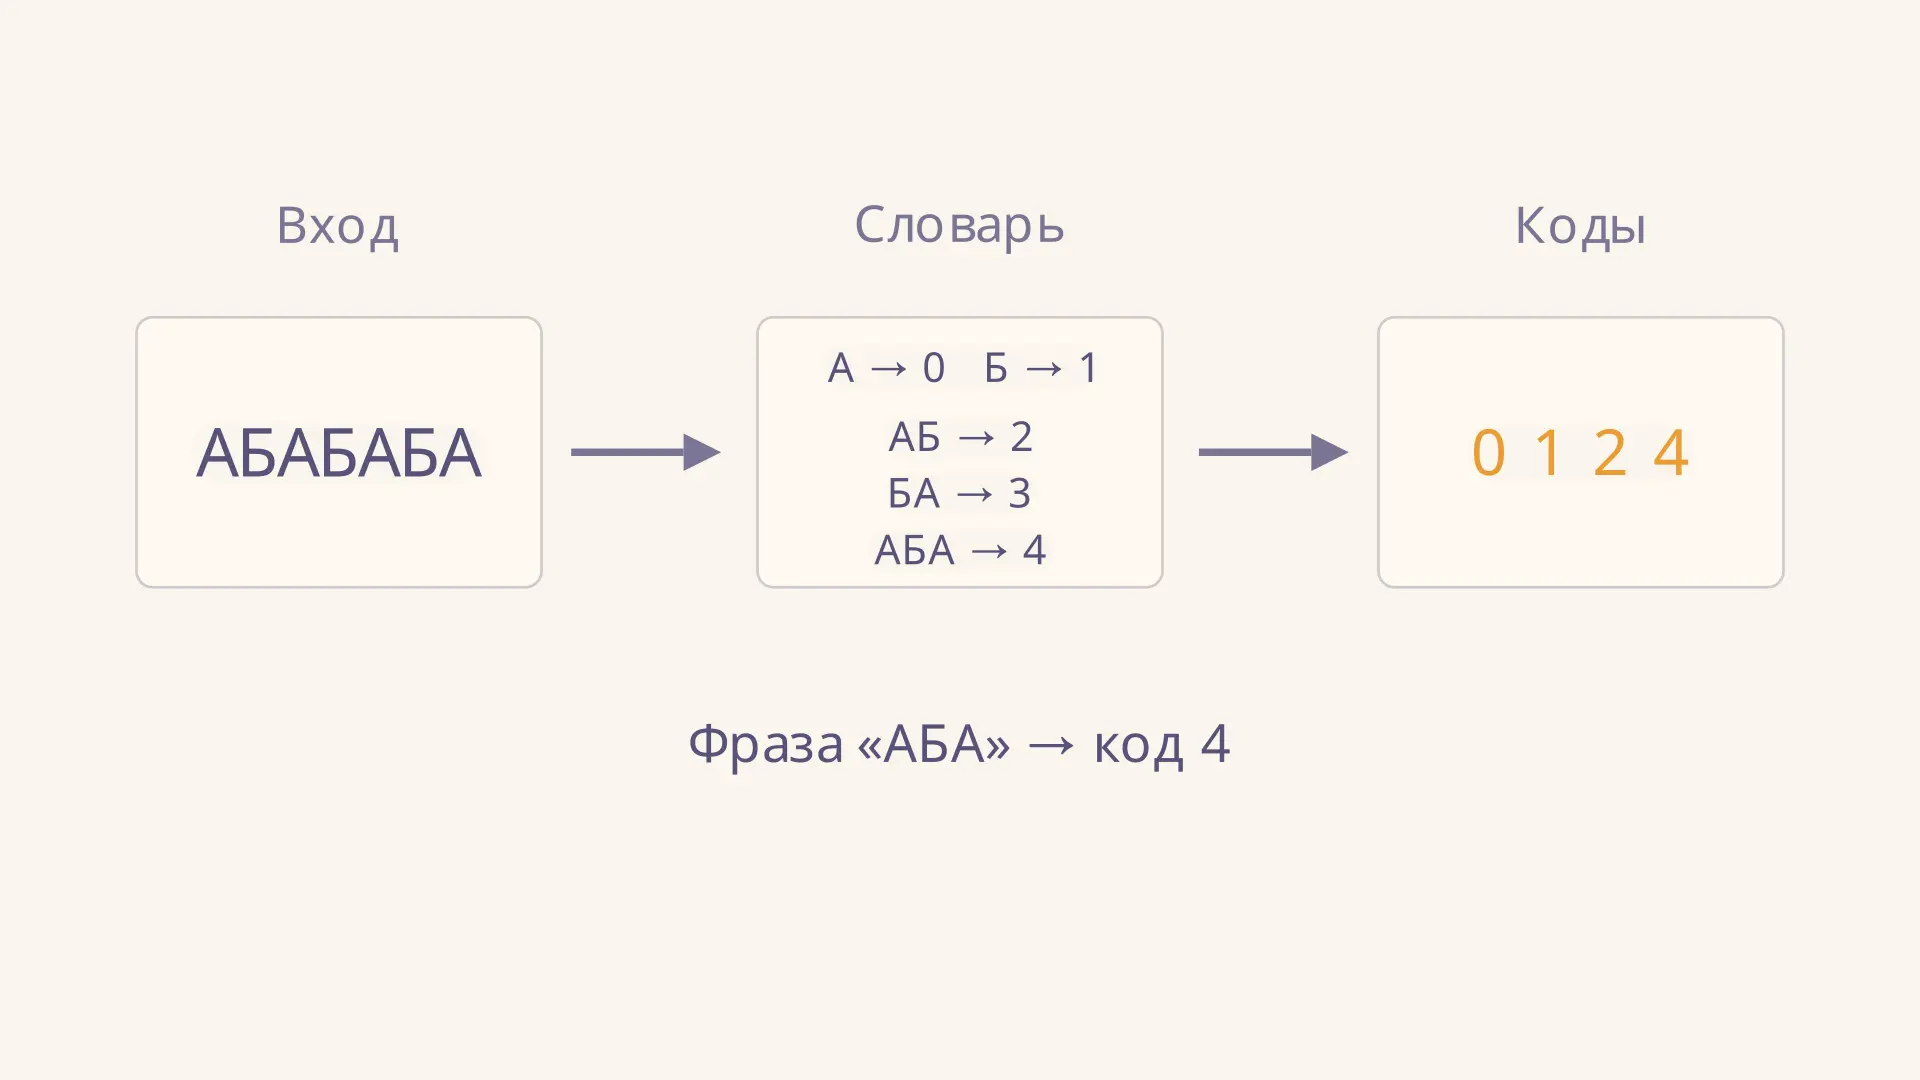
Алгоритм LZW: сжатие данных с помощью словаря
Алгоритм LZW по шагам: как строится словарь фраз, выдаются коды и восстанавливается исходная строка. Разберём пример, особый случай декодирования и оценку размера.
Блок-схема алгоритма: условный оператор
Как построить блок-схему алгоритма с условным оператором: обозначения, полное и неполное ветвление, пример проверки чётности и трассировка двух путей.
Исполнитель Черепаха: алгоритм рисования фигур
Как исполнитель Черепаха рисует фигуры по командам: положение, направление и перо, пошаговая трассировка квадрата, циклы и углы поворота многоугольников.
Обратная польская запись: как вычислять со стеком
Обратная польская запись простыми словами: как перевести выражение в постфиксную форму, вычислить его со стеком, сохранить порядок операндов и найти ошибку.
Перевод битов в байты и других единиц информации
Как перевести биты в байты и обратно, учитывать остаток, различать килобайты и кибибайты и пошагово решать задачи на размер файла и скорость передачи данных.