Прямой доступ к памяти DMA: как работает передача
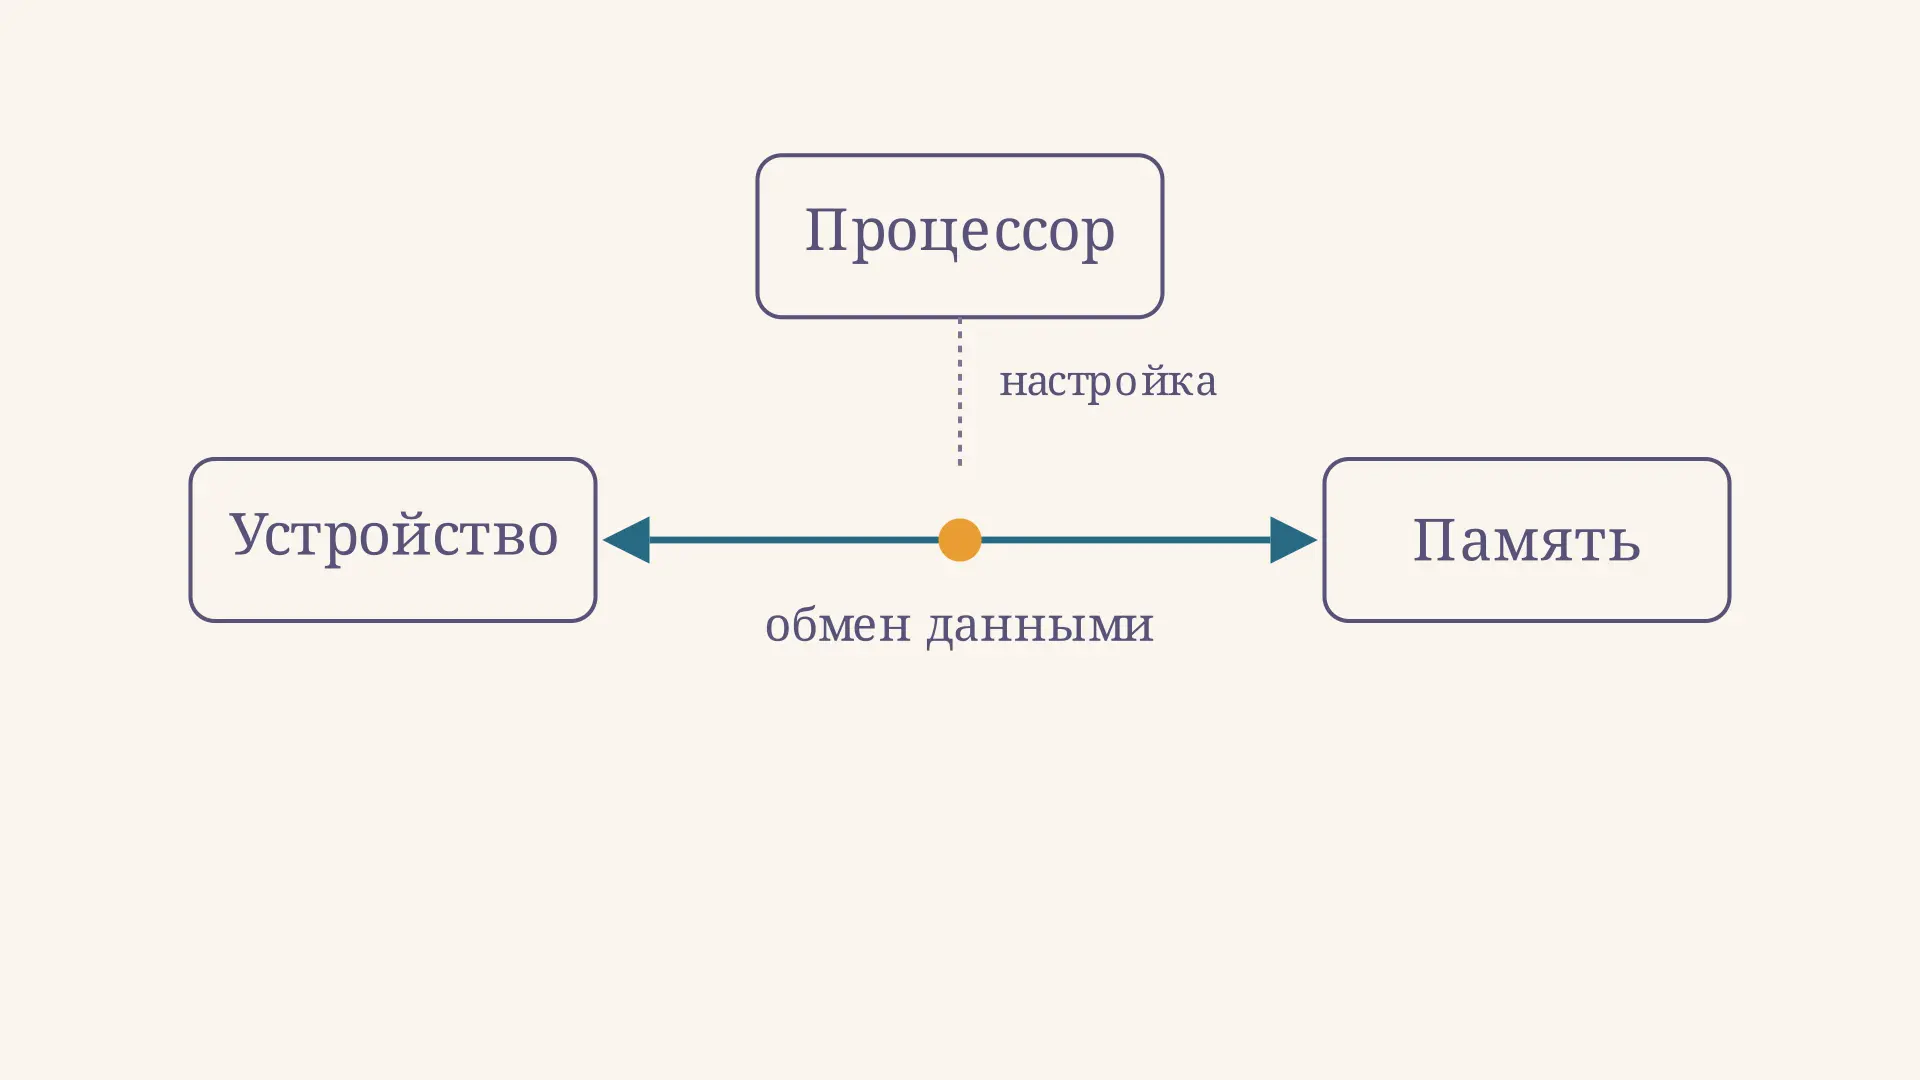
Прямой доступ к памяти, или DMA (Direct Memory Access), позволяет устройству обмениваться данными с оперативной памятью без того, чтобы процессор выполнял отдельную инструкцию копирования для каждого слова. Процессор всё равно подготавливает операцию и обрабатывает её результат. Разница в том, что саму передачу выполняет аппаратный механизм: контроллер DMA или устройство, умеющее инициировать обращения к памяти.
Размер блока помогает понять, почему важна организация обмена. В калькуляторе каждый блок запускается отдельно: измените объём или размер блока и посмотрите, сколько операций понадобится. Это упрощённый учебный счёт, а не замер скорости конкретного устройства.
Как проходит передача DMA
Представим, что сетевая карта получила пакет. Драйвер заранее подготавливает буфер в оперативной памяти, получает пригодный для устройства DMA-адрес и сообщает карте, куда можно положить данные. Карта записывает пакет в этот буфер, а затем сообщает о выполнении согласно своему протоколу. После необходимой синхронизации драйвер передаёт данные дальше сетевому стеку.
Направление обмена зависит от задачи: устройство может записывать данные в память или читать их из неё. Двунаправленное движение на схеме обозначает эти два возможных направления, а не то, что один и тот же пакет обязательно движется туда и обратно. В конкретной операции направление задаётся заранее и важно для правильной работы с кэшем.
Точная последовательность зависит от устройства и операционной системы. Но роли обычно разделены: процессор и драйвер управляют операцией, а механизм DMA выполняет обращения к памяти. После завершения процессор может получить прерывание, проверить статус при опросе или обработать уведомление другим способом. Одно прерывание на каждый блок не гарантировано.
Чем DMA отличается от программного ввода-вывода
При программном вводе-выводе процессор сам исполняет инструкции для обмена данными с регистрами устройства и памятью. При DMA ему не нужно переносить каждую единицу данных собственными инструкциями. Это может освободить процессор для другой работы, особенно когда объём велик.
Освобождение не означает отсутствие затрат. Драйвер выделяет или подготавливает буферы, заполняет дескрипторы, запускает устройство и обрабатывает завершение. Данные по-прежнему занимают ресурсы памяти и межсоединения, которые могут делиться с процессором и другими устройствами. Для очень маленького обмена подготовка DMA может оказаться заметной частью общей работы; какой способ быстрее, зависит от системы и нагрузки.
Вопрос похож на различие между числом операций и временем их выполнения в теме временной и пространственной сложности: один показатель полезен для модели, но не заменяет измерения на реальном оборудовании. DMA сокращает участие процессора в переносе, однако не обещает автоматически минимальную задержку каждой операции.
Кто именно управляет обменом
В учебных схемах часто рисуют отдельный контроллер DMA между устройством и памятью. Такой контроллер действительно может обслуживать периферию и получать от неё запросы. В других системах само устройство обладает логикой DMA и инициирует транзакции на шине. Для понимания важно не место блока на рисунке, а его функция: аппарат получает параметры и выполняет обмен без инструкции процессора на каждое слово.
Дескриптор обычно описывает адрес буфера, длину и управляющие признаки. Драйвер формирует такие записи по правилам конкретного устройства, а устройство читает их и выполняет работу. В кольцевом буфере множество дескрипторов позволяет ставить в очередь несколько операций. Аналогично тому как двоичное дерево поиска организует данные для определённого способа доступа, очередь дескрипторов задаёт структуру работы, но её детали определяются протоколом оборудования.
В некоторых контроллерах есть режим scatter-gather: одна логическая передача описывается списком участков памяти. Это удобно, когда данные расположены не в одном непрерывном физическом диапазоне. Нельзя считать, что любая карта поддерживает произвольный список: существуют пределы числа элементов, длины и выравнивания, которые нужно проверять в документации устройства.
Расчёт числа блоков
Пусть требуется передать КиБ, а один отдельно запускаемый блок содержит не больше КиБ. Тогда число блоков в нашей модели равно
Скобки обозначают округление вверх: неполный последний блок тоже нужно передать. Например, при КиБ и КиБ получаем . Если уменьшить блок до 32 КиБ, понадобится 32 блока. Для 1024 КиБ и блока 96 КиБ результат равен 11: десять полных блоков и последний на 64 КиБ. Здесь КиБ означает 1024 байта.
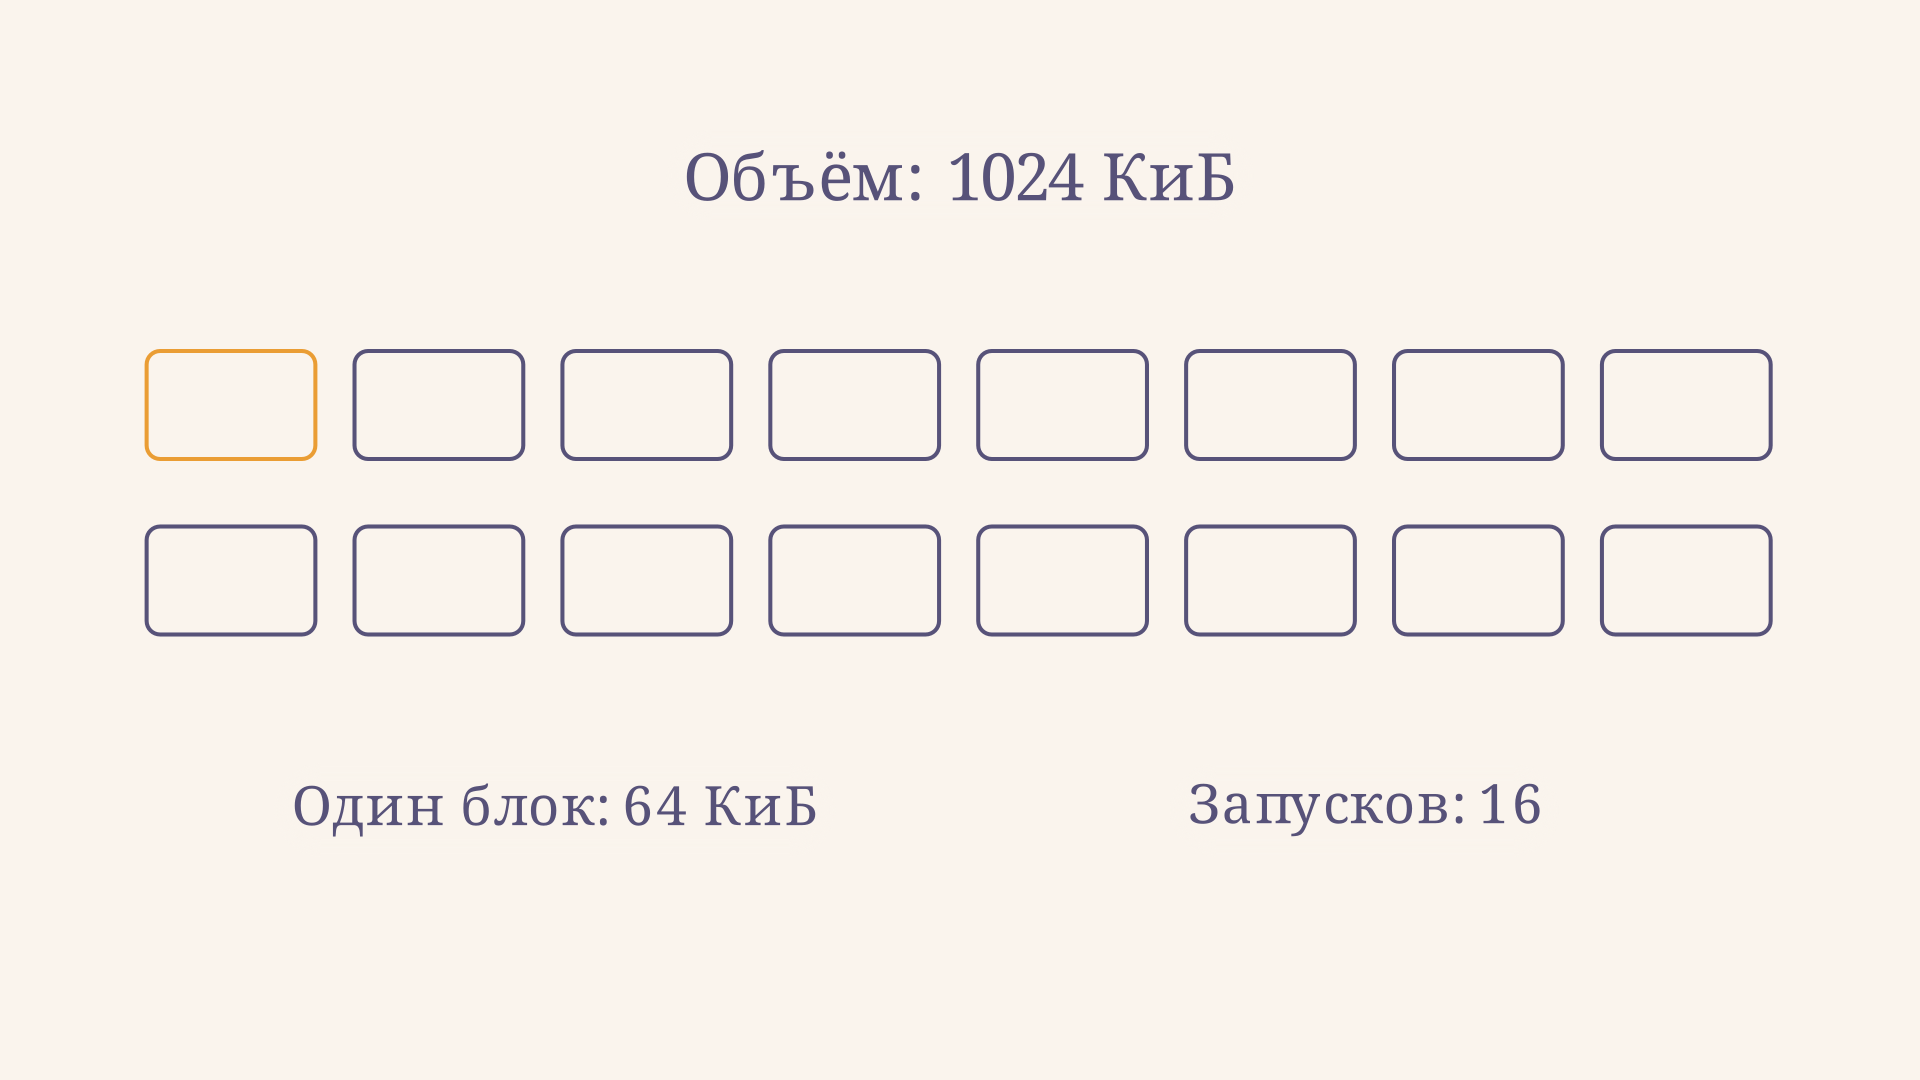
При принятом условии «один блок - один запуск» число запусков равно числу блоков. В реальном драйвере несколько дескрипторов могут обрабатываться после одного запуска очереди, а уведомления могут объединяться. Поэтому формула сама по себе не сообщает ни число прерываний, ни загрузку процессора, ни длительность передачи. Для времени дополнительно нужны скорость тракта, задержки подготовки, конкуренция за память и другие параметры; складывать их без оговорок в универсальную константу нельзя.
Адрес процессора и адрес устройства
Адрес, который видит программа или ядро на процессоре, не обязательно совпадает с адресом, который следует сообщить устройству. В системе могут существовать виртуальные адреса процессора, физические адреса памяти и адреса DMA на стороне устройства. Между ними возможно преобразование, в том числе с помощью IOMMU.
Поэтому драйвер не должен просто взять произвольный указатель и записать его в регистр устройства. В Linux для подготовки отображения предусмотрен DMA API: он возвращает адрес DMA, учитывая ограничения устройства и платформы. Для потоковых отображений также важны направление и своевременное снятие отображения. Это описано в руководстве ядра Linux по DMA.
IOMMU может ограничивать доступ устройства разрешёнными отображениями и преобразовывать адреса, но наличие DMA не означает, что защита автоматически настроена. Какие области доступны, зависит от конфигурации платформы и операционной системы. Иначе говоря, «прямой» относится к пути данных без поэлементного копирования процессором, а не к отсутствию правил доступа.
Кэш и согласованность данных
У процессора может быть кэш, а устройство работает с памятью по собственному пути. На некогерентной платформе новые данные процессора не всегда автоматически видны устройству, и наоборот. Поэтому перед передачей владения буфером и после завершения операции драйвер применяет предусмотренные платформой отображения и синхронизацию. Направление DMA при этом имеет значение.
Когерентная память упрощает видимость обновлений, но сама по себе не отменяет требования к порядку операций и барьерам памяти. Например, нельзя бездумно предполагать, что устройство увидит признак готовности дескриптора после всех его остальных полей только потому, что область когерентна. Детали определяются API, архитектурой и протоколом устройства; документация ядра отдельно подчёркивает необходимость барьеров.
Такие правила полезно воспринимать как протокол владения: пока устройство записывает буфер, процессор не должен считать его готовым; после сигнала завершения нужно выполнить необходимые действия и только затем читать содержимое. Если нарушить порядок, ошибки могут проявляться нерегулярно и зависеть от нагрузки или архитектуры.
Где применяется DMA
Сетевые адаптеры передают пакеты через буферы в памяти, накопители обмениваются блоками данных с системой, а аудиоустройства могут обслуживать повторяющиеся участки буфера. В каждом случае детали отличаются: один механизм использует очередь запросов, другой - циклический буфер. Описание поддерживаемых типов, включая scatter-gather и циклическую передачу, есть в документации Linux DMAengine.
Для звука важны своевременное заполнение и опустошение буфера: если данные не поступают вовремя, воспроизведение может прерваться. Связь размера данных с представлением звука рассматривается в статье о частоте дискретизации. Для сетевого обмена важно также успевать возвращать свободные буферы устройству. DMA помогает перенести данные, но не заменяет обработку протокола и управление очередями.
При изучении двоичных представлений полезно отдельно различать смысл данных и механизм их перемещения. Например, кодирование текстовой информации ASCII объясняет значение байтов, тогда как DMA отвечает на вопрос, как аппарат может доставить эти байты в память.
Частые ошибки
- «Процессор не участвует». Он настраивает обмен и обрабатывает результат, хотя не копирует каждое слово самостоятельно.
- «DMA всегда быстрее». Для оценки нужны размер данных, стоимость подготовки, устройство и нагрузка на память.
- «Число блоков равно числу прерываний». Очереди и объединение уведомлений нарушают это предположение.
- «Адрес указателя можно передать устройству». Адрес DMA получают и используют по правилам платформенного API.
- «Когерентность решает всё». Видимость данных и порядок публикации дескриптора - связанные, но разные требования.
FAQ
DMA копирует данные только из устройства в память?
Нет. Передача может идти и из памяти к устройству; некоторые контроллеры поддерживают также операции между областями памяти. Возможности зависят от конкретного оборудования.
Что происходит после завершения?
Устройство сообщает статус предусмотренным способом, например прерыванием или обновлением записи в очереди. Драйвер проверяет результат, выполняет требуемую синхронизацию и возвращает буфер программе либо готовит его для повторного использования.
Всегда ли большой блок лучше?
Нет. Увеличение блока уменьшает число блоков в нашей модели, но может влиять на задержку, расход памяти и отзывчивость. Кроме того, устройство задаёт собственные ограничения. Оптимальный размер выбирают по задаче и измерениям.
Коротко
DMA передаёт данные между устройством и памятью под управлением аппаратного механизма, пока процессор отвечает за настройку и обработку результата. Число блоков можно оценить округлением объёма вверх по размеру блока, но производительность и число уведомлений зависят от реализации. Для корректной работы драйверу необходимы правильные DMA-адреса, порядок операций и согласование доступа к буферам.
Читайте также
Адресация: прямая, косвенная и непосредственная
Разбираем прямую, косвенную и непосредственную адресацию операндов на одном примере памяти: как найти значение, посчитать чтения и не перепутать адрес с данными.
Архитектура NUMA: узлы и доступ к памяти
Архитектура NUMA простыми словами: как устроены узлы, чем отличается локальный доступ к памяти от удалённого, как оценить задержку и проверить размещение в Linux.
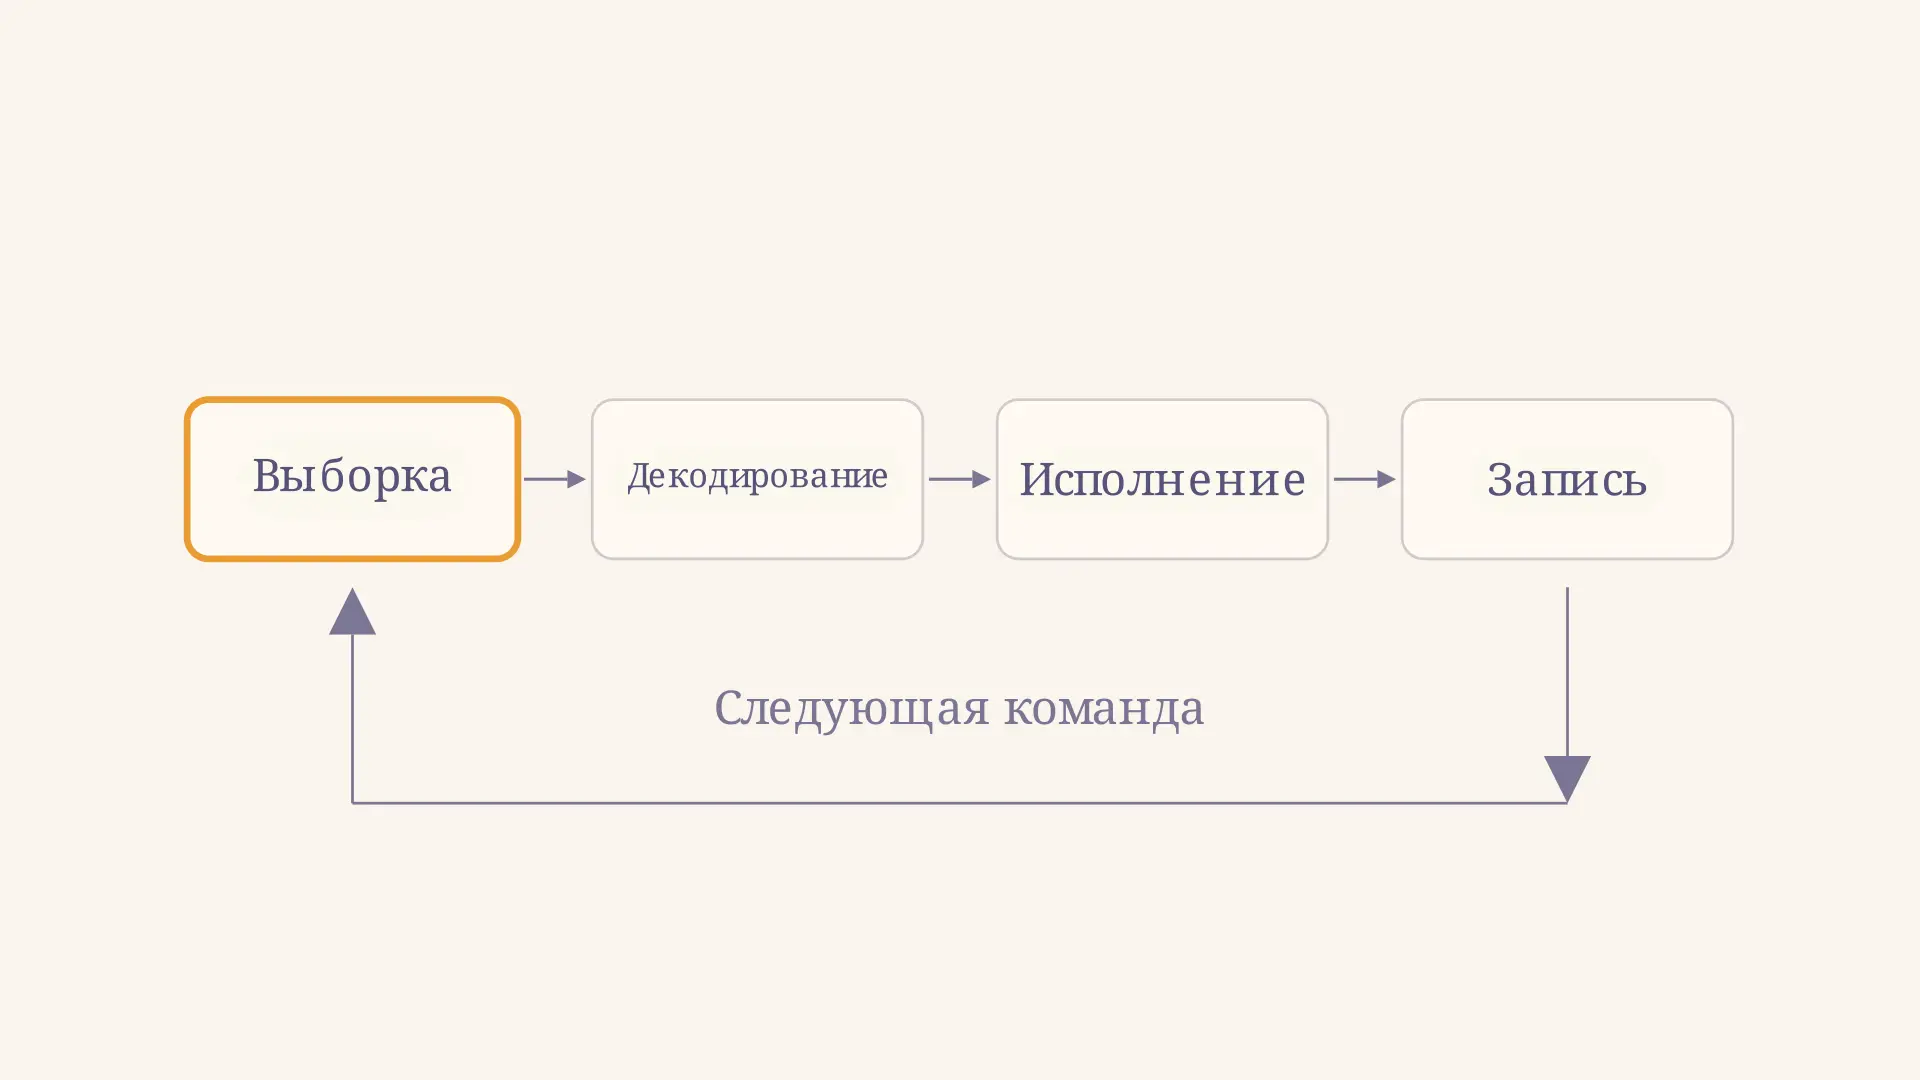
Цикл выполнения команды процессора: этапы и пример
Цикл выполнения команды процессора по шагам: выборка, декодирование, исполнение и запись результата. Разберём регистры, переходы, такты и конвейер на примере.
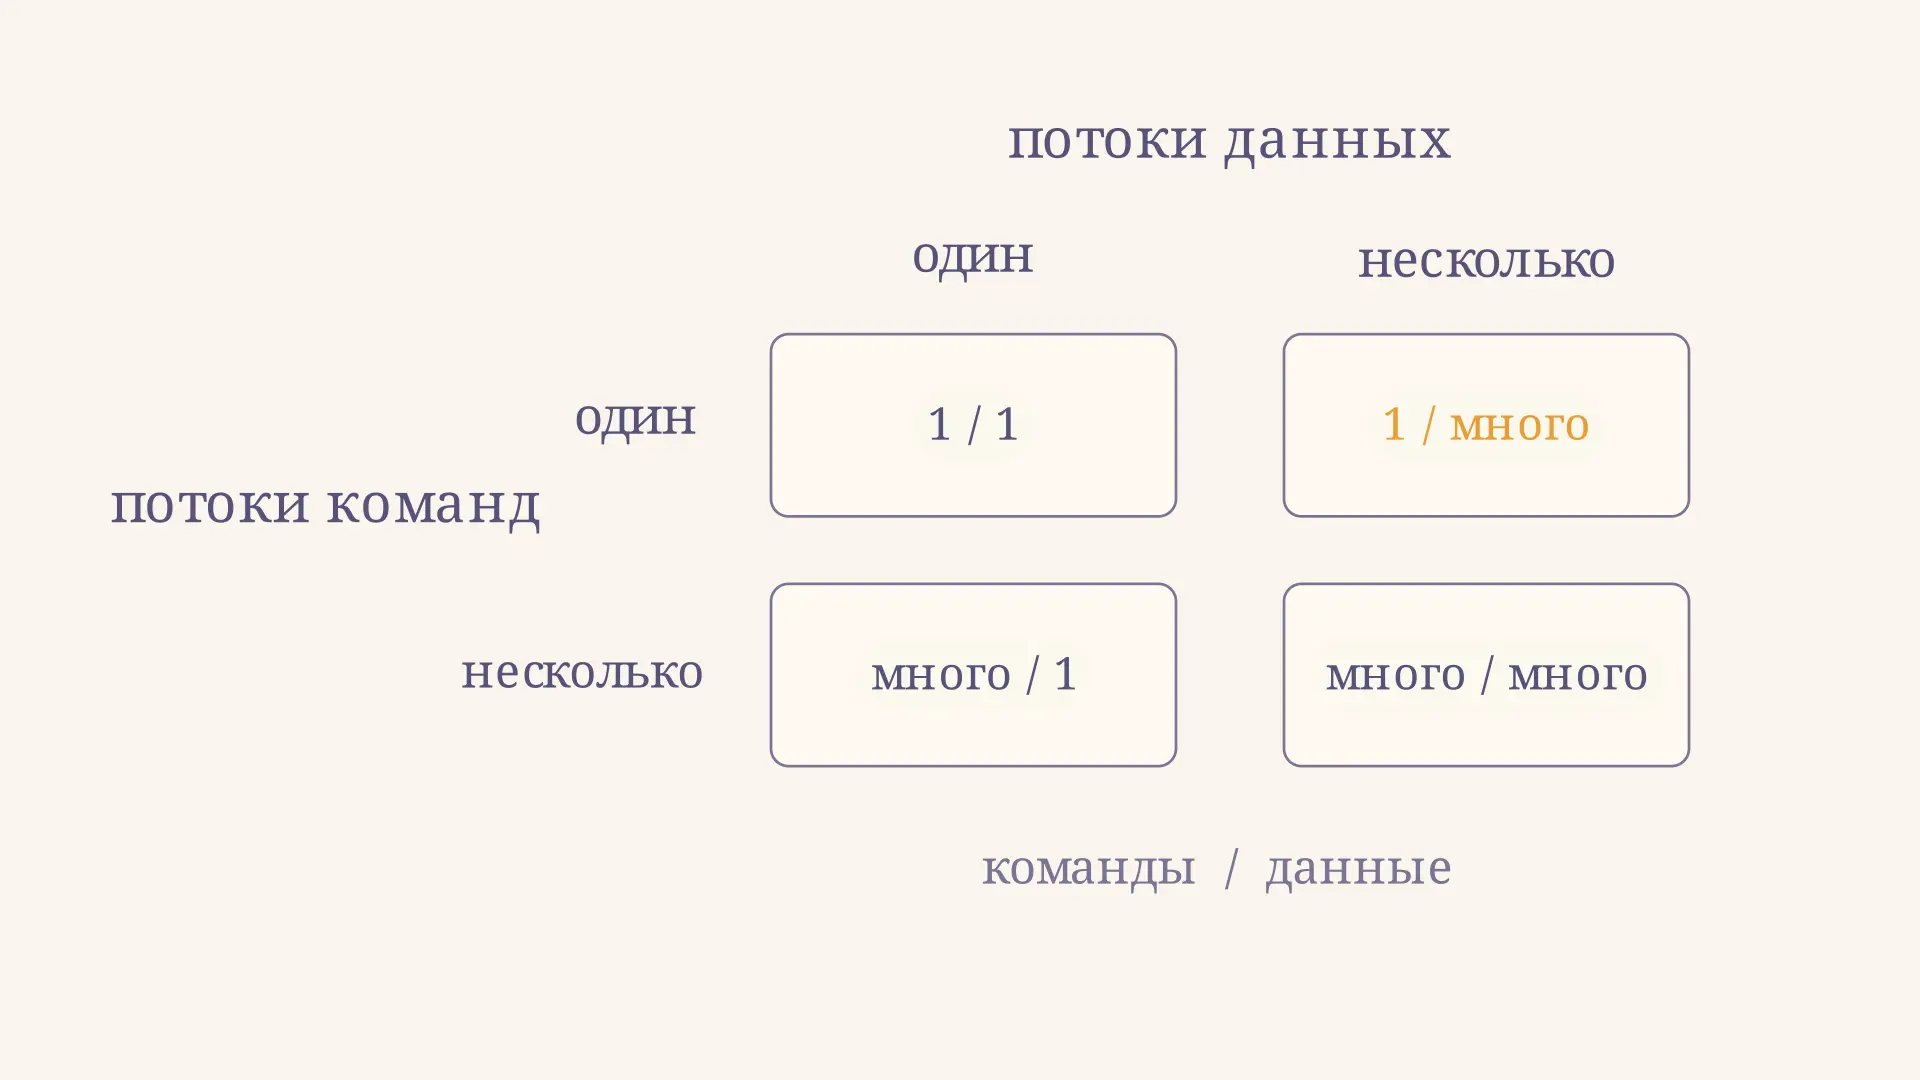
Классификация архитектур Флинна: SISD, SIMD, MISD, MIMD
Классификация архитектур Флинна по потокам команд и данных: чем отличаются SISD, SIMD, MISD и MIMD, как определить класс и почему он не предсказывает скорость.
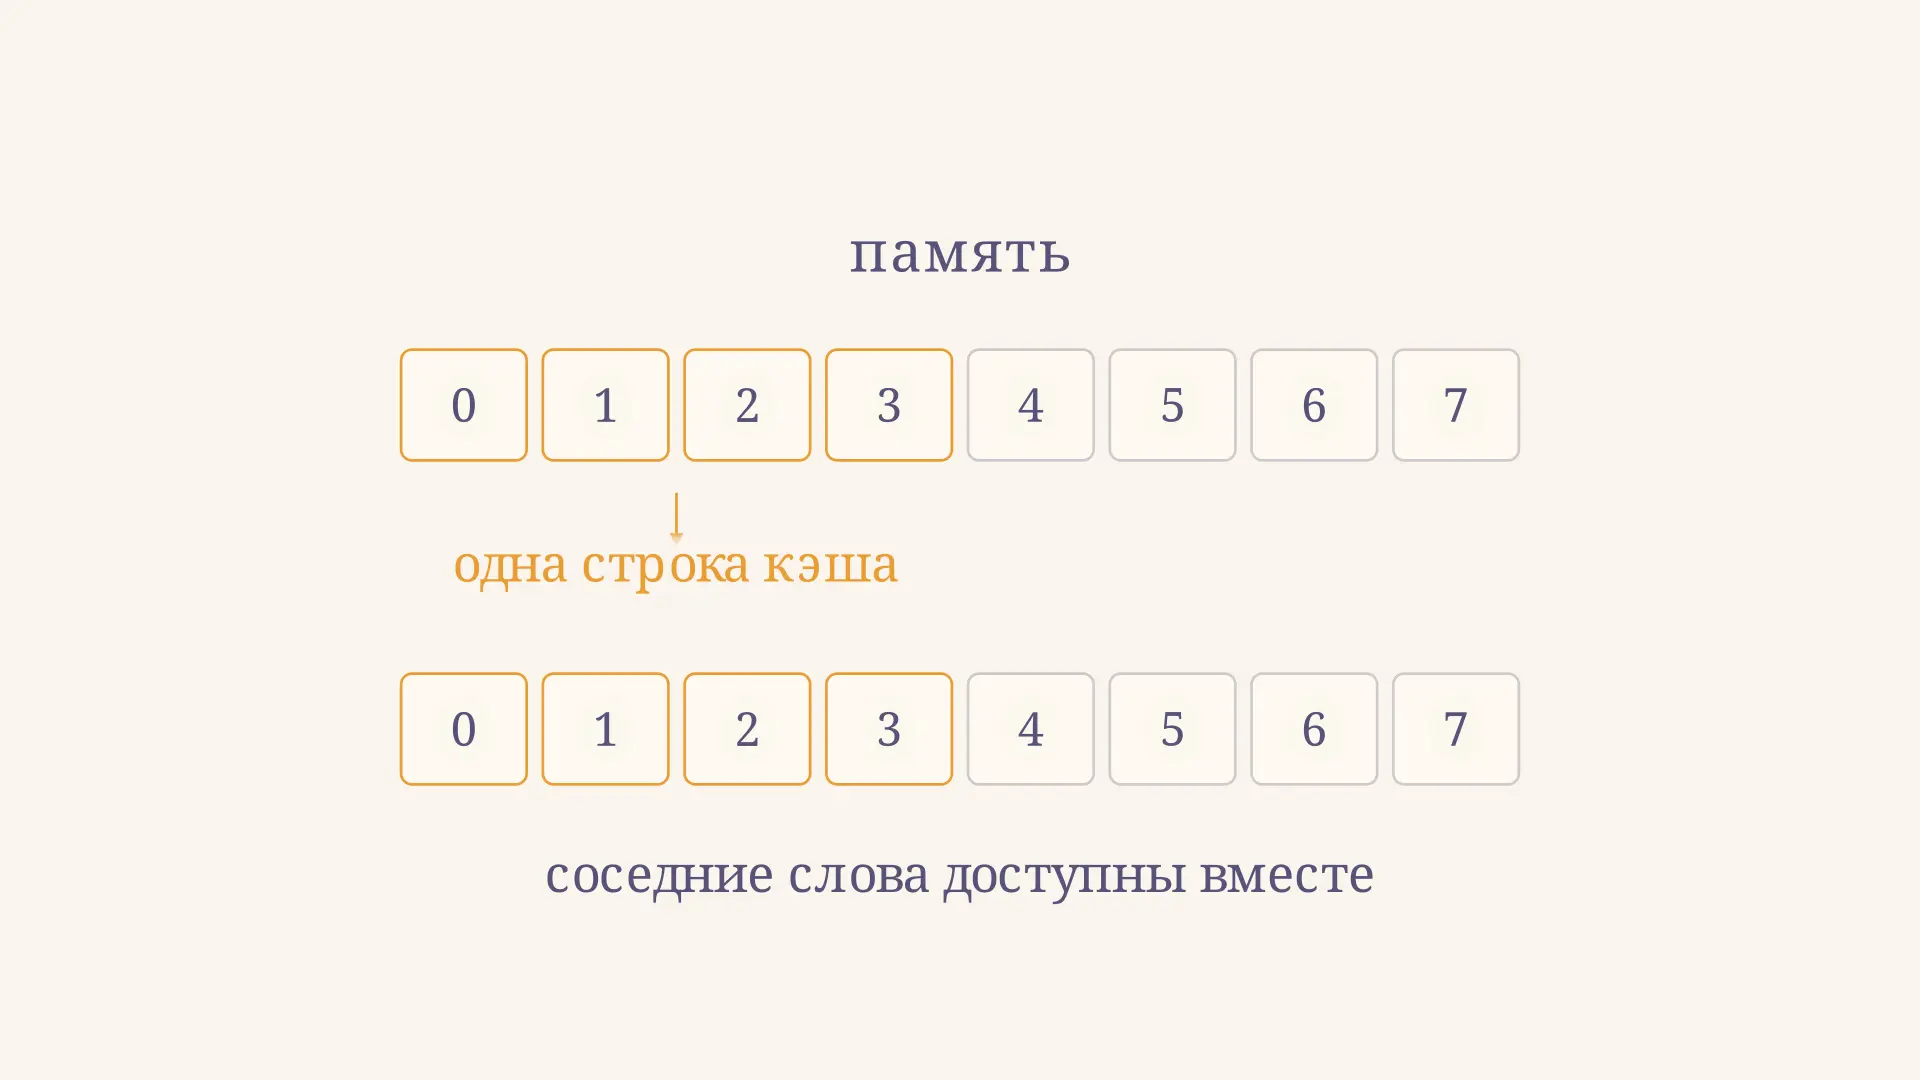
Принцип локальности: как программы используют память
Принцип локальности в информатике: временная и пространственная локальность, работа кэша, разбор попаданий и промахов и способы улучшить обход данных.
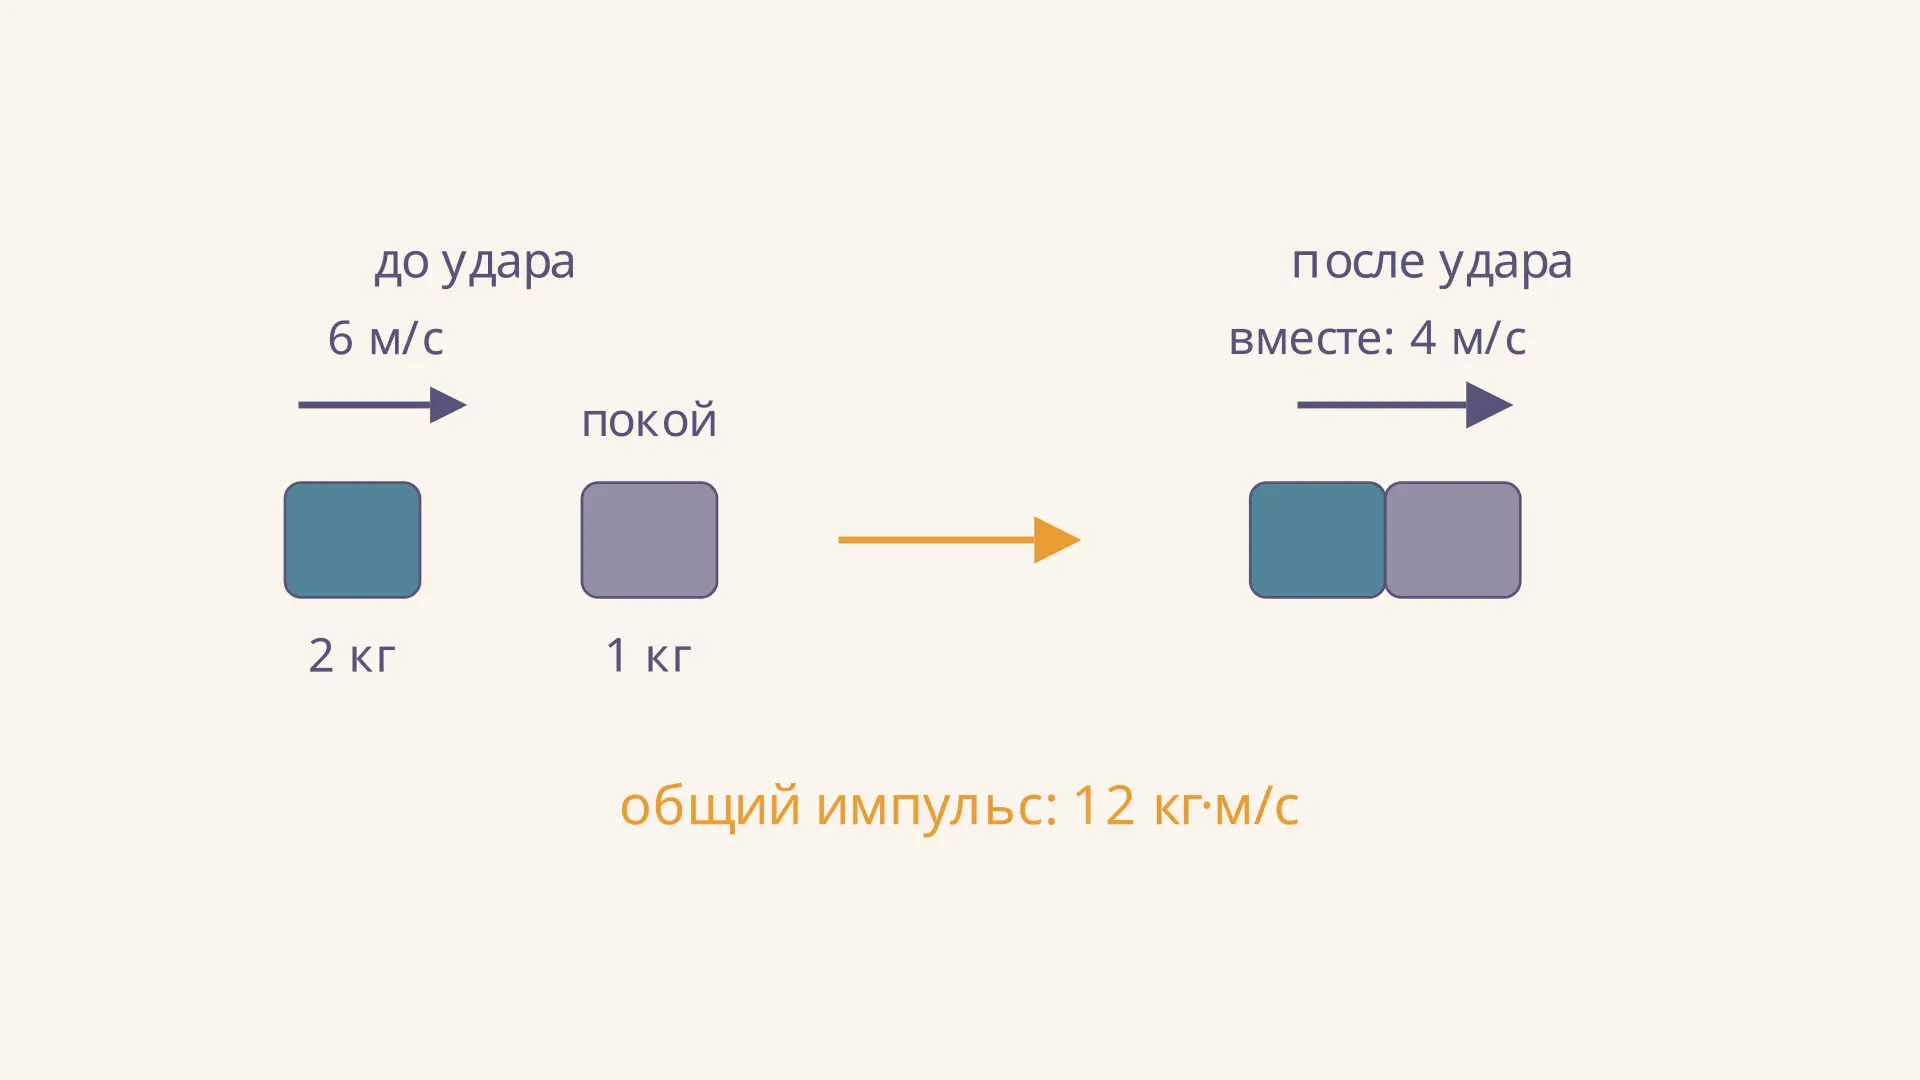
Абсолютно неупругий удар: сохранение импульса
Как найти скорость тел после абсолютно неупругого удара, применить закон сохранения импульса и вычислить потерю кинетической энергии на понятных примерах с формулами.