Классификация архитектур Флинна: SISD, SIMD, MISD, MIMD
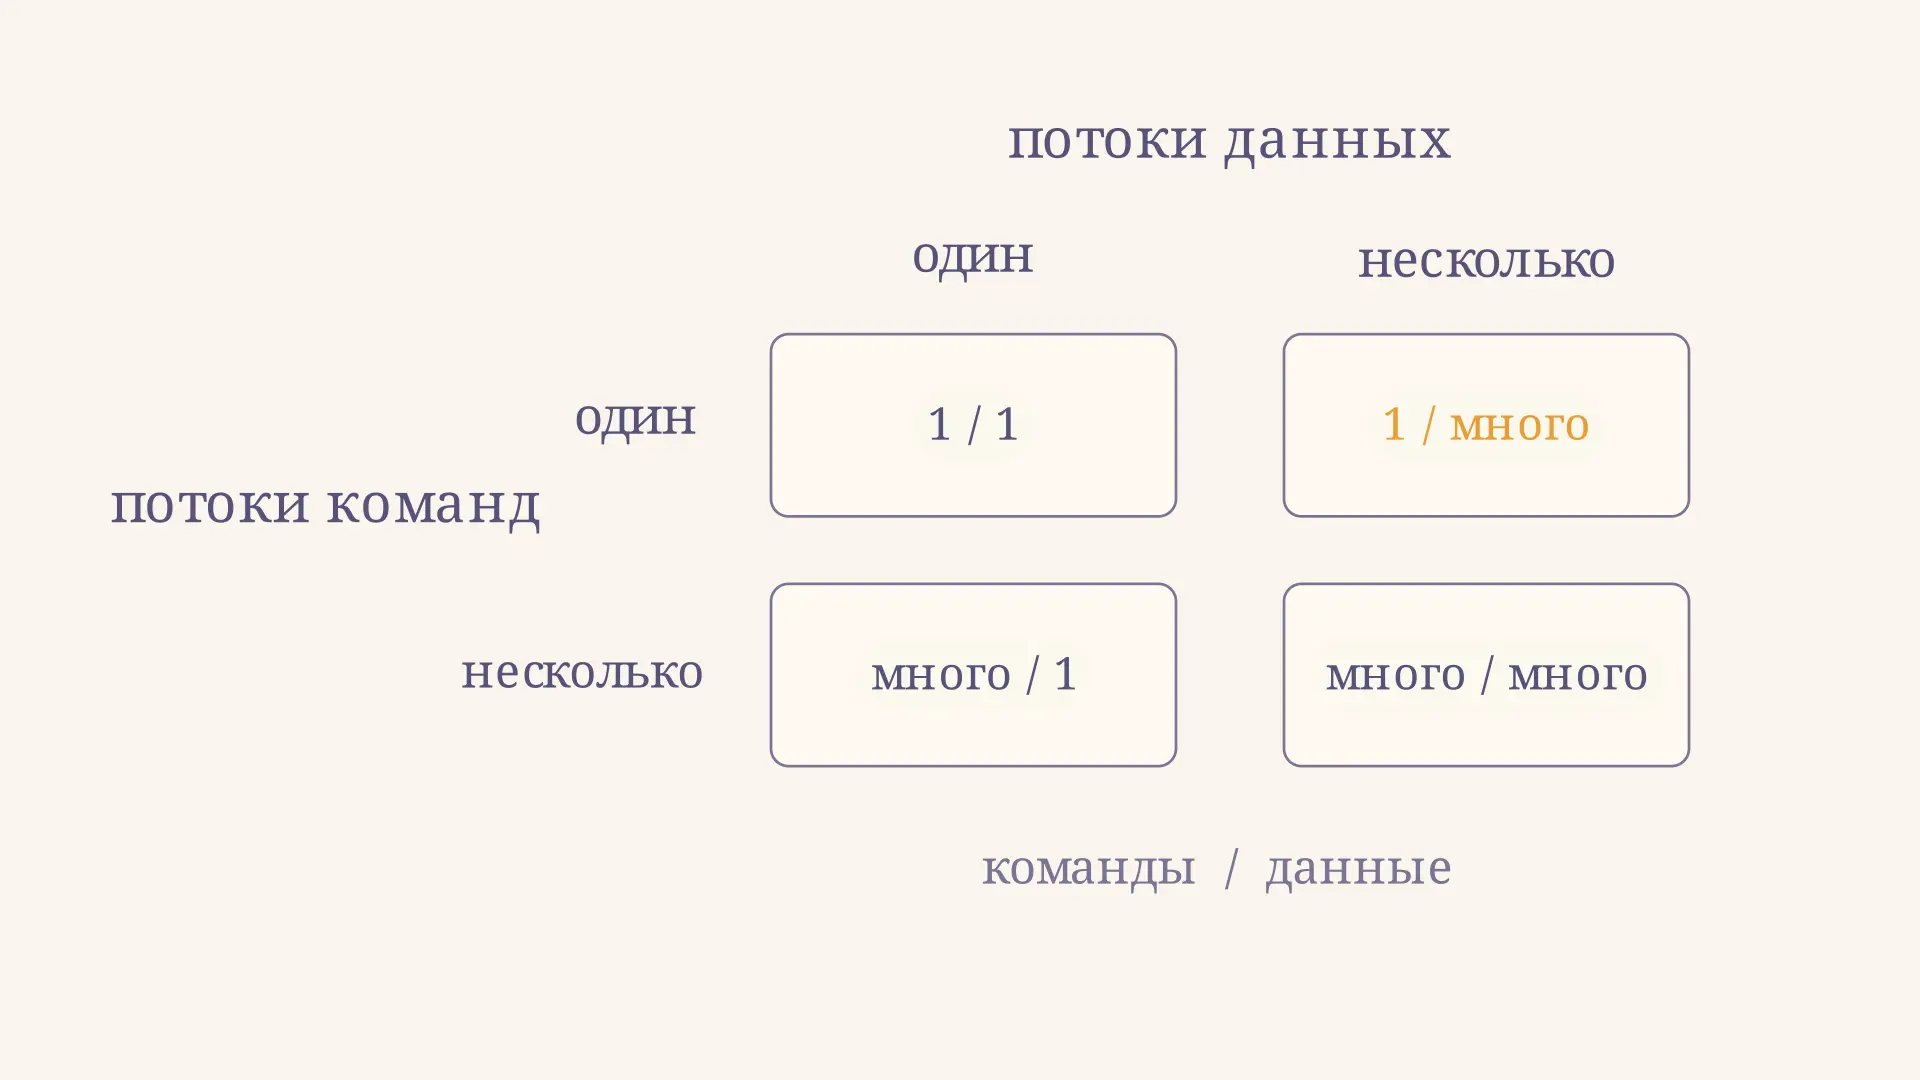
Классификация архитектур Флинна делит вычислительные организации по числу потоков команд и потоков данных: один или несколько каждого вида. Получаются четыре класса: SISD, SIMD, MISD и MIMD. Эта сетка помогает понять, где возникает параллелизм, но не сообщает, какой компьютер быстрее. Выберите два признака в интерактивном блоке, а затем проверьте вывод на примерах ниже.
Две оси классификации
Поток команд - последовательность инструкций, которыми управляется вычисление. Поток данных - последовательность значений, над которыми выполняются операции. В статье Майкла Флинна 1972 года эти понятия используются для описания организации на достаточно крупном уровне: важно взаимодействие потоков, а не подробная схема каждого транзистора.
Буква S означает single, один поток, M - multiple, несколько; I обозначает инструкции, D - данные. Первые две буквы относятся к командам, последние две - к данным. Поэтому SIMD читается как «один поток команд, несколько потоков данных». На схеме ниже одна и та же команда доходит до четырёх элементов, но обрабатываемые значения различаются.
Речь идёт о потоках в рассматриваемой организации, а не просто о количестве сохранённых программ или чисел в памяти. Даже обычная последовательная программа обрабатывает множество чисел по очереди; это само по себе не делает её SIMD. При разборе сначала определяют границу системы и то, какие действия происходят независимо или одновременно, а потом выбирают клетку таблицы.
| Класс | Потоки команд | Потоки данных | Учебный образ |
|---|---|---|---|
| SISD | один | один | последовательное выполнение |
| SIMD | один | несколько | одна операция над элементами вектора |
| MISD | несколько | один | разные обработки общего потока |
| MIMD | несколько | несколько | независимые вычислители с разными задачами |
SISD: последовательность команд и данных
В модели SISD одна последовательность инструкций работает с одним потоком данных. Например, программа берёт очередное число, увеличивает его и сохраняет результат, прежде чем перейти к следующему числу. Один поток данных не означает, что программа за всё время видит только один операнд: он означает последовательность значений, поступающих в вычисление.
Условный простой скалярный процессор удобен как пример SISD. При этом из названия нельзя заключить, что внутри физически ничего не перекрывается по времени: конвейер может одновременно заниматься разными стадиями нескольких инструкций. Классификация зависит от выбранного уровня описания и не раскрывает внутреннее устройство конвейера. Как команды и данные вообще передаются между узлами, отдельно объясняет статья о шине адреса, данных и управления.
SIMD: одна команда, много элементов
SIMD подходит для однотипной работы над множеством значений. Пусть команда «прибавить 1» применяется к четырём элементам: . Результат будет . На рисунке четыре дорожки представляют четыре элемента данных; операция у них общая. Это иллюстрация логической организации, а не обещание, что любая конкретная машина завершит операцию за один такт.
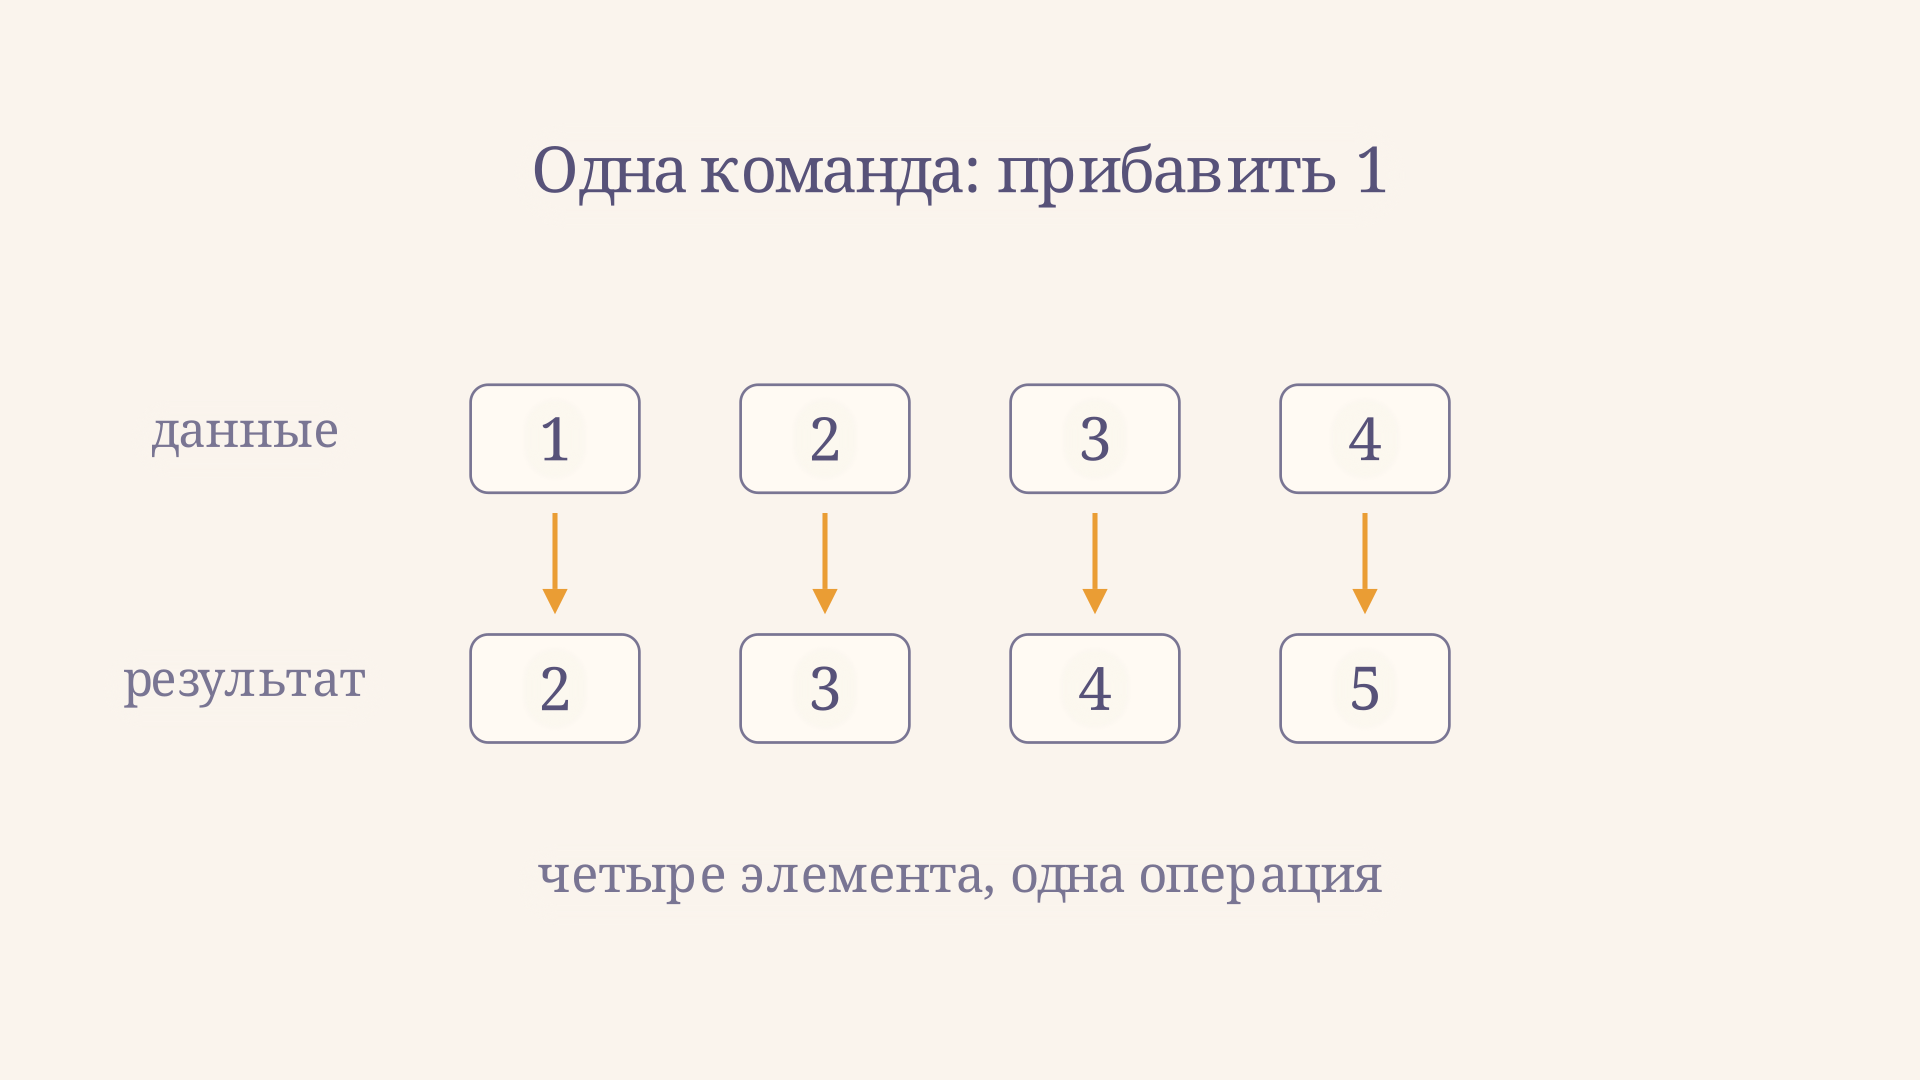
Подобный приём полезен, например, при изменении яркости пикселей или поэлементном сложении массивов. Процессору нужны подходящие векторные инструкции, а программе - данные, которые можно обрабатывать одинаково. Если для разных элементов нужны разные ветви условия, часть вычислительных дорожек может простаивать. Доступ к данным тоже имеет значение: даже широкая операция не устранит задержки памяти. О том, почему близость обращений к памяти влияет на работу программы, рассказывает принцип локальности.
Графические процессоры часто обсуждают рядом с SIMD, но точнее говорить о конкретном уровне организации. Например, NVIDIA описывает выполнение потоков в модели SIMT: потоки группы следуют общей инструкции, сохраняя собственное состояние. При расхождении ветвей выполнение усложняется; это родственная SIMD идея, а не полное тождество всей видеокарты одному блоку SIMD. Подробнее см. руководство NVIDIA по CUDA.
MISD: несколько команд и один поток данных
MISD описывает несколько потоков команд, работающих с одним потоком данных. Мысленный пример - последовательность показаний датчика, которую одновременно анализируют разные алгоритмы: один ищет среднее, другой проверяет превышение порога. Их инструкции различны, а входной поток общий.
Это редкий и неоднозначный для реальных машин класс. При копировании входа по разным обработчикам можно спорить о том, считать ли копии одним логическим потоком или несколькими физическими. Поэтому полезнее явно назвать выбранную модель, чем без оговорок приписывать MISD каждому конвейеру или отказоустойчивой системе. Сам Флинн обсуждал и вариант передачи производного значения между ступенями; не всякий современный процессорный конвейер автоматически относят к MISD.
MIMD: независимые команды и данные
В MIMD несколько потоков команд работают с несколькими потоками данных. Например, один вычислитель сортирует свой массив, а другой одновременно обрабатывает изображение. Потоки команд могут идти по разным ветвям и выполнять разные операции. Общая память возможна, но общая память не делает их потоком данных в единственном числе: решает организация обработки, а не просто число банков памяти.
Многоядерный компьютер и кластер удобно рассматривать как примеры MIMD на уровне независимых вычислительных узлов. Внутри отдельных ядер при этом могут присутствовать SIMD-инструкции: классы применяются к выбранному уровню, а современная система сочетает несколько механизмов. Независимость команд также не означает полного отсутствия взаимодействия: при совместной задаче нужны обмен, синхронизация и согласование результатов.
Как определить класс в задаче
Возьмём четыре независимых участка изображения. Если все они обрабатываются одной общей инструкцией в нескольких дорожках, на этом уровне подходит SIMD. Если четыре ядра независимо выполняют собственные последовательности инструкций над своими участками, на уровне ядер это MIMD, даже когда программы написаны одинаково: их выполнение и переходы могут различаться.
Порядок рассуждения таков: определите границу системы; выясните, сколько независимых последовательностей команд управляет работой; затем установите, один или несколько потоков данных обрабатываются в этой организации. Только после этого сопоставьте пару признаков с таблицей. Одинаковый исходный код ещё не доказывает наличие одного потока команд: независимые экземпляры программы могут продвигаться по нему по-разному.
Например, при обработке массива отдельные фрагменты можно распределить между ядрами MIMD, а внутри каждого фрагмента применить SIMD к нескольким числам. Аналогично при анализе алгоритма полезно отделять сам способ решения задачи от организации машины, на которой он выполняется; это различие помогает и при изучении алгоритма Карацубы или алгоритма Кадане.
Различайте также организацию машины и способ записи программы. В модели SPMD участники получают одну программу, но каждый работает со своими данными и может выполнять собственную ветвь. На независимых ядрах такую программу нередко исполняет MIMD-система. Название модели программирования само по себе не определяет аппаратный класс: нужно посмотреть, как управляются конкретные исполнители.
Для SIMD важна и зависимость между элементами. Если новый элемент зависит от результата предыдущего, простое одновременное применение операции уже не воспроизводит последовательное вычисление. Иногда алгоритм можно перестроить, но это отдельная задача, которую таблица Флинна за программиста не решает. Сначала проверяют корректность разбиения, затем измеряют эффект на выбранном оборудовании.
Что классификация не измеряет
Класс Флинна не задаёт тактовую частоту, ширину вектора, объём памяти, число ядер или цену обмена. Поэтому из одного обозначения нельзя вывести ускорение. Даже при большом числе вычислителей выполнение может упираться в последовательную часть программы, передачу данных или ожидание общего ресурса. В исходной работе Флинн отдельно рассматривает ограничения эффективности, связанные с зависимостями и взаимодействием ресурсов.
И наоборот, один класс может охватывать разные реализации. Для сравнения систем нужны ещё описание задачи, конкретной архитектуры и измерения при одинаковых условиях. Таблица Флинна отвечает на предварительный вопрос «как организованы потоки?», создавая язык для дальнейшего анализа.
Частые ошибки
- Считать данные в файле потоками. Тысяча чисел в массиве может последовательно обрабатываться одним потоком данных.
- Приравнивать одну программу к одному потоку команд. Несколько независимых исполнителей одной программы могут находиться на разных инструкциях.
- Называть любой конвейер MISD. Для такого вывода нужно обосновать, что именно считается общим потоком данных и независимыми потоками команд.
- Выбирать класс по скорости. SIMD и MIMD описывают организацию; реальная производительность зависит также от задачи и ресурсов.
FAQ
Чем SIMD отличается от MIMD?
В SIMD одна последовательность команд управляет обработкой нескольких потоков данных. В MIMD несколько последовательностей команд независимо работают с несколькими потоками данных.
Могут ли классы сочетаться в одном компьютере?
Да. Многоядерная система может быть MIMD на уровне ядер, а каждое ядро - применять SIMD-инструкции к элементам вектора. Нужно указать уровень рассмотрения.
Почему MISD встречается редко?
Немного типичных задач естественно укладываются в модель нескольких разных потоков команд над одним потоком данных. Кроме того, определение границ потока в конкретной реализации может быть спорным.
Коротко
Классификация Флинна строится на двух вопросах: один или несколько потоков команд и один или несколько потоков данных. Ответы дают SISD, SIMD, MISD и MIMD. Она помогает описать параллелизм на выбранном уровне, но для оценки скорости нужны сведения о задаче и реализации.
Читайте также
Адресация: прямая, косвенная и непосредственная
Разбираем прямую, косвенную и непосредственную адресацию операндов на одном примере памяти: как найти значение, посчитать чтения и не перепутать адрес с данными.
Цикл выполнения команды процессора: этапы и пример
Цикл выполнения команды процессора по шагам: выборка, декодирование, исполнение и запись результата. Разберём регистры, переходы, такты и конвейер на примере.
Принцип локальности: как программы используют память
Принцип локальности в информатике: временная и пространственная локальность, работа кэша, разбор попаданий и промахов и способы улучшить обход данных.
Прямой доступ к памяти DMA: как работает передача
Прямой доступ к памяти DMA: как устройство обменивается данными с оперативной памятью, какую роль играет процессор, как считать блоки и зачем нужны IOMMU и синхронизация кэша.
Закон Амдала: формула и предел ускорения программы
Закон Амдала показывает предел ускорения программы при распараллеливании. Разбираем формулу, расчёт времени на нескольких процессорах и ограничения модели.
Абсолютно неупругий удар: сохранение импульса
Как найти скорость тел после абсолютно неупругого удара, применить закон сохранения импульса и вычислить потерю кинетической энергии на понятных примерах с формулами.