Принцип локальности: как программы используют память
Принцип локальности в информатике описывает типичное поведение программ: в течение короткого времени они часто повторно обращаются к одним и тем же данным или к данным с близкими адресами. Компьютер использует эту закономерность, сохраняя недавно полученные блоки памяти в быстром кэше. Поэтому важен не только объём вычислений, но и порядок, в котором программа читает данные.
Попробуйте изменить вместимость кэша и порядок обращений в модели ниже. Она считает попадания и промахи по заданным правилам, а затем мы разберём, почему результаты различаются и когда локальность может не помочь.
Два вида локальности
Временная локальность означает склонность скоро снова использовать тот же адрес. Например, счётчик цикла и переменная суммы участвуют в каждой итерации. Если их значения хранятся в кэше или регистрах, повторное обращение может быть быстрым. Повторяются и инструкции самого цикла: локальность относится не только к данным.
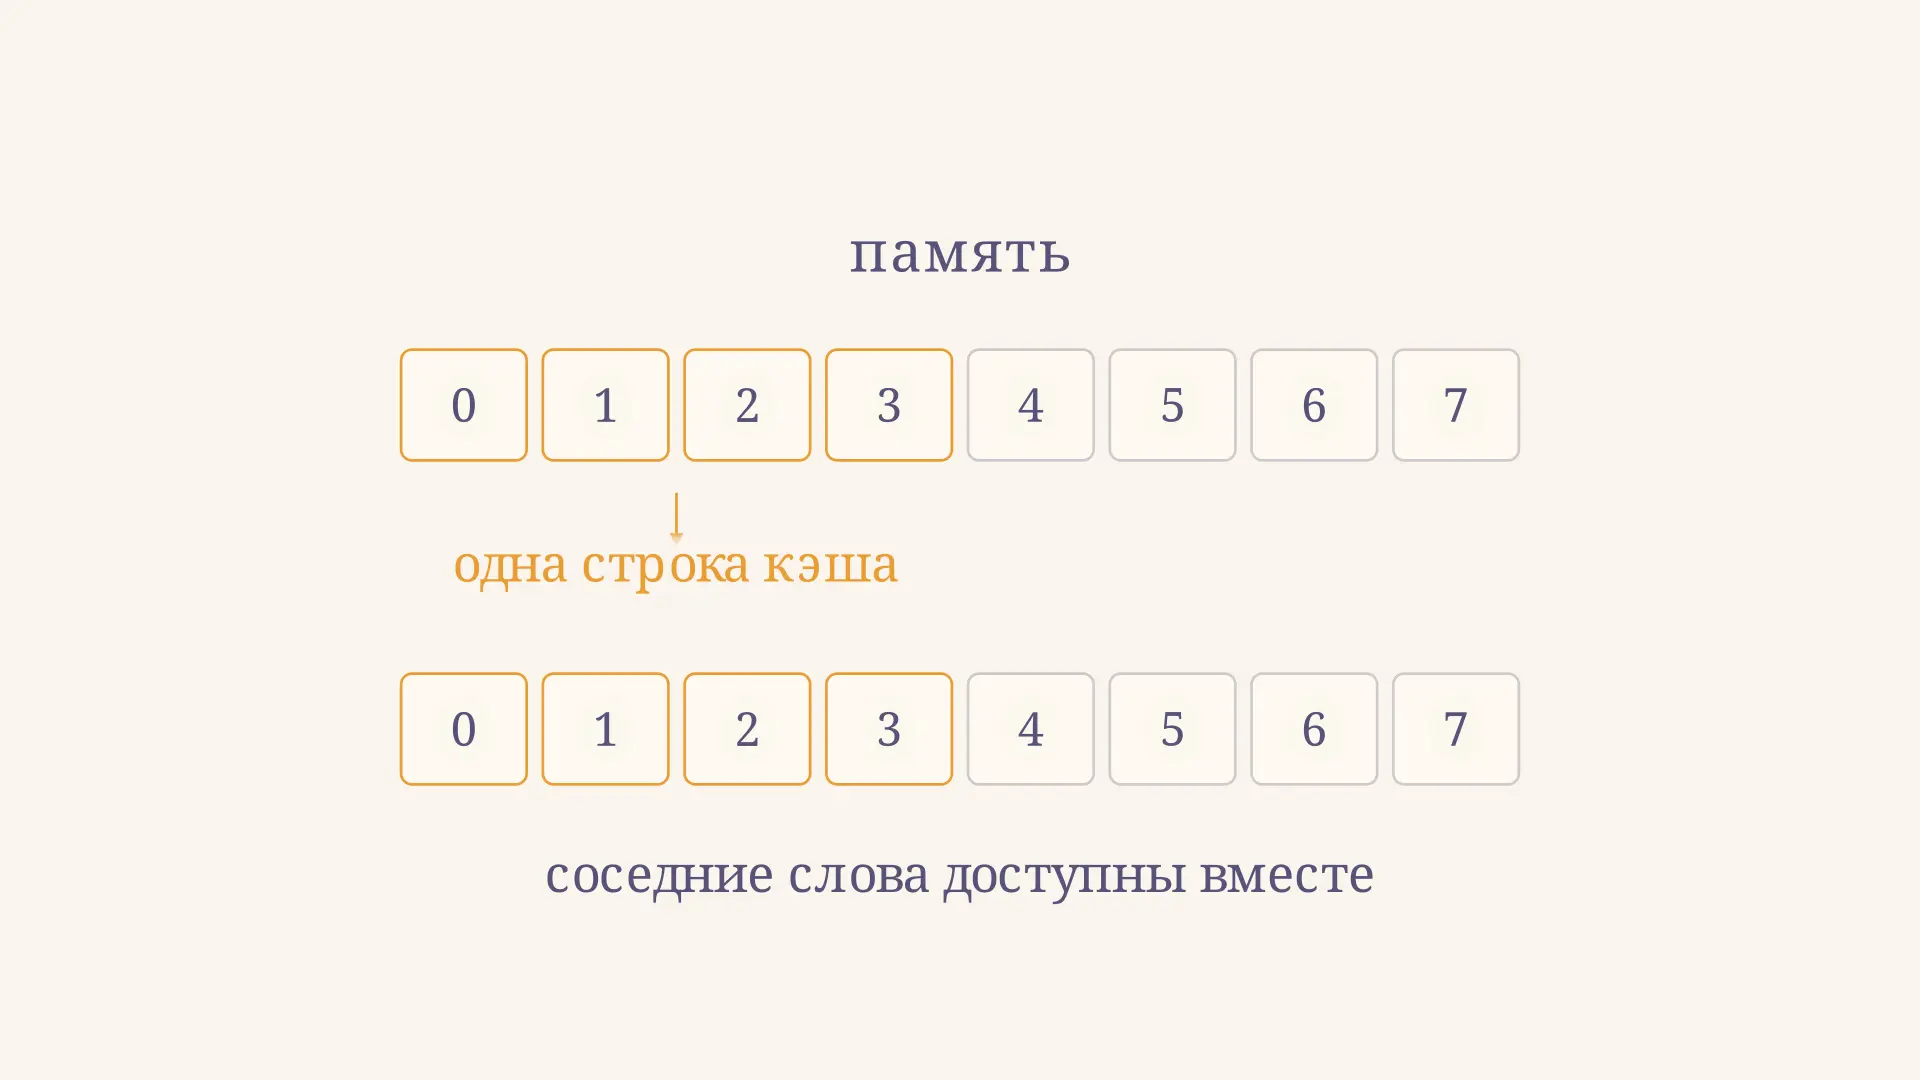
Пространственная локальность означает склонность обращаться вскоре к адресам рядом с уже использованным. При последовательном чтении элементов непрерывного массива соседние элементы располагаются рядом в памяти. Когда процессор получает один элемент, вместе с ним обычно загружается целая строка кэша, и следующие элементы этой строки могут уже оказаться рядом с процессором.
Эти свойства могут сочетаться: проход по массиву использует пространственную локальность, а повторный проход вскоре после первого добавляет временную. Но близкие по смыслу объекты необязательно лежат рядом в памяти, а повторное обращение не гарантирует, что данные ещё сохранились в кэше. В лекции Carnegie Mellon о кэш-памяти оба вида определяются именно через последовательность адресов и время обращений.
Как кэш использует локальность
Между процессором и основной памятью располагается иерархия памяти: небольшие быстрые уровни дополняются более вместительными. При чтении процессор ищет данные в доступном уровне кэша. Если нужная строка там есть, возникает попадание; если нет, возникает промах и строку приходится искать на следующем уровне. Промах одного уровня не обязательно означает обращение непосредственно к оперативной памяти.
Строка кэша - единица передачи, обычно содержащая несколько соседних байтов. Её загрузка использует предположение, что соседние адреса могут понадобиться. Хранение строки после доступа использует предположение о повторном обращении. Адреса и передача данных связаны с устройством шины адреса, данных и управления, хотя кэш и шина выполняют разные функции.
Если свободного места нет, кэш вытесняет одну из строк. Конкретный результат зависит от размера строки, вместимости, отображения адресов в наборы и политики замещения. В реальных системах также работают предвыборка, несколько уровней кэша и другие механизмы. Поэтому подсчёт по простой модели показывает логику, но не является замером скорости конкретного устройства.
Разбор: два прохода по массиву
Пусть память содержит слова с номерами от 0 до 7, строка включает четыре соседних слова, а изначально пустой кэш вмещает две строки. Для определённости он полностью ассоциативный: любую строку можно поместить в любое место. При нехватке места вытесняется наименее недавно использованная строка, то есть применяется правило LRU.
Читаем адреса и повторяем их в том же порядке. Адрес 0 вызывает промах и загрузку строки 0–3; обращения к 1, 2 и 3 попадают в неё. Адрес 4 вызывает второй промах и загрузку строки 4–7; обращения к 5, 6 и 7 попадают. Теперь обе строки помещаются в кэше, поэтому все восемь обращений второго прохода дают попадания.
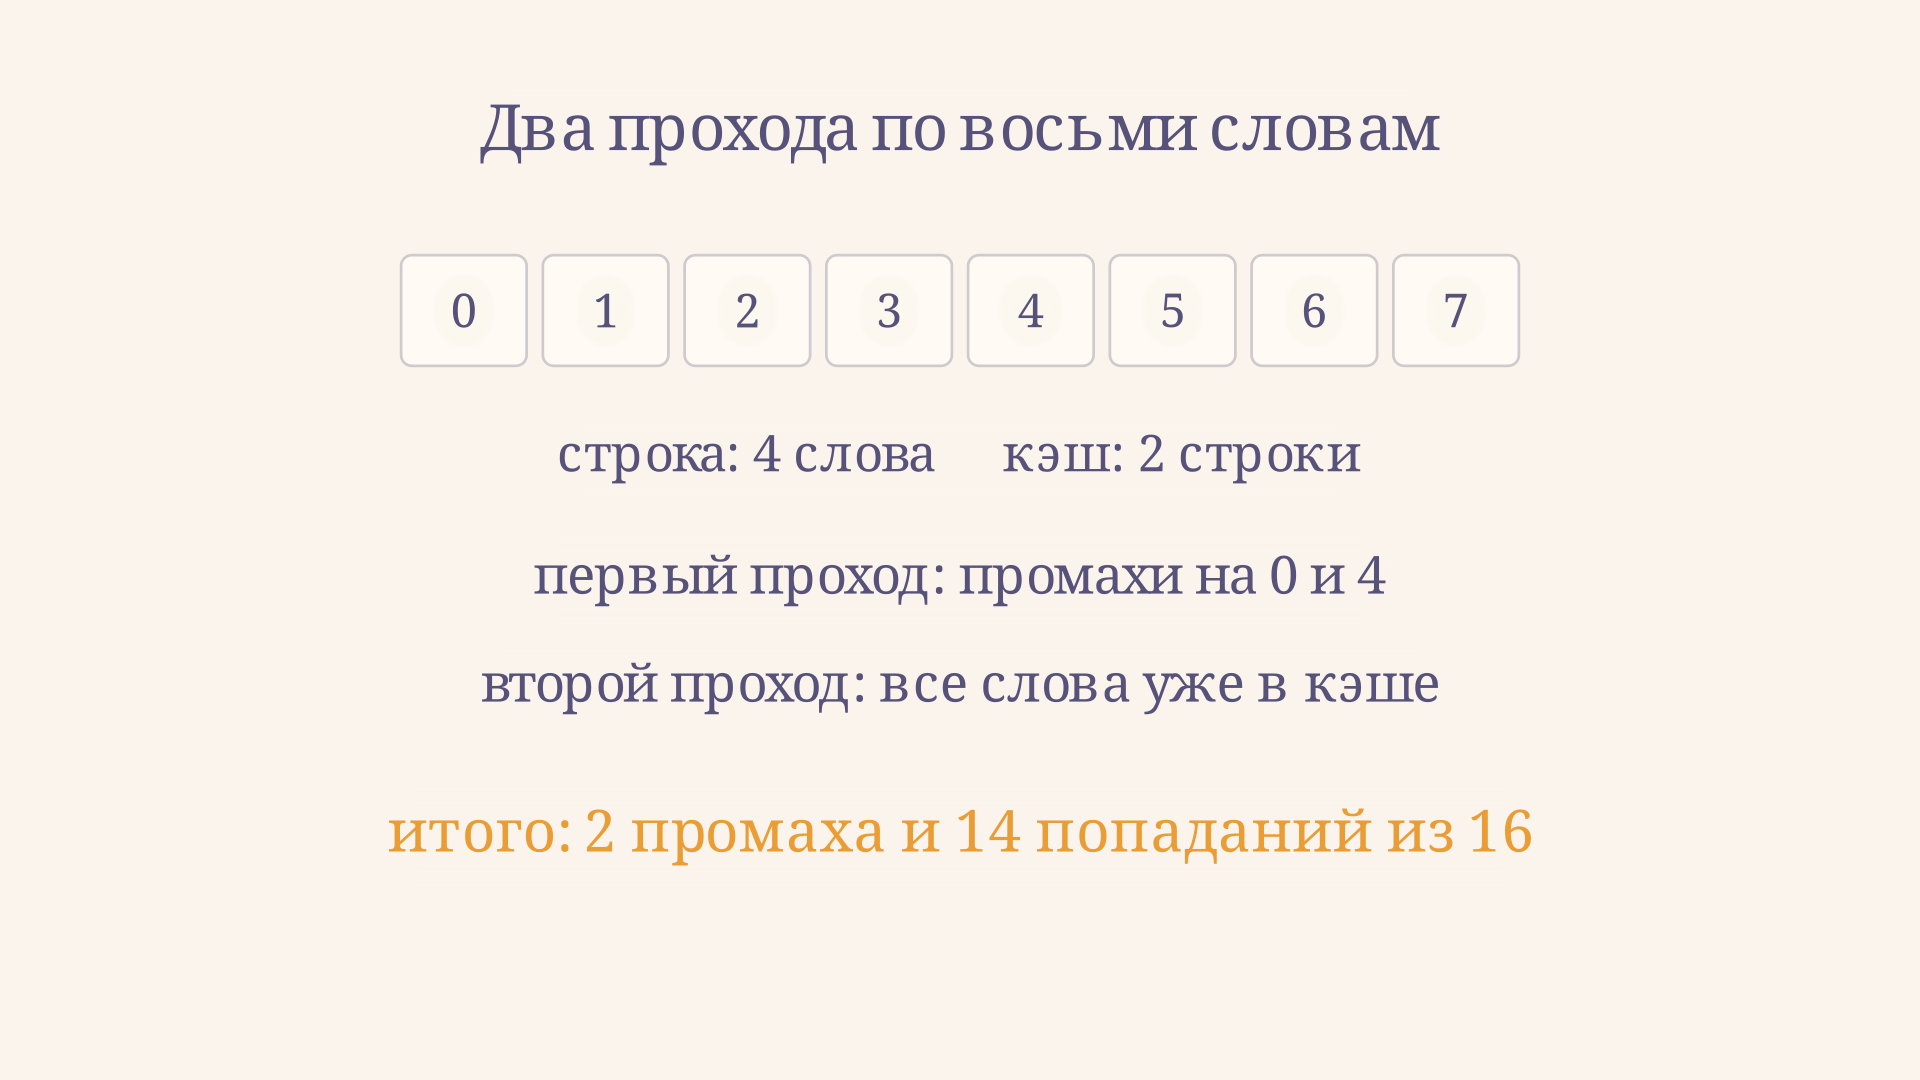
Всего получается 2 промаха и 14 попаданий из 16 обращений, то есть доля попаданий равна . Это доля именно в данной короткой трассе, включая холодные промахи пустого кэша. При вместимости в одну строку начало каждого следующего блока вытесняет предыдущий: оба прохода дадут вместе четыре промаха и 12 попаданий. Проверьте это ползунком.
При анализе полезно выделять рабочий набор: данные, к которым данный участок программы обращается в рассматриваемый промежуток времени. В нашем примере второй проход успешен, потому что две нужные строки одновременно помещаются в кэше. Если между проходами прочитать достаточно других строк, они могут вытеснить исходные, и повторный проход снова получит промахи. Поэтому один только факт повторения адреса не позволяет определить результат без истории предыдущих обращений.
Для LRU в полностью ассоциативной модели можно рассуждать так: если после последнего обращения к строке использовали как минимум столько разных других строк, сколько помещается в кэше, исходная строка уже вытеснена. В настоящем кэше с наборами конкуренция зависит ещё и от того, в какой набор отображаются адреса. Условия учебного примера специально проще, чтобы каждый шаг можно было проверить вручную.
Что меняет шаг обращения
Теперь рассмотрим адреса , повторённые четыре раза. Каждое слово находится в своей строке из четырёх слов. При кэше на две строки и LRU каждое следующее обращение вытесняет строку, которая понадобится раньше остальных: все 16 обращений становятся промахами. При вместимости в четыре строки первые четыре обращения загружают данные, а остальные 12 попадают в кэш.
В обеих трассах есть повторение, но расстояние между повторными обращениями различается относительно доступной вместимости. Кроме того, последовательный обход использует соседние слова загруженной строки, а шаг четыре в этой модели читает только одно слово из каждой. Заметьте, что адреса здесь - номера слов, а не байтовые адреса; выравнивание блоков начинается с нуля.
Количество промахов не всегда прямо пропорционально времени работы: часть задержек может перекрываться, а вычисления и запись тоже занимают время. Чтобы сравнить реальные варианты программы, нужны измерения на целевой системе и одинаковые входные данные.
Как улучшать локальность в коде
При работе с массивом полезно проходить элементы в том порядке, в котором они размещены в памяти. Для двумерного массива с построчным непрерывным хранением соседние элементы строки находятся рядом: внутренний цикл по столбцам обычно использует пространственную локальность лучше, чем внутренний цикл по строкам. Для другого представления данных вывод может измениться.
Ещё один приём - блокирование: разбить большую задачу на части и выполнять больше работы с небольшим блоком, пока тот остаётся в быстром уровне памяти. Например, при умножении матриц плиточная организация помогает повторно использовать загруженные элементы. Размер блока подбирают с учётом доступного кэша и конкретной реализации, а не по универсальному числу.
Иногда выгодно хранить часто используемые вместе поля рядом или уменьшить лишние переходы по указателям. Однако преобразование структуры может усложнить обновления или ухудшить другой сценарий. Поэтому сначала определяют горячий участок программы, затем меняют порядок доступа и сравнивают результаты профилирования. Обсуждение оптимизаций через повторное использование и порядок обхода есть в материалах Carnegie Mellon.
Где ещё встречается идея локальности
В виртуальной памяти данные также группируются, но страница и строка кэша - разные единицы, используемые разными механизмами. Страницы отображают виртуальные адреса на физические и участвуют в управлении памятью; строки кэша обслуживают быстрый доступ к данным. Хорошая локальность может быть полезна обоим уровням, но промах кэша и отсутствие страницы в оперативной памяти - разные события.
В свёрточных нейронных сетях слово «локальный» описывает также небольшую область входа, с которой работает фильтр. Это близкая интуиция соседства, но она не определяет автоматически эффективность кэша: та зависит от фактической раскладки данных и порядка вычислений. Аналогично название принципа локальности в парадоксе ЭПР относится к физической причинности, а не к адресам памяти.
Частые ошибки
- Считать локальность гарантией попадания. Строка могла быть вытеснена до повторного доступа или конфликтовать с другими строками.
- Путать соседство по смыслу и по адресу. Объекты одной структуры данных могут лежать в разных местах памяти.
- Приравнивать промах кэша к промаху страницы. Это события разных уровней и с разными последствиями.
- Переносить результат модели на любое железо. Ассоциативность, предвыборка и другие особенности меняют фактическую картину.
FAQ
Локальность - это свойство программы или кэша?
Последовательность обращений создаётся программой и входными данными; кэш пытается её использовать. Будет ли повторное использование попаданием, зависит также от организации и состояния кэша.
Почему большая строка кэша не всегда лучше?
Она может принести больше полезных соседних данных, но также занимает место и переносит ненужные байты. Польза зависит от шаблона доступа и ограничений системы.
Есть ли локальность при случайном доступе?
Возможны случайные повторы и обращения к соседним адресам, но предсказать их по одному слову «случайный» нельзя. Результат зависит от распределения адресов и размера рабочего набора.
Коротко
Временная локальность - скорое повторение адреса, пространственная - обращения к соседним адресам. Кэш использует обе, сохраняя недавно загруженные строки. Эффект зависит от конкретной трассы и устройства памяти, поэтому учебный подсчёт помогает понять механизм, а окончательную оценку производительности дают измерения.
Читайте также
Адресация: прямая, косвенная и непосредственная
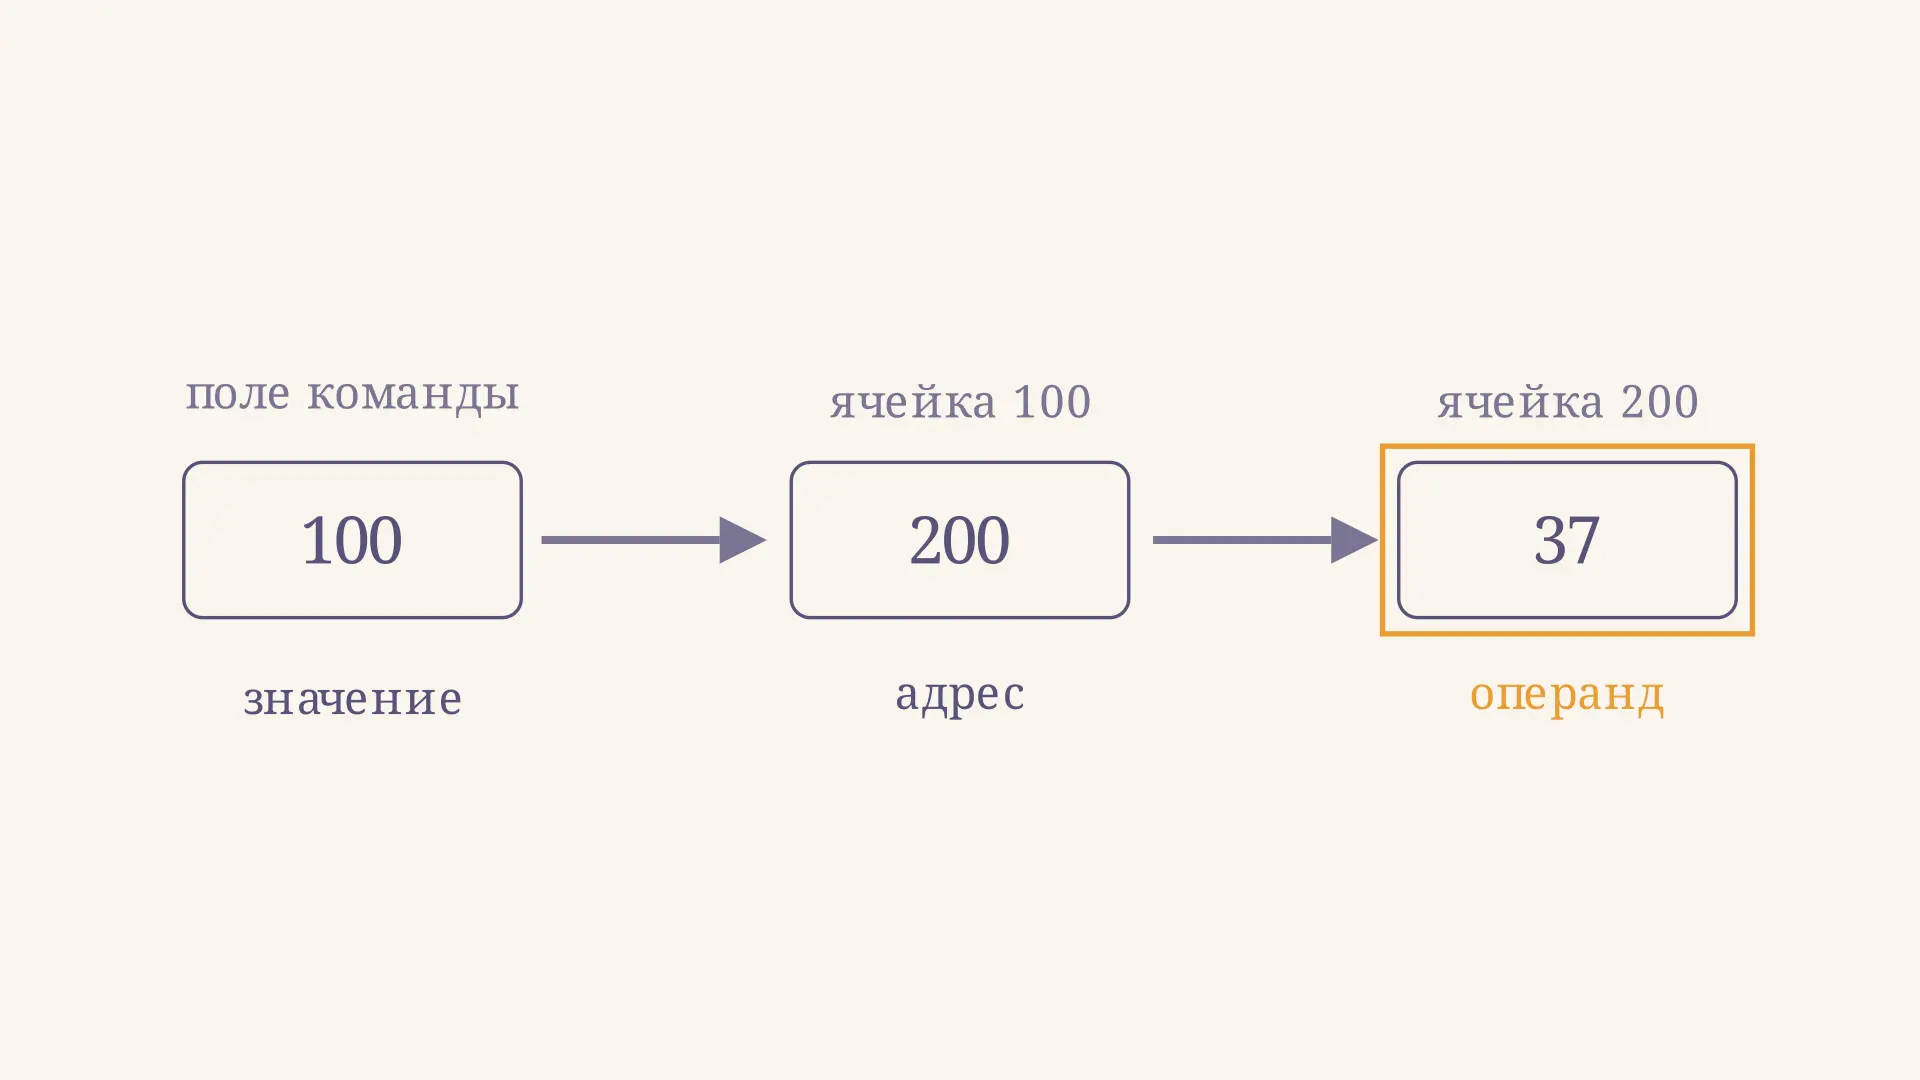
Разбираем прямую, косвенную и непосредственную адресацию операндов на одном примере памяти: как найти значение, посчитать чтения и не перепутать адрес с данными.
Алгоритм LZ77: сжатие с помощью ссылок назад
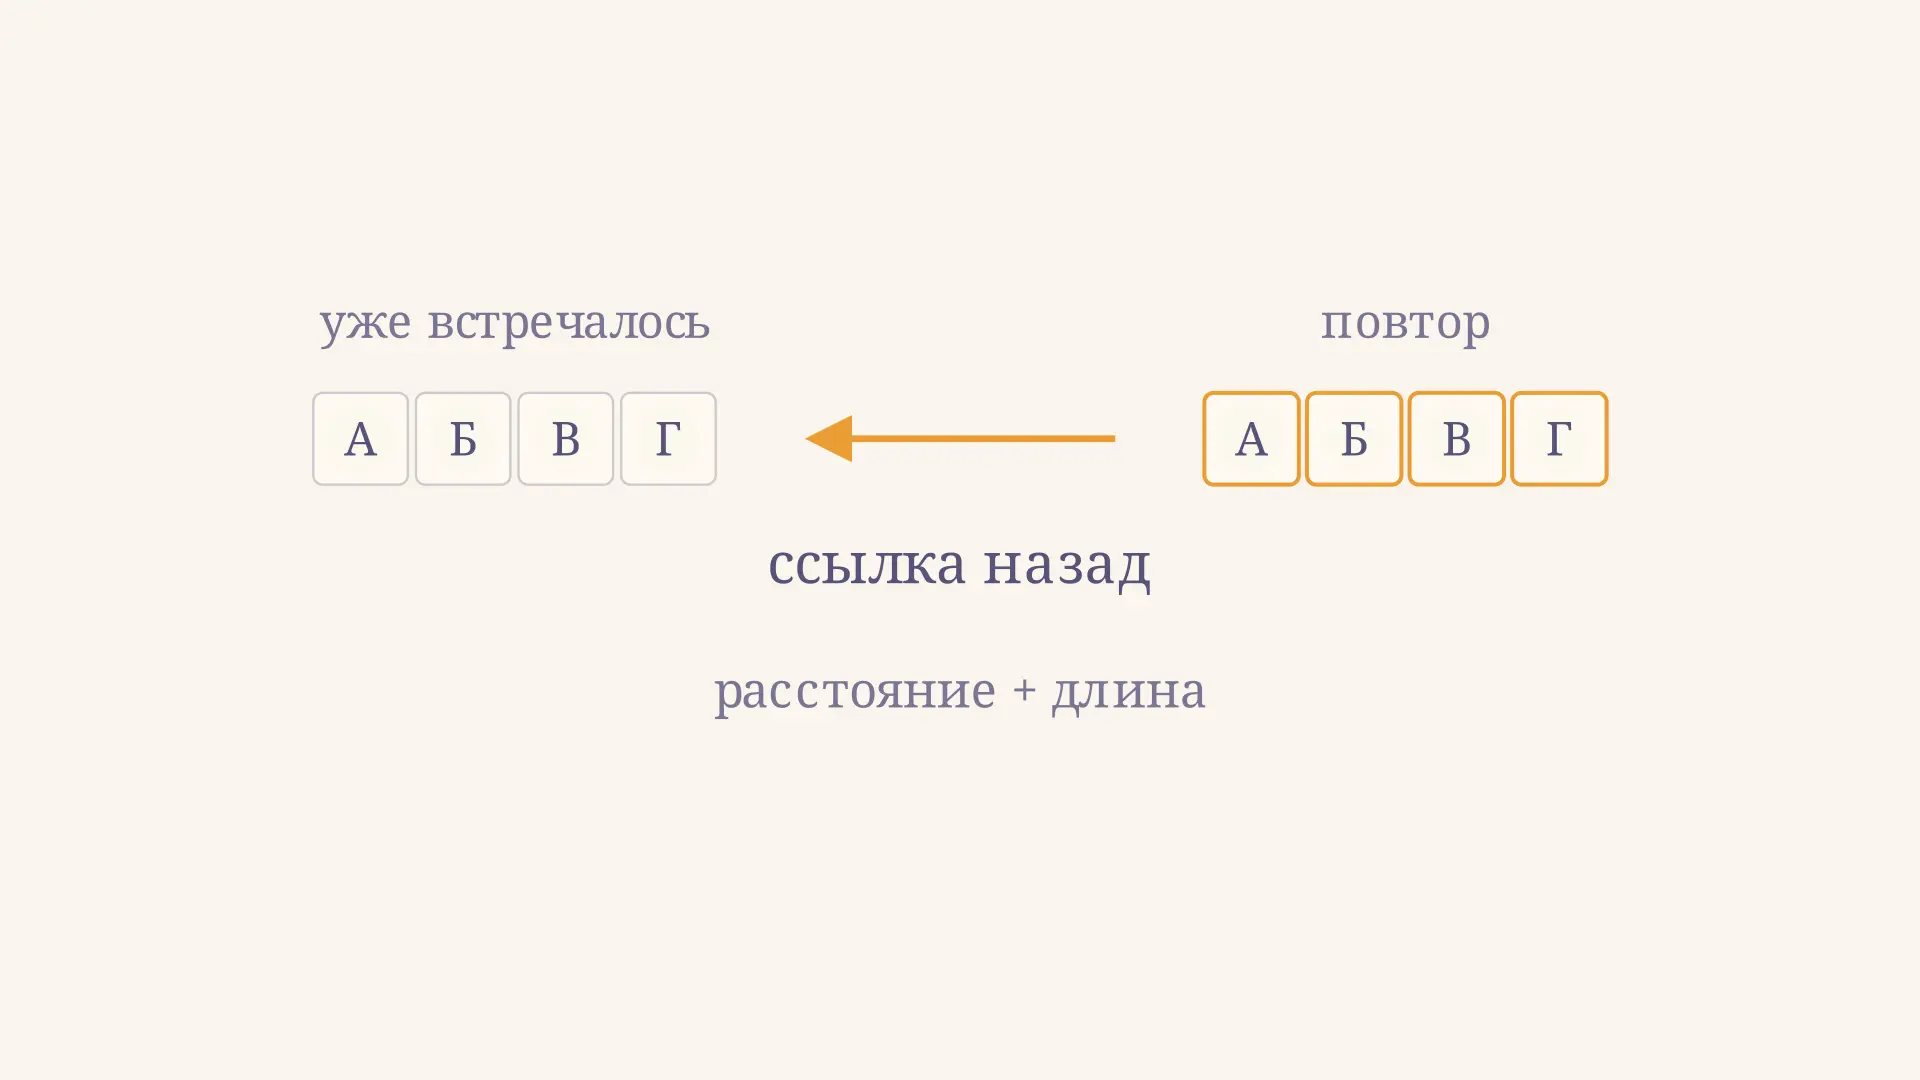
Алгоритм LZ77 на пошаговом примере: как скользящее окно находит повторы, что означают расстояние и длина, как работает перекрытие и от чего зависит размер результата.
Числа Белла: разбиения множества и формула
Числа Белла считают разбиения множества на непустые группы. Разбираем подробные примеры, рекуррентную формулу, связь с числами Стирлинга и алгоритм вычисления.
Числа трибоначчи: формула и примеры вычисления
Числа трибоначчи: три начальных значения, рекуррентная формула и расчёт по шагам. Как последовательность считает пути по ступенькам и как написать эффективный алгоритм.
Чётность подстановки: инверсии и знак
Чётность подстановки через инверсии, транспозиции и циклы: пошаговый подсчёт, доказательство независимости разложения и применение в алгоритмах и определителях.
Цикл выполнения команды процессора: этапы и пример
Цикл выполнения команды процессора по шагам: выборка, декодирование, исполнение и запись результата. Разберём регистры, переходы, такты и конвейер на примере.