Архитектура NUMA: узлы и доступ к памяти
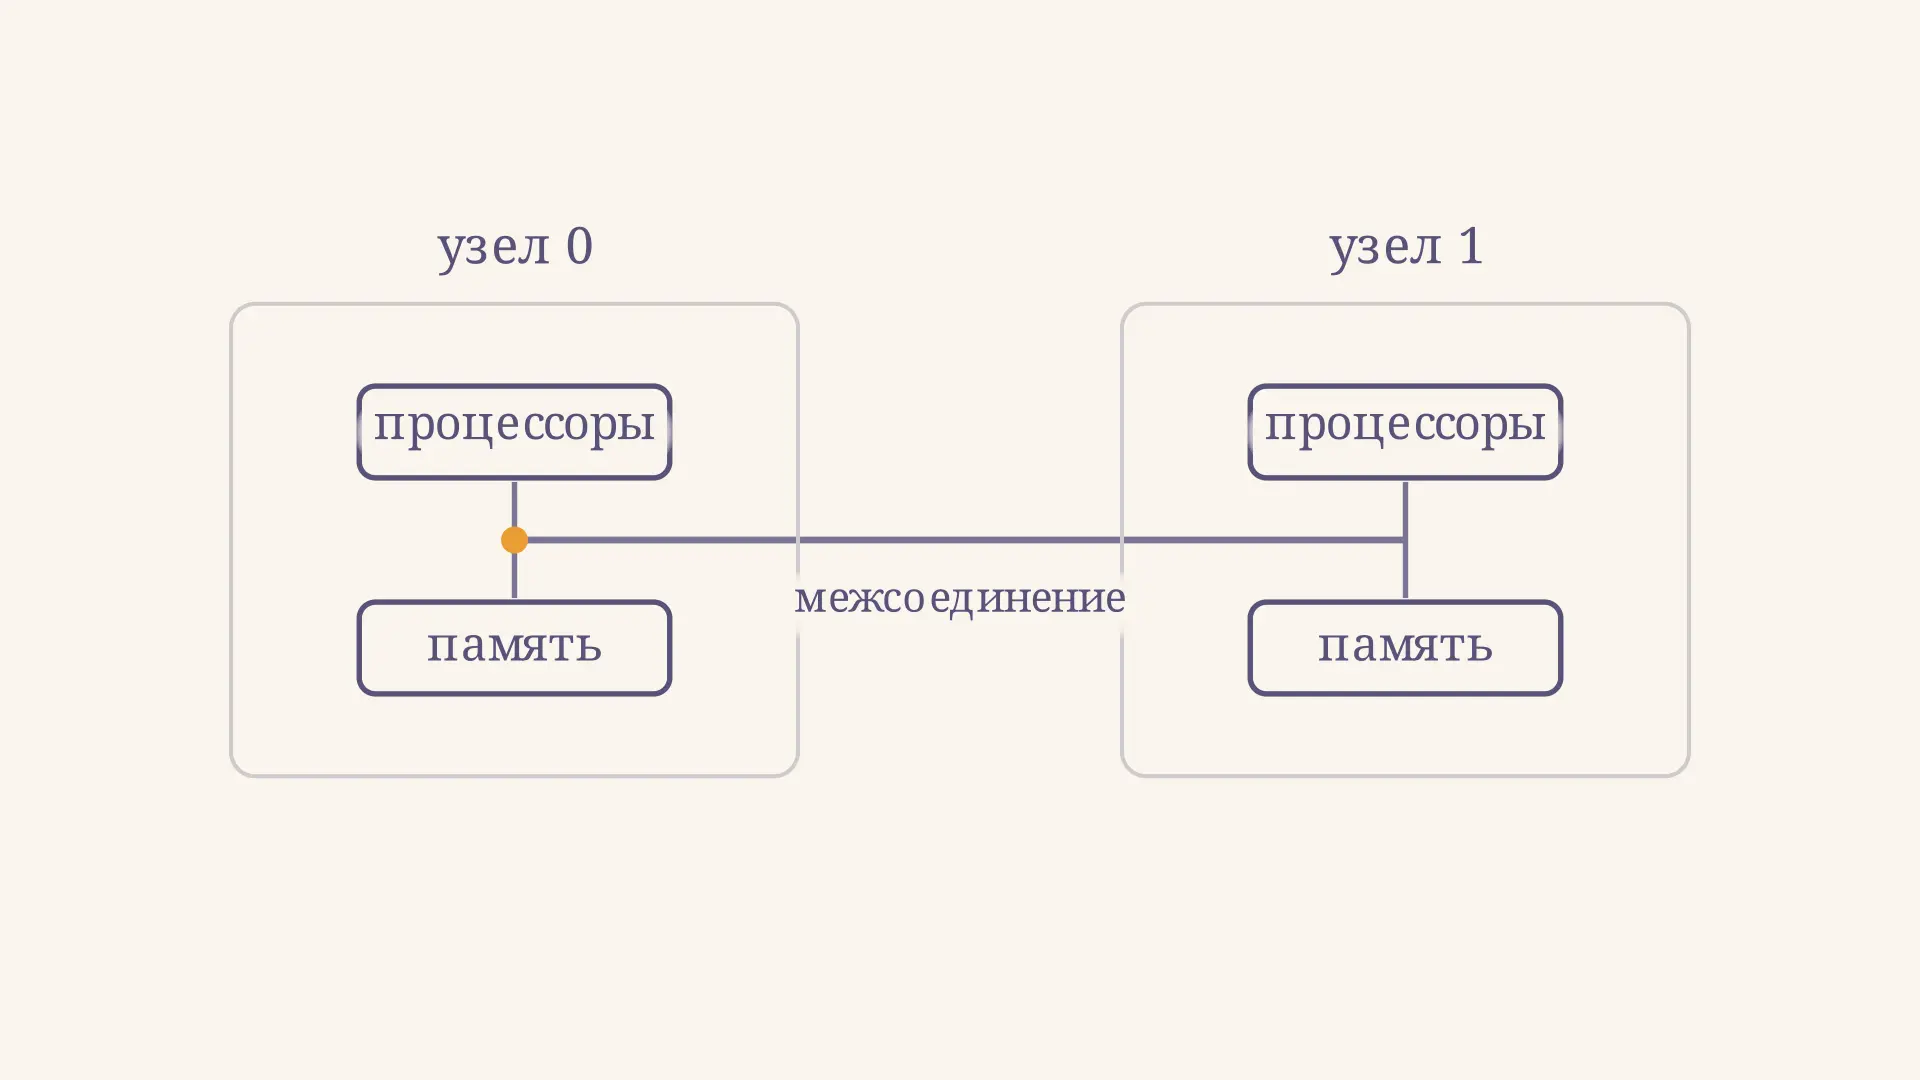
Архитектура NUMA (Non-Uniform Memory Access) - организация общей памяти, при которой стоимость обращения к ней зависит от расположения процессора и данных. Процессор может обращаться не только к ближайшей памяти своего узла, но и к памяти другого узла. Второй путь обычно проходит через межсоединение и может иметь большую задержку. Ниже разберём устройство узлов, размещение страниц и простую модель среднего времени доступа. В калькуляторе можно менять долю удалённых обращений и смотреть, как она влияет на учебный пример.
Узлы и общая память
Представим систему из двух узлов. В каждом есть процессорные ядра и связанная с ними оперативная память; узлы соединены каналом. Ядро узла 0 обращается к памяти узла 0 по местному пути, а к памяти узла 1 - по удалённому. Для ядер узла 1 понятия местного и удалённого меняются местами: они определяются относительно того, где выполняется поток.
Память остаётся частью общего физического адресного пространства: удалённая не означает недоступная. В типичной когерентной NUMA-системе аппаратные механизмы поддерживают согласованность копий данных в кэшах. Это не отменяет правил синхронизации потоков: два потока не должны одновременно изменять общие данные без подходящих средств языка или системы.
Схема из двух одинаковых узлов - лишь модель. Топология реального сервера может быть сложнее: в одном сокете может быть несколько NUMA-узлов, а отдельный узел может не содержать процессорных ядер или собственной памяти. Поэтому число сокетов нельзя автоматически приравнивать к числу узлов. Документация ядра Linux описывает представление топологии и выбор ближайшей доступной памяти.
NUMA и UMA: в чём разница
В модели UMA время доступа к общей памяти предполагается одинаковым для всех процессоров. В NUMA оно зависит от пары «процессор - память». На практике характеристики влияют друг на друга: задержка, пропускная способность, кэши и нагрузка на каналы не сводятся к одному числу. NUMA описывает прежде всего неоднородность расстояний, а не гарантированное ускорение каждой программы.
Преимущество распределённых контроллеров памяти - возможность увеличивать совокупные ресурсы системы вместе с числом узлов. Но если много ядер постоянно запрашивают данные одного удалённого узла, они могут создать очередь у его памяти и межсоединения. Локальное расположение данных помогает сократить такой трафик; результат зависит от нагрузки и устройства сервера.
Полезно отличать топологию памяти от шины адреса, данных и управления: шина описывает передачу сигналов, тогда как NUMA показывает, почему путь до разных областей памяти неодинаков. Точно так же размер оперативной памяти сам по себе не говорит, насколько близко данные расположены к конкретному ядру.
Как оценить среднюю задержку
Возьмём условные числа, а не характеристики конкретного процессора: локальное обращение занимает нс, удалённое нс. Пусть доля удалённых обращений равна , то есть 40 %. Если каждое обращение относится ровно к одному из двух типов, их средняя задержка равна взвешенному среднему:
Подставляем значения: нс. При нулевой доле удалённых обращений модель даёт 80 нс, при 100 % - 140 нс. Между этими точками результат растёт линейно: каждый дополнительный процент удалённых обращений добавляет в данном примере 0,6 нс к среднему.
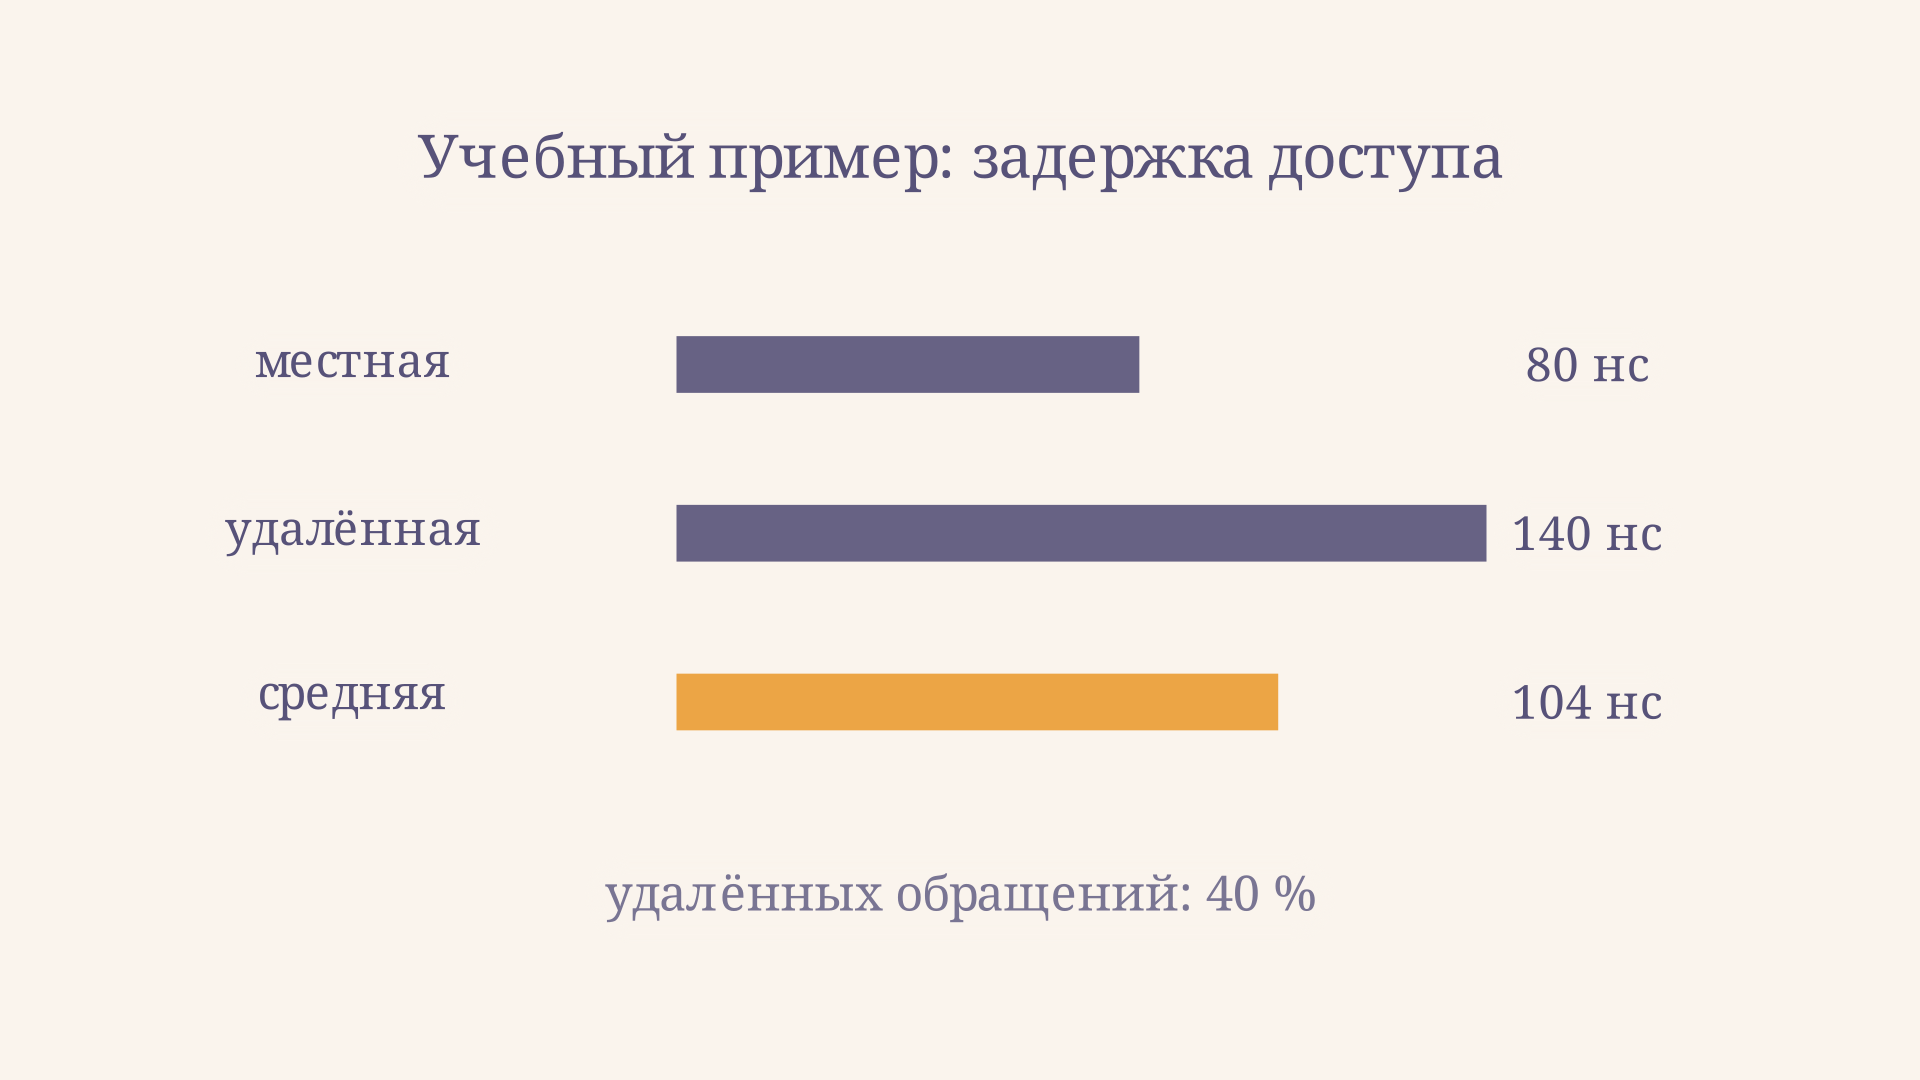
Это среднее по обращениям, а не время выполнения программы. Оно не учитывает попадания в кэш, параллельные запросы, очереди, разные удалённые расстояния и работу процессора, которая может перекрывать ожидание памяти. Например, снижение средней задержки обращений на 10 % не означает автоматического ускорения всего приложения на 10 %. Для практического вывода нужны замеры самой нагрузки.
От виртуальной страницы к физическому узлу
Программа обычно работает с виртуальными адресами, а операционная система отображает их на физические страницы. Механизм трансляции рассмотрен в статье про страничную организацию виртуальной памяти. NUMA добавляет другой вопрос: на каком узле находится физическая страница, к которой в итоге приведёт адрес?
В Linux политика по умолчанию обычно сначала пытается выделить память на узле процессора, выполняющего запрос, и при необходимости может перейти к другим узлам. Для анонимной памяти важен момент первого обращения, вызывающего фактическое выделение страницы: например, поток инициализирует массив, записывая в него значения. Если один поток сначала заполнит весь массив, а потом работа распределится между узлами, часть потоков может регулярно обращаться к удалённым страницам.
Один из способов улучшить локальность - параллельно инициализировать части массива теми же рабочими потоками, которые будут их обрабатывать. Это работает как идея только при соответствующем размещении потоков и страниц; миграция потоков, нехватка памяти, явная политика и ограничения контейнера могут изменить результат. Ядро также может перемещать страницы или задачи. Первое касание не является обещанием неизменного расположения на весь срок работы.
Политики размещения и привязка потоков
Управлять можно двумя связанными, но разными решениями: где разрешено выполняться потоку и где разрешено выделять страницы. Привязка к процессорам ограничивает перемещение потока, а политика памяти определяет предпочтения или допустимые узлы для выделения. Настроить только одно из них недостаточно, чтобы гарантировать локальность всей программы.
Например, политика чередования распределяет выделения между выбранными узлами. Она может помочь нагрузке, которой важна суммарная пропускная способность, но часть обращений отдельного потока при этом станет удалённой. Привязка памяти к одному узлу полезна для локальных данных, однако при нехватке места ограничение способно привести к неудаче выделения. Семантика политик и ограничения допустимых узлов описаны в документации Linux NUMA Memory Policy.
Разделение данных имеет значение и на уровне алгоритма. Например, при поиске в двоичном дереве последовательные переходы по указателям могут зависеть от результата предыдущего обращения. Расположение узлов дерева и поведение кэша влияют на ожидание памяти; одна только оценка числа сравнений не измеряет это ожидание.
Как проверить NUMA на практике
Начните с топологии: команда numactl --hardware показывает доступные узлы, связанные с ними процессоры и матрицу расстояний, если утилита установлена. Числа расстояния служат относительным описанием топологии, а не гарантированными задержками в наносекундах. Доступные узлы внутри контейнера могут быть ограничены по сравнению со всей машиной.
Затем проверьте размещение рабочего процесса: /proc/<pid>/numa_maps содержит сведения об отображениях и распределении страниц по узлам; numastat -p <pid> даёт сводную картину, если утилита доступна. Снимайте данные во время характерной нагрузки: сразу после запуска страницы ещё могут не быть выделены, а позже их расположение может измениться.
Сравните несколько запусков с одинаковыми входными данными и числом потоков. Отдельно измерьте время приложения, загрузку процессоров и, если доступны, счётчики памяти. Меняйте по одному фактору: сначала размещение потоков, затем инициализацию или политику памяти. Повторения нужны из-за фоновой нагрузки и разброса результатов. Для задач обучения моделей расположение массивов может влиять на подачу данных, хотя сам алгоритм обратного распространения ошибки от NUMA не зависит.
Частые ошибки
- Считать всю память узла частной. В общей адресной модели другие узлы тоже могут к ней обращаться, хотя путь может быть дороже.
- Путать узел с сокетом. Соответствие определяется реальной топологией и настройками, а не названием процессорного разъёма.
- Принимать модель за бенчмарк. Значения 80 и 140 нс в примере условны; замеры зависят от системы и нагрузки.
- Закреплять поток после инициализации и считать проблему решённой. Страницы уже могли оказаться на другом узле, поэтому нужно смотреть на оба размещения.
FAQ
NUMA означает отдельную память для каждого процесса?
Нет. Процессы имеют собственные виртуальные адресные пространства, но физические страницы размещаются на узлах общей памяти. Разные процессы могут также разделять некоторые страницы.
Удалённая память всегда медленнее?
Её путь обычно дороже местного, но результат конкретного измерения зависит от кэшей, конкуренции за контроллеры, характера доступа и топологии. При сильной локальной нагрузке сравнение может измениться.
Нужна ли NUMA-настройка каждой программе?
Нет. Небольшое приложение или задача, не ограниченная памятью, может почти не выиграть. Сначала измерьте нагрузку и только затем усложняйте размещение.
Коротко
NUMA объединяет память узлов в общее адресное пространство, сохраняя различия стоимости доступа. Локальность зависит и от того, где работает поток, и от расположения страниц. Учебное взвешенное среднее помогает понять влияние доли удалённых запросов, а решение для реальной программы опирается на топологию и повторяемые измерения.
Читайте также
Адресация: прямая, косвенная и непосредственная
Разбираем прямую, косвенную и непосредственную адресацию операндов на одном примере памяти: как найти значение, посчитать чтения и не перепутать адрес с данными.
Архитектура фон Неймана: память и цикл команды
Как устроена архитектура фон Неймана: общая память команд и данных, процессор, цикл выполнения инструкции, пример вычисления и ограничение общей шины.
Цикл выполнения команды процессора: этапы и пример
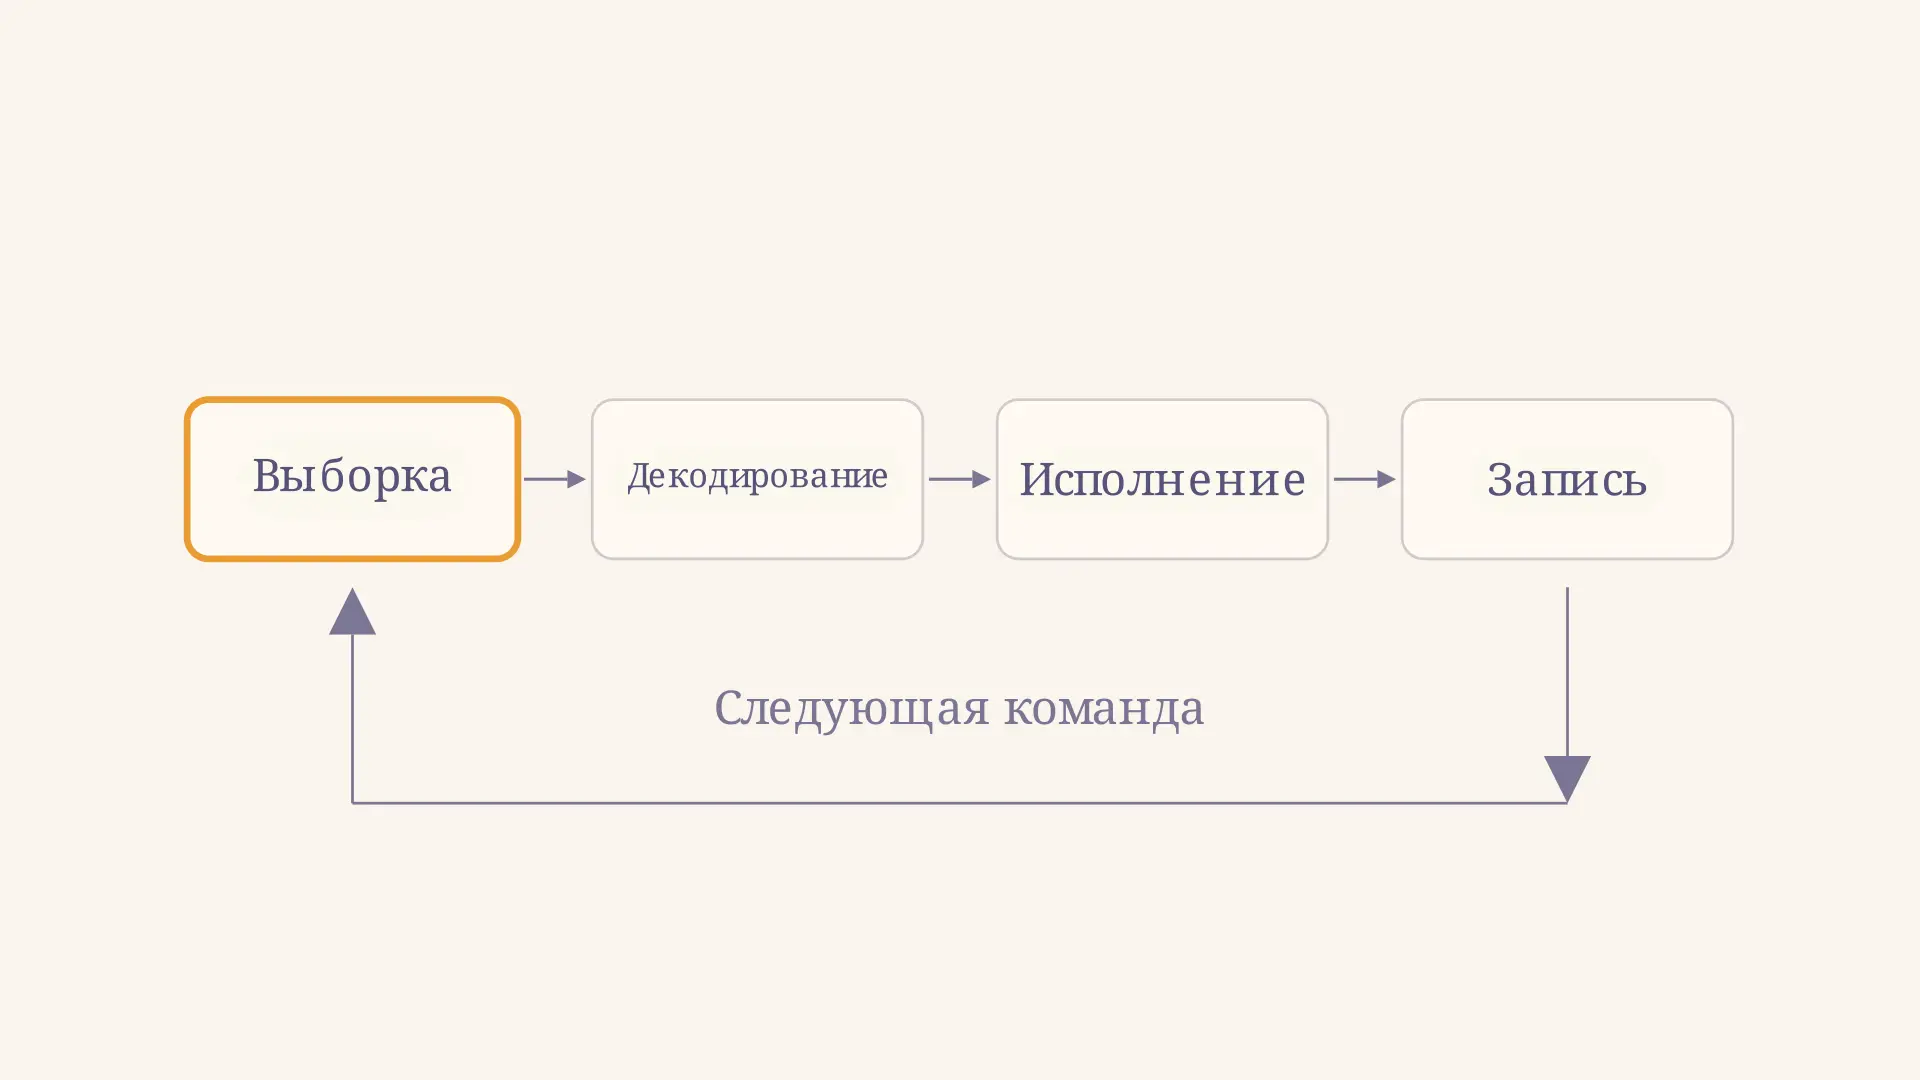
Цикл выполнения команды процессора по шагам: выборка, декодирование, исполнение и запись результата. Разберём регистры, переходы, такты и конвейер на примере.
Прямой доступ к памяти DMA: как работает передача
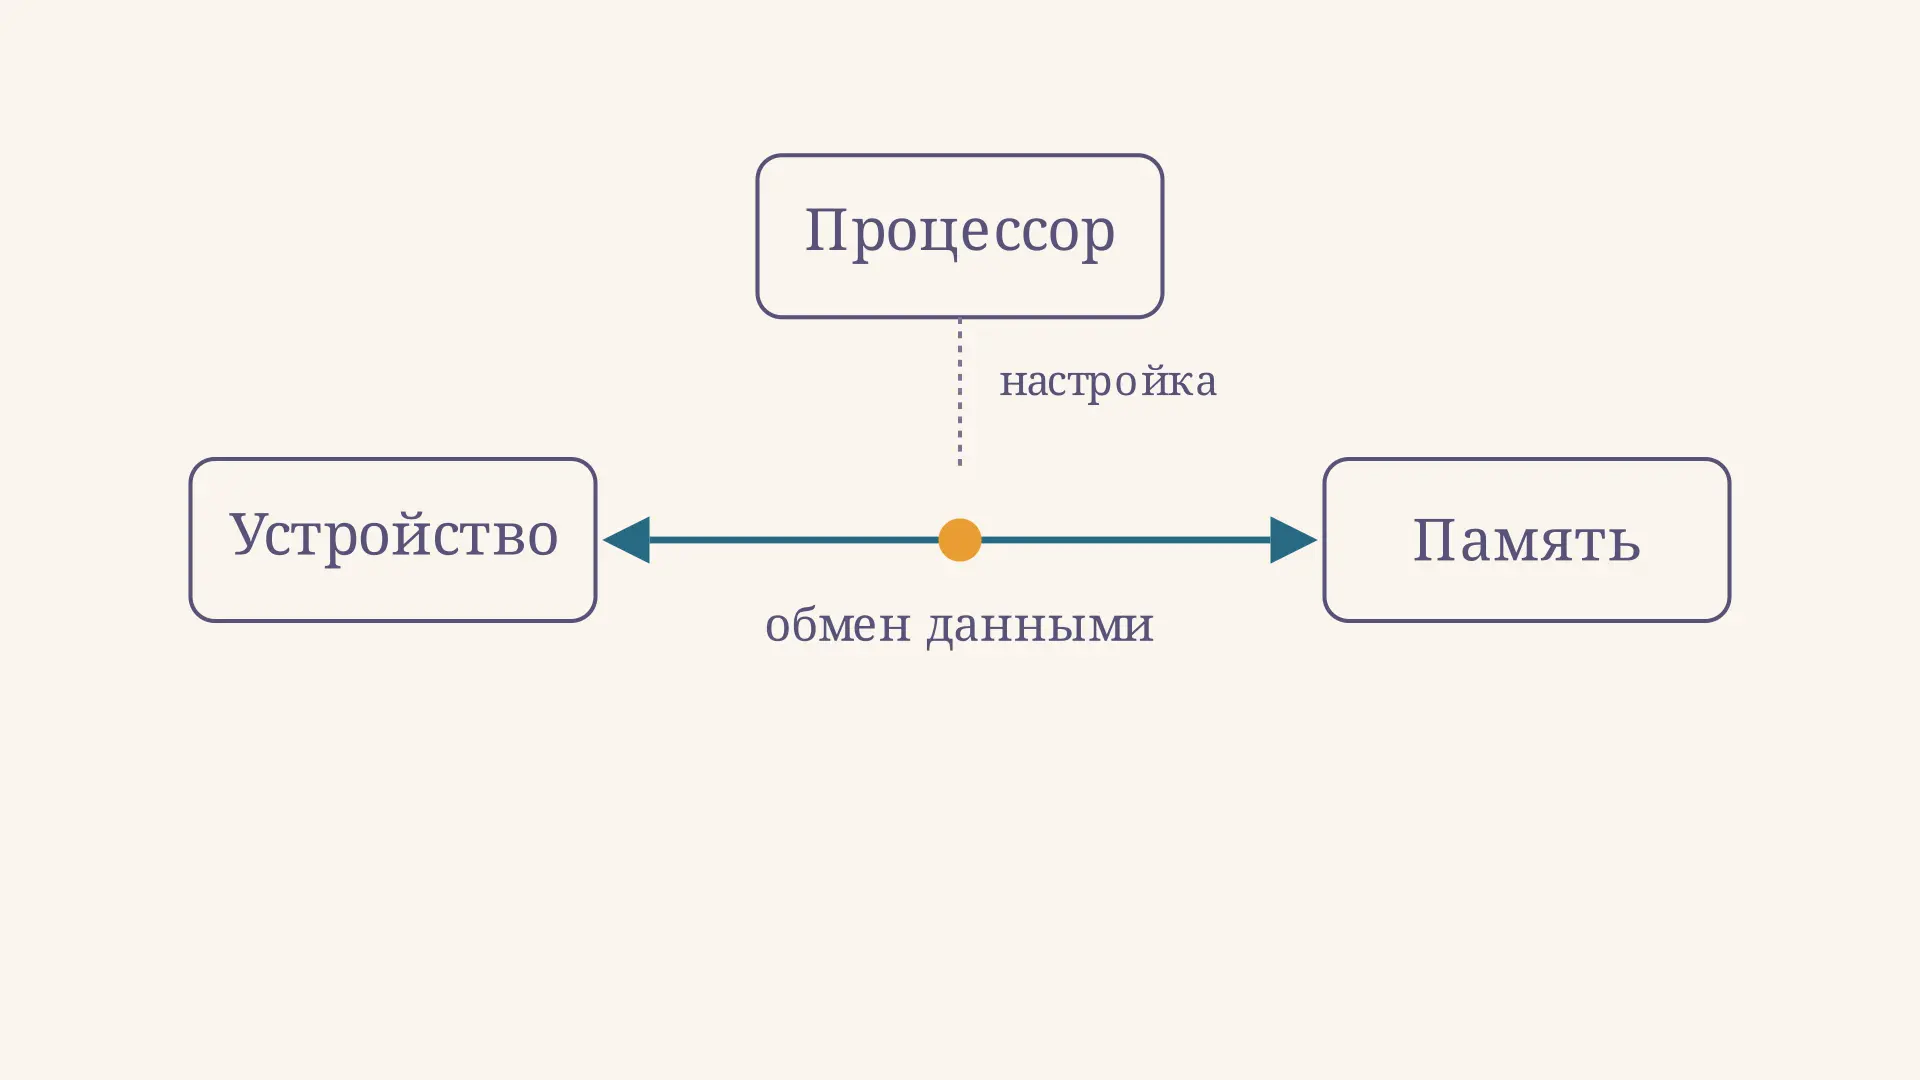
Прямой доступ к памяти DMA: как устройство обменивается данными с оперативной памятью, какую роль играет процессор, как считать блоки и зачем нужны IOMMU и синхронизация кэша.
Вектор прерываний: как процессор находит обработчик
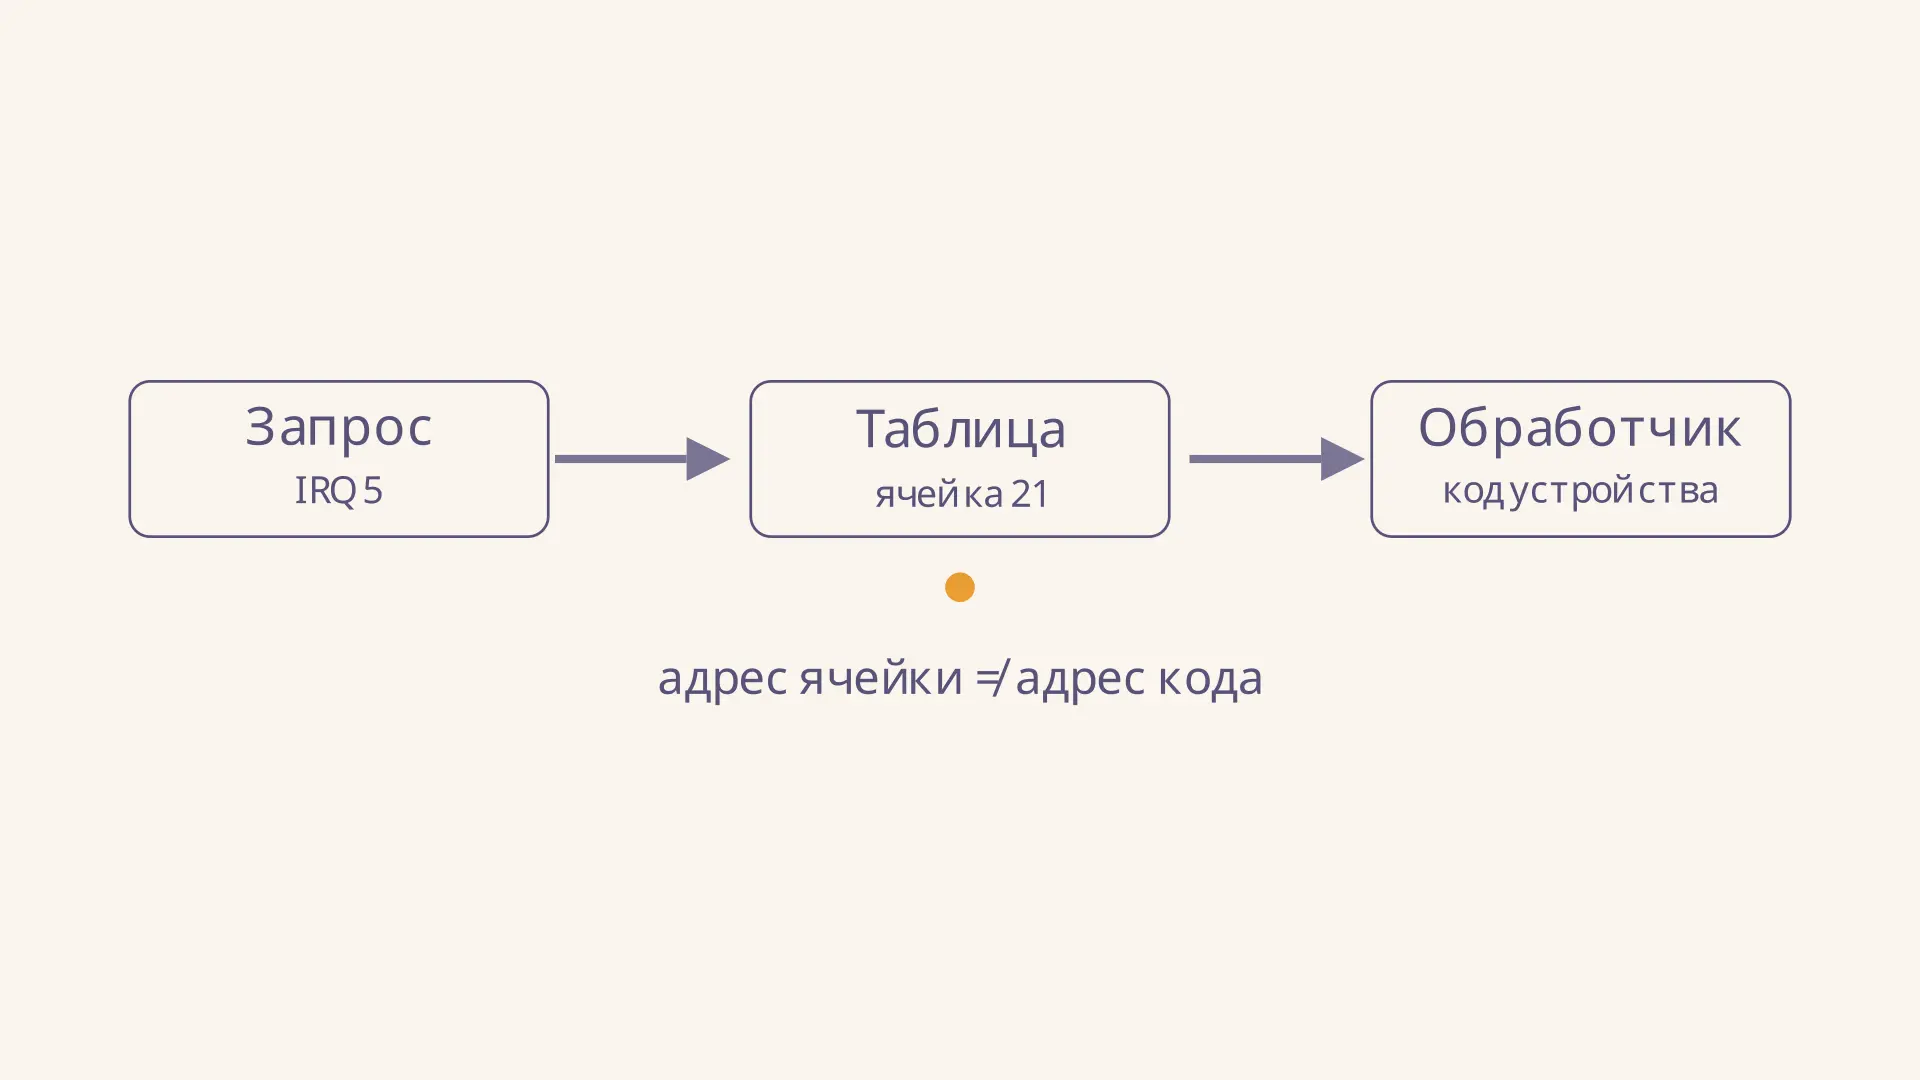
Что такое вектор прерываний и таблица векторов: путь от запроса к обработчику, расчёт адреса ячейки на Cortex-M4 и типичные ошибки при чтении таблицы.
Абсолютно неупругий удар: сохранение импульса
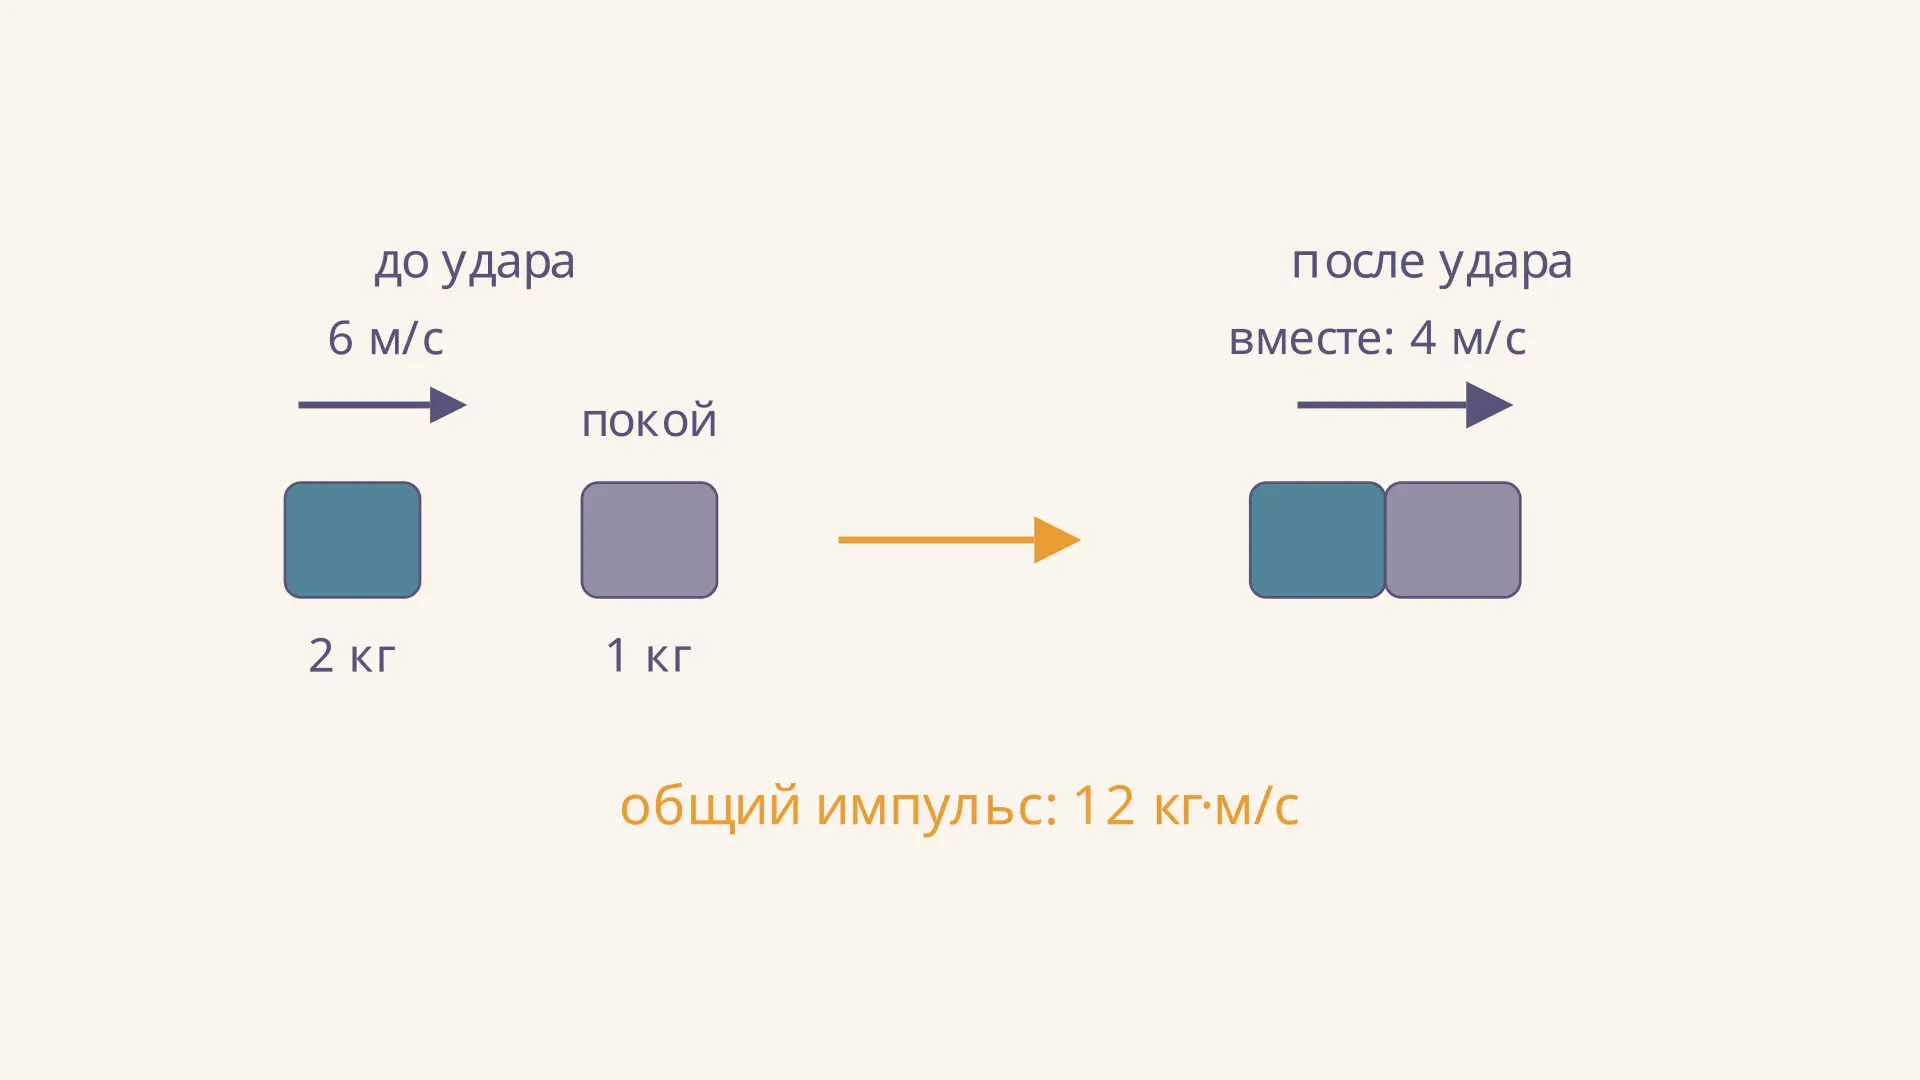
Как найти скорость тел после абсолютно неупругого удара, применить закон сохранения импульса и вычислить потерю кинетической энергии на понятных примерах с формулами.