Архитектура фон Неймана: память и цикл команды
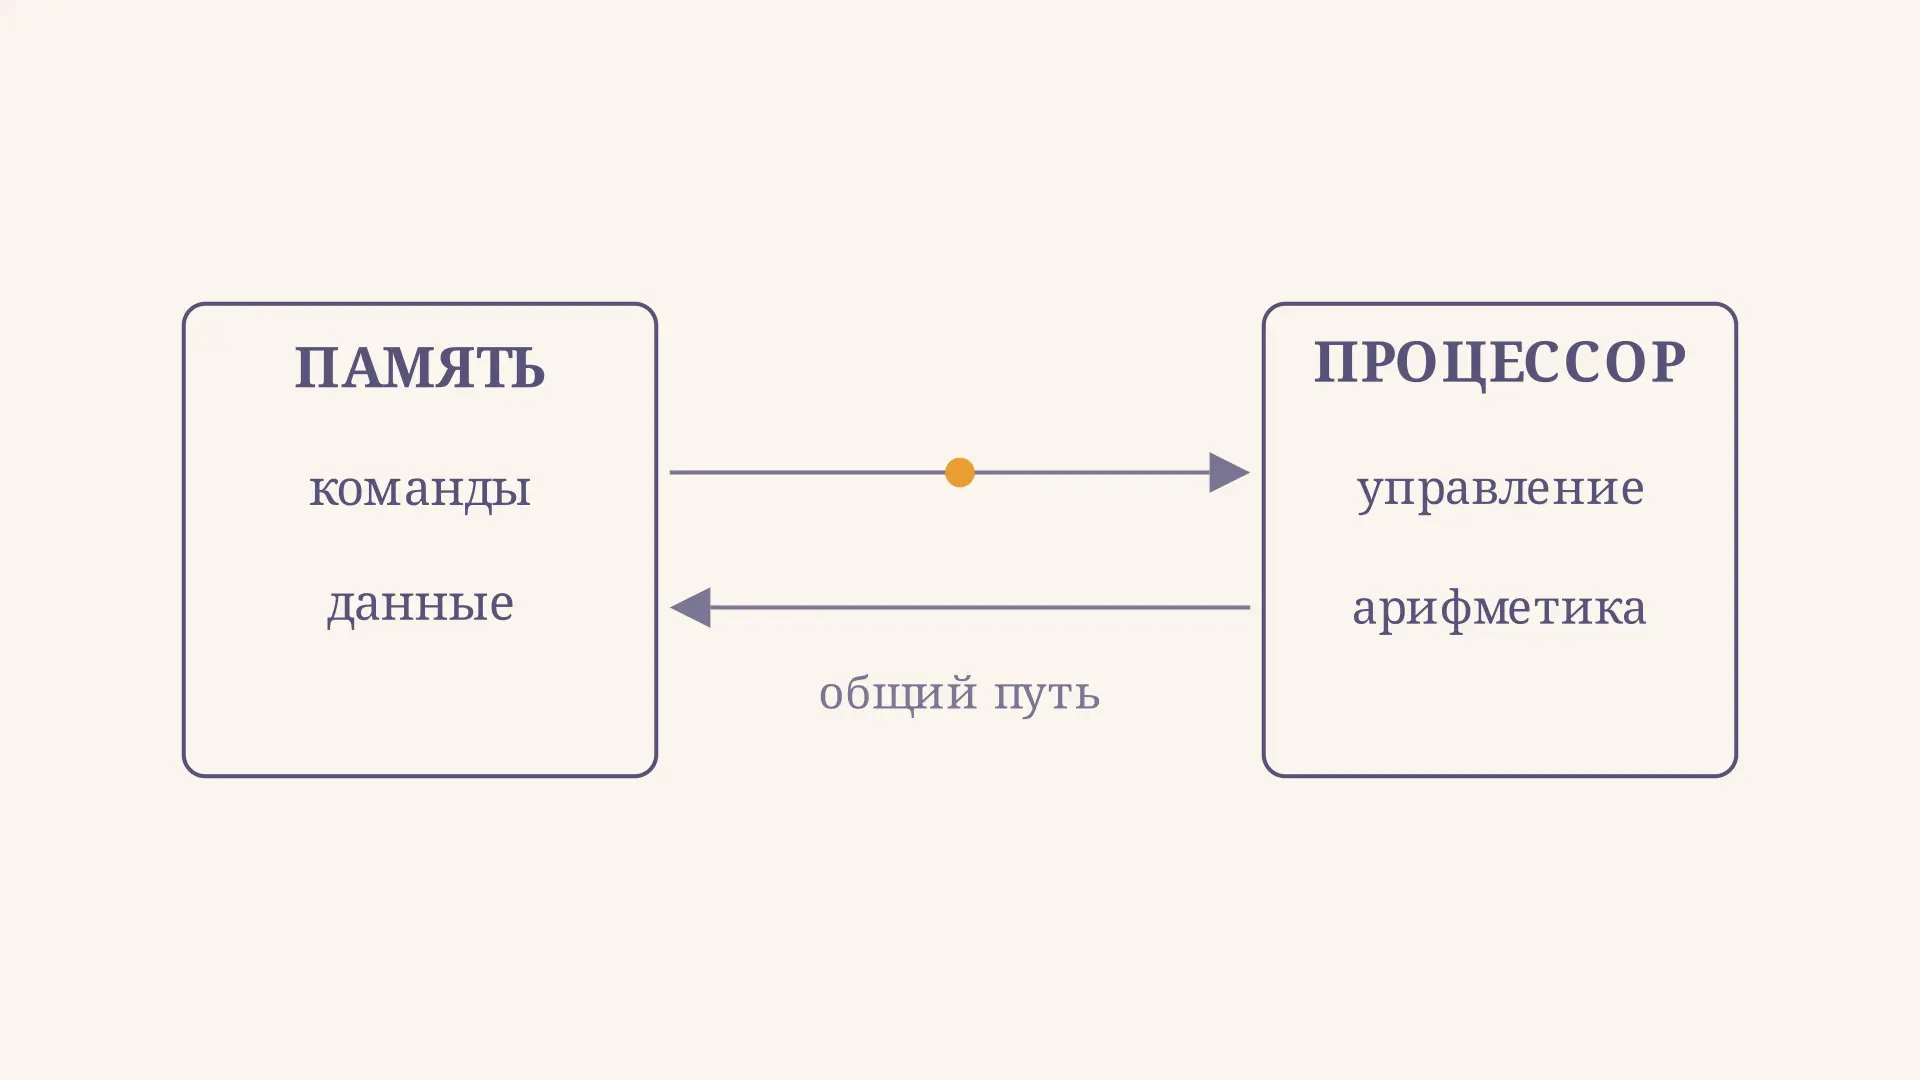
Архитектура фон Неймана - способ организации компьютера, в котором программа хранится в памяти вместе с данными, а процессор извлекает её команды и выполняет их. Благодаря хранимой программе одна и та же машина может решать разные задачи: достаточно загрузить другую последовательность инструкций. Посмотрим, как взаимодействуют память и процессор, пройдём короткую программу и разберём, почему обмен между ними иногда ограничивает скорость. Для начала выберите интересующий вопрос в форме ниже.
Главная идея: хранимая программа
Компьютеру нужны и числа для обработки, и указания, что с ними делать. В модели фон Неймана те и другие представлены кодами и хранятся в общей адресуемой памяти. Процессор обращается к ячейке по адресу и использует полученные биты как команду или как данные в зависимости от текущего действия. Сами биты не снабжены универсальной меткой «это программа»: смысл задаёт способ их использования.
До распространения хранимых программ изменение задачи могло требовать существенной перенастройки оборудования. При новой организации программу можно записать в память и затем заменить другой. Это не означает, что любая программа мгновенно готова к работе: её ещё нужно представить в подходящих машинных командах и загрузить.
Идеи устройства EDVAC изложены в первом проекте отчёта фон Неймана 1945 года. Работа над EDVAC была коллективной, поэтому название архитектуры не следует понимать как утверждение, что вся идея принадлежала одному человеку.
Из каких частей состоит компьютер
В упрощённой схеме выделяют память, процессор и устройства ввода-вывода. Память хранит команды, исходные данные и промежуточные результаты. Адрес позволяет выбрать место, а содержимое этого места можно прочитать или, если область допускает запись, изменить.
В процессоре устройство управления организует выполнение команд, а арифметико-логическое устройство выполняет операции над значениями. Регистры удерживают небольшие порции информации внутри процессора: например, текущий результат и адрес следующей команды. Это функциональное разделение; реальный процессор устроен сложнее и не обязан состоять из двух наглядно отделимых коробок.
Устройства ввода передают машине информацию, устройства вывода представляют результат или отправляют его дальше. Связь между частями обеспечивают каналы обмена; отдельно о назначении линий можно прочитать в статье про шины адреса, данных и управления.
На схеме движение показывает направление обмена, а не число электрических сигналов или точное устройство конкретной шины. Одна инструкция может потребовать нескольких обращений, а другая вообще не обращаться к данным в памяти.
Как выполняется команда
Работу удобно представить повторяющимся циклом. Сначала процессор выбирает команду по адресу, который указывает счётчик команд. Затем он декодирует её: определяет операцию и то, откуда взять операнды. На этапе выполнения процессор выполняет действие, при необходимости читает данные или записывает результат.
После обычной команды адрес следующей инструкции продвигается вперёд. Но команда перехода может установить другой адрес: так возникают ветвления и циклы. Операционная система и аппаратные события также могут менять ход выполнения через исключения и прерывания. Поэтому «команды всегда идут строго подряд» - только первое приближение.
Порядок стадий помогает понять логику, но не задаёт длительность в тактах. Современные процессоры могут перекрывать стадии разных инструкций, заранее выбирать команды и выполнять некоторые операции параллельно. При этом программа должна получать результат в соответствии с правилами выбранной архитектуры.
Пример: сложение двух чисел
Представим учебный процессор с одним рабочим регистром. Его условные команды занимают по одной ячейке, а адреса ниже записаны просто как номера; это не машинный код конкретного процессора.
| Адрес | Содержимое до выполнения | Действие |
|---|---|---|
| 00 | ЗАГРУЗИТЬ 10 | Прочитать число из ячейки 10 в регистр |
| 01 | СЛОЖИТЬ 11 | Прибавить к регистру число из ячейки 11 |
| 02 | ЗАПИСАТЬ 12 | Сохранить регистр в ячейке 12 |
| 10 | 3 | Первое слагаемое |
| 11 | 4 | Второе слагаемое |
| 12 | 0 | Место для результата |
В начале регистр может содержать произвольное значение: команда по адресу 00 заменит его числом 3. После команды по адресу 01 в регистре находится . Команда по адресу 02 записывает 7 в ячейку 12. Исходные ячейки 10 и 11 при этом не меняются.
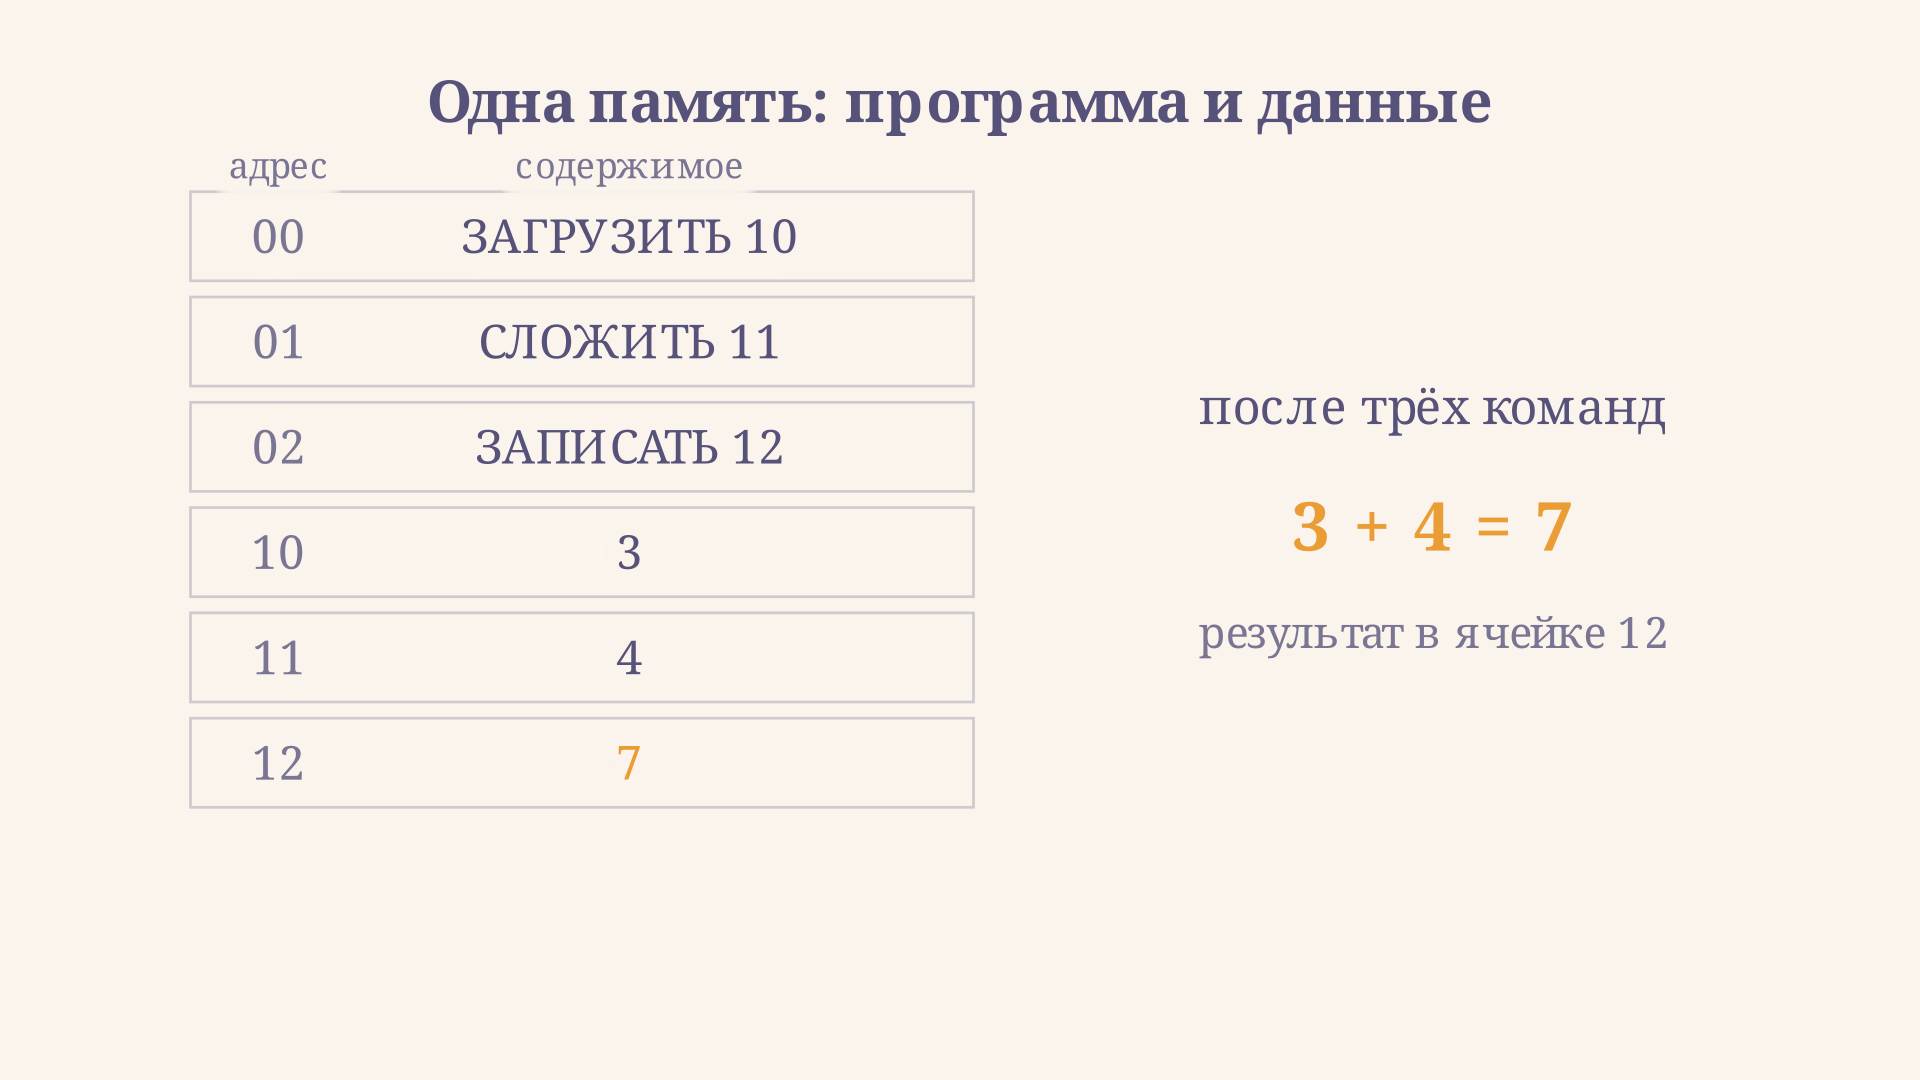
Каждую команду сначала нужно получить из той же учебной памяти, где лежат числа. Именно поэтому общий ресурс обмена важен даже в таком маленьком примере. Мы специально опустили кодирование команд, разрядность и переполнение: они зависят от реального набора инструкций.
В этом примере адрес и содержимое ячейки играют разные роли. Число 10 в первой команде обозначает место, откуда следует взять операнд; число 3 по этому адресу является самим операндом. Если вместо 3 в ячейку 10 заранее записать 8, программа при тех же командах получит результат 12. Изменение данных не требует переписывать последовательность действий.
Так же можно заменить программу, оставив исходные числа в памяти: например, выполнить другую разрешённую операцию. Но процессор не угадывает намерение автора. Он следует кодам инструкций и адресам, поэтому неверный адрес способен привести к чтению не того значения. В реальной системе защита памяти может запретить такое обращение, если оно направлено в недоступную область.
Почему возникает узкое место фон Неймана
Если процессор способен обрабатывать значения быстрее, чем система памяти доставляет нужные команды и данные, он может ждать обмена. Такую проблему часто называют узким местом фон Неймана. Время и энергия уходят на перемещение информации между памятью и вычислителем; ограничение проявляется по-разному в зависимости от задачи и устройства машины. Исследователи IBM рассматривают его, например, в контексте вычислений для ИИ.
Представим, что процессору нужны данные, которых нет рядом с ним. Даже очень быстрое арифметическое устройство не завершит операцию до их поступления. Увеличение скорости одного лишь вычислительного блока не гарантирует такого же ускорения всей программы.
Для уменьшения ожидания используют иерархию памяти, кеши, предварительную загрузку и другие приёмы. Кеш хранит недавно или часто используемые данные ближе к процессору, но при промахе обращение всё равно может потребовать более медленного уровня. Это не то же самое, что виртуальная память, которая прежде всего организует адресное пространство программ и его отображение на физическую память.
Чем отличается Гарвардская архитектура
В классической Гарвардской архитектуре команды и данные размещают в раздельных памятях с отдельными путями доступа. Это позволяет организовать одновременное получение команды и обращение к данным, если реализация поддерживает такие операции. Цена - более сложная организация и менее свободное распределение ресурсов между двумя видами памяти.
На практике граница не всегда проходит по всему компьютеру. Например, процессор может иметь отдельные кеши инструкций и данных, хотя на другом уровне память организована как общее адресное пространство. Название полезно для сравнения принципов, но по одному слову нельзя восстановить все детали реализации.
Зачем это нужно программисту
Модель объясняет, почему один компьютер способен выполнять множество программ и почему расположение данных влияет на время работы. Например, алгоритм Кнута - Морриса - Пратта задаёт порядок операций над строкой, а процессор исполняет реализующие его команды. При обработке большого массива повторное использование уже загруженных значений может снизить число дорогих обращений к памяти. Однако эффект зависит от размера кеша, компилятора и самой задачи; оценивать конкретную программу нужно измерениями.
Архитектурная схема также отличается от математической модели вычисления. Универсальная машина Тьюринга помогает рассуждать о вычислимости, тогда как схема фон Неймана описывает организацию компонентов и выполнение хранимых команд. В обоих случаях одна универсальная система может работать с разными программами, но детали реализации различаются.
Частые ошибки
- Путать процессор с памятью. Процессор выполняет операции и управляет их порядком, память хранит информацию.
- Считать программу особым физическим веществом. Команды тоже представлены битами; их роль определяется тем, как их интерпретирует процессор.
- Обещать одно обращение на команду. Количество обращений зависит от инструкции, кеша и реализации.
- Считать общую память запретом на параллелизм. Конвейеры и несколько ядер могут работать параллельно, хотя доступные ресурсы обмена остаются ограниченными.
FAQ
Все современные компьютеры устроены строго по фон Нейману?
Многие используют принцип хранимой программы, но дополняют простую схему кешами, несколькими ядрами и специализированными ускорителями. Отдельные уровни могут разделять пути команд и данных.
Может ли программа изменить собственные команды?
В принципе да, если соответствующая область памяти доступна для записи и исполнения. На практике действуют ограничения защиты и правила согласования кешей; изменение кода не является необходимым условием хранимой программы.
Почему команда и число могут лежать рядом?
Память хранит битовые представления по адресам. Процессор трактует выбранное содержимое согласно текущей операции: как инструкцию при выборке команды или как значение при чтении данных.
Коротко
Архитектура фон Неймана связывает процессор с общей памятью команд и данных. Процессор последовательно выбирает, декодирует и выполняет инструкции, а переходы меняют их порядок. Общий обмен делает машину гибкой, но скорость и стоимость перемещения информации могут ограничивать вычисление.
Читайте также
Адресация: прямая, косвенная и непосредственная
Разбираем прямую, косвенную и непосредственную адресацию операндов на одном примере памяти: как найти значение, посчитать чтения и не перепутать адрес с данными.
Архитектура NUMA: узлы и доступ к памяти
Архитектура NUMA простыми словами: как устроены узлы, чем отличается локальный доступ к памяти от удалённого, как оценить задержку и проверить размещение в Linux.
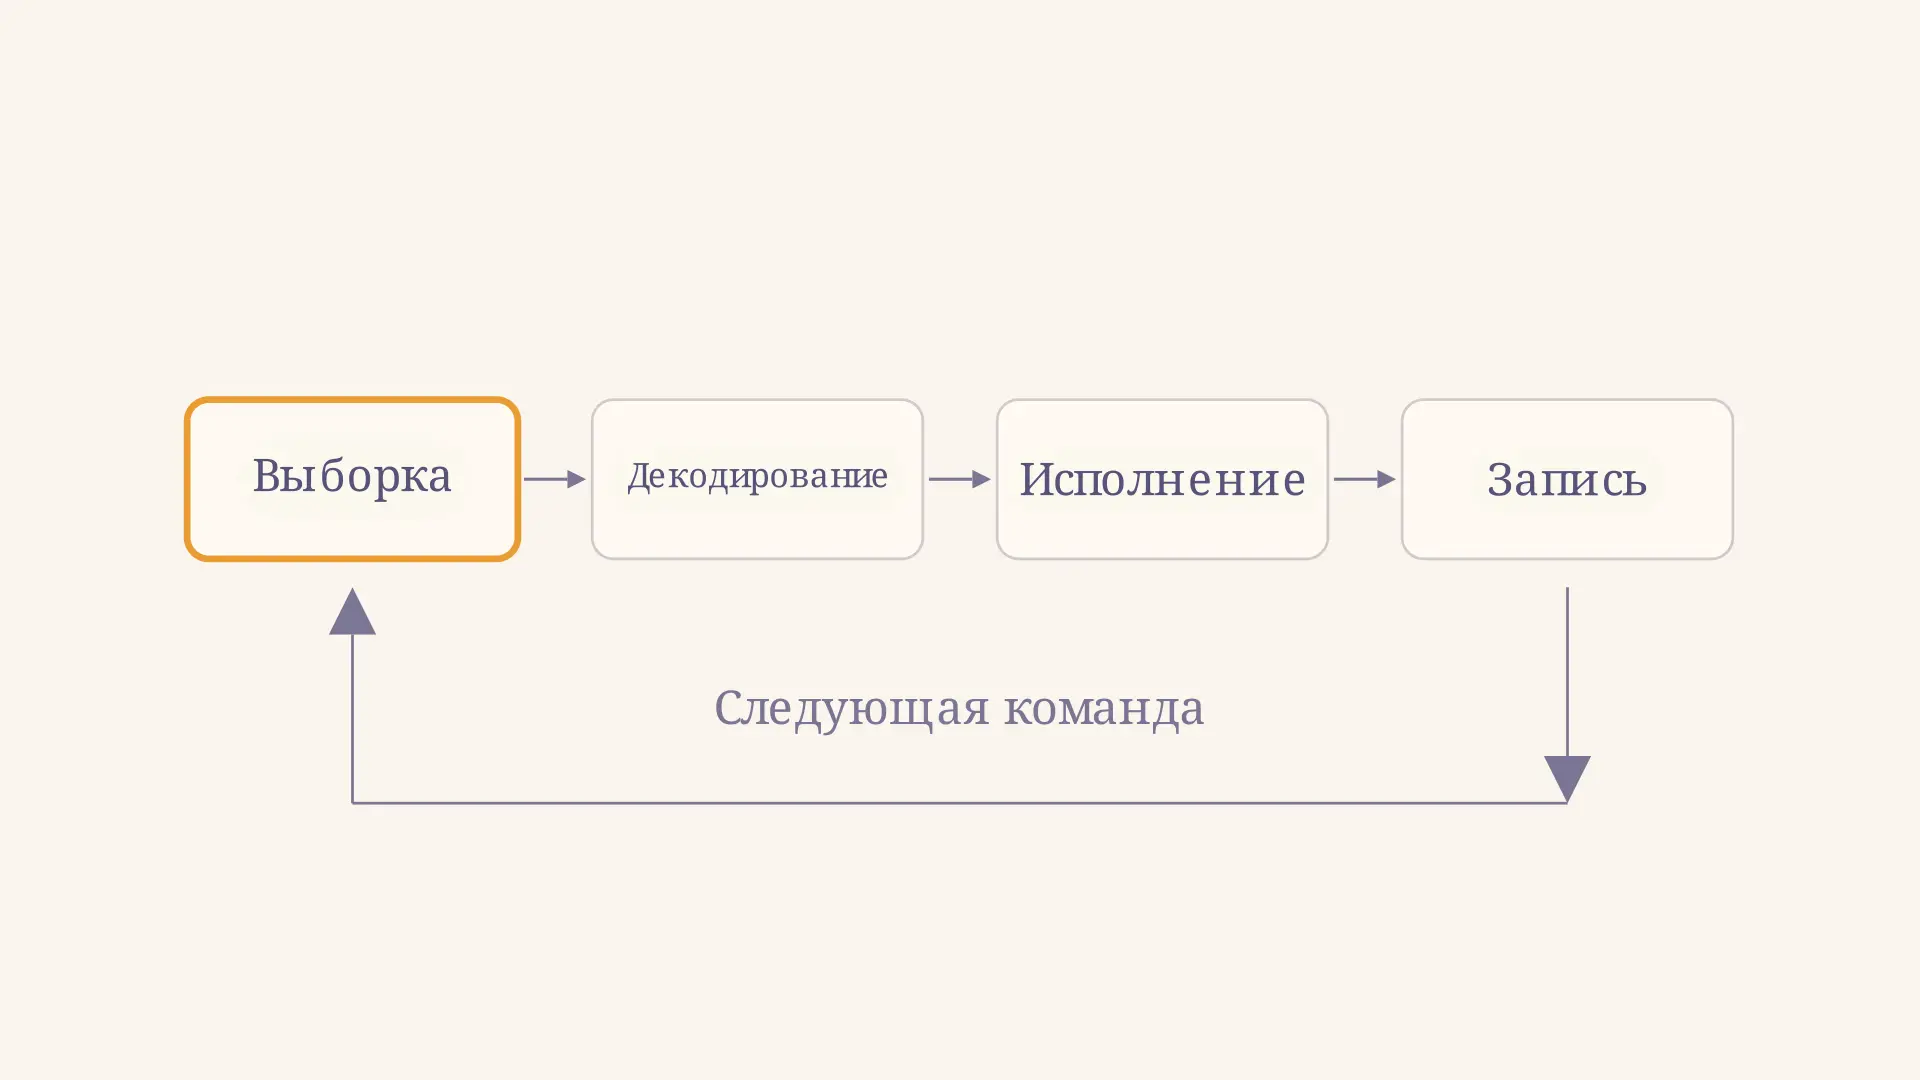
Цикл выполнения команды процессора: этапы и пример
Цикл выполнения команды процессора по шагам: выборка, декодирование, исполнение и запись результата. Разберём регистры, переходы, такты и конвейер на примере.
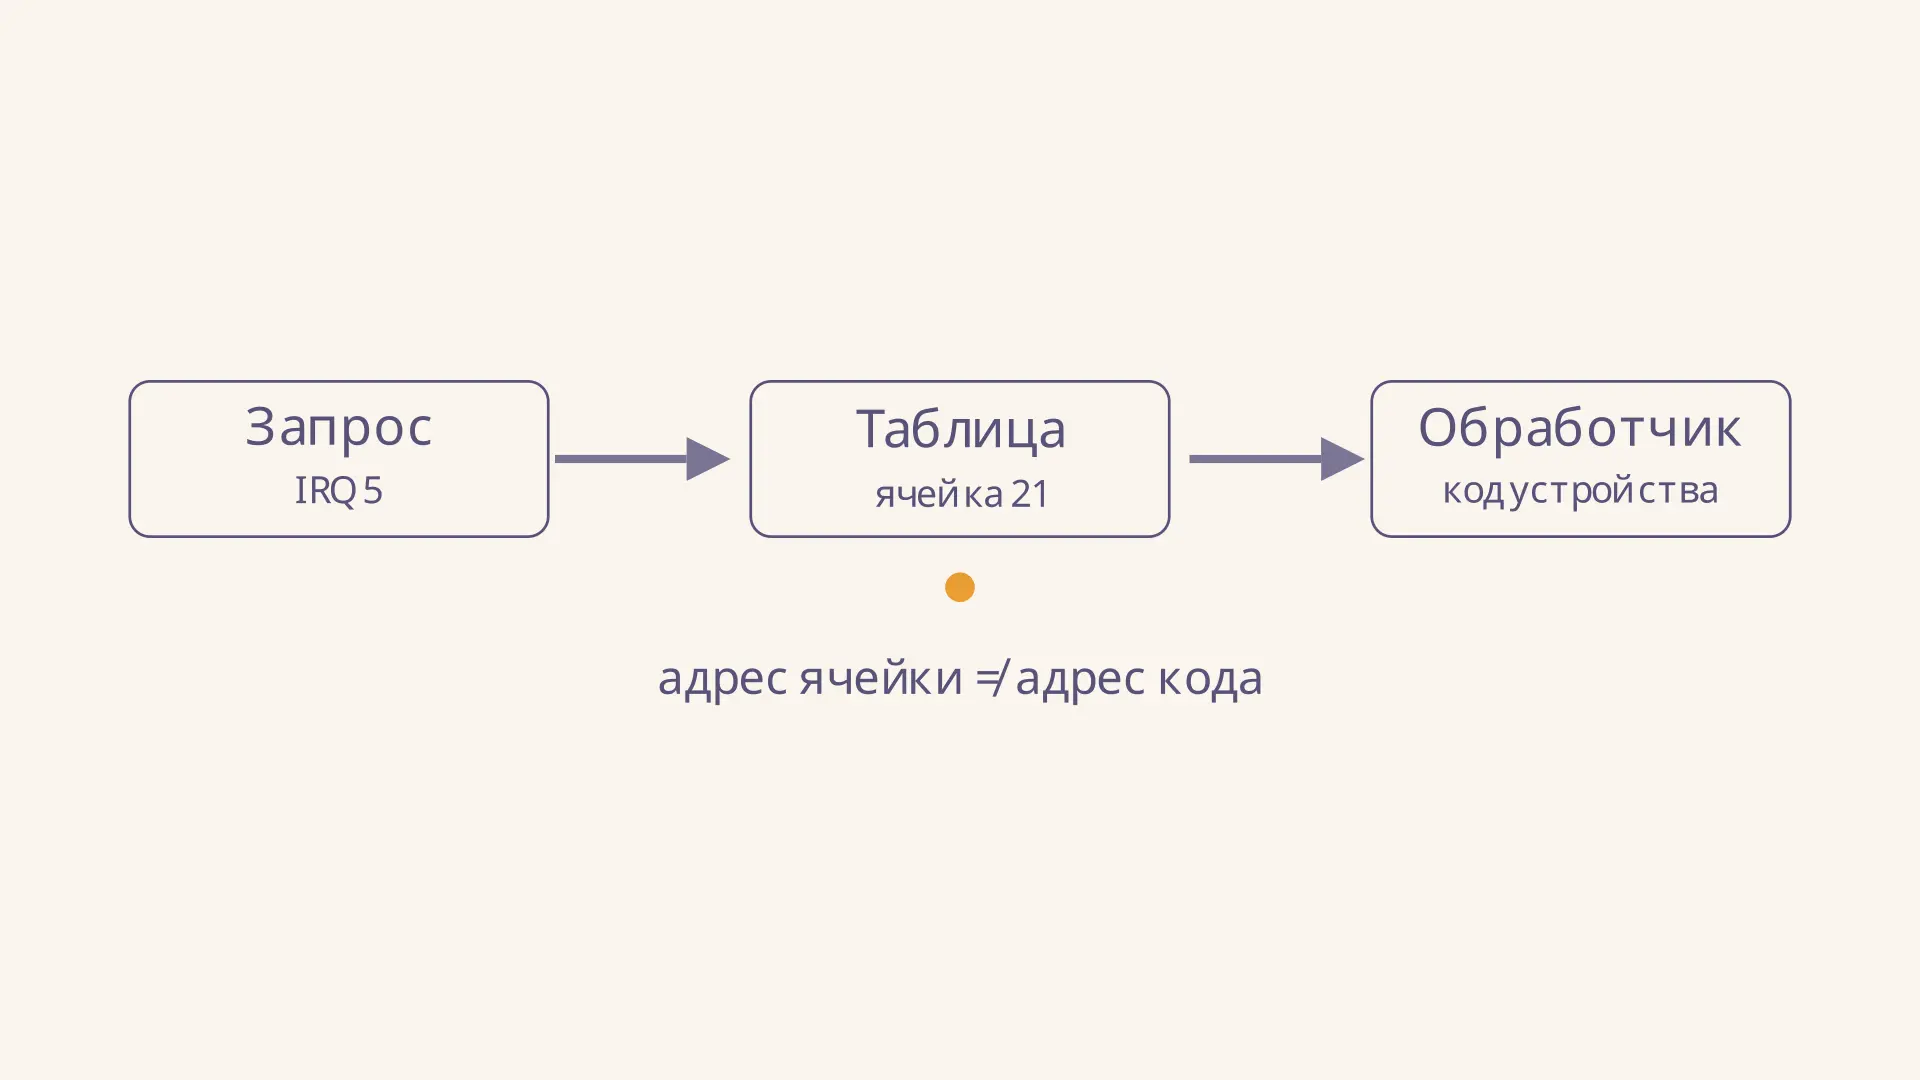
Вектор прерываний: как процессор находит обработчик
Что такое вектор прерываний и таблица векторов: путь от запроса к обработчику, расчёт адреса ячейки на Cortex-M4 и типичные ошибки при чтении таблицы.
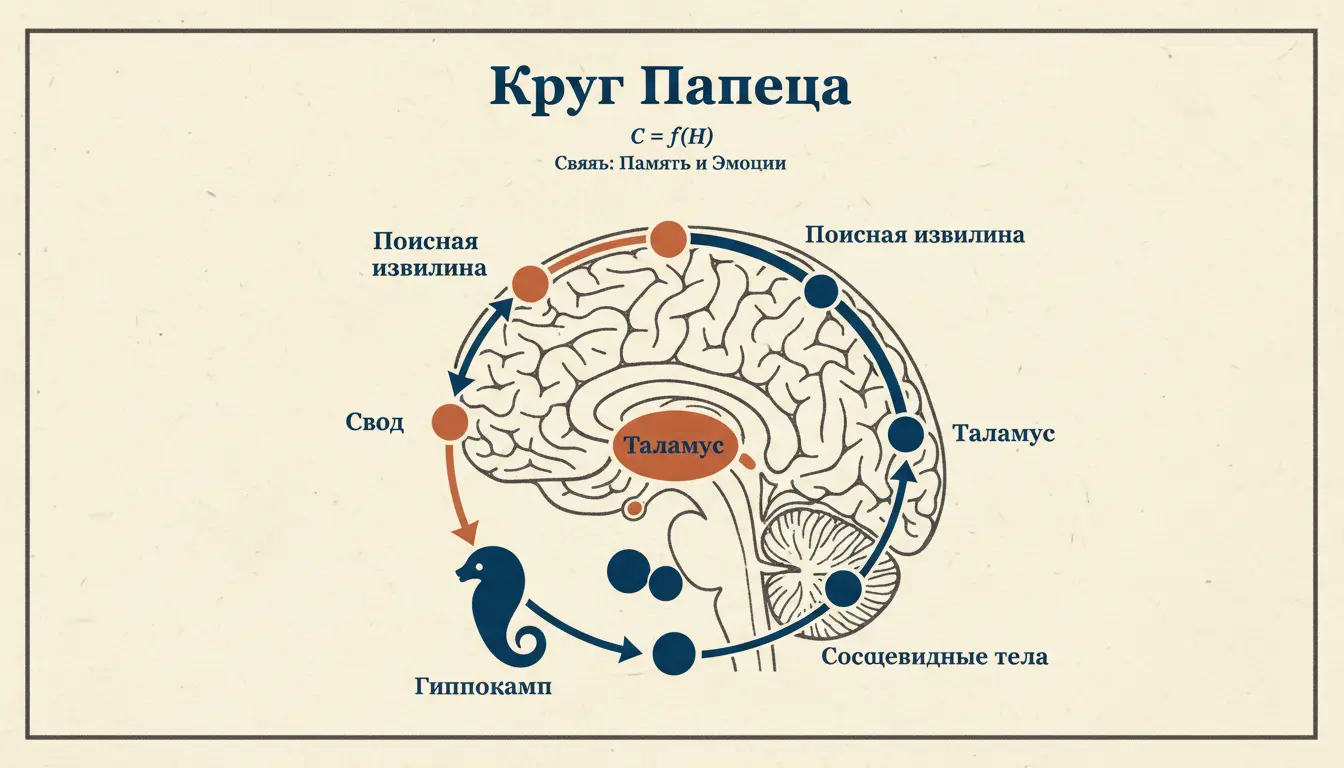
Круг Папеца лимбической системы: схема и звенья
Круг Папеца лимбической системы: из каких структур состоит контур памяти и эмоций, в каком порядке идут звенья от гиппокампа к таламусу и как запомнить схему к экзамену.
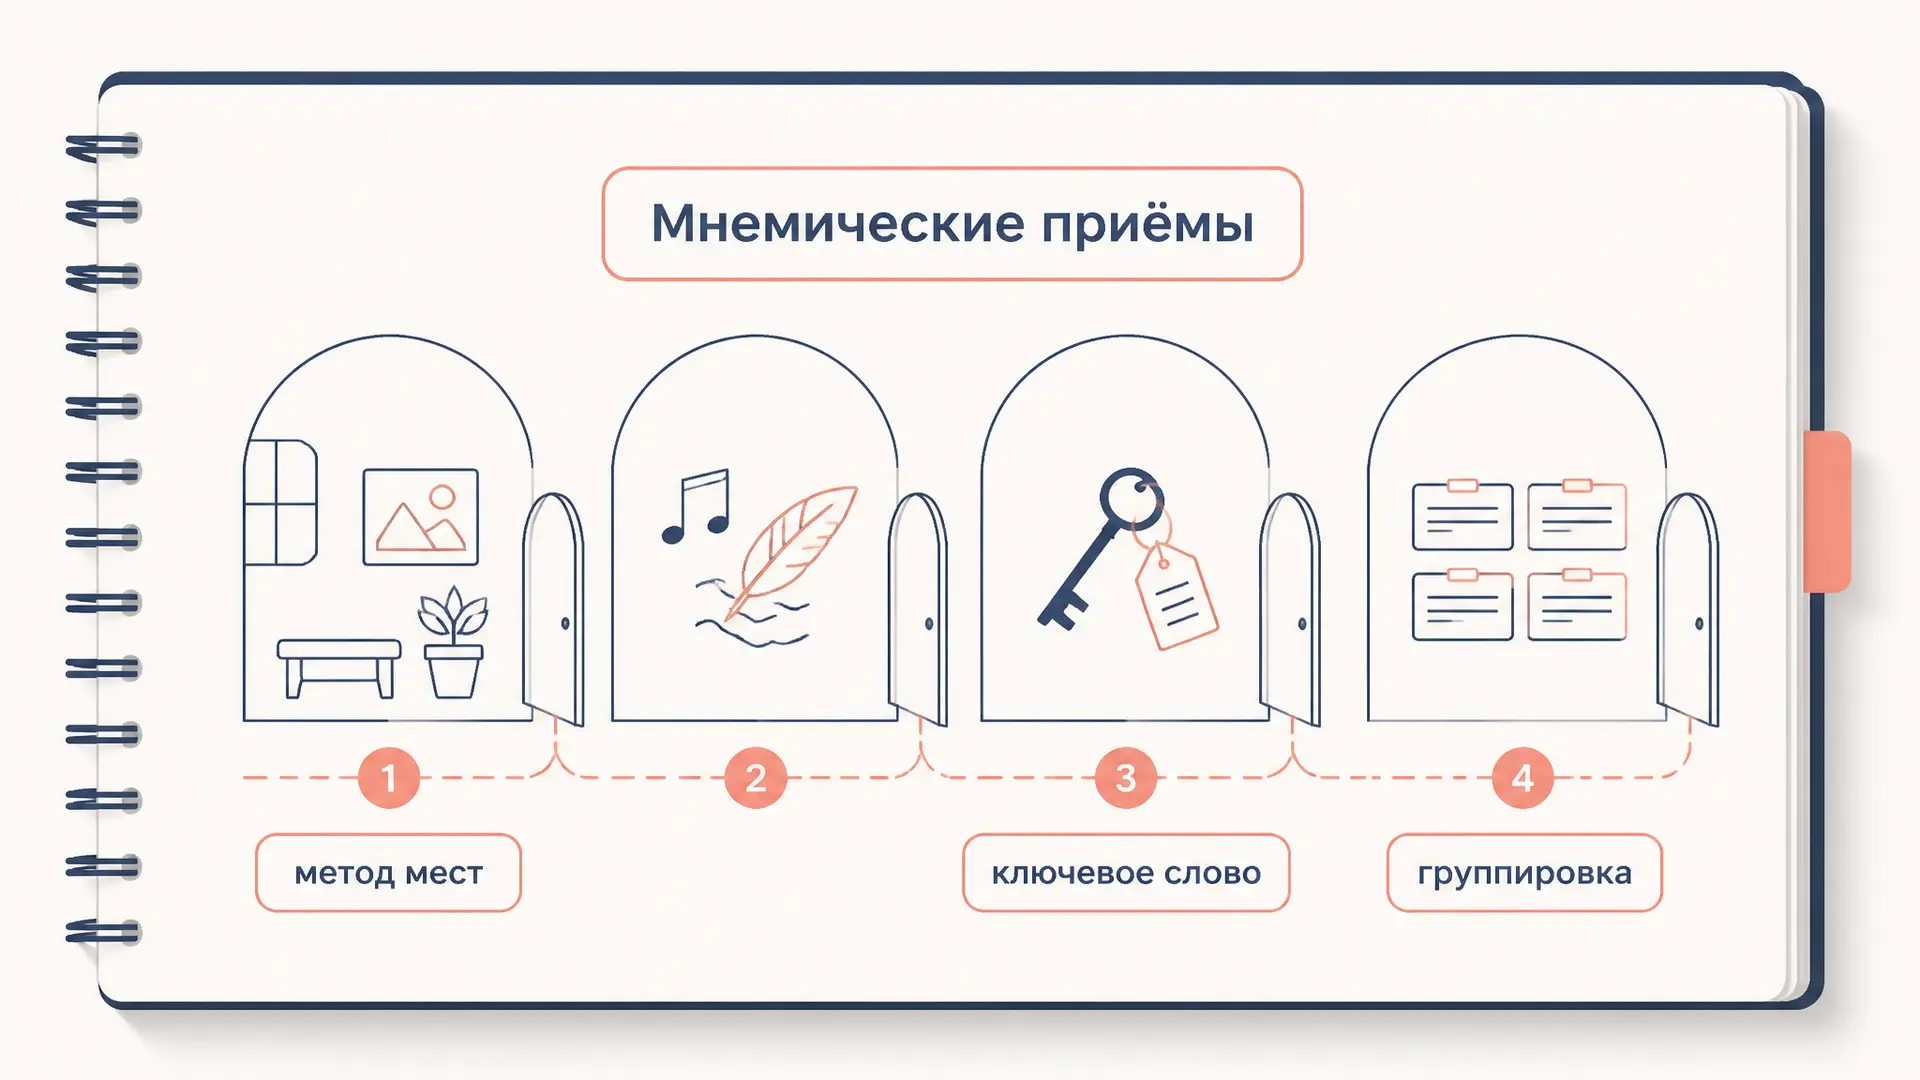
Мнемические приёмы: методы и примеры
Мнемические приёмы для учёбы: метод мест, рифмы, акронимы, ключевые слова, группировка и опорные пункты. Как выбрать технику и не заменить ею понимание.