Показательное распределение: формулы и свойства
Показательное (или экспоненциальное) распределение описывает время ожидания события, которое может произойти в любой момент с одной и той же «готовностью»: отказ электронного элемента, приход заявки в очередь, распад ядра, звонок в колл-центр. У него единственный параметр - интенсивность, то есть среднее число событий за единицу времени. Всё остальное - плотность, функция распределения, среднее, дисперсия, медиана - выражается через одной-двумя формулами, и именно поэтому показательный закон стал рабочей моделью теории массового обслуживания и теории надёжности. Ниже разберём формулы, выведем моменты, докажем главное свойство закона и покажем, откуда он берётся в пуассоновском потоке. Начать удобно с калькулятора: задайте свою интенсивность и границы интервала и посмотрите, как меняются вероятности.
Плотность и функция показательного распределения
Непрерывная случайная величина распределена по показательному закону с параметром , если её плотность равна нулю при отрицательных значениях и убывающей экспоненте при неотрицательных:
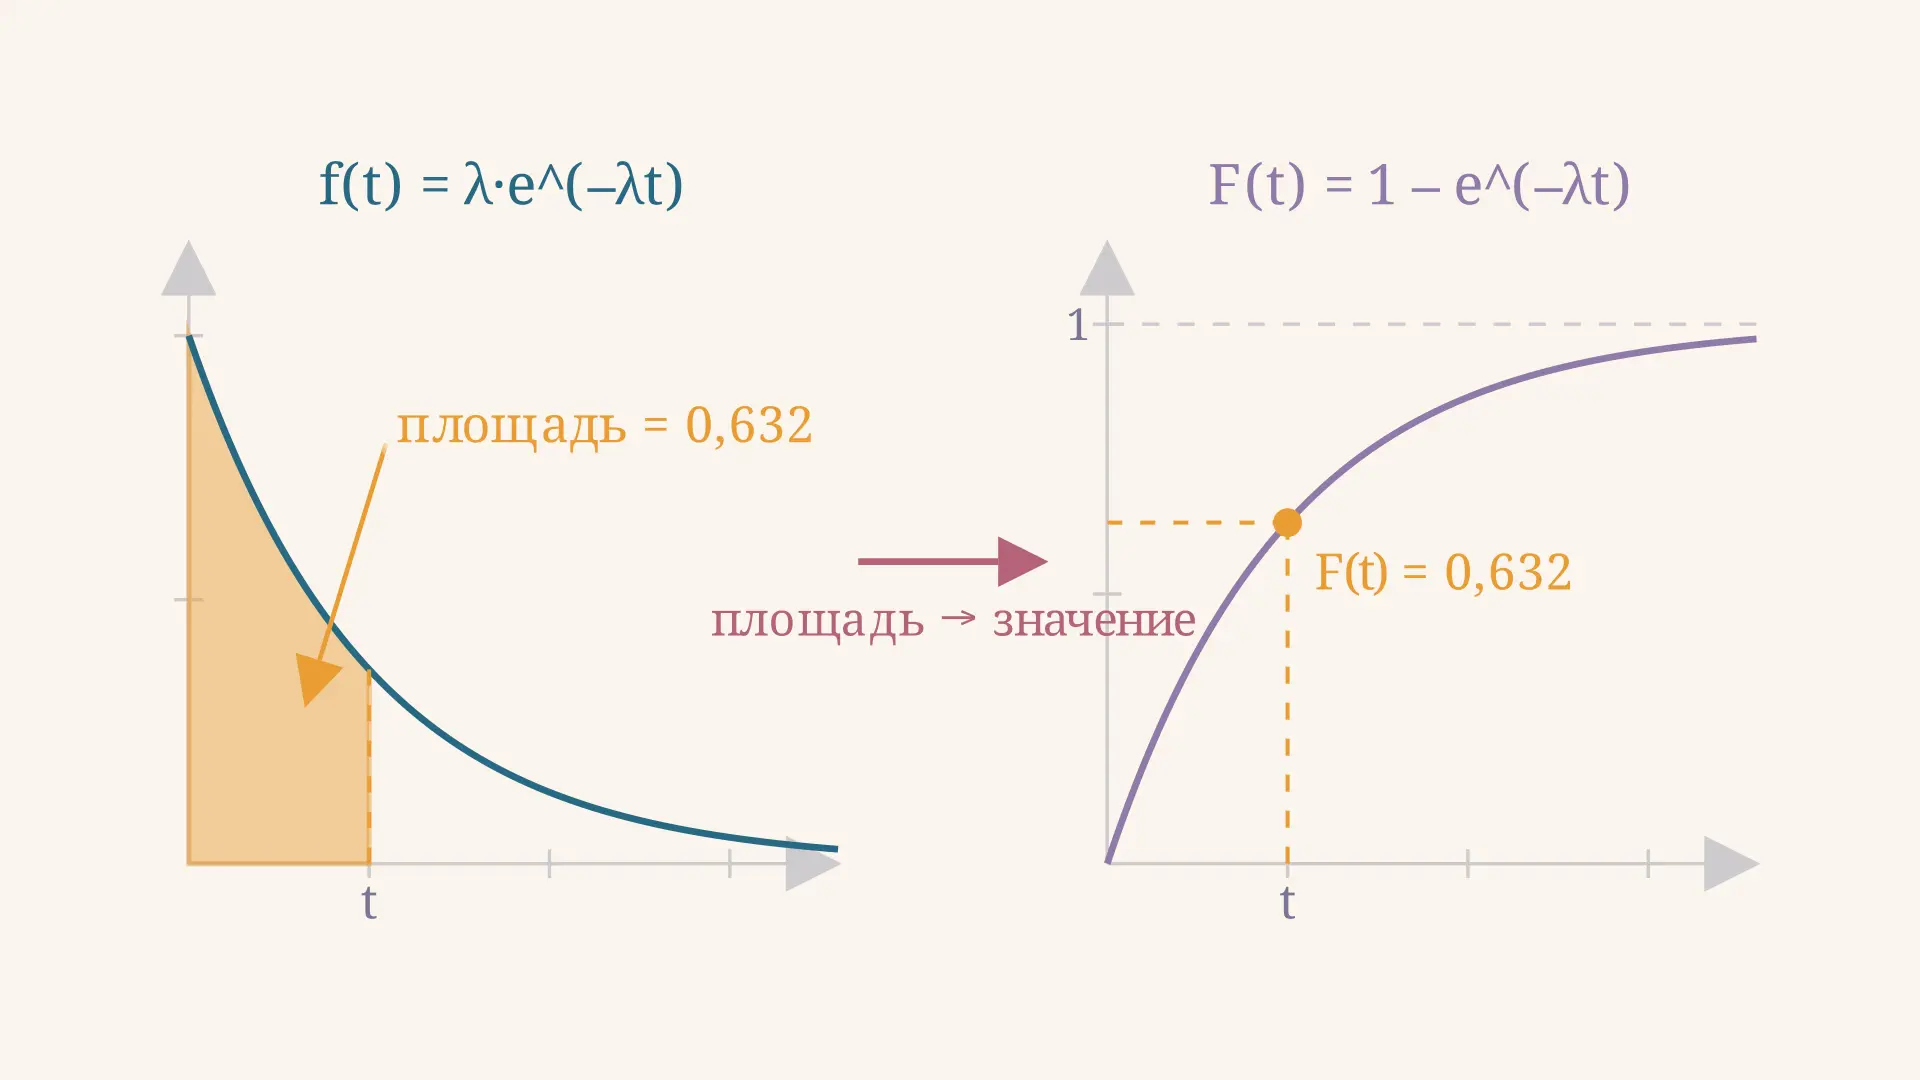
Интегрируя плотность, получаем функцию распределения - вероятность того, что событие произойдёт не позже момента :
Отсюда сразу следует вероятность «дожития» - того, что к моменту событие ещё не наступило:
Параметр работает как масштаб времени, а не как форма: при любом его значении кривая остаётся той же убывающей экспонентой, просто сжатой или растянутой по горизонтали. Чем больше интенсивность, тем выше старт и тем быстрее спад, то есть событие в среднем наступает раньше. Никакой «горки», как у нормального закона, здесь нет: самые вероятные значения прижаты к нулю, и мода показательного распределения равна нулю. Если же интенсивность мала, кривая становится почти горизонтальной на рабочем участке, и поведение величины приближается к равномерному распределению на не слишком длинном отрезке.
Эти три формулы покрывают почти все задачи. Вероятность попадания на отрезок считается как разность значений функции распределения: . Обратите внимание на геометрический смысл: площадь под плотностью от нуля до равна значению - это общее свойство непрерывных величин, подробнее о нём в разборе функции распределения случайной величины. Полная площадь под кривой равна единице, поэтому множитель перед экспонентой обязателен: без него нормировка нарушится.
Математическое ожидание и дисперсия
Математическое ожидание находится интегрированием по частям:
Для дисперсии нужен второй момент , после чего
Получается редкая ситуация: среднее и среднее квадратическое отклонение совпадают, а коэффициент вариации всегда равен единице. Это удобный экспресс-тест: если у выборки разброс заметно меньше среднего, показательная модель ей не подходит.
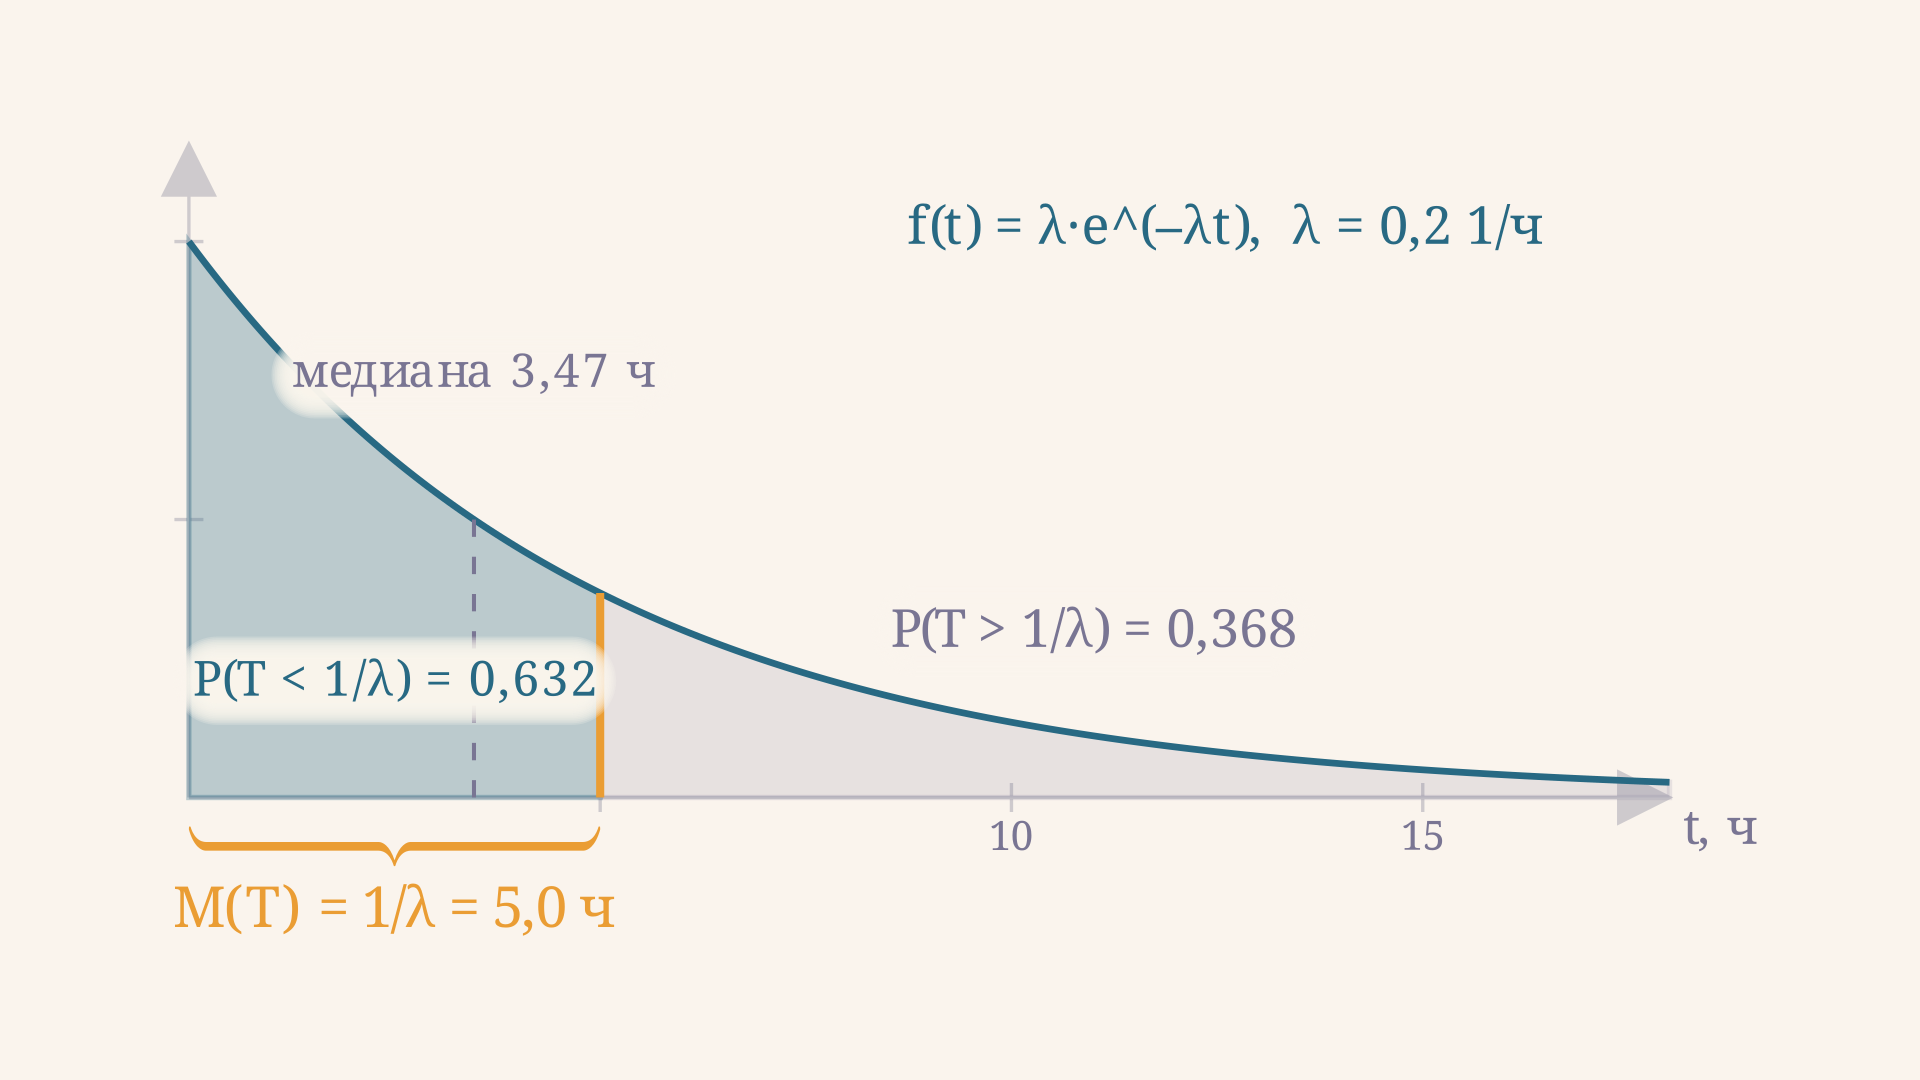
Медиана же меньше среднего. Из условия получаем . Среднее делит площадь под плотностью не пополам, а в отношении к : подстановка даёт . То есть «дожить» до среднего значения удаётся лишь примерно в 37 % случаев - типичный источник ошибок в задачах.
Из формулы среднего следует и способ оценки параметра по данным. Если есть выборка наработок , то оценка максимального правдоподобия для интенсивности равна обратному выборочному среднему: . Считать что-то сложнее здесь не нужно: вся информация о показательном законе содержится в сумме наблюдений, поэтому среднее арифметическое и есть достаточная статистика.
Свойство отсутствия последействия
Главное свойство показательного распределения формулируется так: если событие ещё не произошло за время , то распределение оставшегося времени ожидания такое же, как у «свежей» величины. Формально
Доказательство занимает две строки. По определению условной вероятности и с учётом того, что событие влечёт :
Экспонента - единственная непрерывная функция, у которой отношение не зависит от , поэтому показательное распределение является единственным непрерывным законом без последействия (в дискретном случае этим свойством обладает геометрическое распределение). На практике это значит, что «проработавший 500 часов» прибор с точки зрения модели ничем не отличается от нового: износ она не описывает.
Интуитивно свойство звучит парадоксально: кажется, что чем дольше ждёшь автобус, тем ближе он должен быть. Но в простейшем потоке «часы» каждый раз запускаются заново, и ожидание не накапливается. Наблюдаемая величина при этом, конечно, падает с ростом - именно поэтому важно различать безусловную вероятность дожить до момента и условную вероятность прожить ещё при уже отработанных . Первая убывает, вторая постоянна.
Связь с простейшим пуассоновским потоком
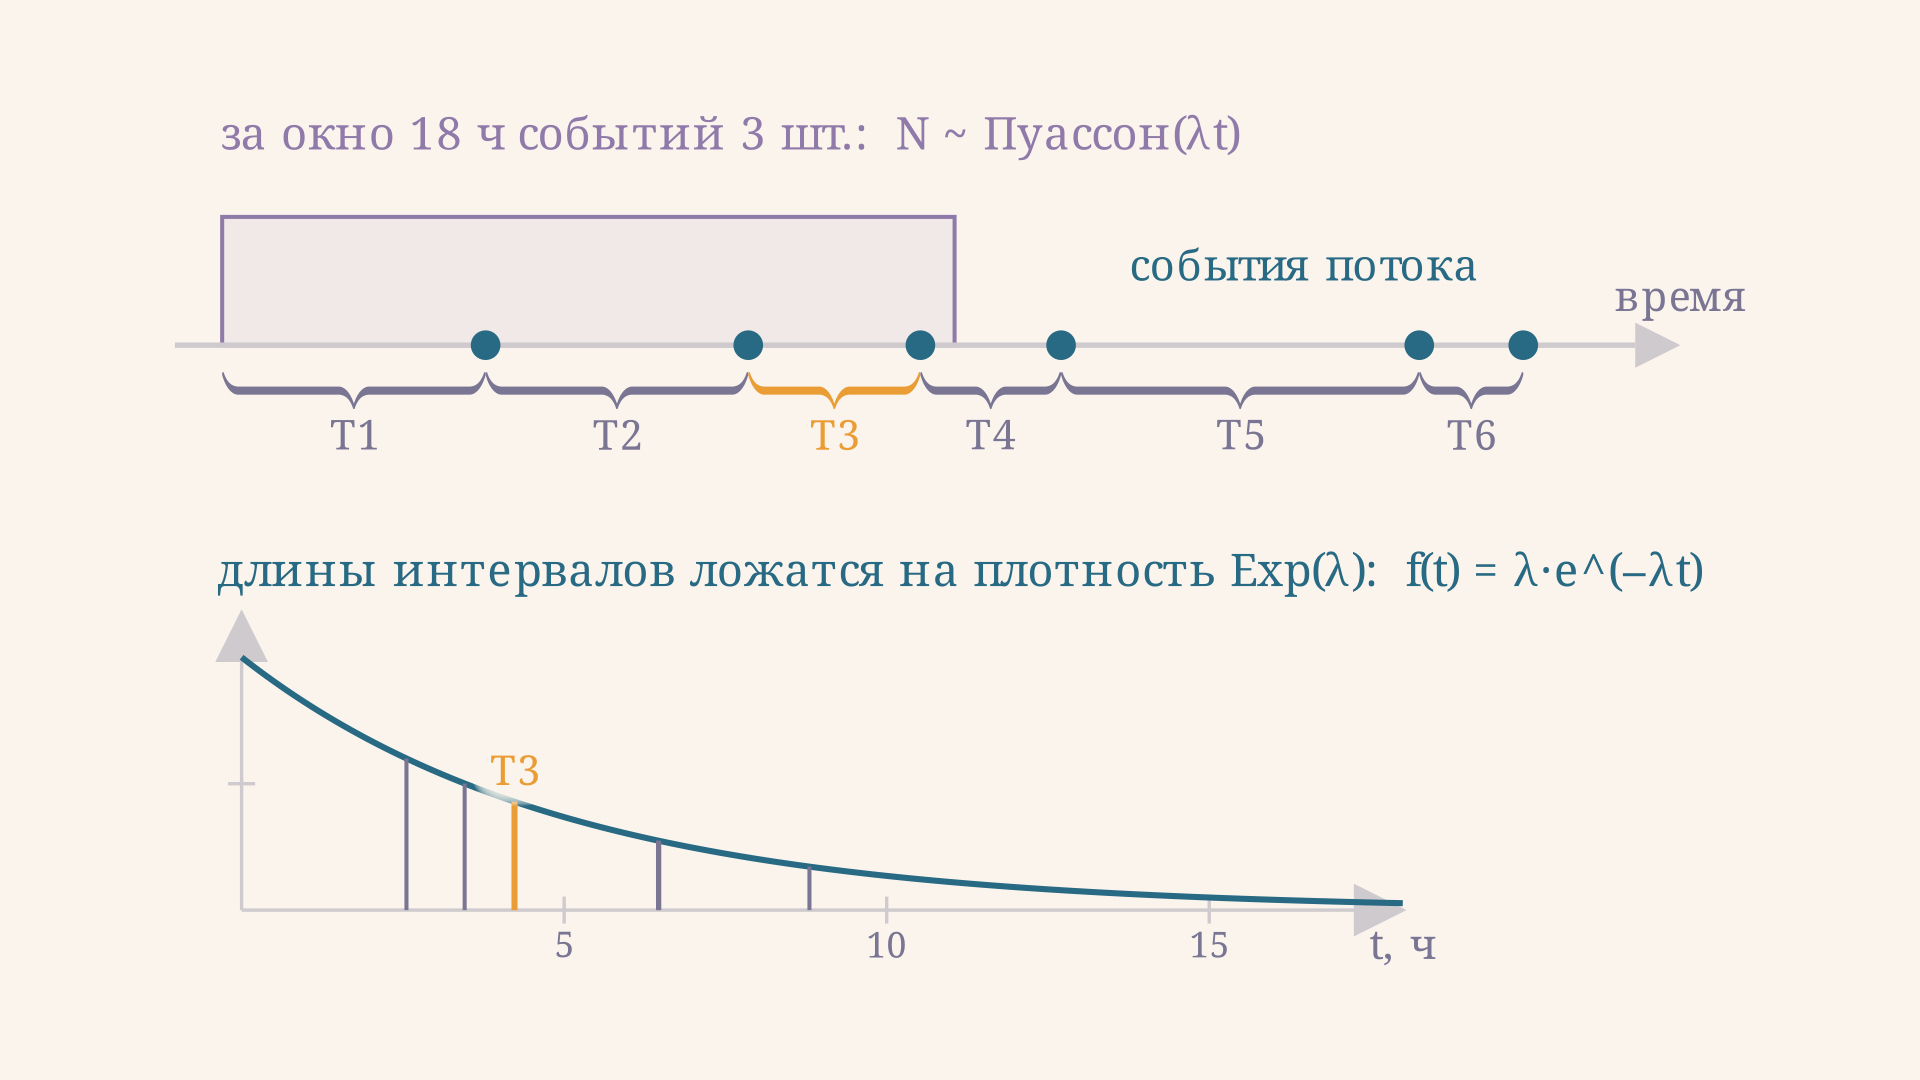
Простейшим называют поток событий, обладающий тремя свойствами: стационарность (интенсивность постоянна), ординарность (события не наступают парами) и отсутствие последействия (непересекающиеся промежутки независимы). Для такого потока число событий за время подчиняется закону Пуассона с параметром :
Подставим . Отсутствие событий на отрезке длины означает ровно то, что интервал до ближайшего события больше :
а это и есть функция дожития показательного закона. Получается пара «одно и то же с двух сторон»: считаем события - работает распределение Пуассона, измеряем промежутки между ними - работает показательное распределение с тем же . Отсюда же берётся удобное правило пересчёта: если известно среднее число вызовов в час, то - это оно и есть, а среднее время между вызовами равно .
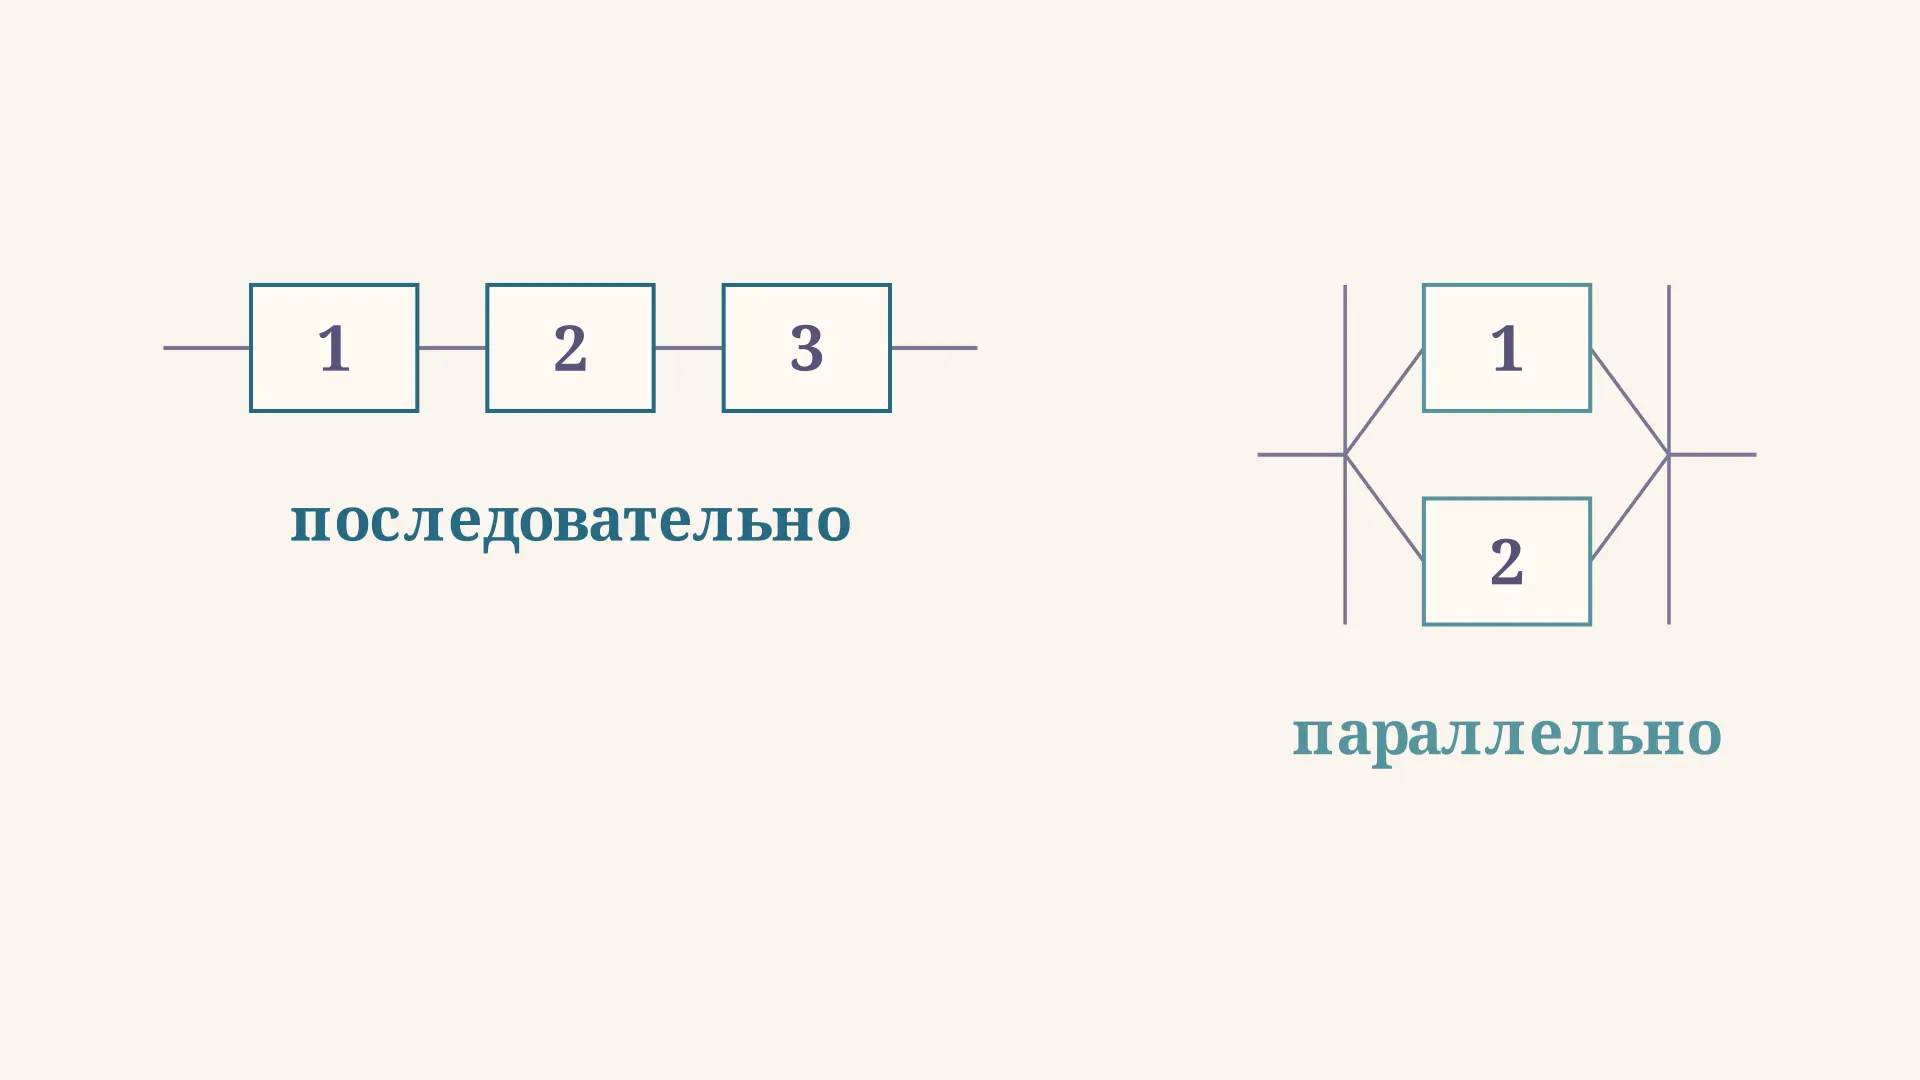
Из этой связи вытекают два часто нужных факта. Сумма независимых показательных величин с одинаковым даёт распределение Эрланга (частный случай гамма-распределения) со средним - это время до -го события потока. А минимум независимых показательных величин с параметрами снова показателен, причём с суммарной интенсивностью . Второй факт и есть математическая основа расчёта последовательного соединения элементов: система выходит из строя по первому отказавшему элементу, а интенсивности отказов при этом просто складываются.
Показательный закон в теории надёжности
В надёжности показательное распределение - модель «внезапных» отказов, не связанных со старением. Вероятность безотказной работы за время равна функции дожития , а интенсивность отказов оказывается постоянной:
Именно постоянная интенсивность соответствует среднему, «рабочему» участку кривой отказов, где приработка уже закончилась, а износ ещё не начался; о том, как ведут себя другие участки, написано в разборе плотности распределения наработки до отказа. Средняя наработка до отказа равна .
Пример: у элемента 1/ч. Тогда средняя наработка ч, а вероятность проработать 1000 часов . При малых работает линейное приближение , которым удобно оценивать надёжность в уме.
Часто требуется обратная задача: найти время, к которому надёжность упадёт до заданного уровня . Логарифмируя равенство , получаем гамма-процентную наработку . Для того же элемента уровень достигается через ч, то есть в десять раз раньше средней наработки. Разрыв между «средним» и «гарантированным» ресурсом у показательного закона всегда велик, и путать эти две характеристики в отчётах нельзя.
Пример расчёта с числами
Пусть время безотказной работы распределено показательно с 1/ч. Тогда:
Вероятность отказа в промежутке от 3 до 8 часов:
Вероятность проработать больше 10 часов: . Медиана ч. А теперь проверим отсутствие последействия на числах: , и ровно столько же даёт для нового прибора. Пошаговый разбор такой задачи с другими данными есть в разделе «Задачи»: как найти показательное распределение.
Частые ошибки
- Путают и среднее время. Если в условии дано «среднее время между отказами 5 часов», то 1/ч, а не 5. Проверяйте размерность: у она обратна времени.
- Считают медиану равной среднему. У несимметричного закона это неверно: медиана примерно на 30 % меньше среднего .
- Подставляют отрицательные . Плотность слева от нуля равна нулю, поэтому при , а не .
- Смешивают единицы. Если задана в 1/ч, а интервал в минутах, показатель степени будет неверным: приводите всё к одной единице до подстановки.
- Применяют модель к износу. Стареющие узлы (подшипники, аккумуляторы) имеют растущую интенсивность отказов, для них берут распределение Вейбулла, а не показательное.
FAQ
Как найти параметр , если известно только среднее? По формуле . Если дана дисперсия, то , поскольку . Если известна вероятность дожития до какого-то момента, выражается логарифмированием: .
Почему , а не ? Потому что распределение скошено вправо: у него длинный тонкий хвост из редких больших значений, который «перетягивает» среднее вправо от медианы. Половина значений лежит левее , а среднее находится заметно правее этой точки.
Когда показательную модель применять нельзя? Когда у процесса есть память: износ, обучение, накопление усталости, а также когда события приходят пачками (поток не ординарный). Признак несоответствия виден по выборке: если выборочное стандартное отклонение сильно отличается от выборочного среднего, коэффициент вариации не равен единице, и показательный закон отвергается.
Коротко
Показательное распределение задаётся единственным параметром : плотность , функция распределения , вероятность дожития . Среднее и стандартное отклонение равны , дисперсия , медиана . Главное свойство - отсутствие последействия: прошедшее время ожидания не влияет на распределение оставшегося, и именно из него вырастает связь с простейшим пуассоновским потоком, где интервалы между событиями показательны, а их число за окно пуассоновское. В теории надёжности это даёт постоянную интенсивность отказов и вероятность безотказной работы - модель внезапных отказов, которая перестаёт работать там, где начинается износ.
Читайте также
Структурная схема надёжности: расчёт системы
Структурная схема надёжности показывает, как элементы системы соединены при отказе: последовательно или параллельно. Разбираем формулы расчёта вероятности безотказной работы и резервирования.
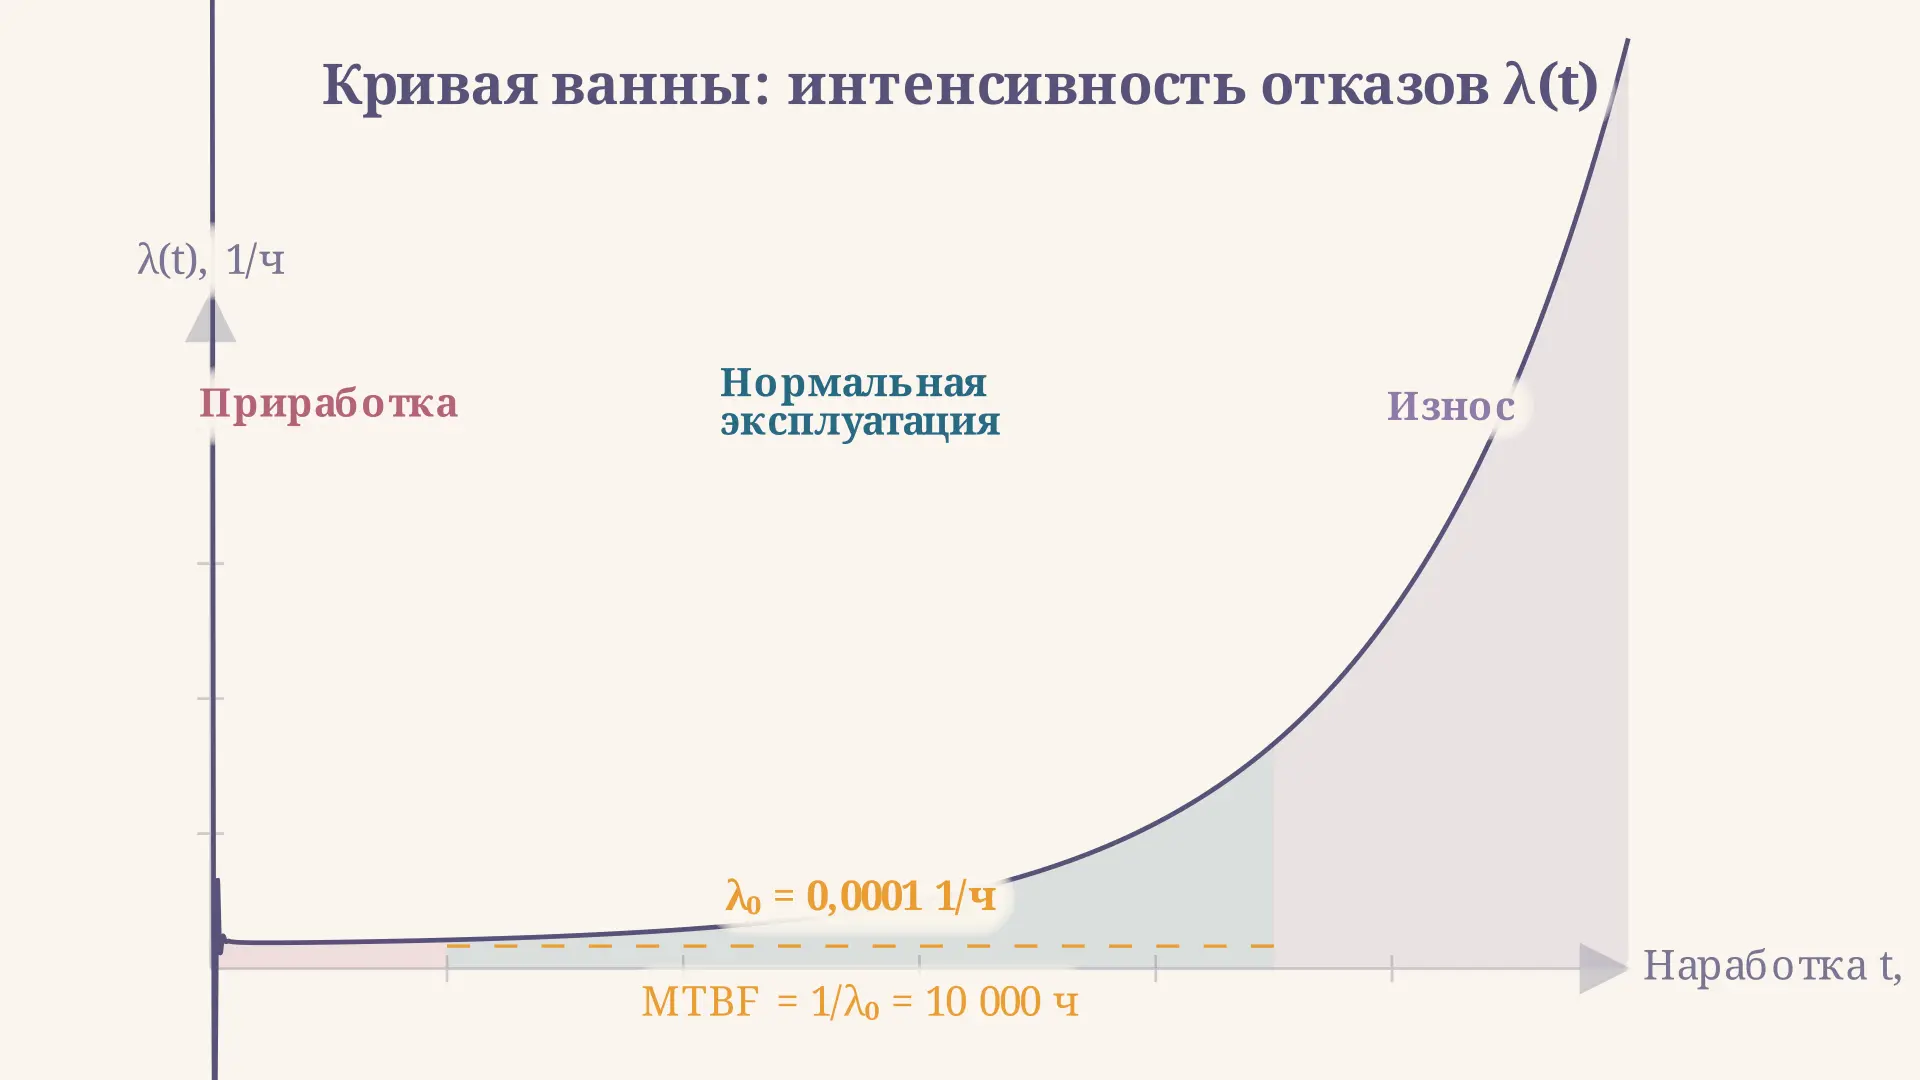
Интенсивность отказов: расчёт и кривая ванны
Как рассчитать интенсивность отказов lambda, MTBF и вероятность безотказной работы P(t). Модель ванны, три участка, формулы и типовые задачи с решениями.
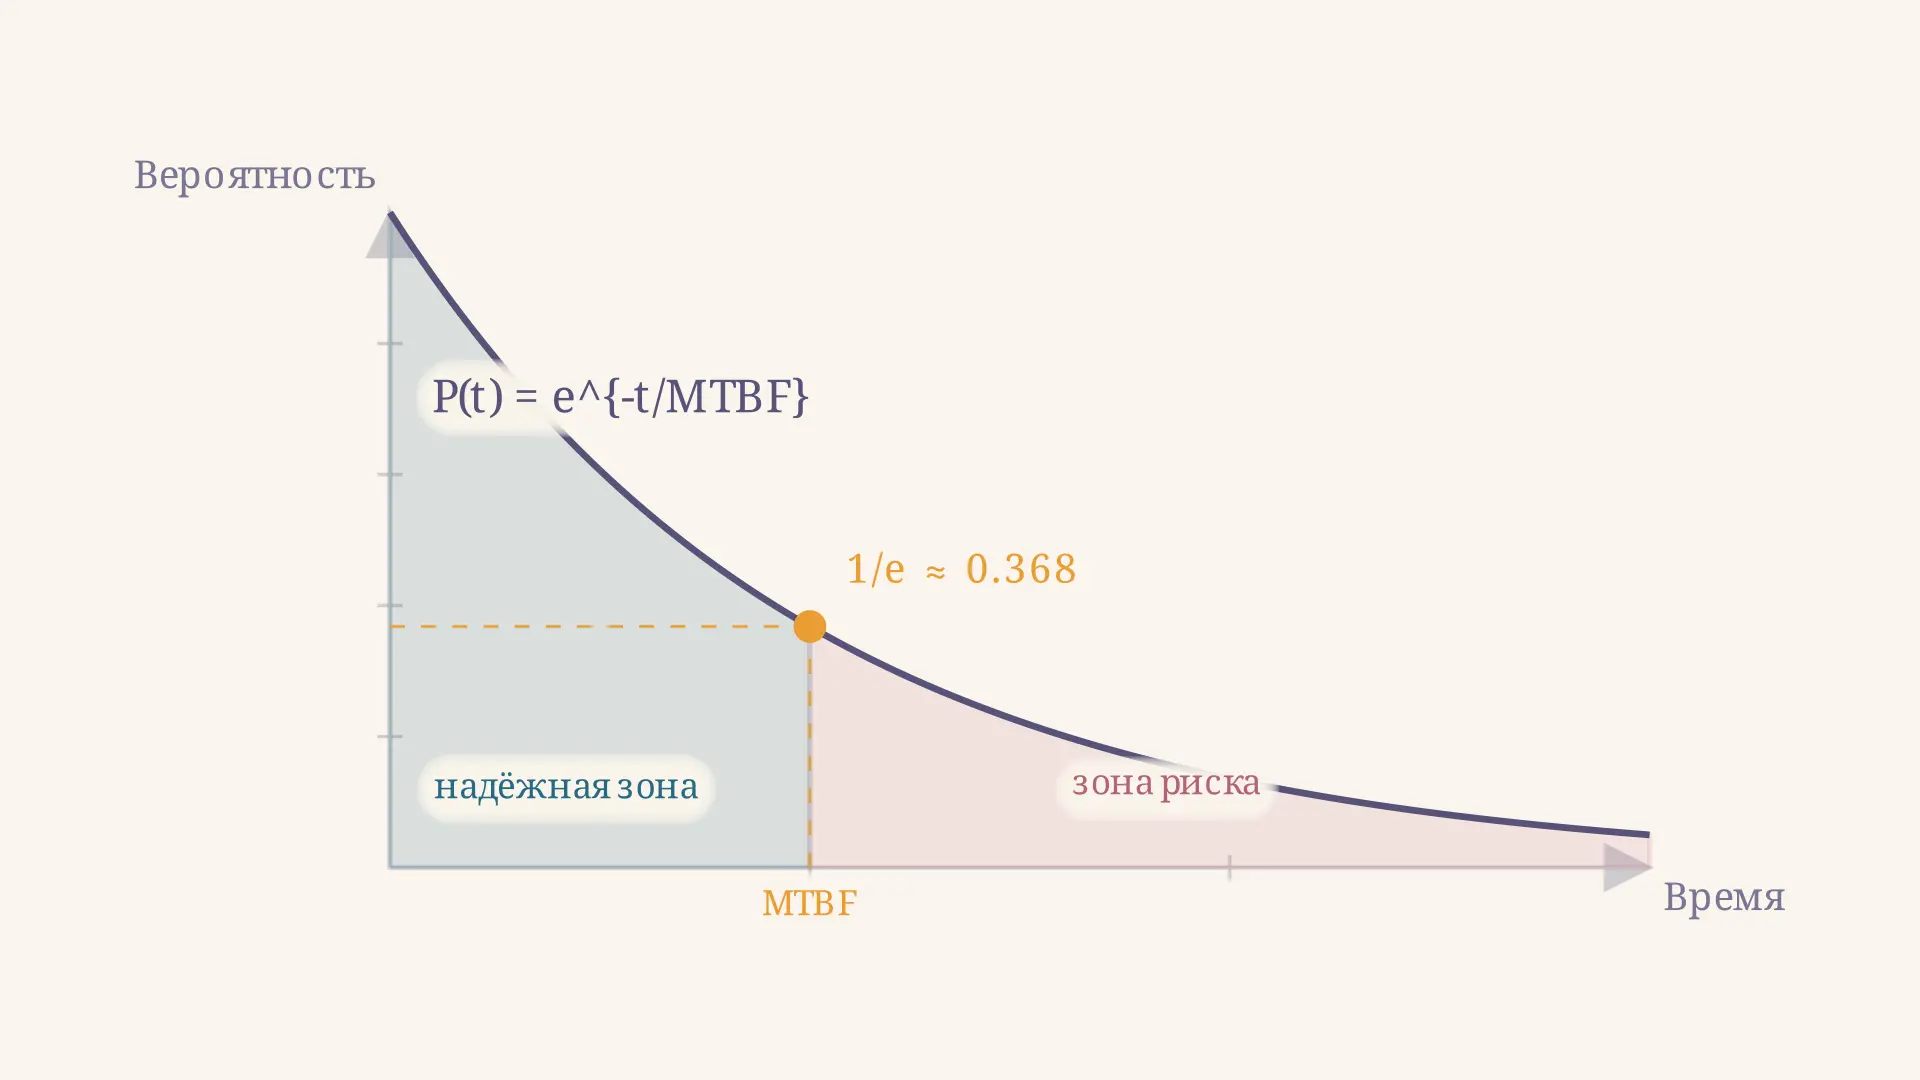
Наработка на отказ: формула расчёта MTBF
Как рассчитать наработку на отказ MTBF: формула P(t) = exp(-t/MTBF), обратный расчёт по надёжности, интенсивность отказов, разбор задач и частые ошибки.
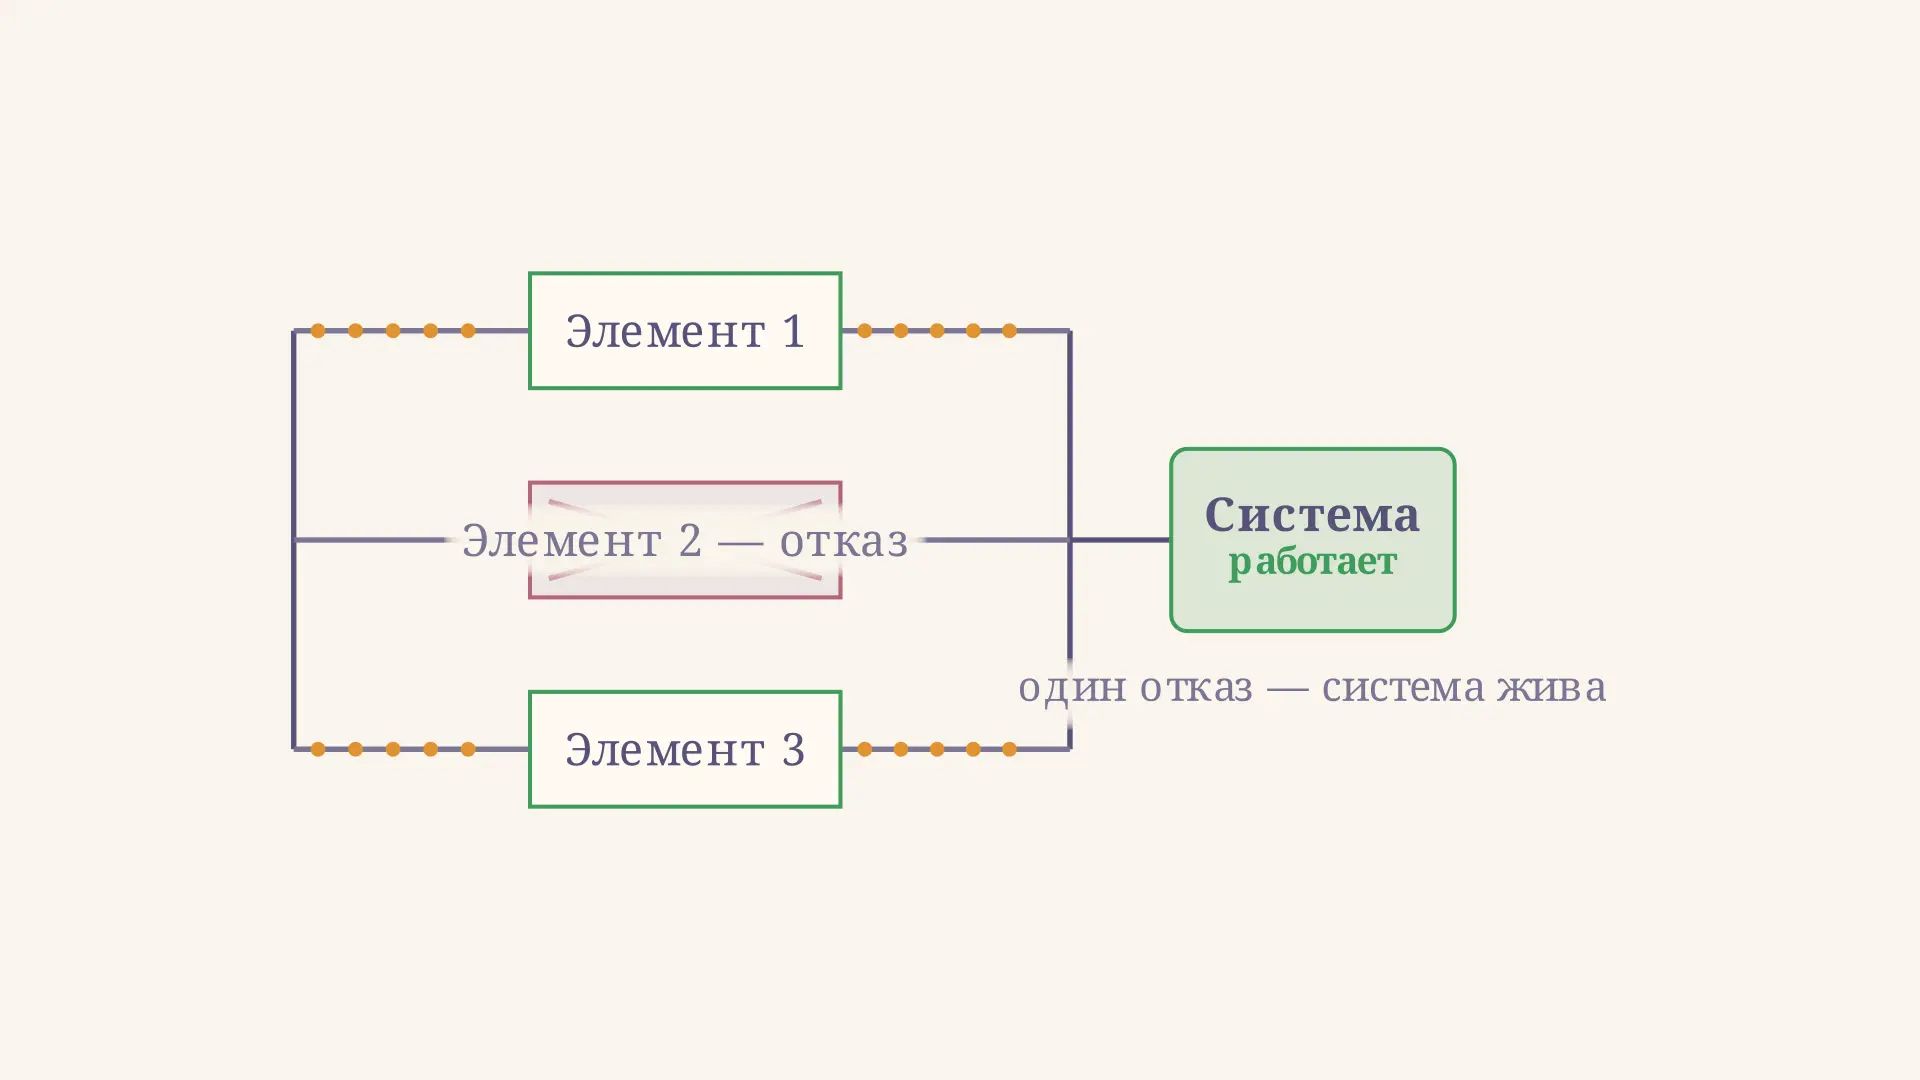
Параллельное соединение: надёжность системы
Как считать надёжность параллельной системы: формула P_sys = 1 - произведение(1 - P_i), рост среднего времени безотказной работы при резервировании и разбор типовых задач с числами.
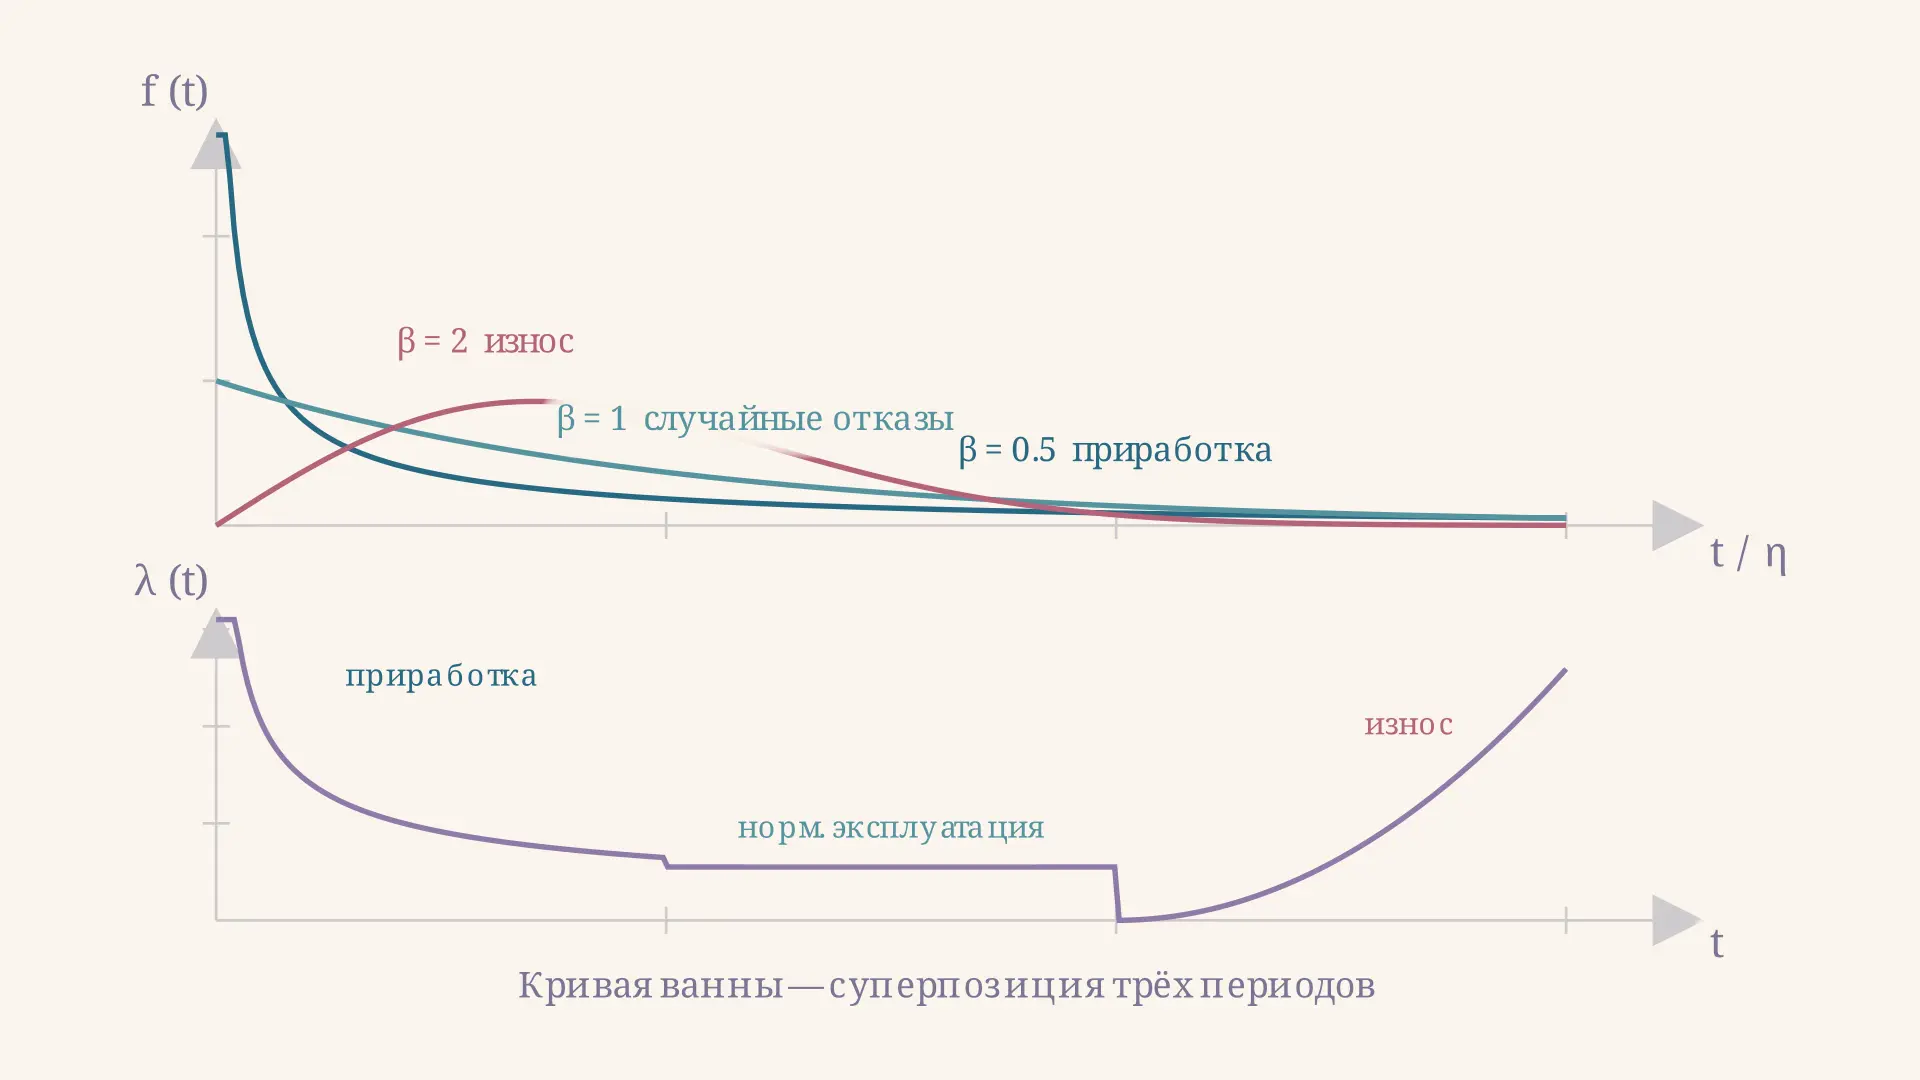
Плотность распределения наработки до отказа
Плотность распределения наработки до отказа: экспоненциальный закон и Вейбулл, формулы f(t), MTTF, интенсивность отказов, кривая ванны. Примеры расчётов для задач по теории надёжности.
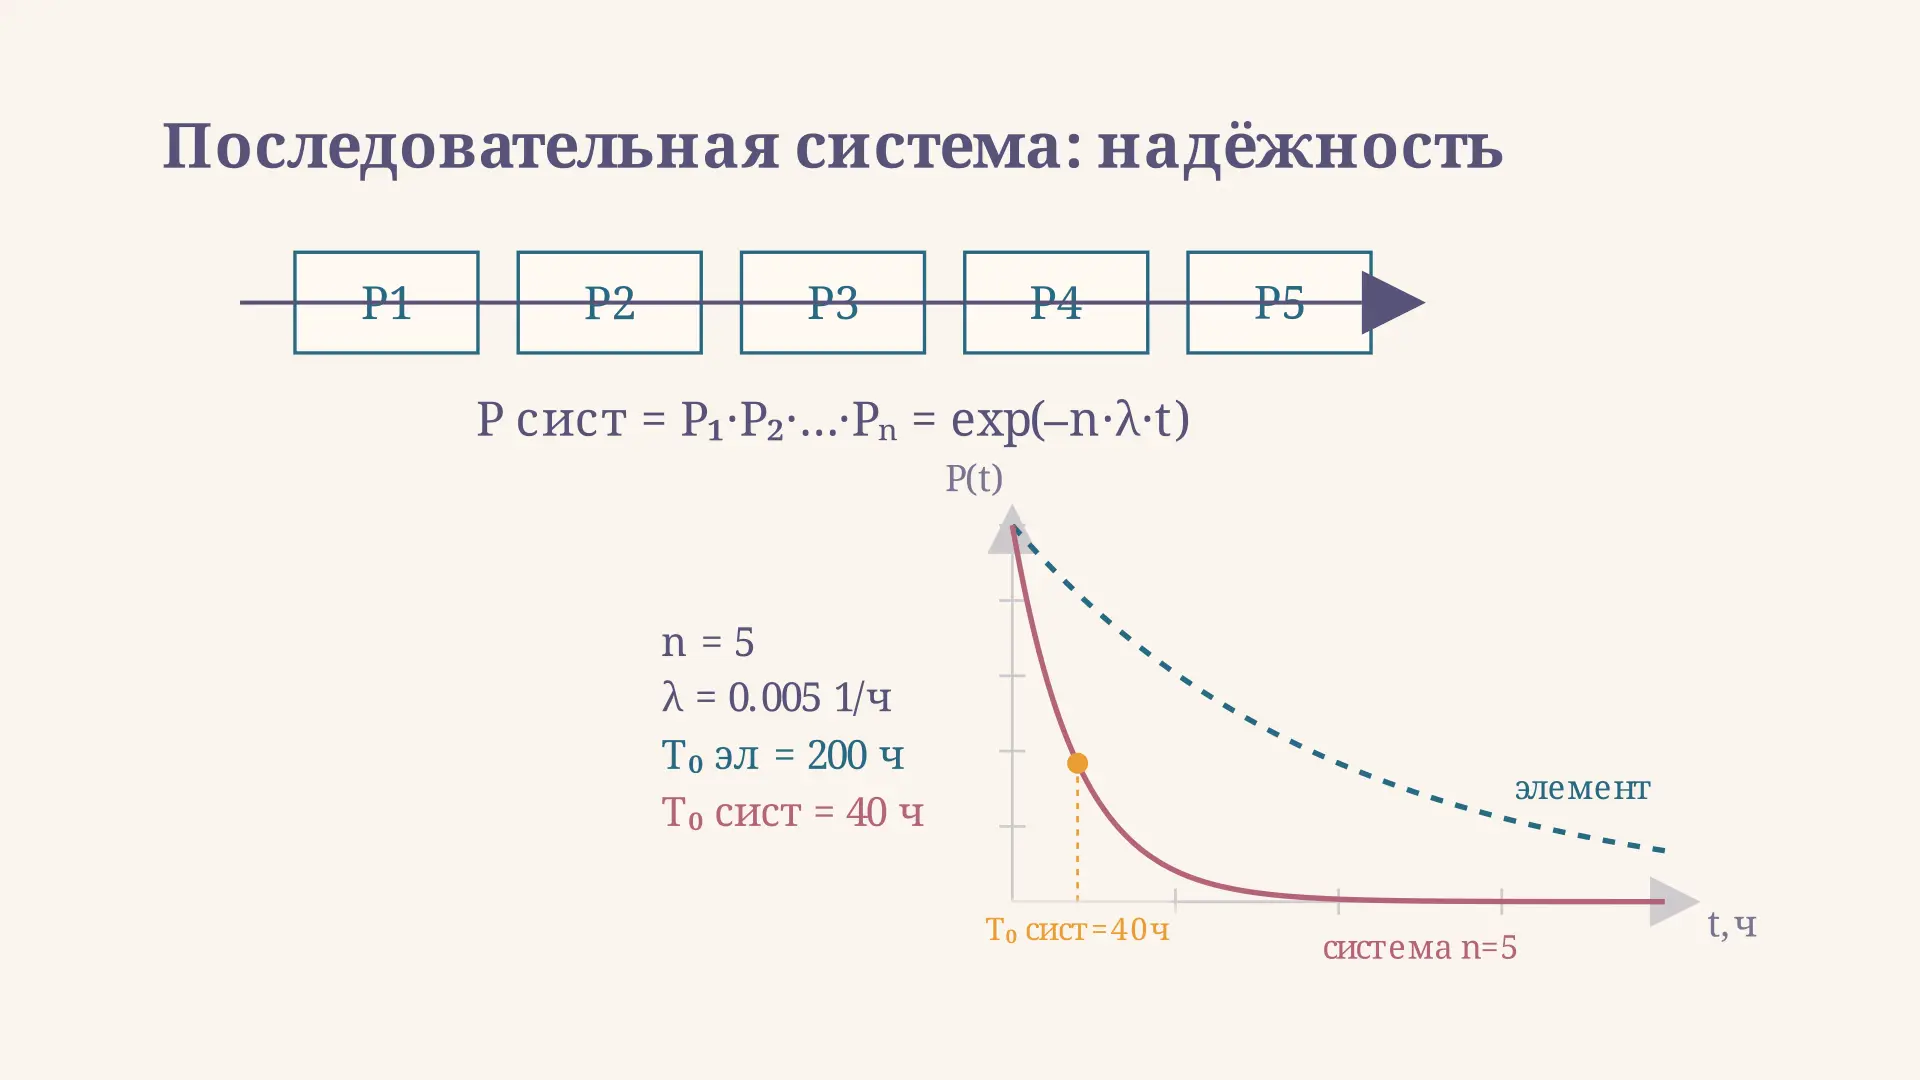
Последовательное соединение: надёжность системы
Как считать надёжность последовательной системы: формула P_sys = exp(-n*lambda*t), среднее время до отказа, влияние числа элементов и типичные задачи с разбором.