Оконные функции SQL: примеры запросов и рамок
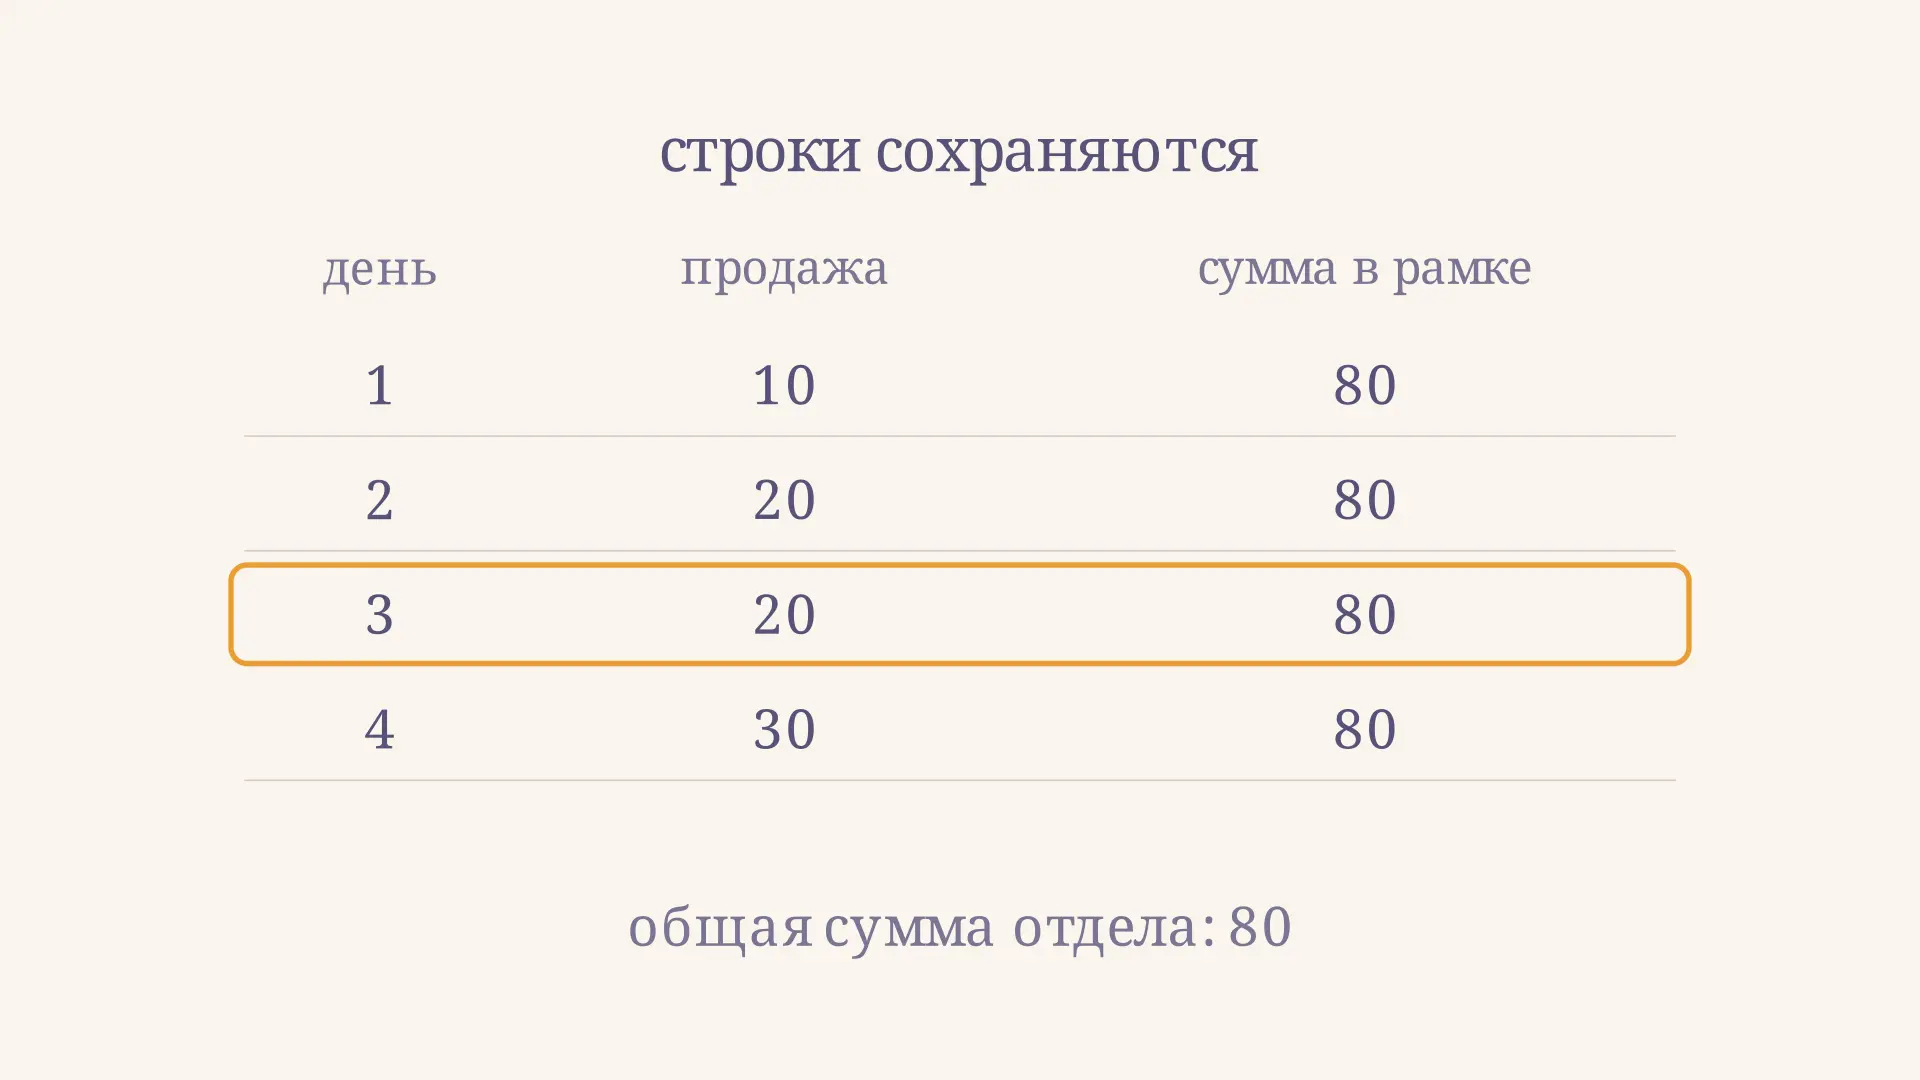
Оконные функции SQL вычисляют значение по связанным строкам и добавляют его к каждой строке результата. Они помогают сравнить продажу с итогом региона, пронумеровать товары внутри категории или получить предыдущий показатель без соединения таблицы с самой собой. Начнём с небольшой таблицы, а затем разберём порядок, границы рамки и типичные ловушки. В интерактивном примере можно изменить ширину рамки и увидеть, как пересчитывается сумма по дням.
Что сохраняет оконная функция
Обычный запрос с GROUP BY сводит группу к одной строке. Оконный вызов, напротив, рассчитывает показатель для каждой входной строки и сохраняет её в ответе. Сначала представим таблицу sales: id уникален, day - дата, amount - сумма продажи в условных единицах.
| id | region | day | amount |
|---|---|---|---|
| 1 | Север | 2026-01-01 | 10 |
| 2 | Север | 2026-01-02 | 20 |
| 3 | Север | 2026-01-03 | 20 |
| 4 | Север | 2026-01-04 | 30 |
| 5 | Юг | 2026-01-01 | 15 |
| 6 | Юг | 2026-01-02 | 25 |
Сумма Севера равна 80, Юга - 40. Следующий запрос вернёт шесть строк и рядом с каждой суммой продажи покажет итог её региона:
SELECT id, region, day, amount,
       SUM(amount) OVER (PARTITION BY region) AS region_total
FROM sales
ORDER BY region, day, id;
Для первых четырёх строк region_total равен 80, для двух остальных - 40. OVER превращает агрегат в оконный вызов, а PARTITION BY определяет раздел: здесь это все строки одного региона. В статье об агрегатных функциях SQL разобрано свёртывание данных через GROUP BY; окно удобно, когда нужна и деталь, и итог рядом.
PARTITION BY и ORDER BY внутри OVER
Общая форма выглядит так: функция(...) OVER (PARTITION BY ... ORDER BY ... рамка). Раздел задаёт набор связанных строк, оконный ORDER BY - порядок внутри него, а рамка уточняет строки, доступные некоторым функциям для текущей позиции. Без PARTITION BY весь вход запроса образует один раздел.
Порядок внутри OVER и финальный ORDER BY решают разные задачи. Первый определяет, например, какая продажа предыдущая; второй управляет порядком вывода. Для воспроизводимого результата добавляйте уникальный ключ к сортировке, если даты могут повторяться: ORDER BY day, id. Сам по себе порядок строк таблицы не гарантирован. Эти принципы связаны с тем, как устроена реляционная модель данных.
Строки, отсеянные WHERE, окно уже не увидит. После объединения таблиц окно работает с получившимися строками, поэтому при соединении таблиц SQL сначала проверьте, не размножил ли JOIN продажи из-за нескольких совпадений. Оконная сумма честно сложит и такие дубликаты.
Нумерация и ранги при равных значениях
Пусть нужно расположить продажи Севера по убыванию суммы. У значений 30, 20, 20 и 10 результаты отличаются:
| amount | ROW_NUMBER | RANK | DENSE_RANK |
|---|---|---|---|
| 30 | 1 | 1 | 1 |
| 20 | 2 | 2 | 2 |
| 20 | 3 | 2 | 2 |
| 10 | 4 | 4 | 3 |
ROW_NUMBER присваивает каждой строке отдельный номер; RANK оставляет пропуск после ничьей, а DENSE_RANK не оставляет. Для стабильного номера у одинаковых сумм добавим id только в сортировку ROW_NUMBER. Если включить его и в сортировку рангов, уникальные идентификаторы перестанут быть равными по полному ключу, и ничья исчезнет.
SELECT id, amount,
       ROW_NUMBER() OVER (ORDER BY amount DESC, id) AS rn,
       RANK() OVER (ORDER BY amount DESC) AS rnk,
       DENSE_RANK() OVER (ORDER BY amount DESC) AS dense_rnk
FROM sales
WHERE region = 'Север'
ORDER BY amount DESC, id;
Для отдельных регионов вместо фильтра добавьте PARTITION BY region в каждое окно. Нумерация или ранг начнутся заново в каждом разделе. Сортировка важна и для алгоритмов вообще: в разборе пирамидальной сортировки показано, как порядок значений строится пошагово.
Накопительная сумма и скользящая рамка
Добавим к сумме порядок по дате и явно зададим рамку от начала раздела до текущей строки:
SELECT id, day, amount,
       SUM(amount) OVER (
         PARTITION BY region ORDER BY day, id
         ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
       ) AS running_total
FROM sales
ORDER BY region, day, id;
Для Севера суммы по порядку дней равны 10, 30, 50 и 80. Если нужна сумма текущей и одной предыдущей строки, замените границу на ROWS BETWEEN 1 PRECEDING AND CURRENT ROW. Тогда получим 10, 30, 40 и 50: в первый день предыдущей строки нет, поэтому в рамке только текущая.
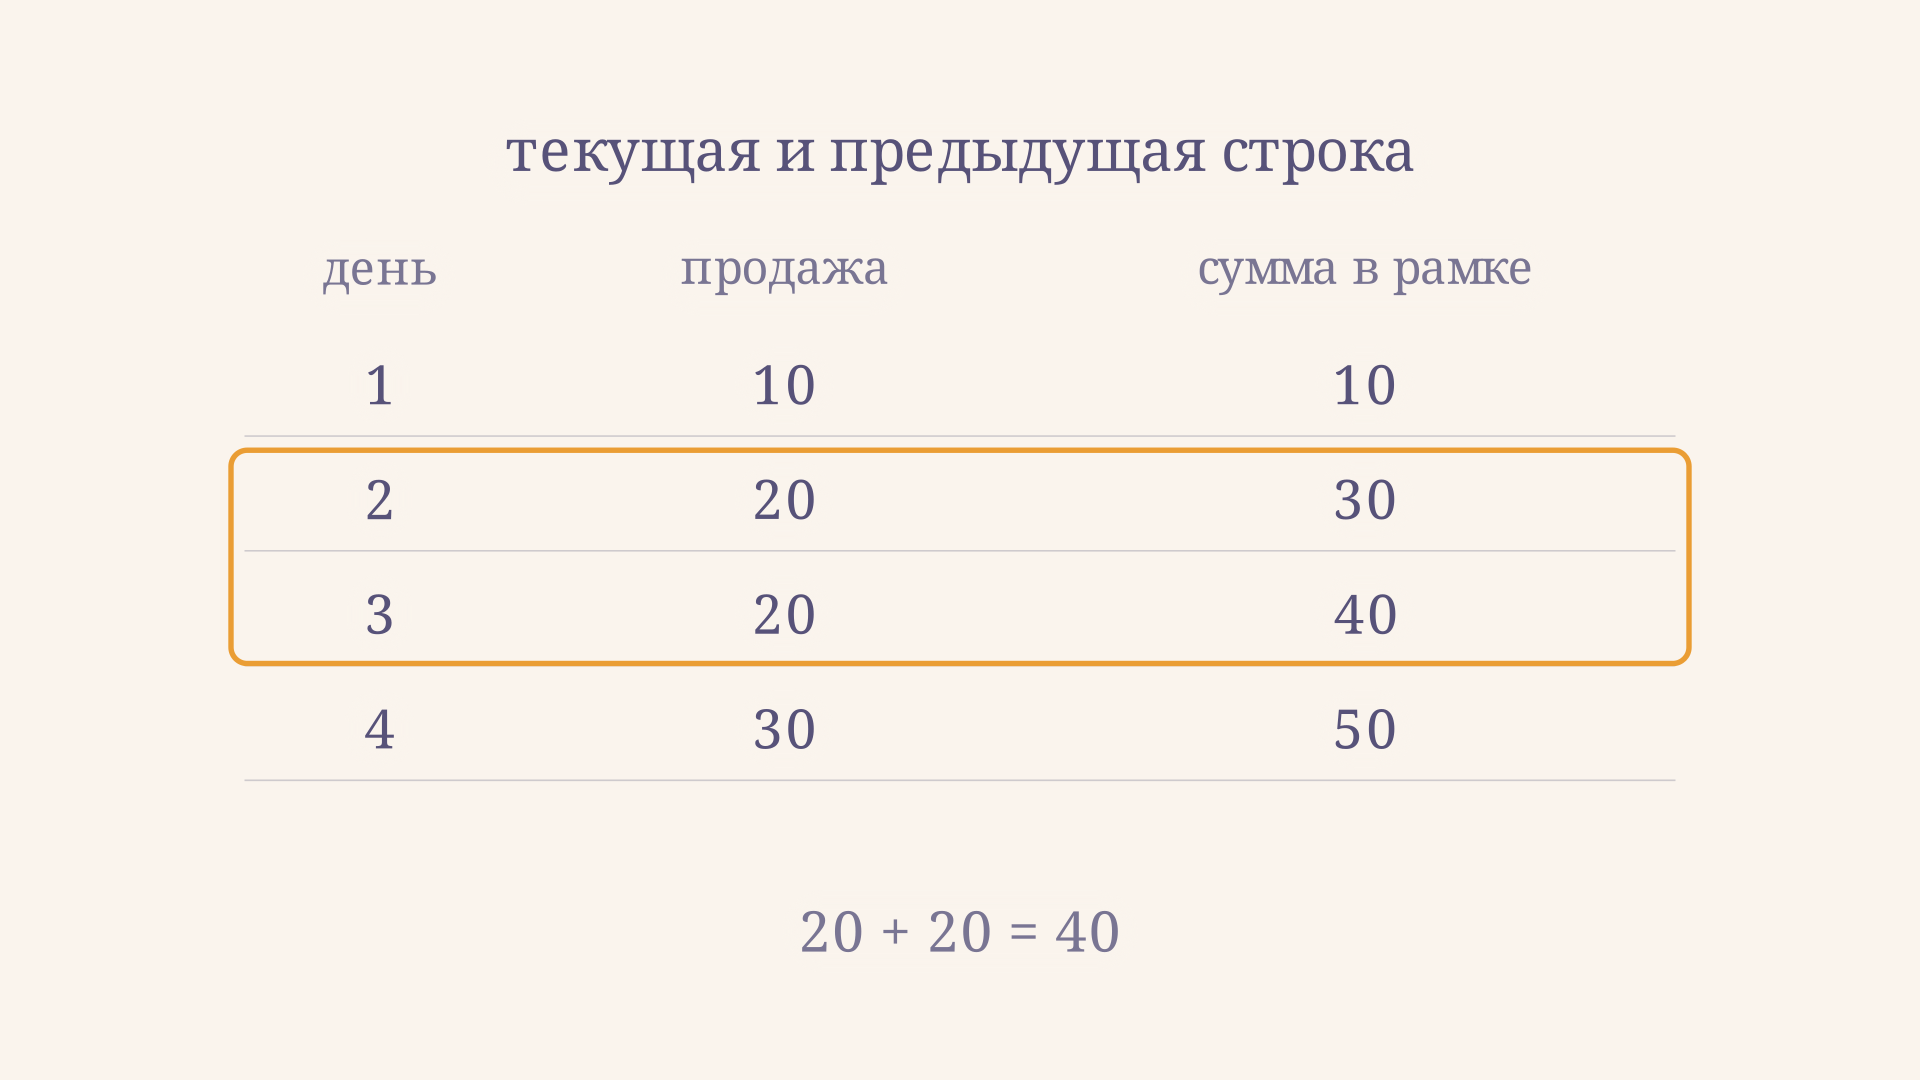
ROWS считает позиции в упорядоченном разделе, а не дни календаря: при пропуске дат предыдущая строка может относиться к более раннему дню. На интерактивной панели ширина 1 оставляет только текущую строку, ширина 4 включает до трёх предыдущих. Все вычисления относятся к Северу и тем же четырём значениям, что на схеме.
В PostgreSQL при оконном ORDER BY рамка по умолчанию включает все строки от начала раздела до текущей и её равных по ключу сортировки соседей. Например, для сумм 10, 20, 20, 30 запрос SUM(amount) OVER (ORDER BY amount) даст 10, 50, 50, 80. Явный ROWS и уникальный ключ снимают неоднозначность для построчного накопления. Подробнее правила описаны в руководстве PostgreSQL.
LAG: сравнение с предыдущей строкой
LAG возвращает значение из предшествующей строки раздела. Сравним каждую продажу с предыдущей в том же регионе:
SELECT id, region, day, amount,
       LAG(amount) OVER (PARTITION BY region ORDER BY day, id) AS previous_amount,
       amount - LAG(amount) OVER (PARTITION BY region ORDER BY day, id) AS change
FROM sales
ORDER BY region, day, id;
Для Севера предыдущие значения: NULL, 10, 20, 20; изменения: NULL, 10, 0, 10. Первой строке не с чем сравниваться. LEAD аналогично обращается к следующей строке. Смещение и значение на случай отсутствия строки можно передать дополнительными аргументами; наличие предыдущей строки с настоящим NULL - отдельная ситуация. Полный список функций приведён в справочнике PostgreSQL.
Первые строки в каждой группе
Условие по оконному результату в PostgreSQL помещают во внешний запрос. Например, чтобы получить ровно две продажи с наибольшими суммами в каждом регионе:
WITH numbered AS (
  SELECT id, region, amount,
         ROW_NUMBER() OVER (
           PARTITION BY region ORDER BY amount DESC, id
         ) AS rn
  FROM sales
)
SELECT id, region, amount, rn
FROM numbered
WHERE rn <= 2
ORDER BY region, rn;
Для Севера это id 4 и 2: при равных 20 меньший id выбран раньше. Для Юга попадут обе строки, id 6 и 5. Если требуется включить всех участников ничьей на границе, используйте RANK по сумме без id внутри окна и учитывайте, что строк может оказаться больше двух. WHERE внутри подзапроса, напротив, исключил бы строки ещё до ранжирования.
Как проверить оконный запрос на своих данных
Прежде чем переносить шаблон в отчёт, сформулируйте смысл одной строки результата. Это может быть отдельный заказ, товар или уже рассчитанный итог за день. Затем выпишите, какие строки должны влиять на показатель именно для этой строки. Если ответ звучит как «все заказы этого клиента», нужен раздел по клиенту; если «текущий и два предыдущих заказа», дополнительно нужны порядок и рамка из трёх строк.
Проверьте ключи на маленьком примере с двумя разделами. Показатель последней строки первого раздела не должен перетекать в первый расчёт следующего. В нашем примере Юг начинается с 15, а не с 95: накопление начинается заново. Для данных с повторяющимися датами заранее решите, нужен ли детерминированный порядок отдельных заказов или одинаковая сумма для всех заказов за один день. Это разные постановки, и выбор влияет на сортировку и рамку.
Проверьте также крайние случаи: раздел из одной строки, одинаковые значения и пропущенные даты. У скользящей рамки в начале может быть меньше строк, чем заданный максимум; она не дополняется нулями автоматически. Для среднего это особенно заметно: AVG делит сумму на число непустых значений в фактической рамке. Если требуется среднее только при наличии всех трёх наблюдений, отдельно посчитайте COUNT(amount) в той же рамке и проверяйте условие во внешнем запросе.
Когда важна доля строки в общем итоге, можно разделить amount на оконную сумму региона. Убедитесь, что знаменатель не равен нулю, например используйте NULLIF для защиты деления; также учтите тип чисел, поскольку целочисленное деление в некоторых СУБД отбрасывает дробную часть. При необходимости явно приведите числитель к десятичному типу. Для продажи 30 из итоговых 80 доля составляет 0,375, или 37,5 %. Такой расчёт сохраняет видимость каждой продажи и её связи с итогом.
Частые ошибки
- Путать раздел и рамку. Раздел - регион целиком; рамка может включать лишь текущую и соседнюю строку.
- Ожидать от оконной сортировки порядка вывода. Добавляйте внешний
ORDER BY, когда порядок ответа важен. - Забывать о равных ключах. Явно выбирайте способ разрешения ничьей и проверяйте рамку по умолчанию.
- Фильтровать оконный результат в том же
WHERE. Сначала вычислите его в подзапросе или CTE, затем фильтруйте снаружи. - Считать строки после
JOINисходными продажами. Проверьте кратность совпадений до расчёта окна.
FAQ
Можно ли использовать несколько окон в одном запросе? Да. Каждое выражение OVER может задавать собственные раздел и порядок; можно также именовать общую спецификацию через WINDOW.
Чем отличается OVER () от GROUP BY? Пустой OVER использует весь доступный набор как один раздел и сохраняет строки. GROUP BY возвращает отдельную строку на группу.
Почему LAST_VALUE иногда возвращает текущую строку? Она смотрит на конец рамки, а не обязательно на конец раздела. При оконной сортировке рамка по умолчанию может заканчиваться у текущей строки и её равных соседей. Для конца раздела задайте рамку до UNBOUNDED FOLLOWING.
Коротко
Оконная функция добавляет расчёт к строкам, не сворачивая их сама. Сначала определите раздел, затем порядок и при необходимости рамку; отдельно задайте порядок итогового вывода. Проверяйте ничьи и фильтры на небольшом наборе данных, прежде чем применять запрос к большой таблице.
Читайте также
SQL соединения таблиц: типы JOIN и число строк
Разбираем соединение таблиц в SQL на строках: условие ON, отличие INNER JOIN от LEFT, RIGHT и FULL, откуда берутся NULL и почему фильтр в WHERE ломает внешнее соединение.
Агрегатные функции SQL: COUNT, SUM, AVG и GROUP BY
Как работают агрегатные функции SQL: COUNT, SUM, AVG, MIN и MAX, группировка GROUP BY, порядок выполнения запроса, разница HAVING и WHERE и поведение NULL внутри агрегата.
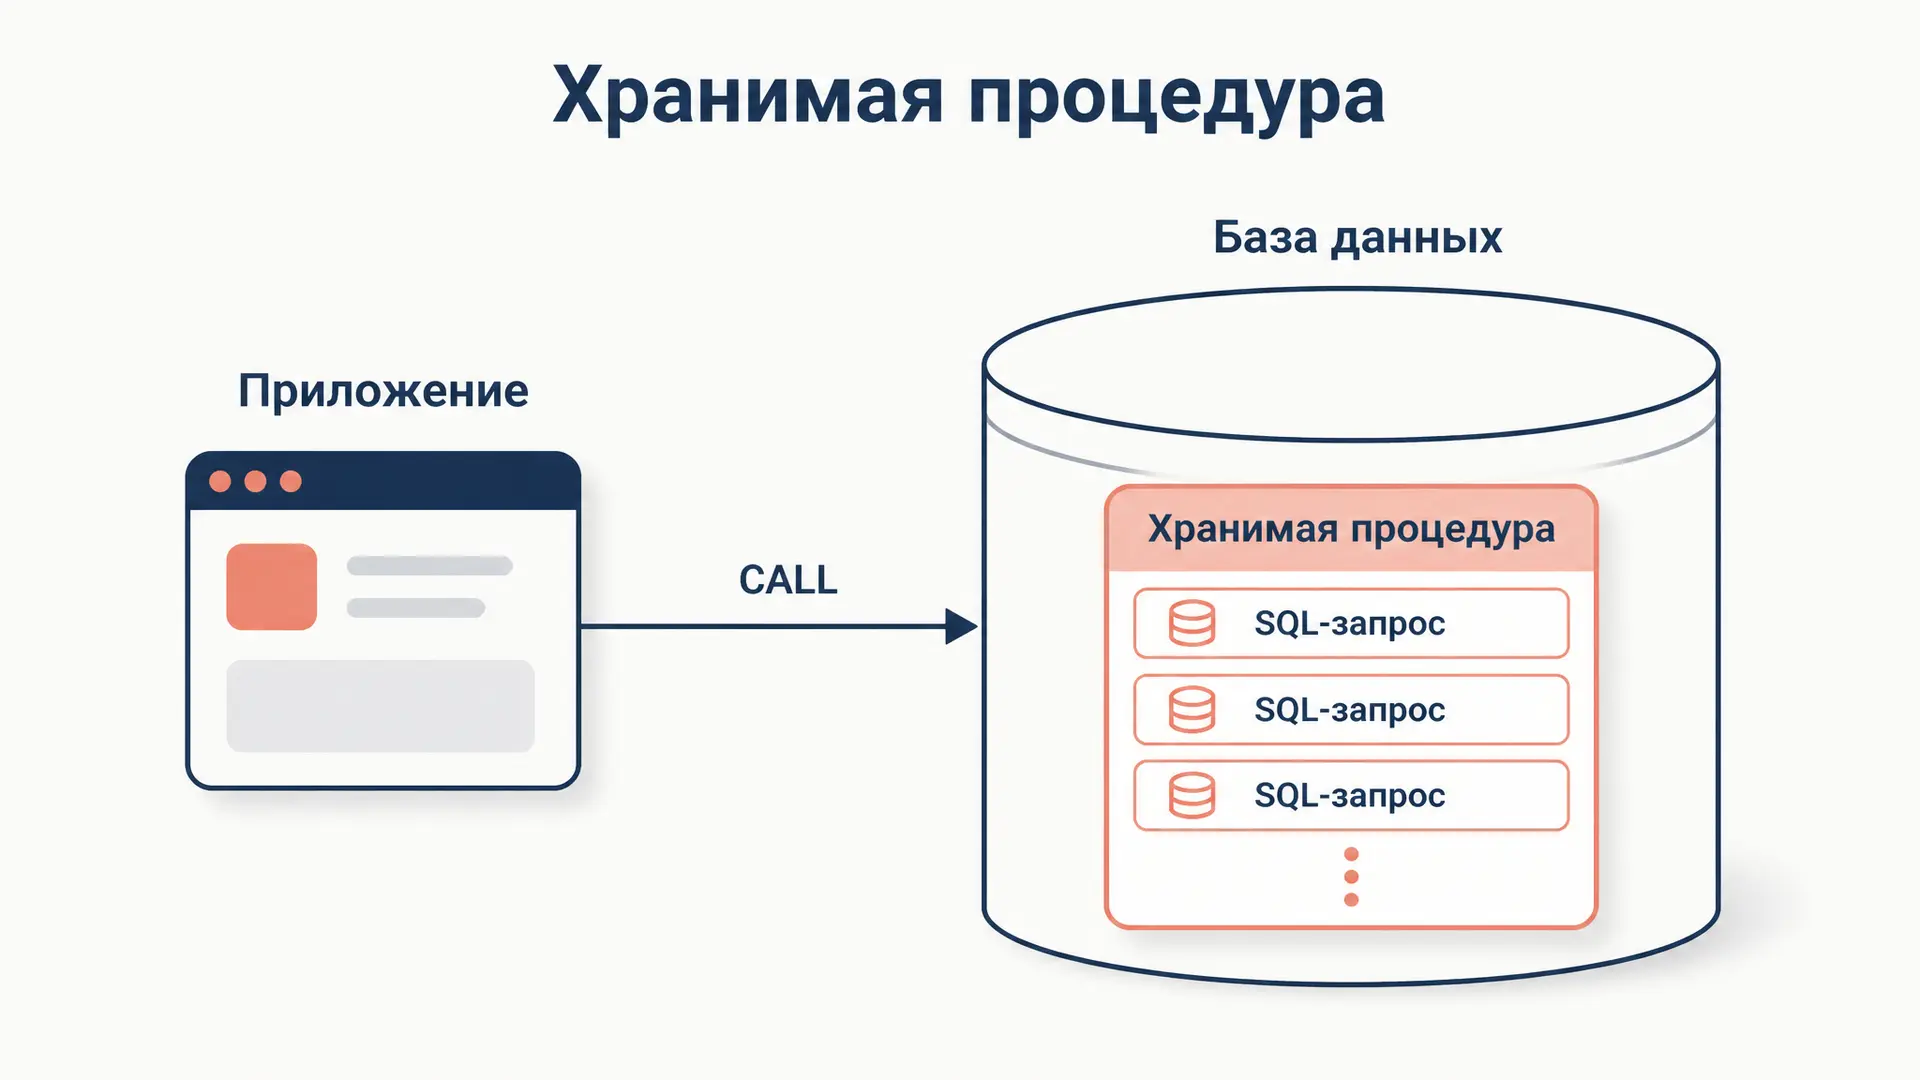
Хранимые процедуры в базе данных: зачем нужны и как писать
Хранимые процедуры в базе данных простыми словами: что это, синтаксис CREATE PROCEDURE, параметры IN OUT, отличие от функций и триггеров, плюсы и минусы, примеры на SQL.
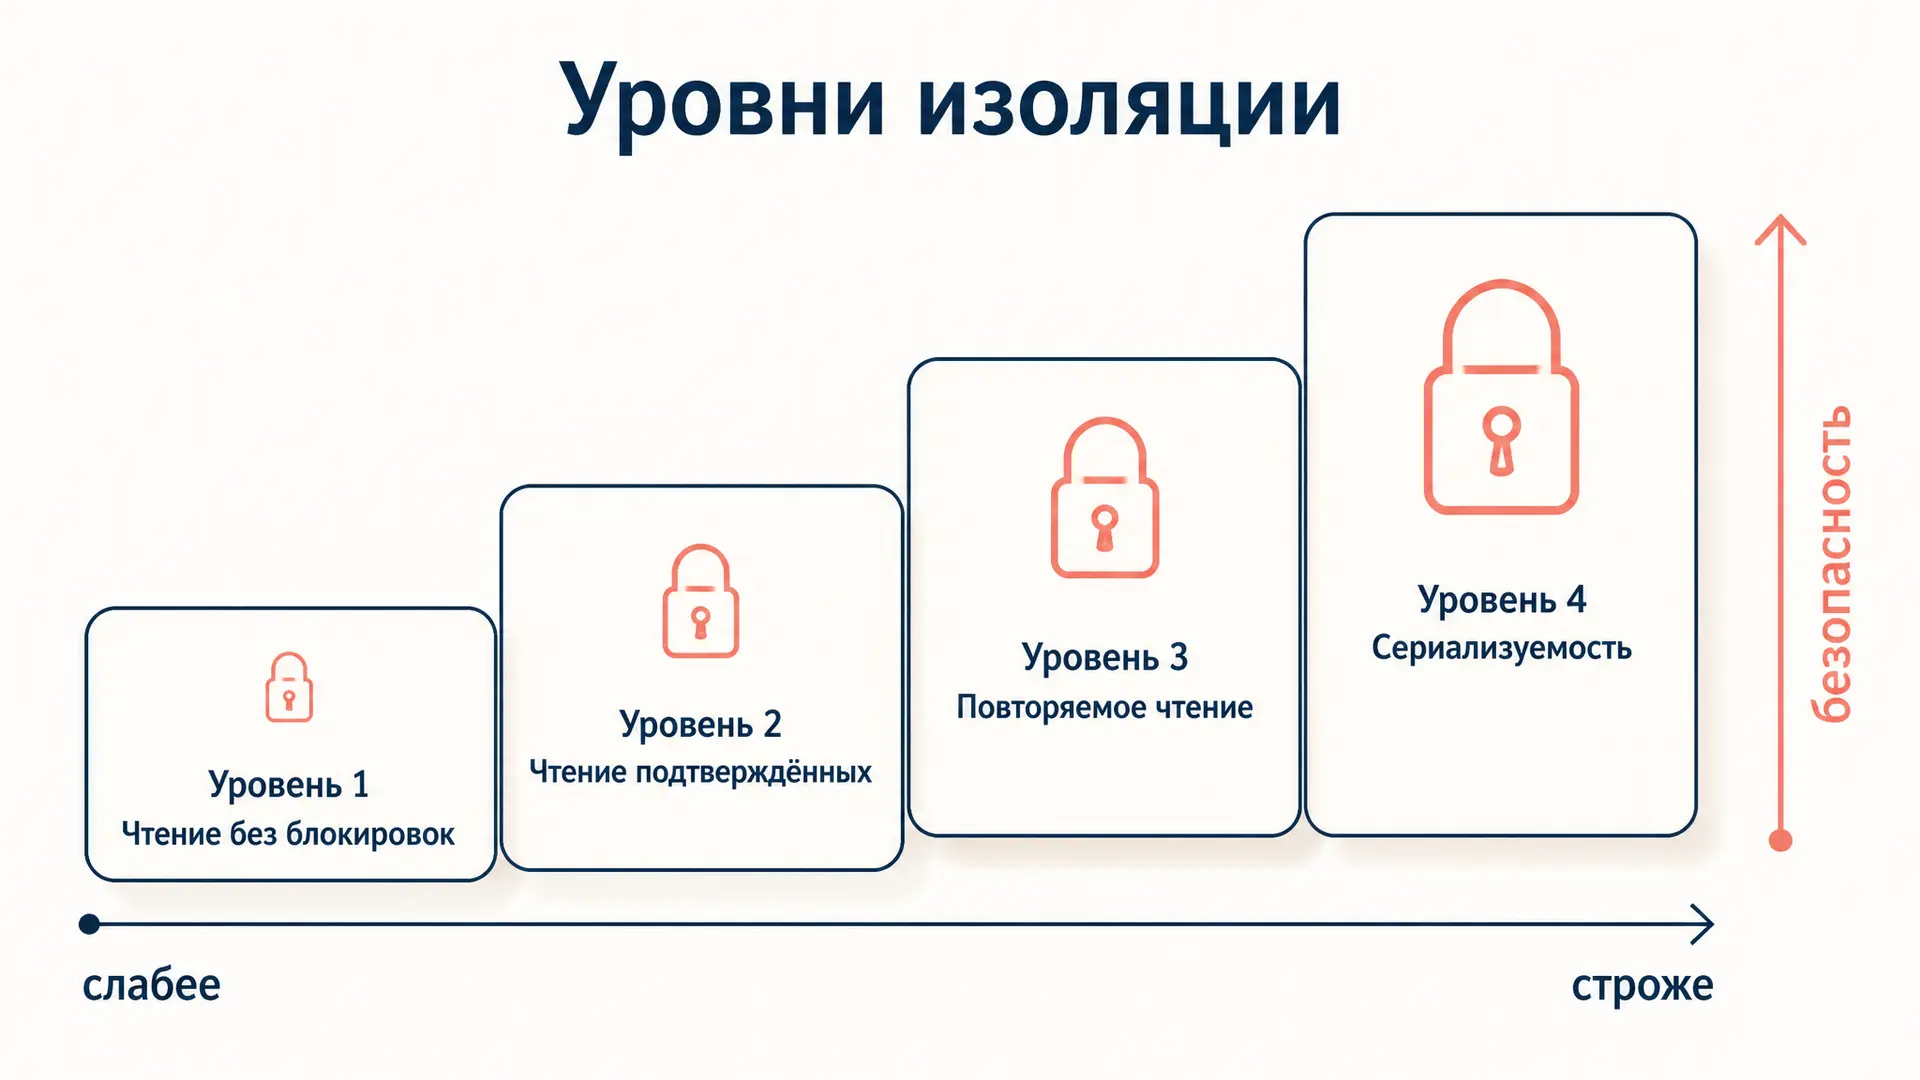
Уровни изоляции транзакций SQL: аномалии и выбор
Четыре уровня изоляции транзакций SQL и аномалии, которые они допускают: грязное, неповторяемое и фантомное чтение. Как выбрать уровень в PostgreSQL и MySQL.
ACID-свойства транзакций: атомарность и изоляция
Разбираем четыре свойства ACID - атомарность, согласованность, изоляцию и долговечность. Примеры уровней изоляции, аномалий и deadlock в реляционных СУБД.
Транзакции ACID: атомарность, изоляция и надёжность
Разбор четырёх свойств ACID транзакции БД: атомарность, согласованность, изолированность, надёжность. Уровни изоляции, аномалии, COMMIT и ROLLBACK с примерами SQL.