Многомерная группировка: признаки и расстояния
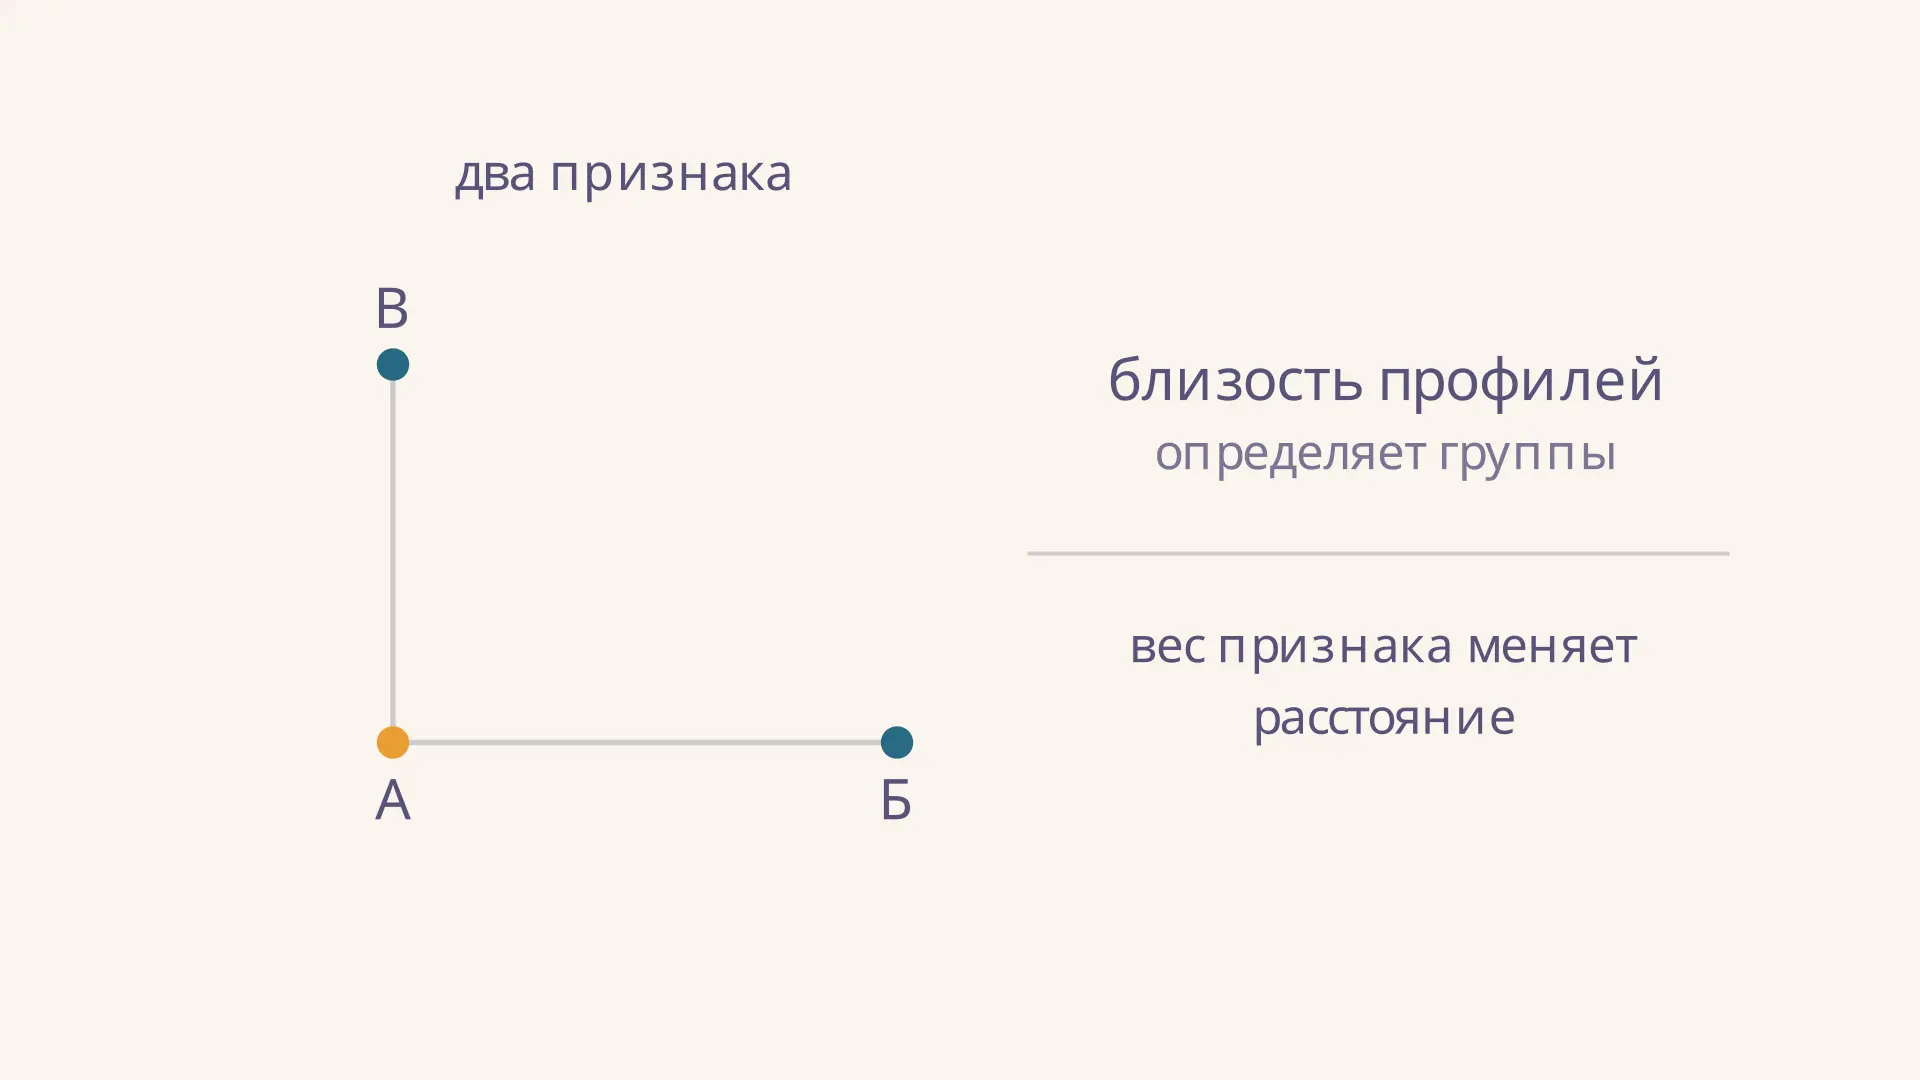
Многомерная группировка объединяет объекты с учётом нескольких признаков. Например, при сравнении предприятий важны не только выручка, но и численность персонала, производительность и другие характеристики. Один из подходов ищет предприятия с похожими наборами показателей: для этого необходимо определить, как измерять различие между профилями. Попробуйте изменить множитель одного признака в калькуляторе: ближайший сосед может измениться, хотя исходные записи останутся прежними.
Что показывает многомерная группировка
При группировке единицами наблюдения могут быть предприятия, регионы или домохозяйства. У каждой единицы есть набор значений, то есть профиль. Задача состоит в том, чтобы получить группы, удобные для описания структуры совокупности или поиска похожих объектов. Слово «многомерная» указывает на несколько признаков, а не обязательно на изображение в трёх измерениях: признаков может быть и больше.
Термин употребляют по-разному. В широком смысле к группировке по нескольким признакам относят и комбинационные таблицы. В более узком под многомерной классификацией понимают поиск сходных профилей по мере близости. Такой подход рассматривается как альтернатива чрезмерному дроблению комбинационной таблицы в учебном пособии ТУСУРа по статистике. Здесь сосредоточимся именно на близости профилей. Важно заранее определить, какие характеристики отвечают исследовательскому вопросу и как они измерены.
Отдельная таблица по каждой характеристике не раскрывает, какие их значения принадлежат одному и тому же объекту. Профиль сохраняет это сочетание. Но решение о том, что считать «похожим», зависит от выбранных признаков, их преобразования и меры расстояния; универсального разбиения для любой задачи нет.
Исходная матрица и смысл признаков
Представим данные в виде матрицы: строки - объекты, столбцы - показатели, а ячейка содержит значение показателя для объекта. До вычислений определите совокупность, период и единицы измерения. Выручка за год и численность на конец другого года могут описывать разные условия; сравнивать их без оговорок рискованно.
Выбирайте признаки под вопрос. Для сравнения структуры затрат полезны доли статей, для масштаба бизнеса - объём выпуска и занятость. Если два показателя почти дублируют друг друга, они могут дважды усилить один аспект близости. С другой стороны, исключение важного показателя скроет различие. Зафиксируйте, какие признаки использованы для построения групп, а какие оставлены для последующего описания.
Пропуск не равен нулю: отсутствие сведений о выручке не означает нулевой выручки. Проверяют ошибки ввода, единицы измерения и необычные значения, затем выбирают обоснованную обработку пропусков. Удаление неполных строк меняет состав данных, а заполнение типичным значением вносит предположение. Оба решения нужно указать при описании результата.
Пример: расстояние между профилями
Возьмём три условных объекта и два уже сопоставимых числовых показателя. Это учебные координаты, а не данные реальных предприятий:
| Объект | Первый признак | Второй признак |
|---|---|---|
| А | 0 | 0 |
| Б | 4 | 0 |
| В | 0 | 3 |
Для точек и с двумя координатами обычное евклидово расстояние равно
Поэтому , а . При одинаковом масштабе признаков В ближе к А. Нулевые координаты здесь показывают выбранное начало условной шкалы и не означают отсутствия данных.
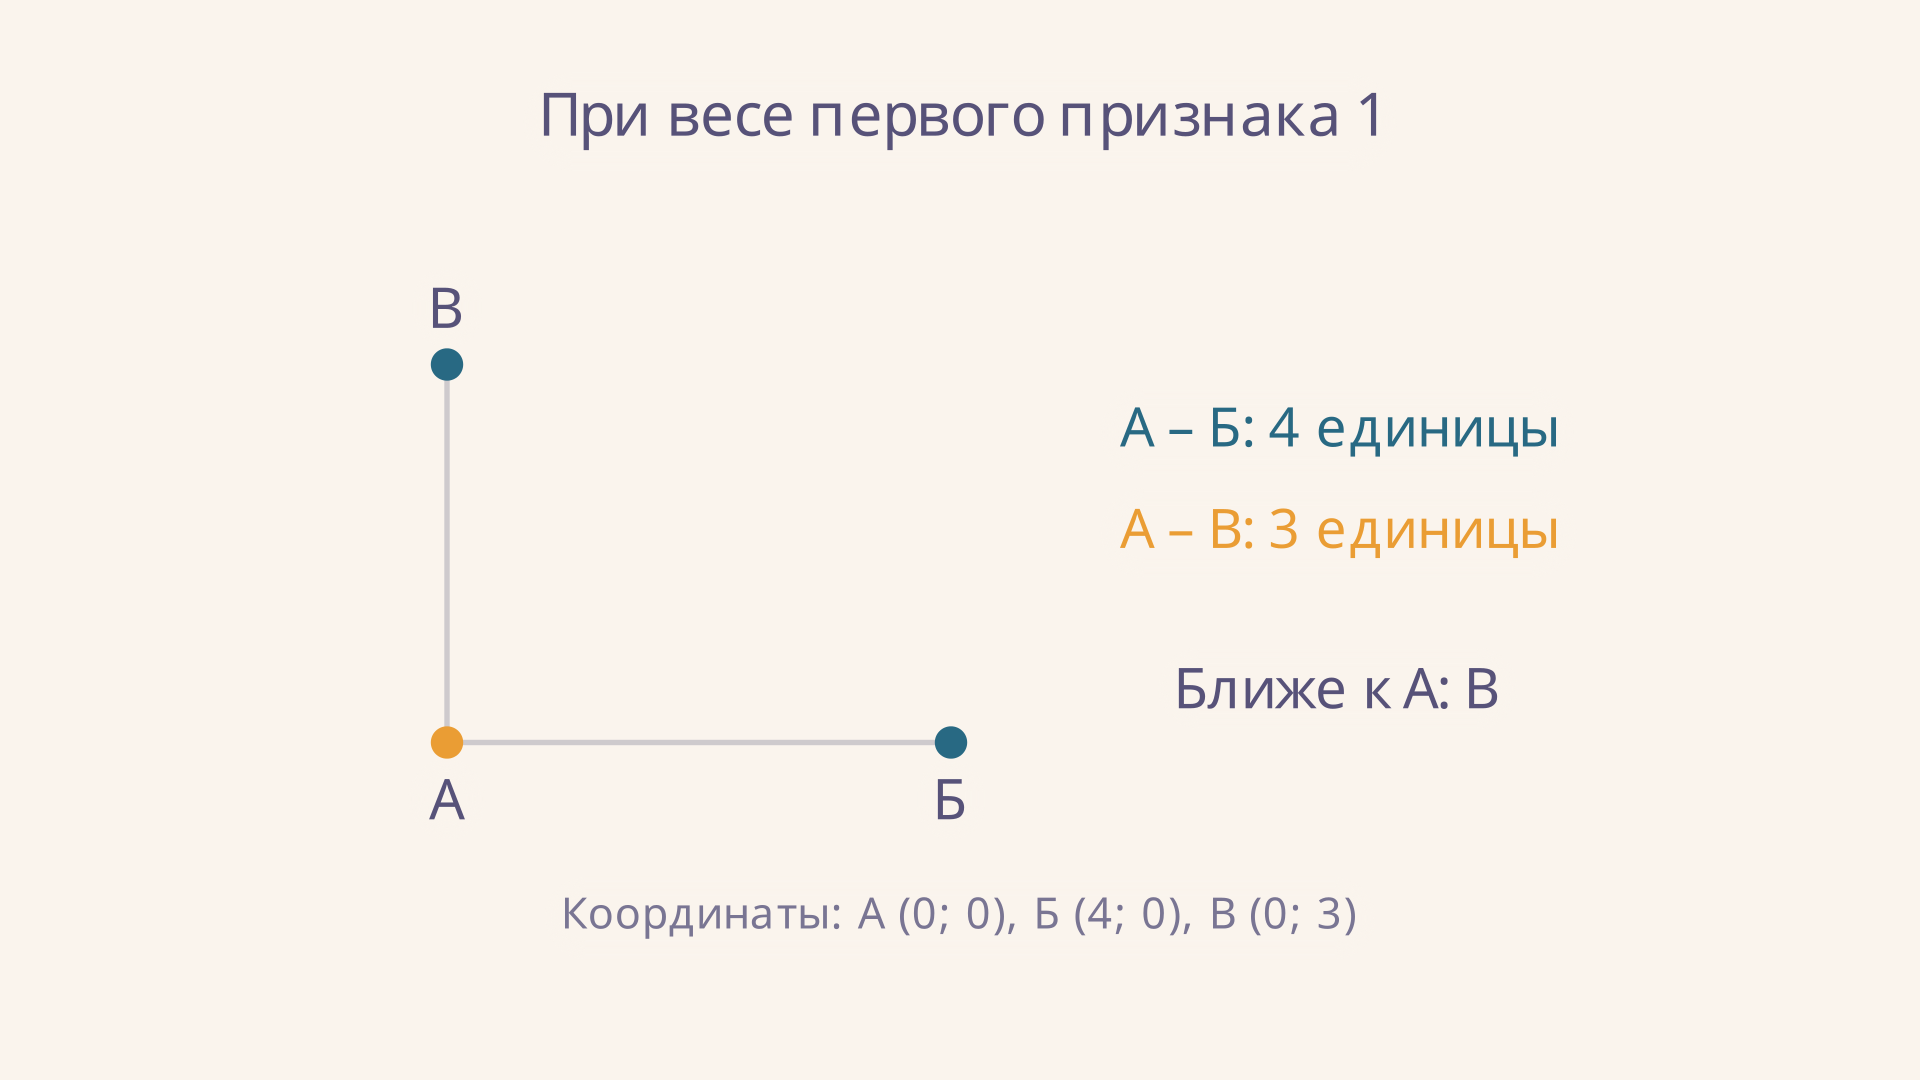
Попарные расстояния - вход для некоторых методов, но ещё не готовое разбиение. Чтобы построить группы всех трёх объектов, нужно дополнительно выбрать алгоритм и правило остановки или число групп. Близость к А сама по себе не сообщает, как алгоритм поступит со всей совокупностью.
Как масштаб меняет близость
Пусть перед расчётом первую координату умножают на , а вторую оставляют без изменения. Тогда , а . При расстояния равны 2 и 3: ближе Б. При они равны 4 и 3: ближе В. Равенство наступает при , то есть . На границе невозможно выбрать единственного ближайшего соседа без дополнительного правила разрешения равенства.
Этот множитель действует на координату, поэтому в сумме квадратов его вклад равен . Вес в другом определении может стоять непосредственно перед квадратом; смешивать эти соглашения нельзя. В интерактиве множитель меняется от 0,5 до 2, а при 2 расстояния составляют 8 и 3 соответственно.
В реальных данных масштаб важен даже без явного множителя. Выручка в рублях может иметь численно большие значения, чем численность работников, и доминировать в расстоянии из-за единицы измерения. Если её перевести в миллионы рублей, результат без дополнительной подготовки изменится. Это не изменение экономической сущности предприятий, а изменение используемой меры.
Стандартизация и выбор расстояния
Распространённый приём - стандартизация каждого числового признака: из значения вычитают среднее по данным и делят на стандартное отклонение. Тогда единица новой шкалы соответствует одному стандартному отклонению выбранного признака. Постоянный столбец с нулевым отклонением так преобразовать нельзя; он и не различает объекты в данной совокупности.
Стандартизация не делает признаки одинаково важными по экономическому смыслу. Среднее и стандартное отклонение также чувствительны к выбросам. Для асимметричных данных могут понадобиться иные преобразования или устойчивые меры масштаба, но их применение надо объяснить. При сравнении новых объектов с прежними группами следует сохранять параметры преобразования, рассчитанные на исходных данных.
Вопрос о том, распространяются ли выводы на все объекты, зависит от того, как получена выборка. Евклидово расстояние удобно для числовых координат, но оно не единственное. Манхэттенское суммирует абсолютные разности по признакам; другие меры подходят для иных типов данных и задач. Категориям вроде отрасли нельзя произвольно присвоить номера 1, 2 и 3 и считать разницу между ними экономическим расстоянием. Для категориальных и смешанных данных нужны подходящее кодирование и мера сходства.
От расстояний к группам
После подготовки выбирают процедуру. Например, метод k-средних ищет группы вокруг центров и использует число групп , заданное исследователем. Его результат зависит от масштаба и начальных центров; повторные запуски помогают исследовать эту зависимость. Иерархические методы строят последовательность объединений и позволяют рассмотреть несколько уровней разбиения.
Не всякий набор данных содержит отчётливые естественные группы. Алгоритм может выдать разбиение даже непрерывного облака точек. Поэтому число групп выбирают с учётом задачи, устойчивости, размеров групп и содержательной интерпретации. Один показатель качества не заменяет проверку: небольшое внутригрупповое расстояние полезно только в контексте выбранной меры и признаков.
Для описания результата вернитесь к исходным единицам измерения: покажите численность каждой группы, медианы или средние показателей, разброс и примеры типичных и пограничных объектов. Название вроде «крупные производительные предприятия» оправданно лишь тогда, когда оно соответствует нескольким характеристикам группы, а не одному удачному примеру.
Как проверить результат перед выводами
Повторите анализ при разумных альтернативных наборах признаков, масштабах и параметрах. Сравните состав групп, а не только их номера: номер может поменяться без изменения состава. Если небольшое изменение веса переносит множество объектов, отметьте неустойчивость и изучите пограничные случаи. Выбросы полезно проверить отдельно: иногда это ошибка, а иногда содержательно важные единицы.
Проекция помогает увидеть данные, но не заменяет расчёт расстояний в исходном пространстве. Например, t-SNE строит карту с акцентом на локальное соседство; по расстоянию между далёкими областями карты нельзя автоматически судить о расстоянии исходных профилей. Для количественных признаков и интервалов отдельно рассмотрены правила группировки статистических данных.
Наконец, найденная похожесть описывает выбранные данные и не доказывает причинную связь. Группы регионов по доходам и занятости сами по себе не объясняют, почему показатели различаются. Для причинного вывода нужны отдельная исследовательская постановка и соответствующие данные.
Частые ошибки
- Смешивают единицы измерения. Численно крупный показатель может определять расстояние только из-за своей шкалы.
- Принимают пропуск за ноль. Это создаёт искусственную близость или удалённость объектов.
- Считают сравнение соседей готовой группировкой. Для разбиения нужен конкретный алгоритм и его параметры.
- Не проверяют устойчивость. При другом разумном масштабе или наборе признаков состав групп может измениться.
- Называют группу по одному объекту. Проверяйте распределения признаков и размер всей группы.
FAQ
Сколько признаков нужно для многомерной группировки?
Не менее двух в обычном смысле термина, но подходящее число зависит от задачи и данных. Лишние или дублирующие признаки могут исказить меру сходства.
Всегда ли нужна стандартизация?
Нет. Она полезна при разных масштабах, но решение зависит от смысла показателей, распределений и выбранной меры расстояния. Иногда исходные единицы или специально заданные веса лучше отражают цель анализа.
Можно ли доказать причину различий между группами?
Нет, одна группировка описывает сходство и различие профилей. Причинный вывод требует отдельного исследования, учитывающего возможные смешивающие факторы и способ отбора данных.
Коротко
Многомерная группировка рассматривает несколько характеристик объекта одновременно. При подходе на основе близости результат зависит от подготовки признаков, масштаба, меры расстояния и алгоритма. Проверка устойчивости и описание групп в исходных единицах помогают понять, насколько полученное разбиение полезно для экономической задачи.
Читайте также
Группировочный признак: выбор и примеры в статистике
Что такое группировочный признак, как выбрать качественное или количественное основание группировки и проверить границы и состав групп на примере предприятий.
Кластерный анализ регионов: показатели и пример
Как провести кластерный анализ регионов: выбрать сопоставимые показатели, стандартизовать данные, рассчитать расстояния, описать группы и проверить устойчивость результата.
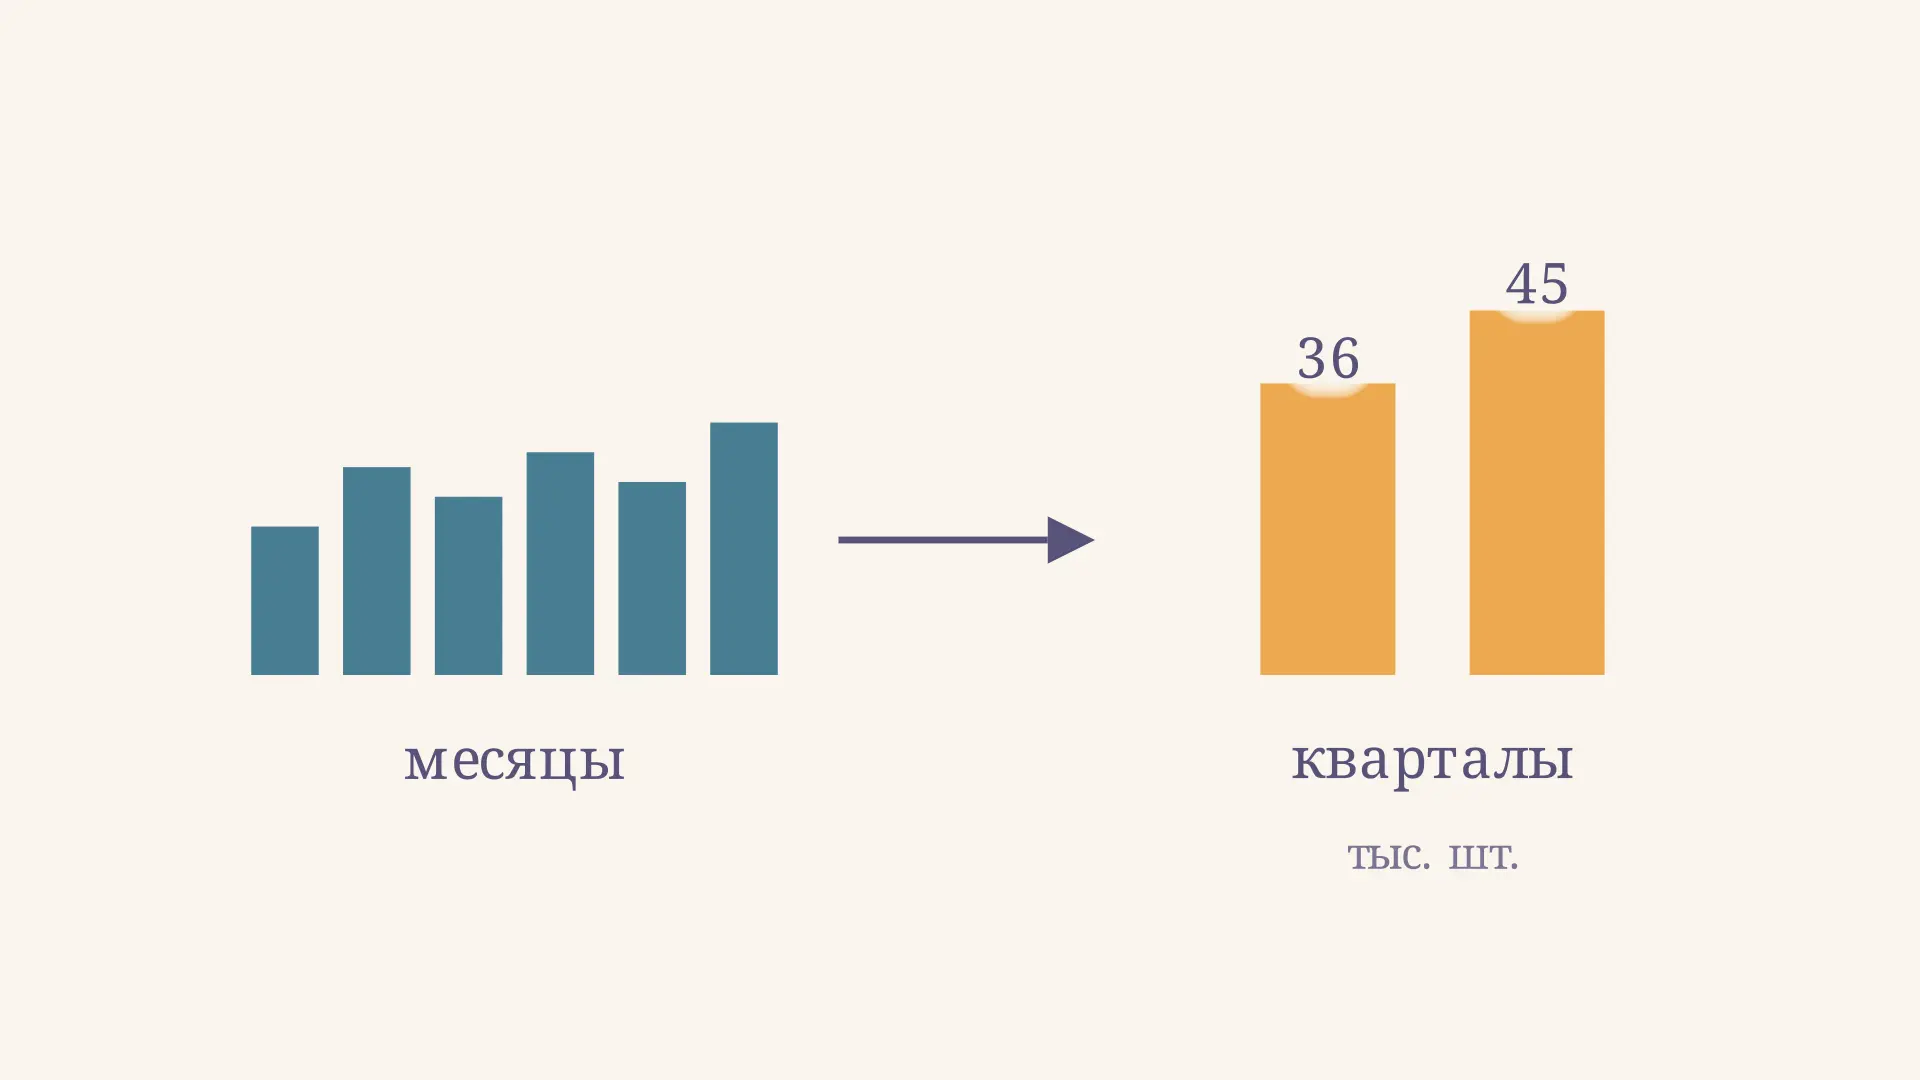
Метод укрупнения интервалов: расчёт и пример
Метод укрупнения интервалов в статистике: как перейти от месячных данных к квартальным, рассчитать суммы и средние, увидеть тенденцию и не потерять важные колебания.
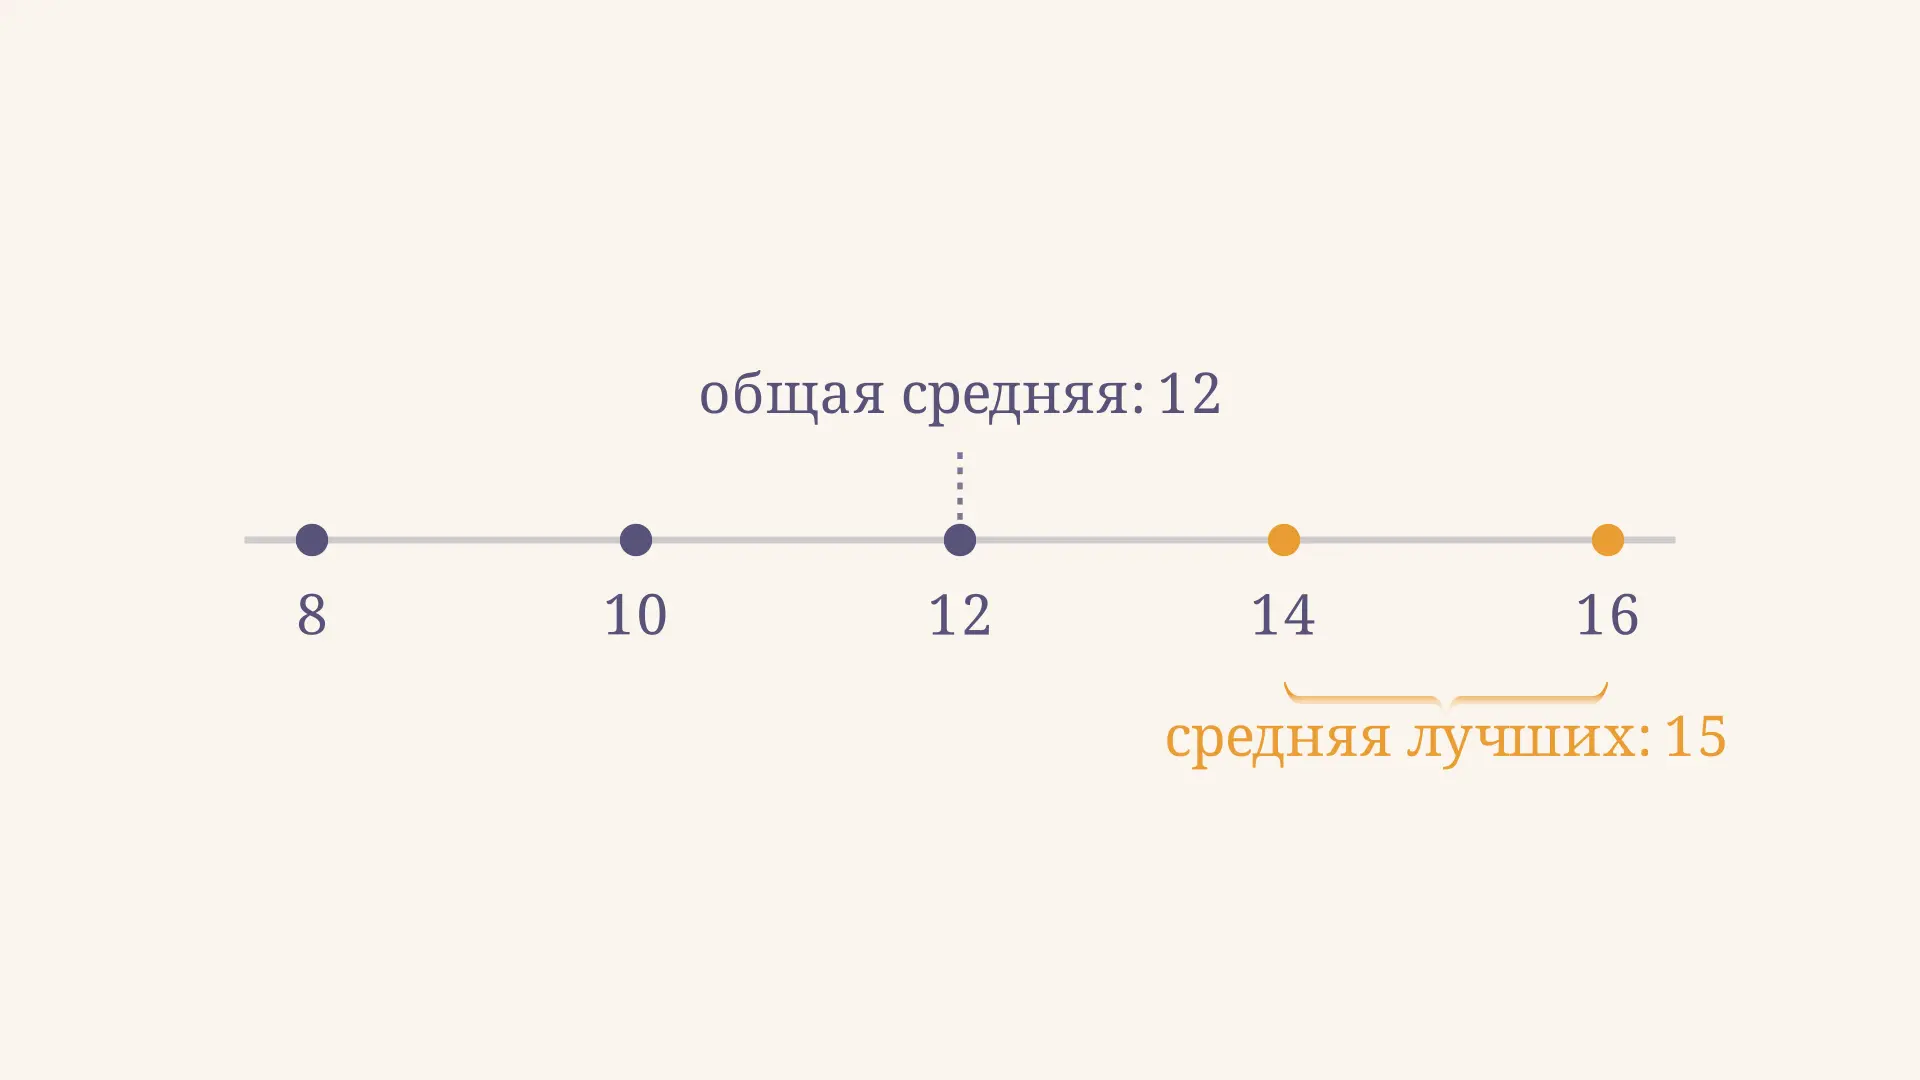
Средняя прогрессивная: формула и пример расчёта
Что показывает средняя прогрессивная в статистике, как выбрать лучшие значения относительно общей средней и рассчитать показатель на примерах выработки и затрат.
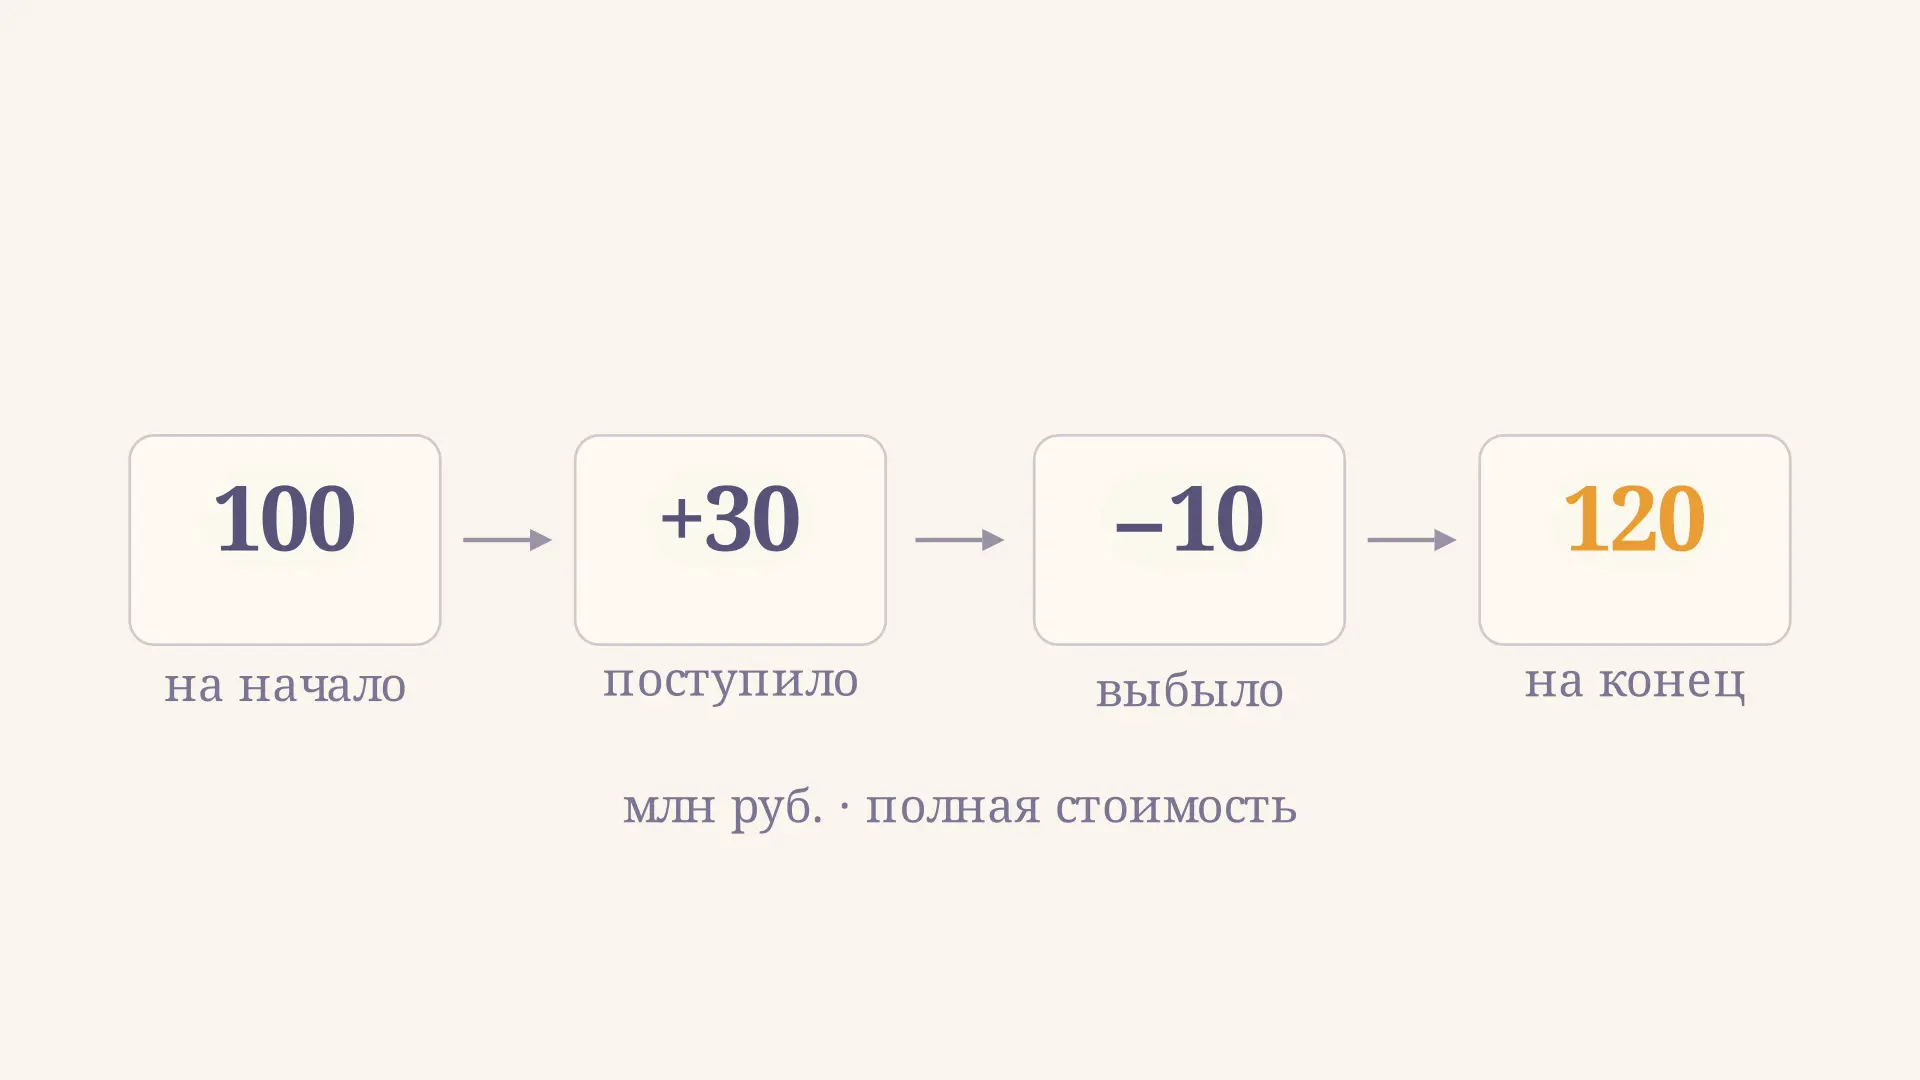
Анализ движения основных средств: формулы и пример
Как составить баланс движения основных средств и рассчитать коэффициенты поступления, обновления и выбытия: формулы, пример в млн рублей и частые ошибки.
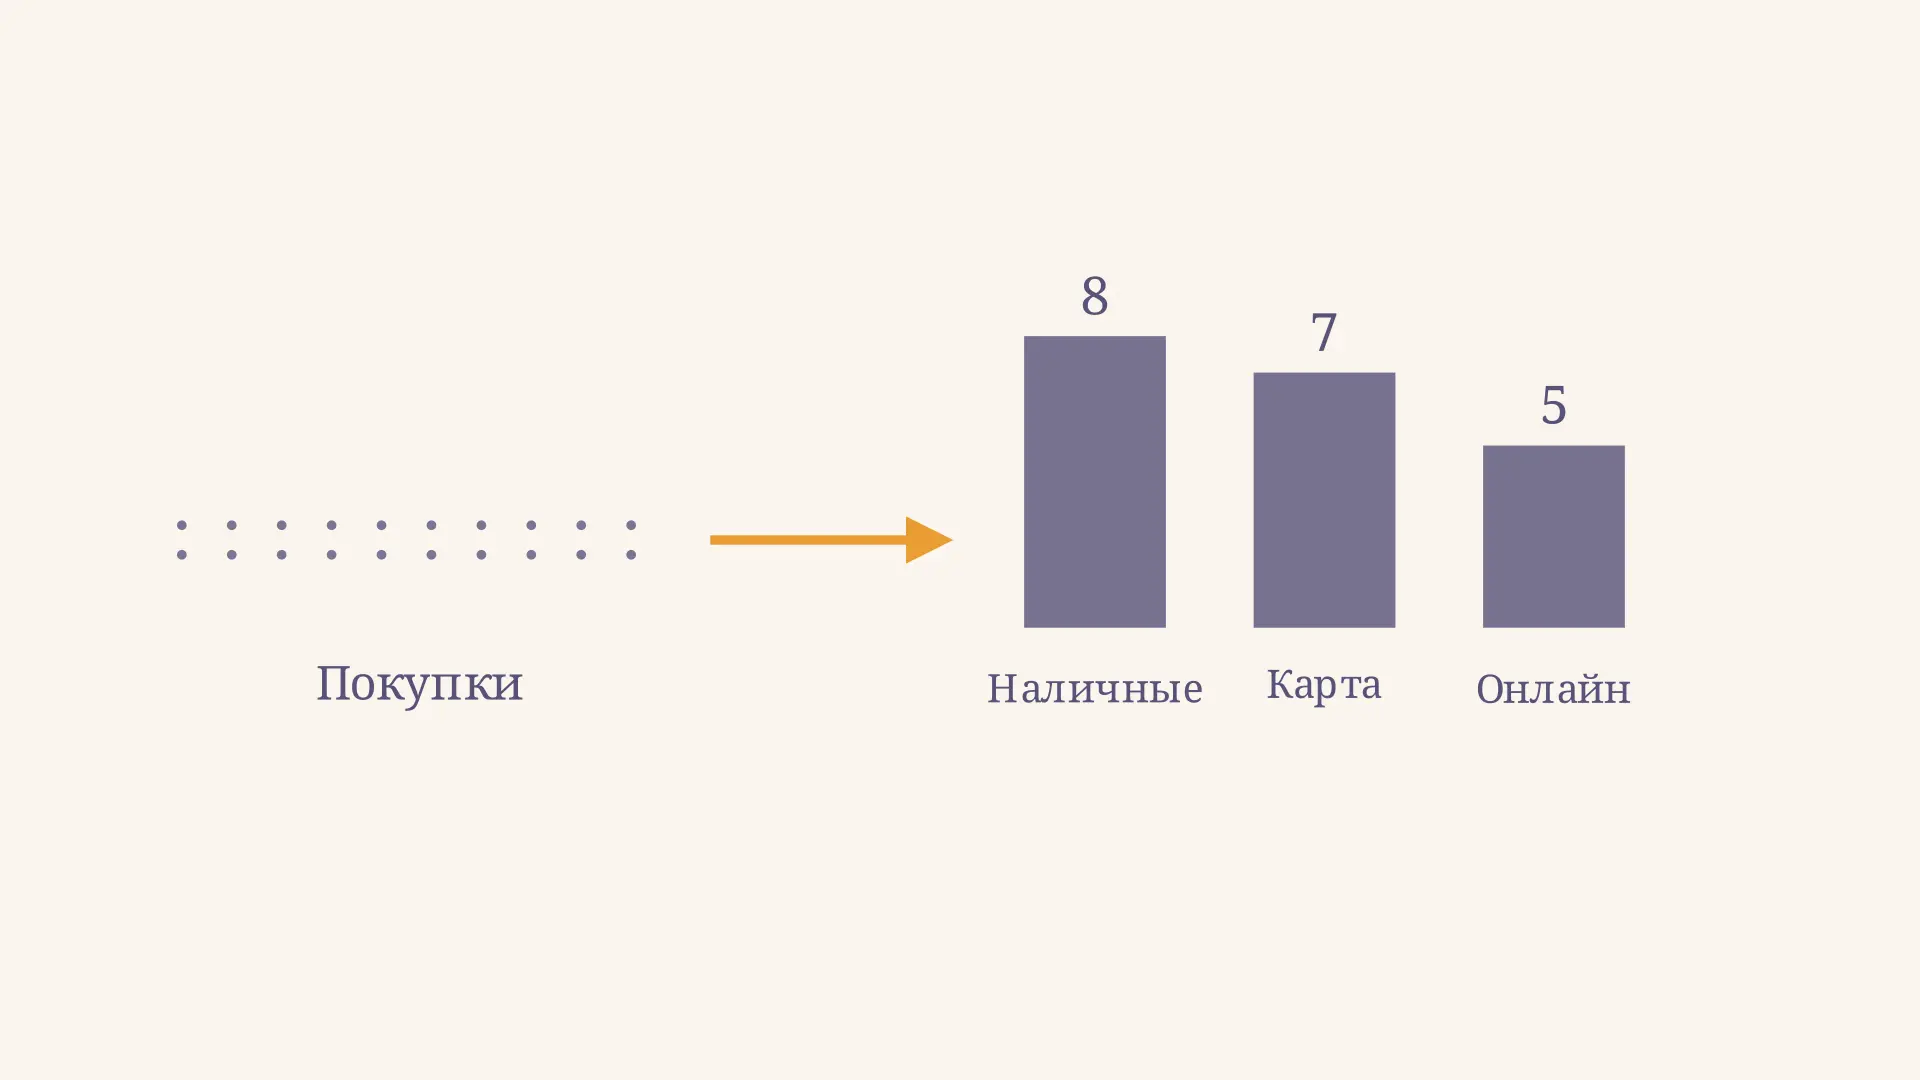
Атрибутивный ряд распределения: пример и расчёт
Атрибутивный ряд распределения в статистике: как выделить качественный признак, подсчитать частоты и доли, построить диаграмму и найти моду на примере покупок.