Кластерный анализ регионов: показатели и пример
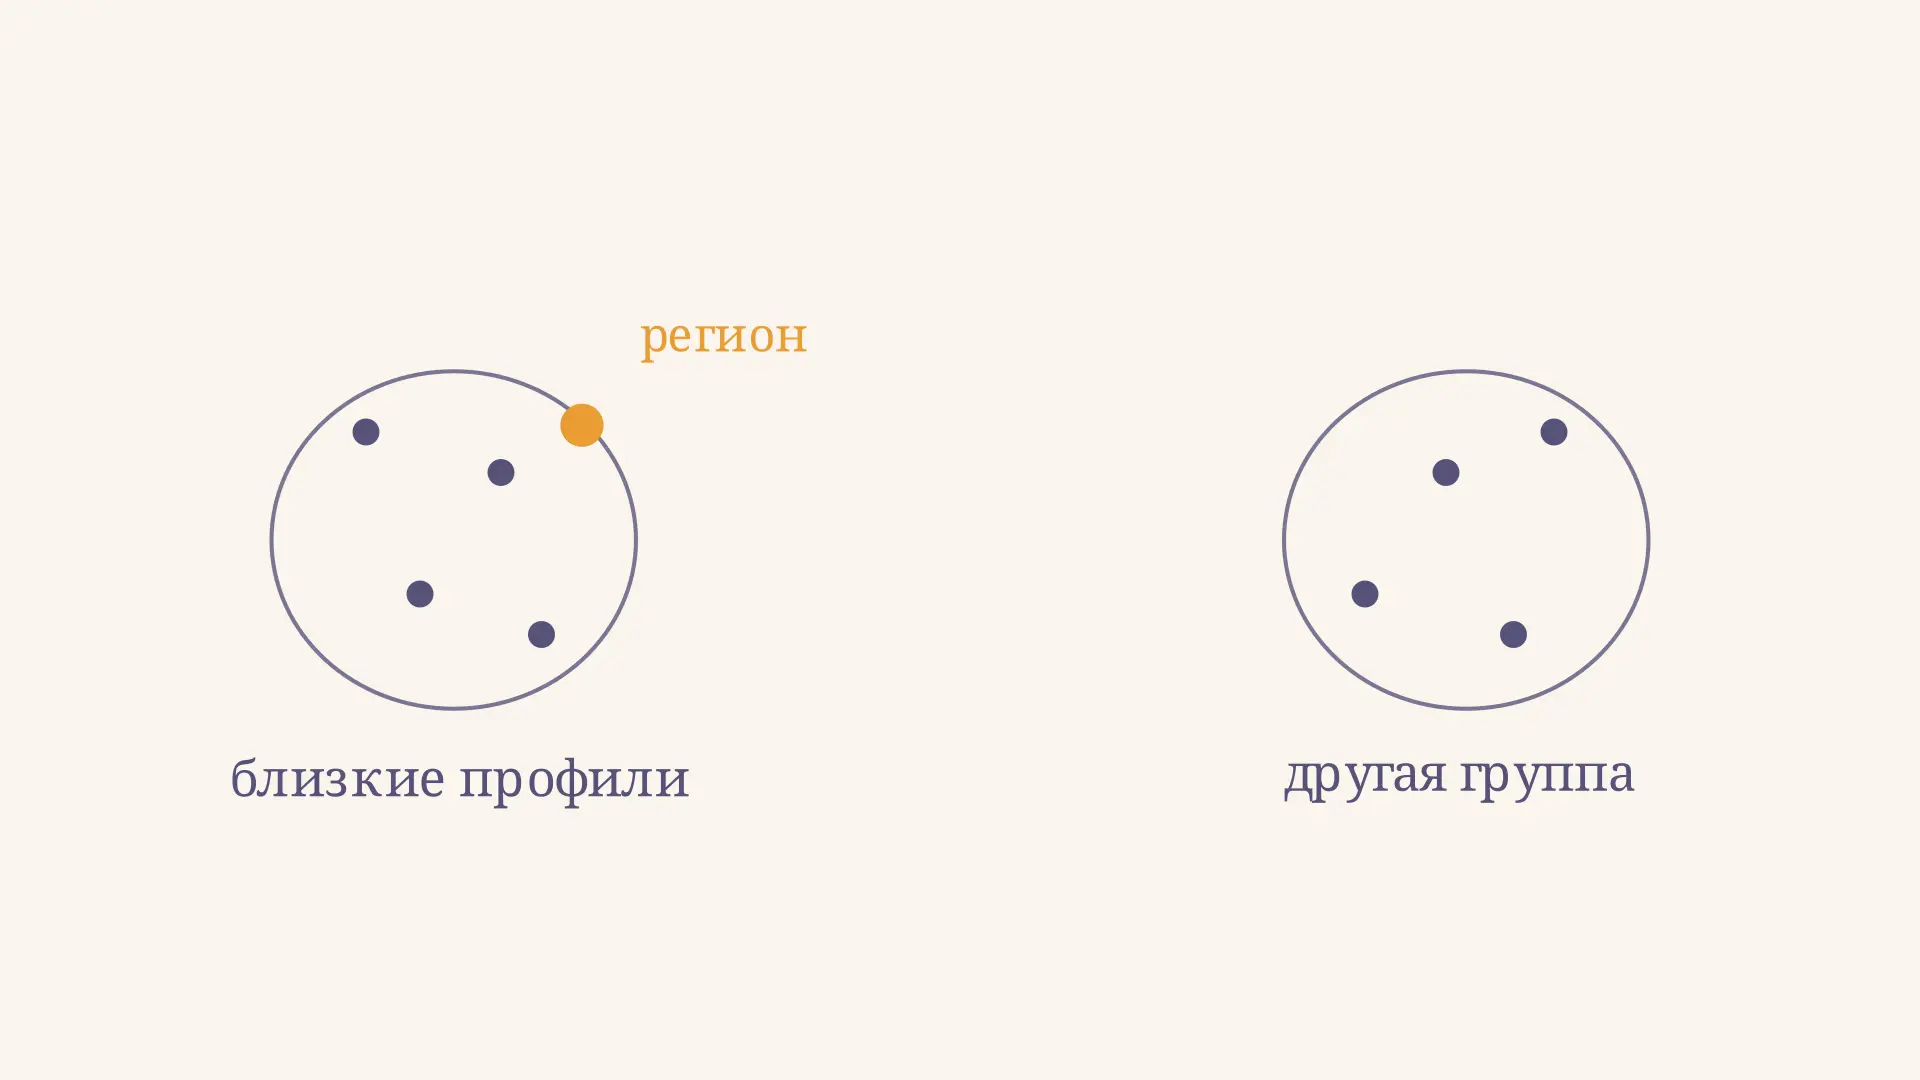
Кластерный анализ регионов помогает объединить территории со сходными экономическими профилями. Вместо одного места в рейтинге каждый регион описывают набором показателей: например, производством на жителя, занятостью и структурой хозяйства. Затем алгоритм ищет сходство между этими наборами. Результат зависит от выбранных признаков и способа измерения близости, поэтому группы нужно не только построить, но и объяснить.
Калькулятор ниже показывает один шаг такого анализа на условных данных: передвиньте регион и сравните его расстояния до двух уже заданных центров. Это упрощённая модель, а не готовая классификация реальных территорий.
Что именно объединяет кластерный анализ
Объект исследования - отдельный регион, а его признаки образуют строку таблицы. В столбцах могут стоять показатели рынка труда, уровня производства и инвестиционной активности. Кластер - группа регионов, которые по выбранной мере близости похожи друг на друга сильнее, чем на регионы других групп. Пространственная близость при этом не обязательна: территории из разных частей страны могут иметь сходную структуру экономики.
Движение на схеме показывает только назначение одного региона ближайшему из двух фиксированных центров. Когда координата первого признака пересекает границу, меняется и ближайший центр. У реального алгоритма центры могут пересчитываться по всем участникам группы.
Такая типология пригодится, когда нужно сравнить территории со сходными проблемами или подобрать группы для дальнейшего исследования. Она не доказывает, почему возникли различия, и сама по себе не определяет, кому необходима поддержка. Группа с похожими числами может объединять регионы с разными природными условиями, историей и институтами.
Как выбрать показатели и сопоставить данные
Начинайте с вопроса: исследуется структура занятости, экономическое развитие или инвестиционный профиль? Под вопрос выбирают небольшой осмысленный набор переменных. Для учебной типологии можно взять валовой региональный продукт на жителя, долю занятых в промышленности и уровень безработицы. Первая величина описывает выпуск, вторая - структуру занятости, третья - состояние рынка труда. Это разные стороны экономики, хотя ни одна не исчерпывает её целиком.
Запишите территориальный уровень, год, единицы и источник каждого столбца. Величины за разные годы или по территориям с изменившимися границами не всегда сопоставимы. Абсолютный выпуск обычно больше в населённых регионах уже из-за их размера, поэтому для сравнения интенсивности полезны показатели на жителя. Однако и отношение на жителя не снимает всех проблем. Евростат отмечает, что высокий региональный выпуск на жителя может частично объясняться притоком работающих из соседних территорий: выпуск создаётся в одном регионе, а население учитывается в другом.
Проверьте пропуски и резко выделяющиеся значения по первоисточнику. Ошибку единиц нужно исправить, а реальный выброс - исследовать, прежде чем исключать. Если пропуски заполняют оценками, следует указать правило и проверить, меняется ли результат без этих наблюдений. О принципах выбора единиц наблюдения подробнее говорится в статье о генеральной совокупности и выборке.
Зачем стандартизовать признаки
Евклидово расстояние напрямую складывает различия по координатам. Если доход записан тысячами рублей, а безработица процентами, первый столбец может численно доминировать просто из-за масштаба. Частое решение - стандартизация каждого признака:
где - значение признака в регионе , - среднее по регионам, а - выбранное стандартное отклонение того же столбца. Полученная координата показывает отклонение от среднего в единицах стандартного отклонения. Если разброс признака равен нулю, делить на него нельзя: такой столбец не различает регионы и его следует убрать из расчёта.
Стандартизация не делает все показатели одинаково важными по смыслу. Вес признака остаётся исследовательским решением; сильно коррелирующие переменные могут фактически повторно учитывать один аспект. Связь двух показателей можно отдельно изучить через выборочный коэффициент корреляции, не принимая корреляцию за причинную связь. При асимметрии и выбросах среднее и стандартное отклонение сами чувствительны к экстремальным значениям; альтернативное преобразование нужно обосновать и проверить на устойчивость.
Пример: расстояние до двух центров
Предположим, что два показателя уже стандартизованы, а центры заданы заранее: А имеет координаты , Б - . Условный регион находится в точке . Эти числа придуманы для примера и не относятся к реальным субъектам. Расстояние от региона до центра равно:
Для центра А получаем , для центра Б - . Поэтому на этом шаге регион относят к А. Пунктирная граница находится при первом показателе : там расстояния равны, и решение о равенстве требует заранее заданного правила. В калькуляторе при равенстве линия условно направлена к А.
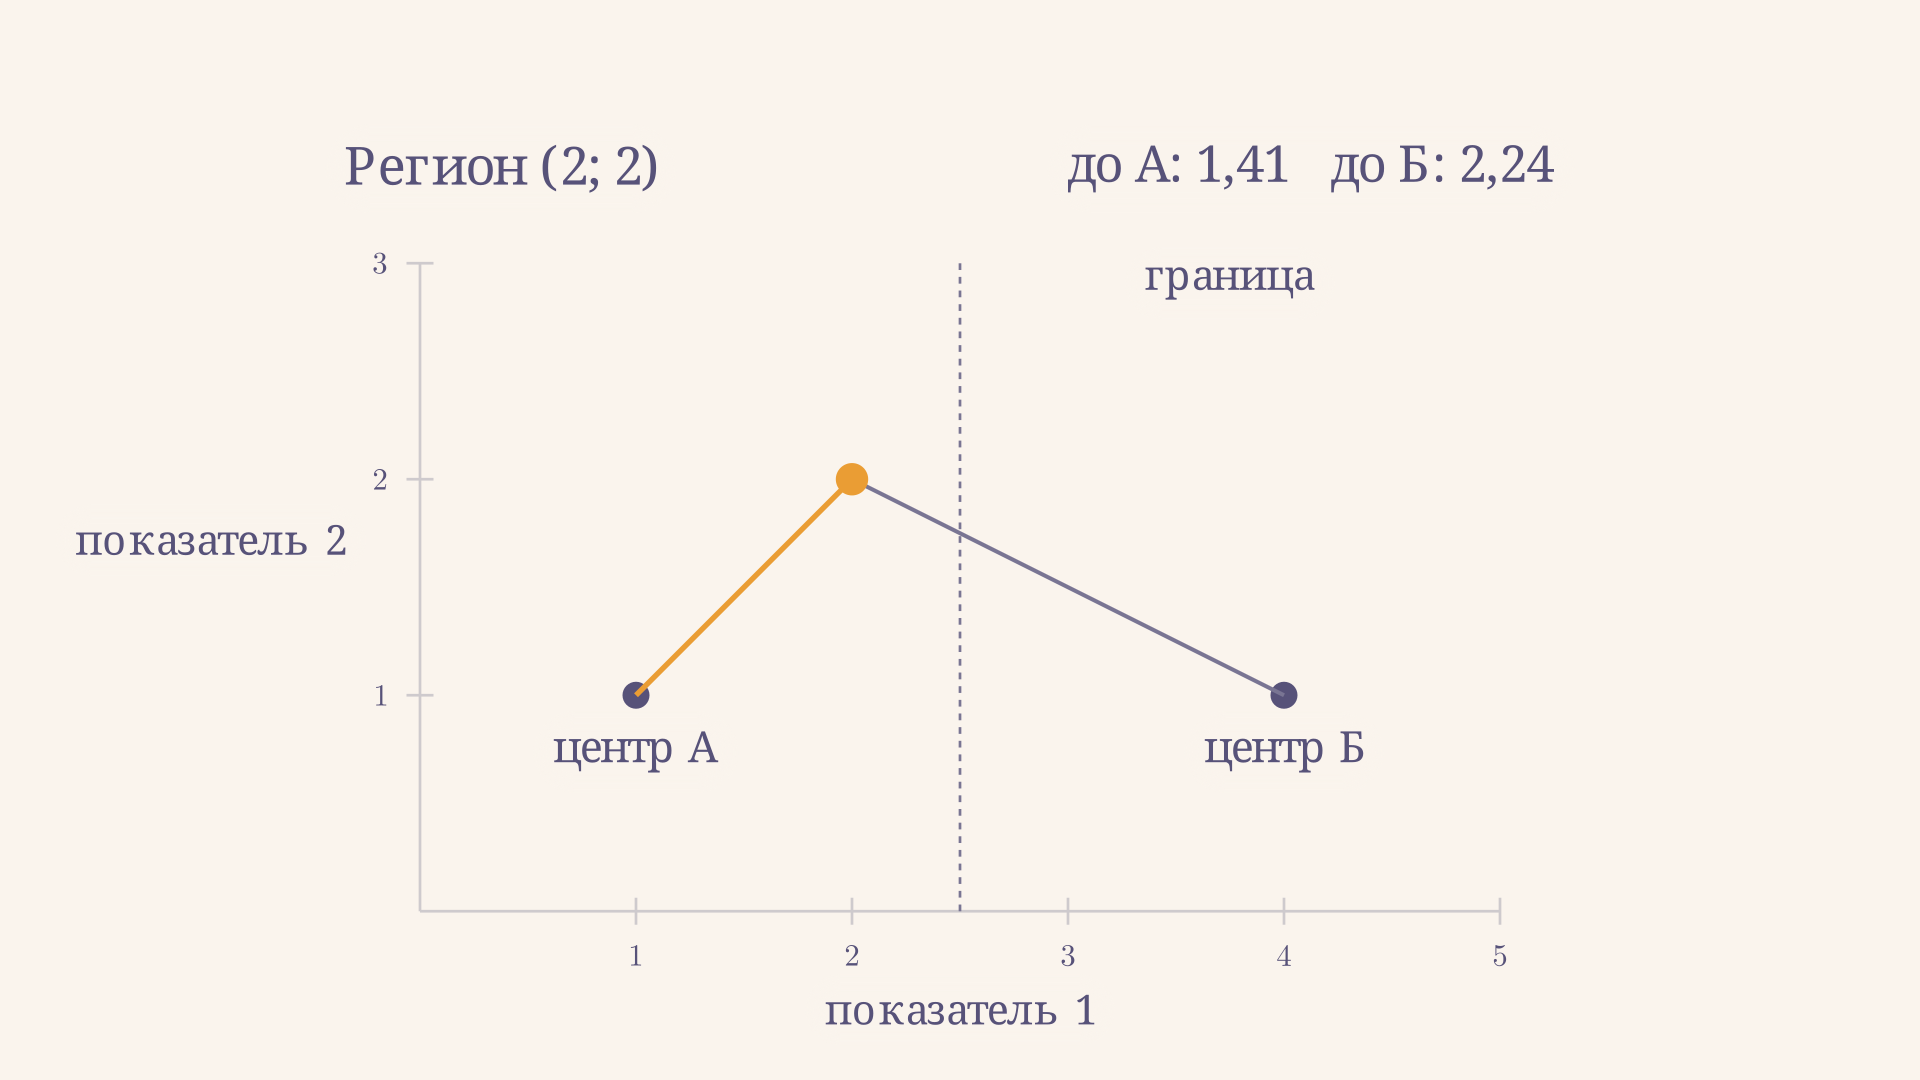
Этот расчёт показывает геометрию одного назначения, но не выводит сами центры и не устанавливает число групп. В настоящей выборке каждый центр зависит от множества регионов, а стандартизованные значения могут быть и отрицательными. Изменение координаты в модели не означает, что регион действительно перешёл из одной экономической категории в другую.
Как получить группы из таблицы
В методе -средних исследователь задаёт число групп и начальные центры. Алгоритм попеременно назначает объекты ближайшим центрам и пересчитывает каждый центр как среднее координат принадлежащих ему объектов. Цель - уменьшать сумму квадратов расстояний объектов до центров своих кластеров. Разные начальные центры могут привести к разным решениям, поэтому полезны повторные запуски. Метод и его ограничения описаны в документации scikit-learn.
Этот способ удобен для количественных данных, но чувствителен к масштабу и выбросам; группы сложной формы он может представить неудачно. Для исследования вложенной структуры можно использовать иерархическую кластеризацию и дендрограмму. Другой метод или метрика отвечают на немного другой вопрос о сходстве, поэтому сравнивать результаты нужно вместе с настройками, а не только по названиям групп.
Число кластеров не следует выбирать по красивой карте. Попробуйте несколько значений , сопоставьте внутригрупповой разброс и силуэт, а затем проверьте размер и экономическую понятность групп. Сумма квадратов обычно снижается при увеличении числа групп, поэтому минимум сам по себе не выбирает полезное . Силуэт помогает оценить отделённость объектов, но тоже не заменяет содержательную проверку.
Как описать и проверить результат
Для каждой группы составьте профиль: число регионов, медианы или средние исходных показателей и их разброс. Верните читателю понятные единицы измерения: стандартизованная координата удобна алгоритму, но процент безработицы легче интерпретировать. Дайте название по отличительным признакам, например «промышленная специализация при высокой занятости», только если данные действительно подтверждают обе части. При интерпретации доходов полезно отдельно учитывать дифференциацию заработной платы: среднее группы может скрывать значительные внутренние различия.
Устойчивость проверяют повторными запусками и разумными изменениями набора признаков, весов, метода масштабирования или периода. Сравните, какие регионы сохраняют принадлежность, а какие переходят между группами. Пограничный регион не следует представлять как однозначный тип: близость двух центров говорит о неопределённости классификации при данной модели. Отдельно проверьте малые кластеры и одиночные территории: это могут быть содержательные особенности либо следствие выброса и ошибки.
В отчёте сохраните список регионов, источники, год, формулы, обработку пропусков, метод, метрику, число групп и настройки запуска. Приложите таблицу членства и профилей. Если классификация предназначена для решения о политике, дополните её качественными данными и проверкой последствий: математическая близость не равна одинаковым потребностям.
Частые ошибки
- Смешивать масштабы без проверки. Денежный показатель может подавить долю только из-за единиц записи.
- Считать кластер рейтингом. Номер группы - условная метка, а не место по качеству жизни.
- Скрывать выбор метода. Без признаков, метрики и числа групп результат невозможно воспроизвести.
- Приписывать сходству причину. Группа описывает наблюдаемые профили, но не объясняет механизм их формирования.
- Игнорировать неоднородность внутри группы. Центр не заменяет данные по отдельным регионам.
FAQ
Обязательно ли регионы одного кластера соседствуют?
Нет. Обычная кластеризация использует сходство признаков, а не общую границу. Географические ограничения можно включить отдельно, если они отвечают задаче исследования.
Нужно ли всегда стандартизовать показатели?
Нет. Это полезно при несопоставимых единицах и равной предполагаемой роли признаков, но выбор зависит от задачи, метрики и распределений. Решение и его последствия стоит описать.
Можно ли по кластерам определить причину отставания региона?
Нет, одного разбиения недостаточно. Оно помогает сформулировать гипотезы и выбрать сравнимые территории; проверка причин требует отдельного исследования.
Коротко
Кластерный анализ регионов превращает таблицу сопоставимых показателей в группы похожих экономических профилей. Надёжность результата зависит от подготовки данных, масштаба признаков, метрики и проверки устойчивости; содержательное объяснение остаётся задачей исследователя.
Читайте также
Многомерная группировка: признаки и расстояния
Многомерная группировка в экономике: как сравнить объекты по нескольким признакам, выбрать масштаб и расстояние, проверить устойчивость и интерпретировать группы.
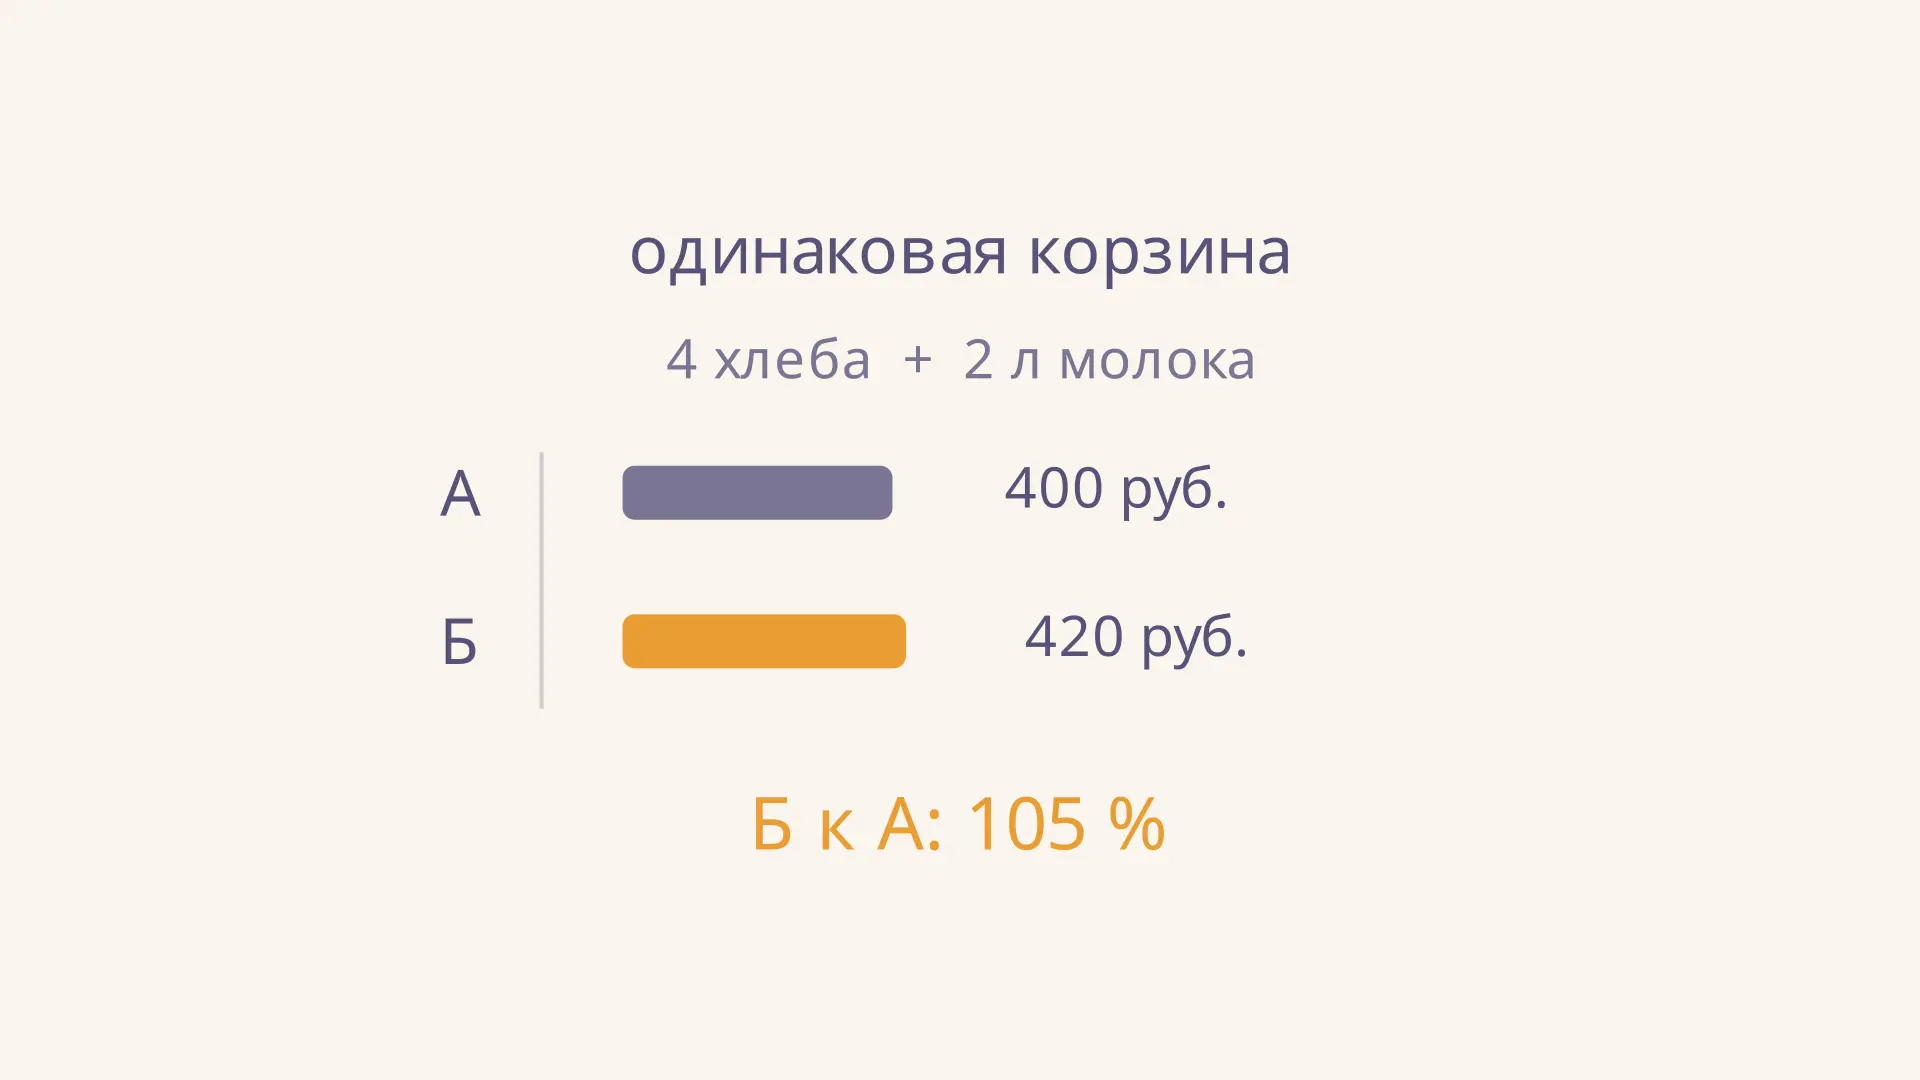
Территориальный индекс цен: формула и пример
Как территориальный индекс цен сравнивает стоимость одной корзины в двух регионах, зачем нужны общие веса и как правильно интерпретировать результат расчёта.
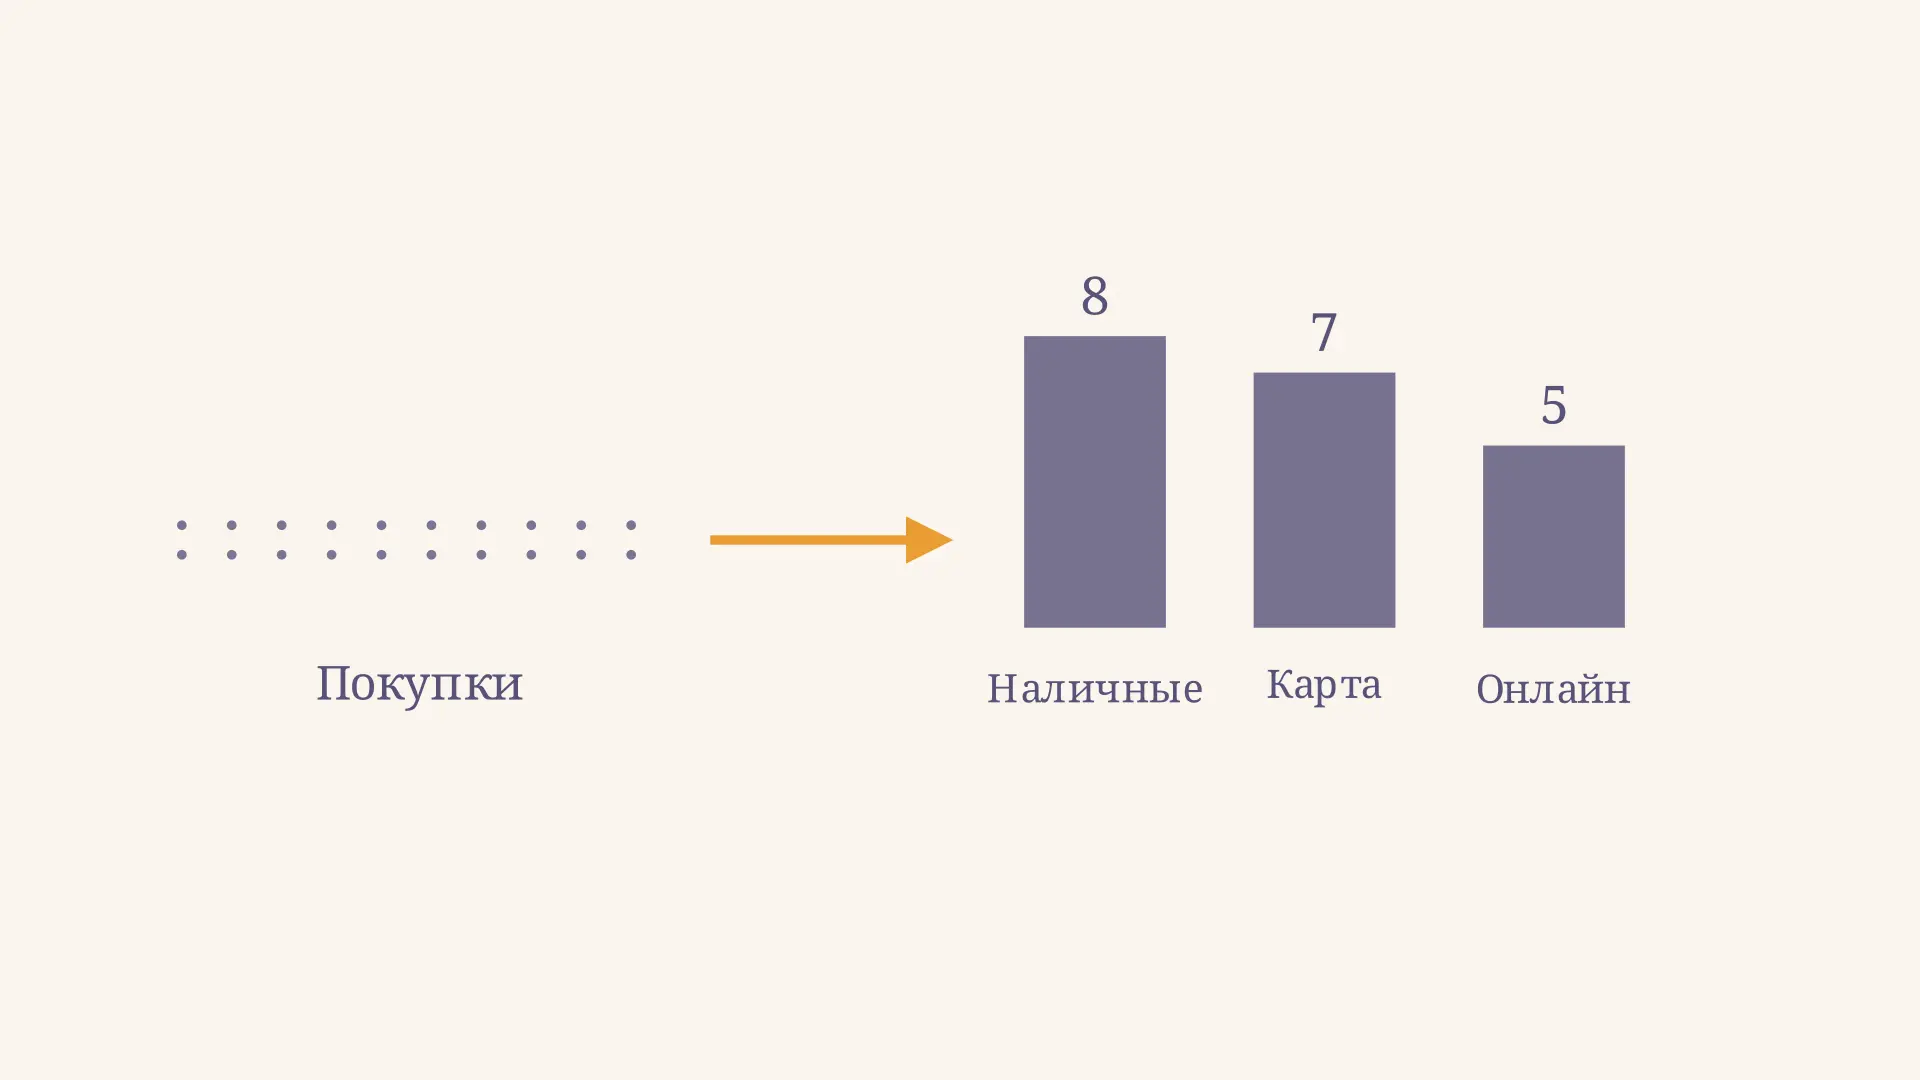
Атрибутивный ряд распределения: пример и расчёт
Атрибутивный ряд распределения в статистике: как выделить качественный признак, подсчитать частоты и доли, построить диаграмму и найти моду на примере покупок.
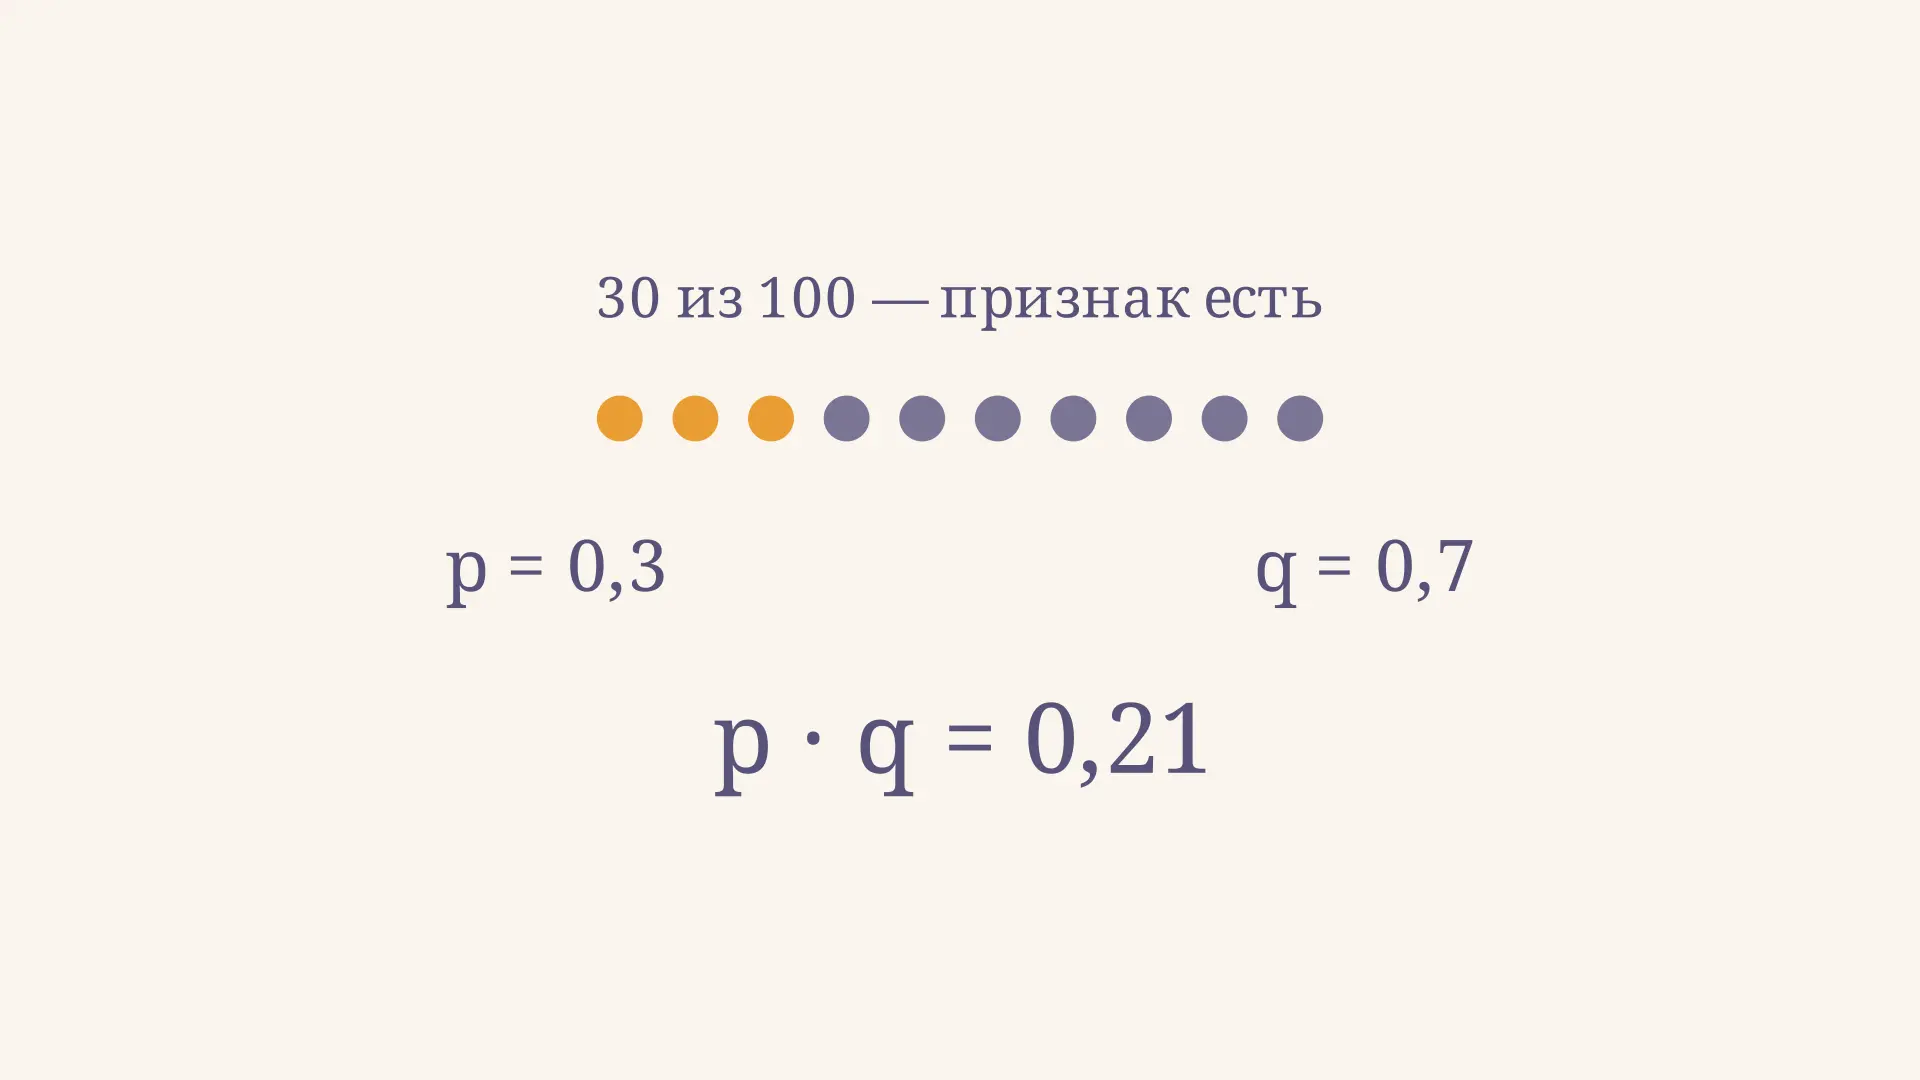
Дисперсия альтернативного признака: формула и пример
Как найти дисперсию альтернативного признака по доле или частотам, почему её максимум равен 0,25 и чем разброс единичного признака отличается от ошибки доли.
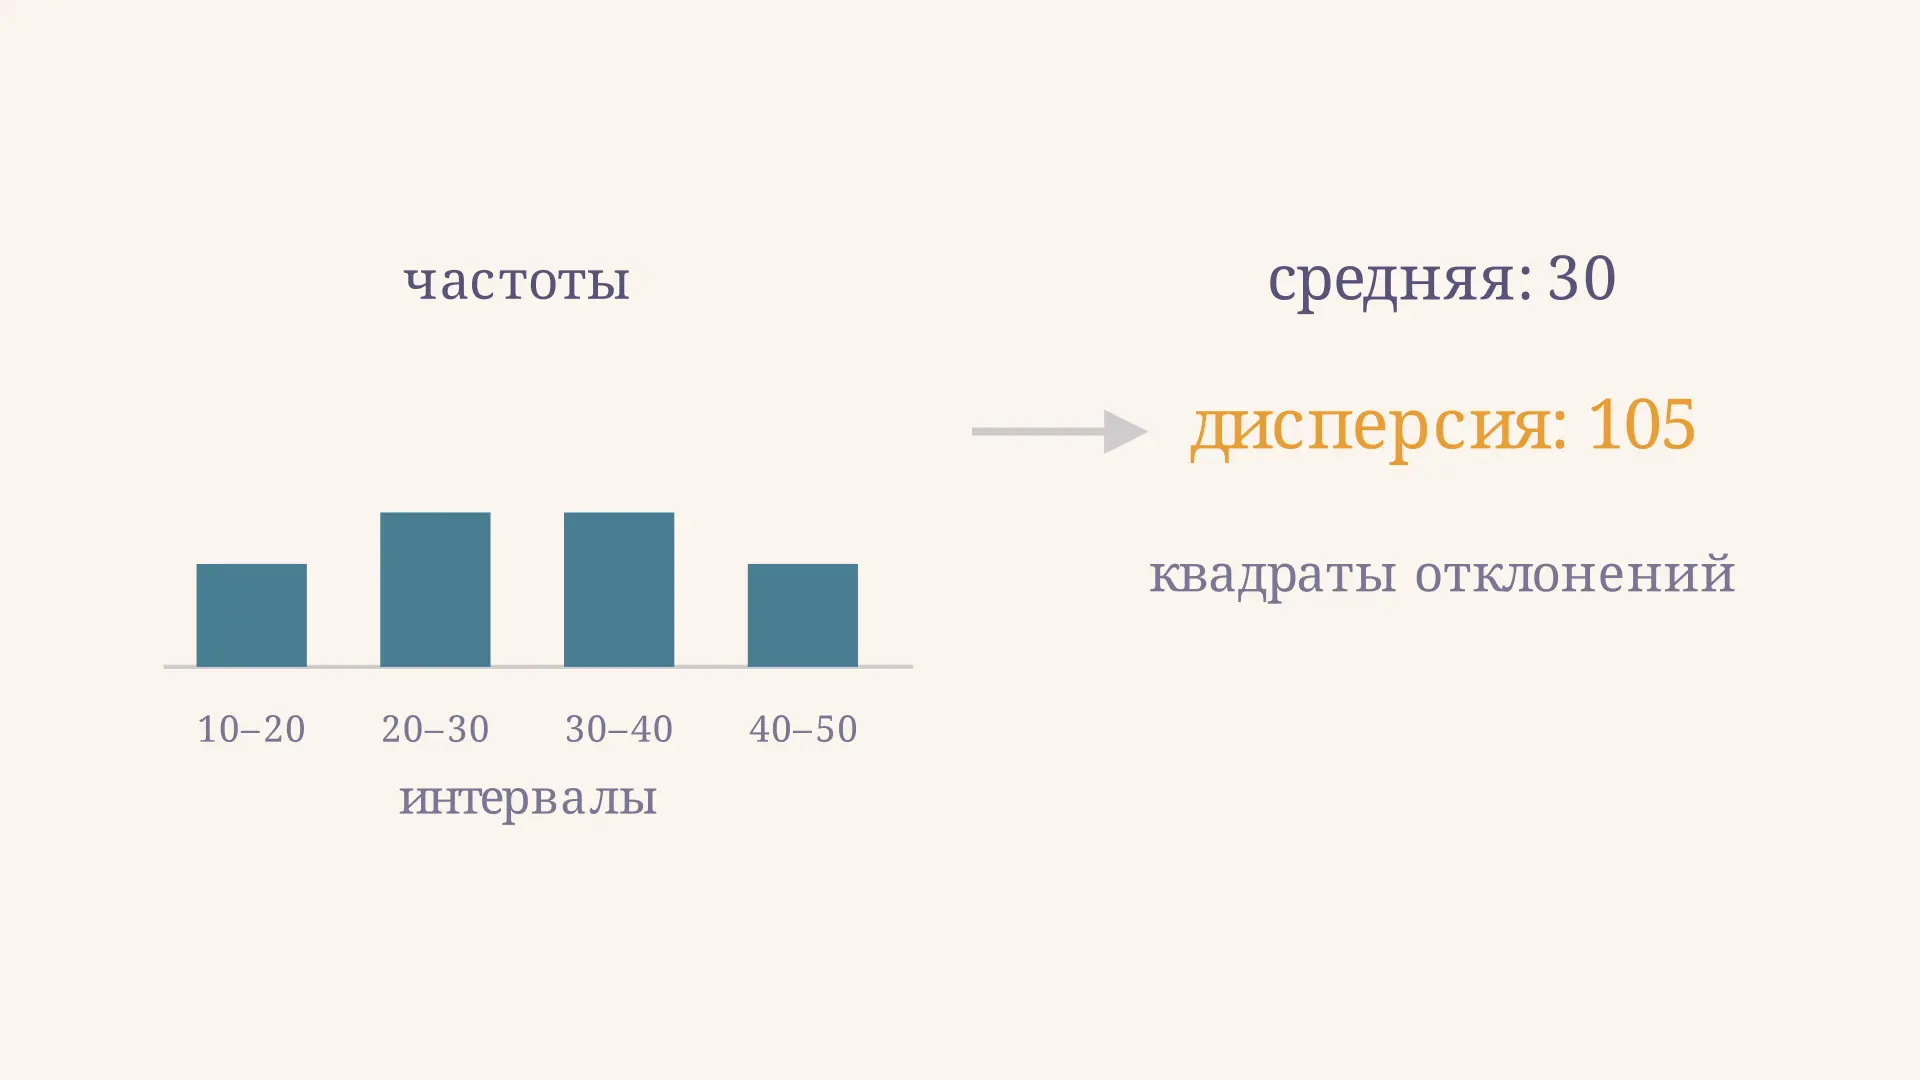
Дисперсия интервального вариационного ряда: расчёт
Как найти дисперсию интервального вариационного ряда по серединам и частотам: подробная таблица, две формулы, исправленная оценка и ограничения группировки.
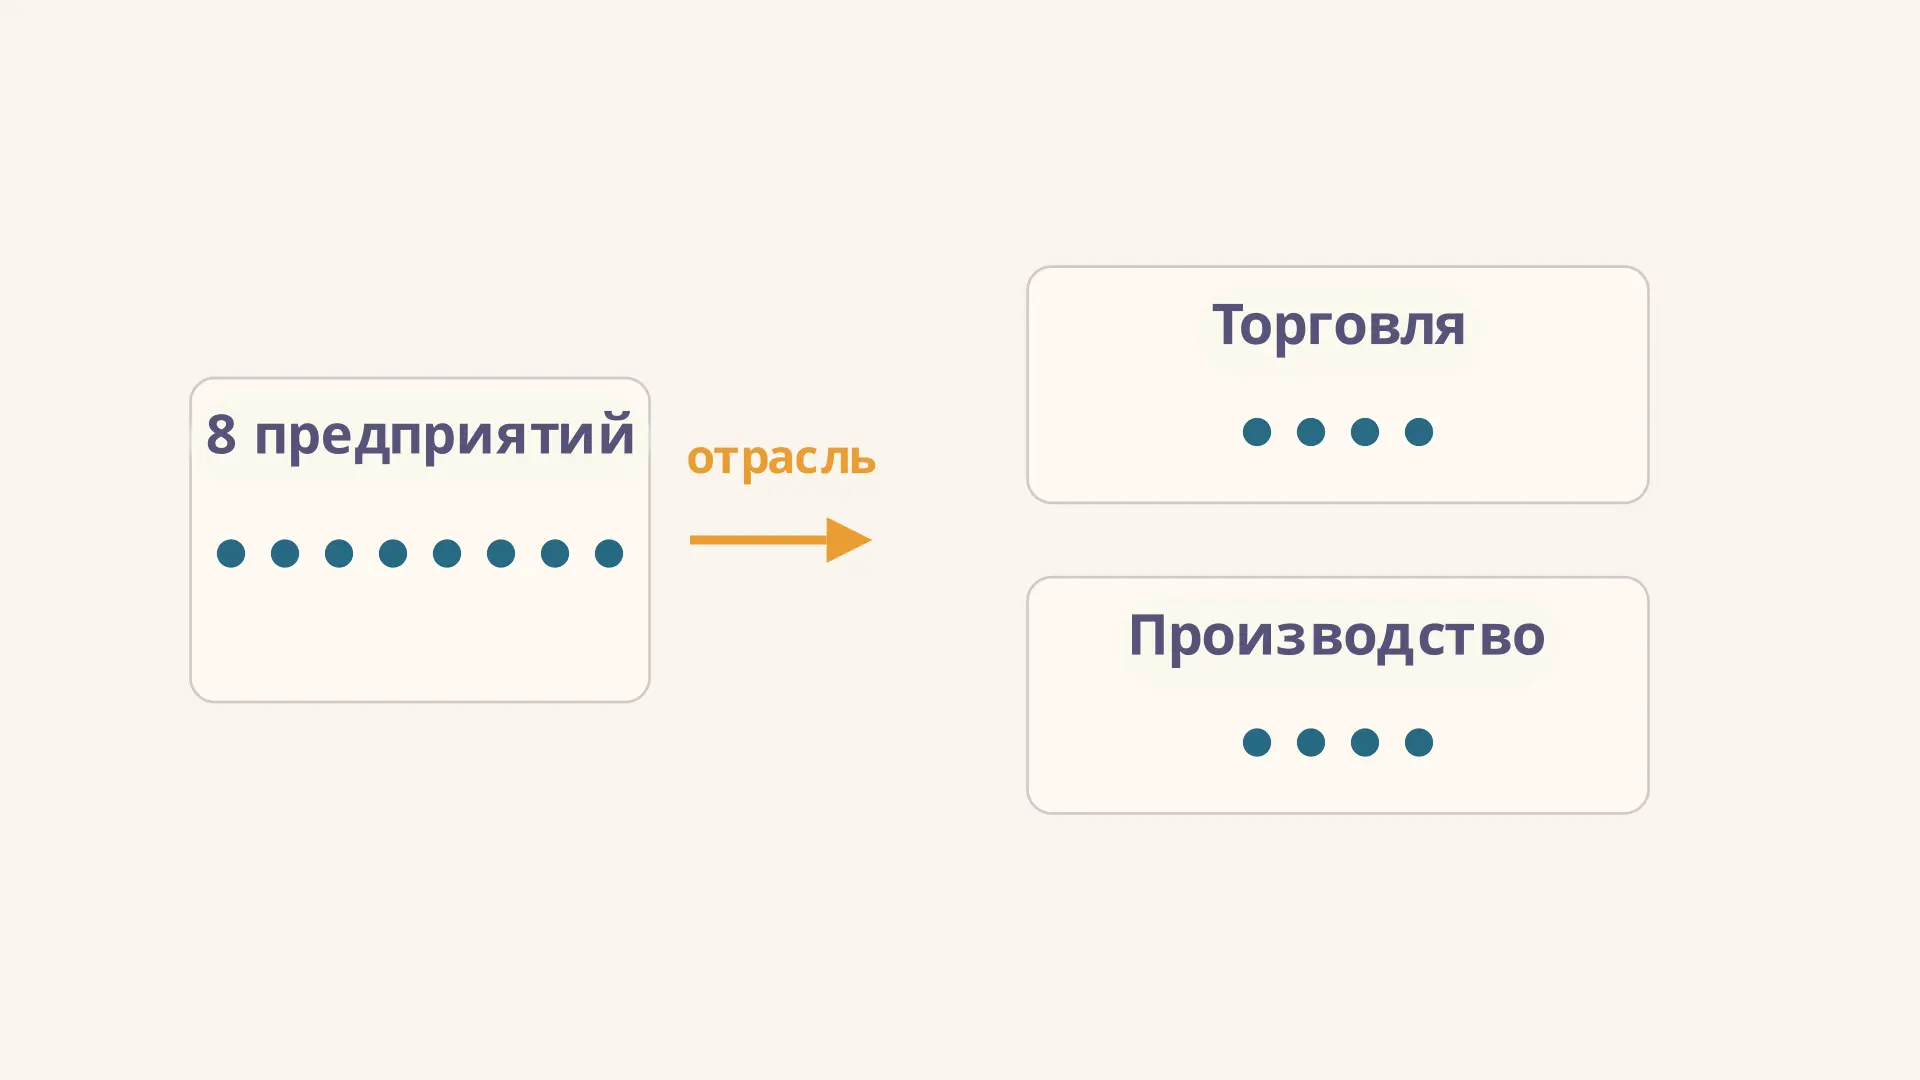
Группировочный признак: выбор и примеры в статистике
Что такое группировочный признак, как выбрать качественное или количественное основание группировки и проверить границы и состав групп на примере предприятий.