Суперскалярный процессор: принцип работы и IPC
Суперскалярный процессор способен выдавать на выполнение более одной инструкции за такт. Для этого в одном ядре предусмотрены несколько исполнительных ресурсов, а аппаратная логика ищет команды, которые готовы работать одновременно. Такое устройство использует параллелизм внутри потока инструкций: программе не обязательно запускать несколько потоков, чтобы ядро нашло независимые операции.
Но ширина выдачи задаёт верхнюю границу, а не гарантированный результат. Если каждая команда ждёт предыдущую, свободные блоки простаивают. В модели ниже можно менять ширину и число независимых цепочек и сравнивать среднее число операций за такт.
Что именно выполняется параллельно
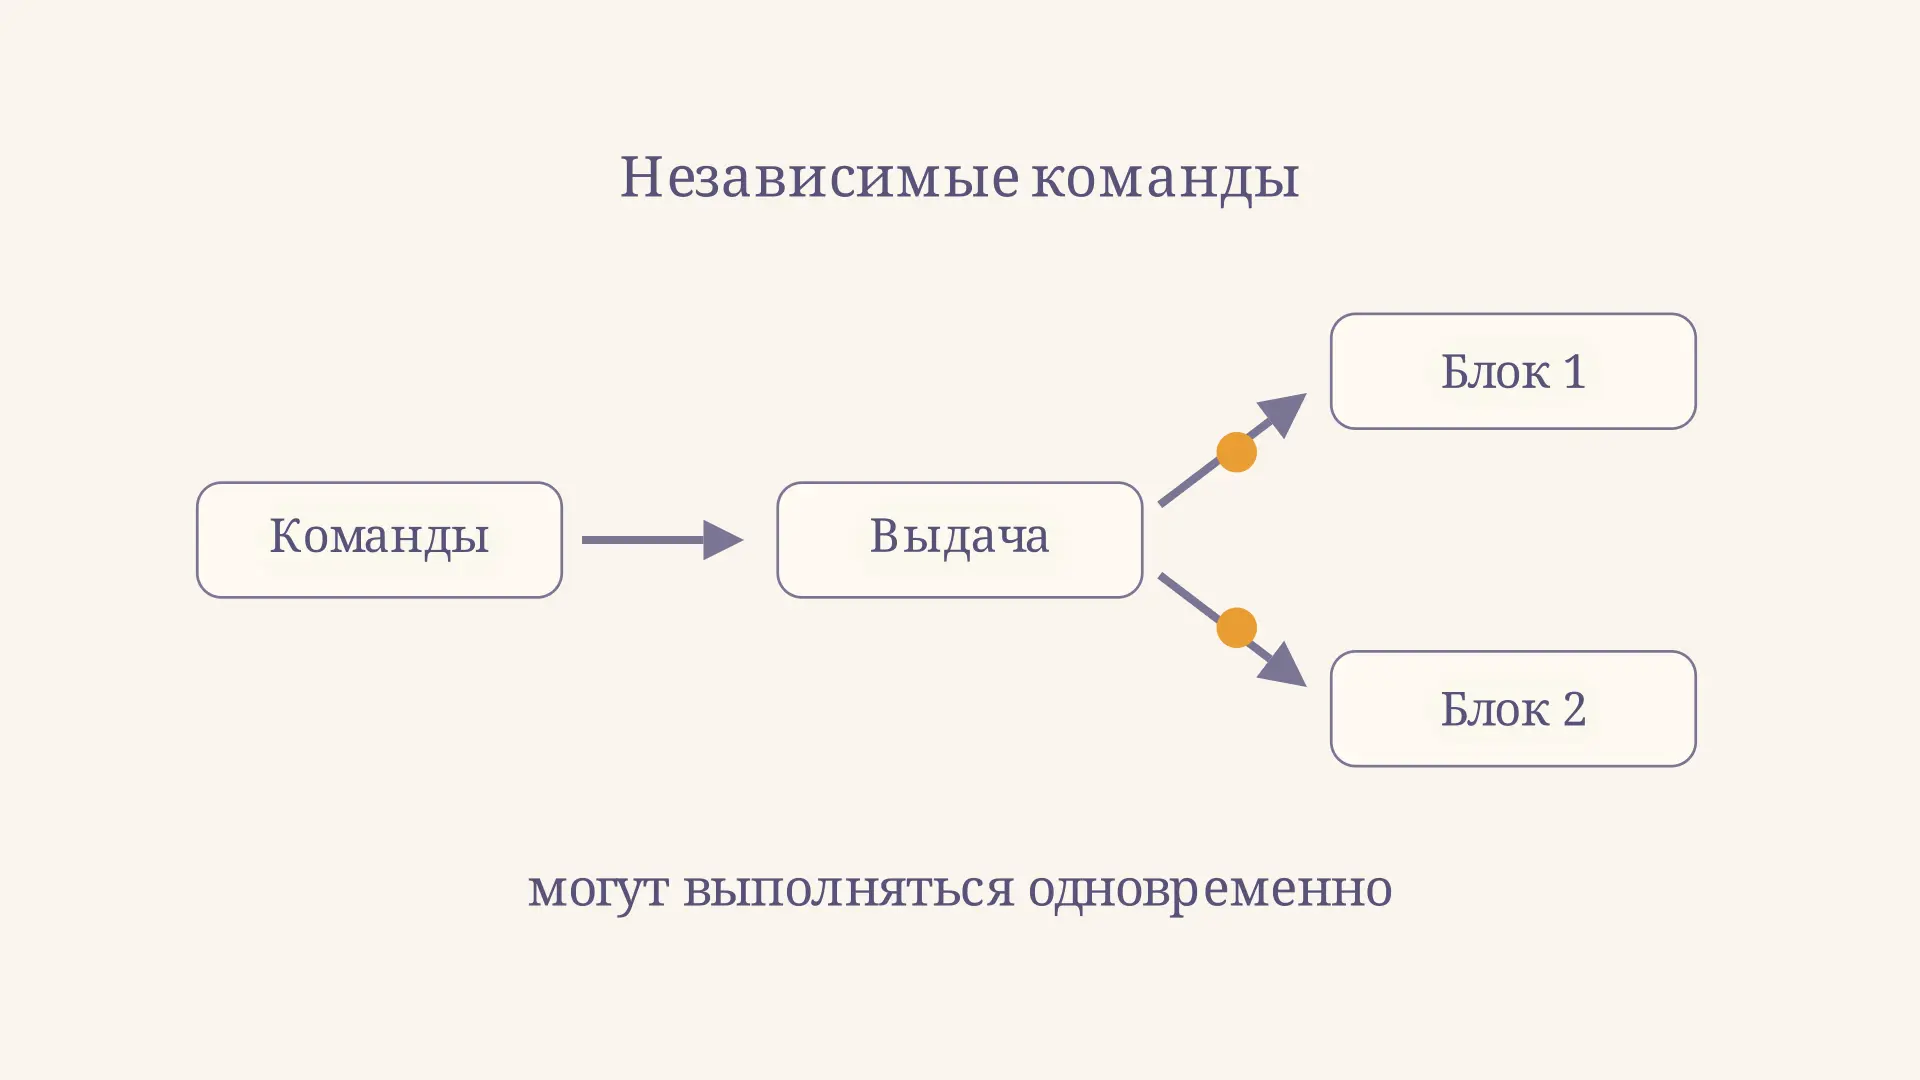
Представим две операции: первая складывает числа и , вторая умножает на . Если исходные данные готовы и доступны подходящие блоки, операции могут начать работу в одном такте. Теперь добавим третью: она складывает результаты первых двух. Ей придётся ждать обоих результатов. Параллелизм определяется не только количеством блоков, но и связями между операциями.
На схеме золотые маркеры обозначают две готовые операции. В реальном ядре одновременно могут находиться в работе и другие операции, начатые раньше. Рисунок показывает идею выдачи, а не точное устройство какого-либо процессора. Внешнее взаимодействие ядра с памятью и устройствами связано с шинами адреса, данных и управления, но наличие широкой шины само по себе не определяет ширину выдачи инструкций.
Важно уточнить терминологию. Архитектурная инструкция может преобразовываться внутри процессора в одну или несколько микроопераций. Ширину разных стадий поэтому описывают в разных единицах: инструкциях, микрооперациях или операциях за такт. В учебной модели ниже одна операция равна одной условной инструкции; смешивать эти единицы при анализе реального ядра нельзя.
Как команды проходят через ядро
Ядро выбирает инструкции из потока, декодирует их и передаёт на дальнейшую обработку. Планировщик отслеживает готовность операндов и доступность подходящих ресурсов. Готовые независимые операции могут быть направлены к разным исполнительным блокам, например целочисленным или работающим с памятью. Набор блоков и пути к ним зависят от микроархитектуры: наличие четырёх ресурсов не означает, что любые четыре операции совместимы с ними.
Современные реализации нередко используют внеочередное выполнение: более поздняя готовая операция начинает работу раньше ожидающей более ранней. При этом процессор должен сохранить корректный архитектурный результат программы. Для этого результаты спекулятивной работы удерживаются до завершения в допустимом порядке, а ошибочные действия могут быть отброшены. Суперскалярность и внеочередность связаны, но не тождественны: выдавать несколько готовых команд за такт можно и при выдаче по порядку.
Конвейеризация тоже решает другую задачу: она перекрывает стадии обработки разных команд во времени. Суперскалярная выдача добавляет возможность пропустить через соответствующую стадию несколько команд за один такт. Эти приёмы сочетаются, но один не гарантирует другого. Очередь готовых операций удобно представить через общую идею очереди как структуры данных, хотя настоящий планировщик выбирает по готовности и ограничениям ресурсов, а не обязательно строго по принципу FIFO.
Зависимости и переименование регистров
Главное ограничение - истинная зависимость по данным: операция читает результат предыдущей. Если , а затем , вторая операция не может получить правильный до появления результата первой. Увеличение числа исполнительных блоков не устраняет такую связь.
Бывают и зависимости из-за повторного использования имени регистра. Например, две независимые операции записывают разные промежуточные результаты в один архитектурный регистр. Переименование регистров позволяет связать эти записи с разными внутренними физическими регистрами и убрать некоторые ложные конфликты имён. Настоящую зависимость между производителем значения и его потребителем переименование не отменяет.
Зависимости памяти сложнее определить заранее: адреса загрузки и записи могут выясниться лишь во время выполнения. Процессор должен соблюдать применимые правила порядка памяти и проверять предположения о независимости. Ожидание данных при промахе кэша способно надолго занять ресурсы; трансляция адресов также участвует в работе подсистемы памяти. Её основы разобраны в статье о страничной организации виртуальной памяти.
Пример: 12 операций и ширина четыре
Возьмём упрощённое ядро с шириной выдачи четыре. Все операции одинаковы, каждая занимает один такт, а её результат доступен следующей операции цепочки в начале следующего такта. Данные уже готовы, блоков достаточно, выборка и завершение не создают задержек. Распределим 12 операций поровну между независимыми цепочками.
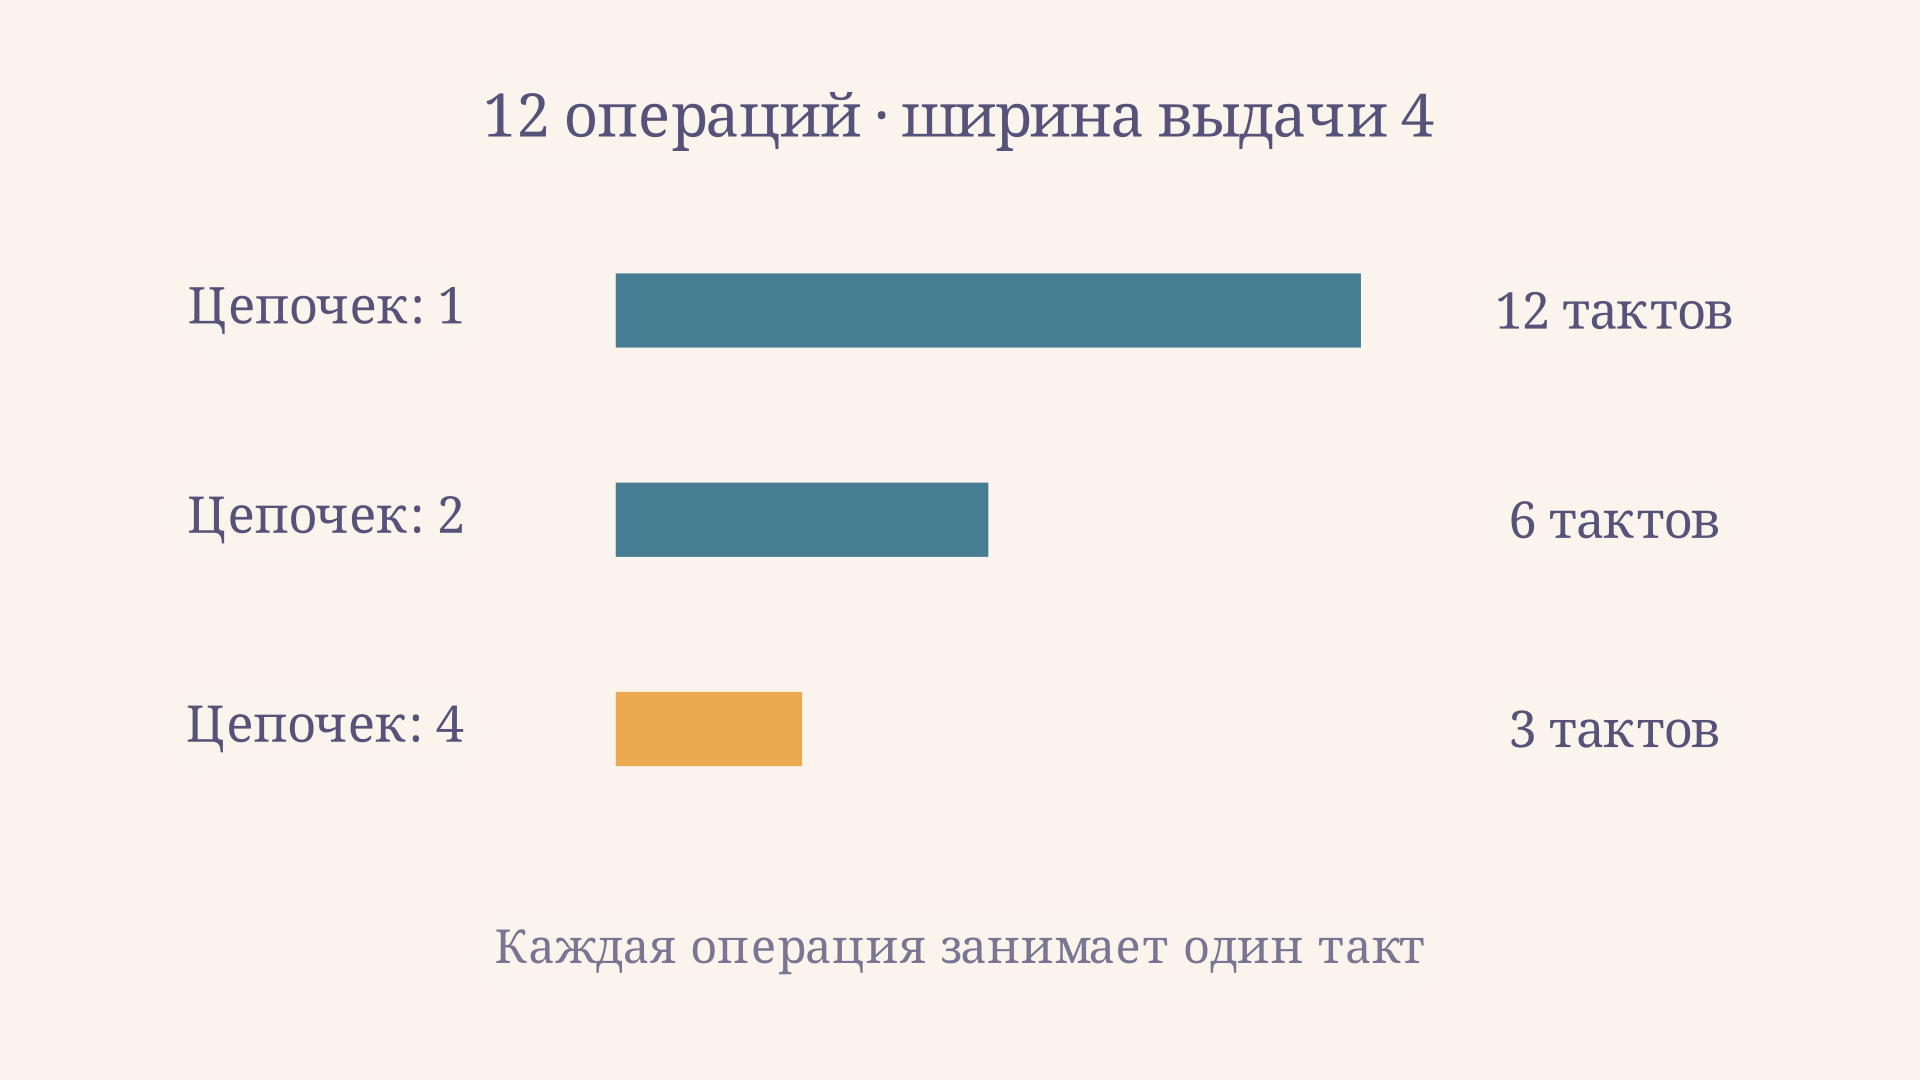
При одной цепочке каждый такт готова лишь одна операция: потребуется 12 тактов, средний . При двух цепочках можно выдавать по две операции, поэтому потребуется 6 тактов и . При четырёх цепочках выдаются четыре операции за такт, и все 12 завершаются за 3 такта: . В этой модели ширина четыре при двух цепочках не сокращает время относительно ширины два.
Число цепочек и ширина в калькуляторе можно менять отдельно. При ширине три и четырёх цепочках результат получают моделированием выдачи по тактам: из каждой готовой цепочки за такт допускается не более одной операции, а приоритет отдаётся цепочкам по порядку. Для заданных правил результат - 6 тактов и . Это следствие выбранного простого планировщика и конечного числа операций, а не универсальная формула для всех процессоров.
IPC, задержка и пропускная способность
- среднее число завершённых архитектурных инструкций на такт за выбранный интервал:
Обратная величина равна числу тактов на инструкцию: при ненулевом IPC имеем . Например, 120 завершённых инструкций за 60 тактов дают и . Это средние величины, поэтому они могут быть дробными. В примере калькулятора вместо реальных инструкций подсчитываются условные операции.
Задержка операции - время до готовности её результата; пропускная способность - частота, с которой блок способен принимать или завершать операции. Они могут различаться: конвейерный блок с задержкой несколько тактов способен принимать новую независимую операцию каждый такт. Длинная зависимая цепочка раскрывает задержку, а набор независимых цепочек помогает заполнить конвейер. Руководство Intel по оптимизации отдельно обсуждает задержку, пропускную способность и ограничения ресурсов.
IPC полезен только с контекстом. Разные наборы инструкций выполняют разный объём работы, а частота и число тактов также влияют на время. Поэтому сравнивать программы лишь по IPC недостаточно: важен результат задачи и время его получения. Например, другой алгоритм умножения может изменить само количество операций; это иллюстрирует алгоритм Карацубы.
Что мешает приблизиться к максимуму
Предел выдачи не достигается, когда поток содержит слишком мало готовых независимых операций. Другие причины - недостаточная скорость выборки или декодирования, конкуренция за один исполнительный блок, ожидание памяти и конечный размер внутренних очередей. Условный переход создаёт неопределённость о следующих инструкциях: предсказание позволяет продолжить работу заранее, но при ошибке неверный путь нужно отбросить.
Широкое ядро требует сложной логики выбора, дополнительных регистров и проводов. Поэтому увеличение ширины связано с затратами площади и энергии, а выигрыш зависит от программы. Иногда компилятор помогает открыть независимые операции, но перестановки допустимы только при сохранении смысла программы; например, зависимость суммы от предыдущего значения нельзя просто удалить.
Суперскалярность отличается и от SIMD: при SIMD одна векторная инструкция задаёт одинаковую операцию над несколькими элементами данных. Суперскалярное ядро, напротив, может одновременно обрабатывать несколько разных инструкций. Современный процессор способен сочетать оба механизма, как и несколько ядер, но это разные уровни параллелизма.
Частые ошибки
- Считать ширину фактическим IPC. Ширина ограничивает возможности стадии; реальное среднее зависит от всей программы и устройства ядра.
- Путать такт с временем одной инструкции. Инструкции могут перекрываться, а их задержки различаются.
- Считать переименование устранением всех зависимостей. Истинную передачу результата от производителя к потребителю оно сохраняет.
- Приравнивать суперскалярность к многоядерности. Несколько исполнительных ресурсов внутри ядра и несколько ядер - разные вещи.
FAQ
Обязан ли суперскалярный процессор выполнять команды вне очереди? Нет. Он может выдавать несколько команд за такт и при соблюдении программного порядка выдачи, если команды готовы и ресурсы доступны.
Может ли IPC быть больше единицы? Да. Если за измеренный интервал завершено больше инструкций, чем прошло тактов, средний IPC превышает единицу. Для корректного сравнения важно использовать одинаковое определение инструкции и интервала.
Всегда ли четыре блока дают ускорение в четыре раза? Нет. Зависимости, конкуренция за ресурсы и ожидание памяти могут оставить часть блоков незанятой. Четырёхкратный результат в примере достигается только при явно заданных идеальных условиях.
Коротко
Суперскалярное ядро использует независимость команд, чтобы выдавать несколько операций за такт. Ширина выдачи, доступные исполнительные блоки и готовность данных вместе определяют возможный параллелизм. IPC отражает среднее число завершённых инструкций за такт, но реальную скорость программы нужно оценивать в контексте выполняемой работы и всей системы.
Читайте также
Архитектура VLIW: пакеты команд и параллелизм
Архитектура VLIW простыми словами: как компилятор собирает независимые операции в пакеты, что ограничивает их заполнение и чем подход отличается от суперскалярного.
Конвейер команд процессора: стадии и расчёт
Как работает конвейер команд процессора: пять стадий, расчёт тактов и ускорения на примере, зависимости данных, остановки и влияние условных переходов на результат.
Арифметико-логическое устройство АЛУ: функции
Что делает арифметико-логическое устройство: операции над битами, сложение с переносом, флаги и пример четырёхразрядного АЛУ с интерактивным расчётом.
Сравнение RISC и CISC: команды и производительность
Сравниваем RISC и CISC по набору команд, работе с памятью и кодированию. На учебном примере считаем время выполнения и разбираем распространённые мифы.
Шина адреса, данных и управления процессора: разрядность
Шина адреса, данных и управления процессора связывает ЦП с памятью: как разрядность каждой шины определяет адресуемую память, объём передачи за такт и пропускную способность.
Абсолютно неупругий удар: сохранение импульса
Как найти скорость тел после абсолютно неупругого удара, применить закон сохранения импульса и вычислить потерю кинетической энергии на понятных примерах с формулами.