Архитектура VLIW: пакеты команд и параллелизм
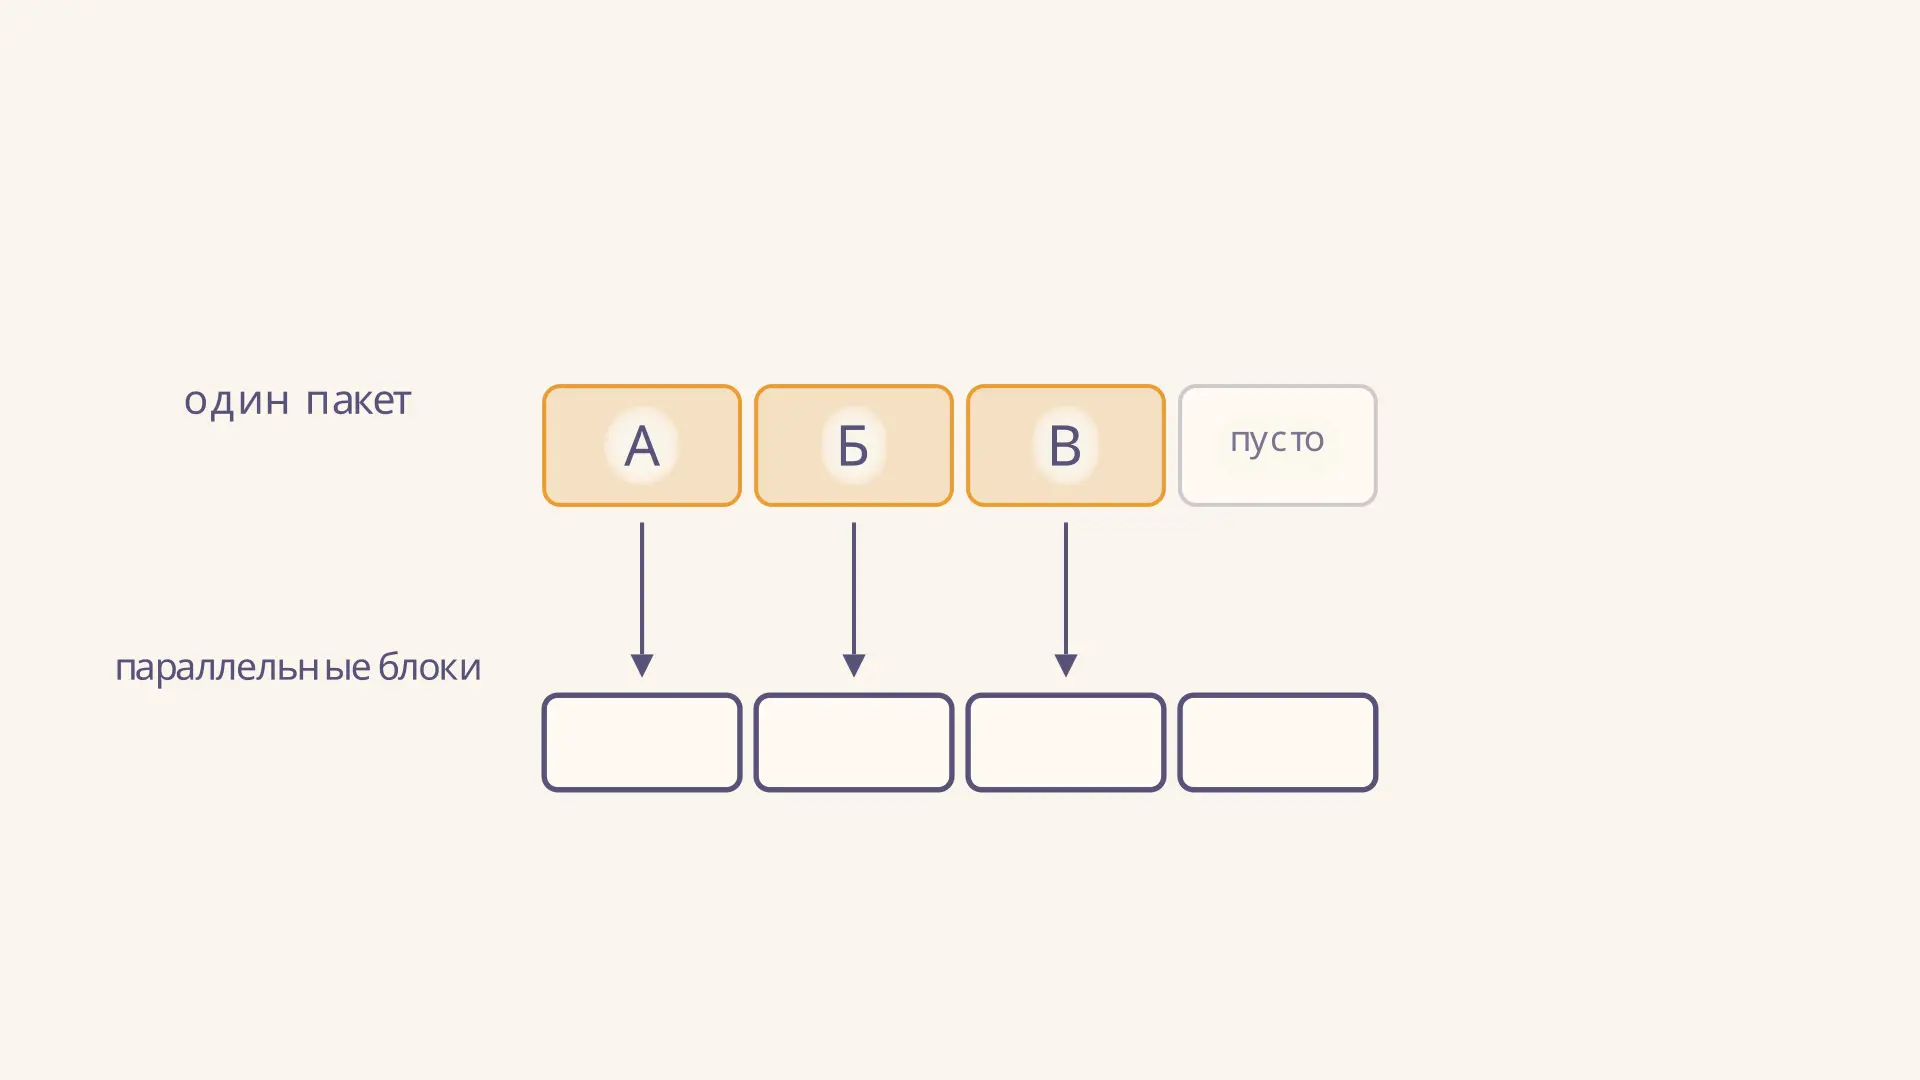
Архитектура VLIW (Very Long Instruction Word, «очень длинное командное слово») позволяет явно задать несколько операций для параллельного запуска. Компилятор заранее размещает подходящие операции в одном пакете, а процессор направляет их к исполнительным блокам. Выигрыш зависит от того, сколько независимой работы удалось найти и какие ограничения накладывает конкретная машина. В калькуляторе ниже можно изменить ширину пакета для маленького учебного примера и увидеть, почему больше слотов не всегда означает лучшее заполнение.
Что такое пакет VLIW
В обычном последовательном описании программы операции записаны друг за другом. Однако соседство в тексте ещё не означает зависимость: сложение двух чисел и независимое умножение других могут выполняться одновременно. VLIW выносит такое решение в представление программы: одна широкая команда или пакет содержит несколько полей, соответствующих операциям, которые разрешено запустить совместно.
Внутри процессора работают исполнительные устройства: например, блоки целочисленной арифметики, умножения или обращения к памяти. Поле пакета часто называют слотом. Его допустимое содержимое определяется набором команд конкретной архитектуры: слот не обязательно подходит для любой операции. Процессор читает пакет и выдаёт входящие в него операции соответствующим устройствам. Параллельный запуск не означает, что результаты обязательно будут готовы одновременно: задержки разных операций могут различаться.
Этот способ использует параллелизм на уровне команд: работу делят не между несколькими программами или потоками, а между независимыми операциями одного потока. Описание алгоритма и его аппаратное расписание отвечают на разные вопросы. Например, алгоритм Карацубы задаёт способ умножения, а планирование команд определяет, когда доступные операции его реализации могут запускаться на выбранном процессоре.
Пример: шесть операций и четыре слота
Рассмотрим намеренно простую машину с четырьмя одинаковыми слотами. Есть операции А, Б, В первого уровня и операции Г, Д, Е второго: Г использует результат А, Д зависит от Б, Е - от В. Каждый результат готов к началу следующего такта, конфликтов ресурсов нет. Для наглядности будем считать, что весь второй уровень начинается после завершения первого.
Компилятор помещает А, Б, В в первый пакет, а Г, Д, Е - во второй. Каждый пакет имеет четыре места, но содержит лишь три полезные операции. Всего за два такта занято шесть из восьми мест. Заполнение рассчитывается так:
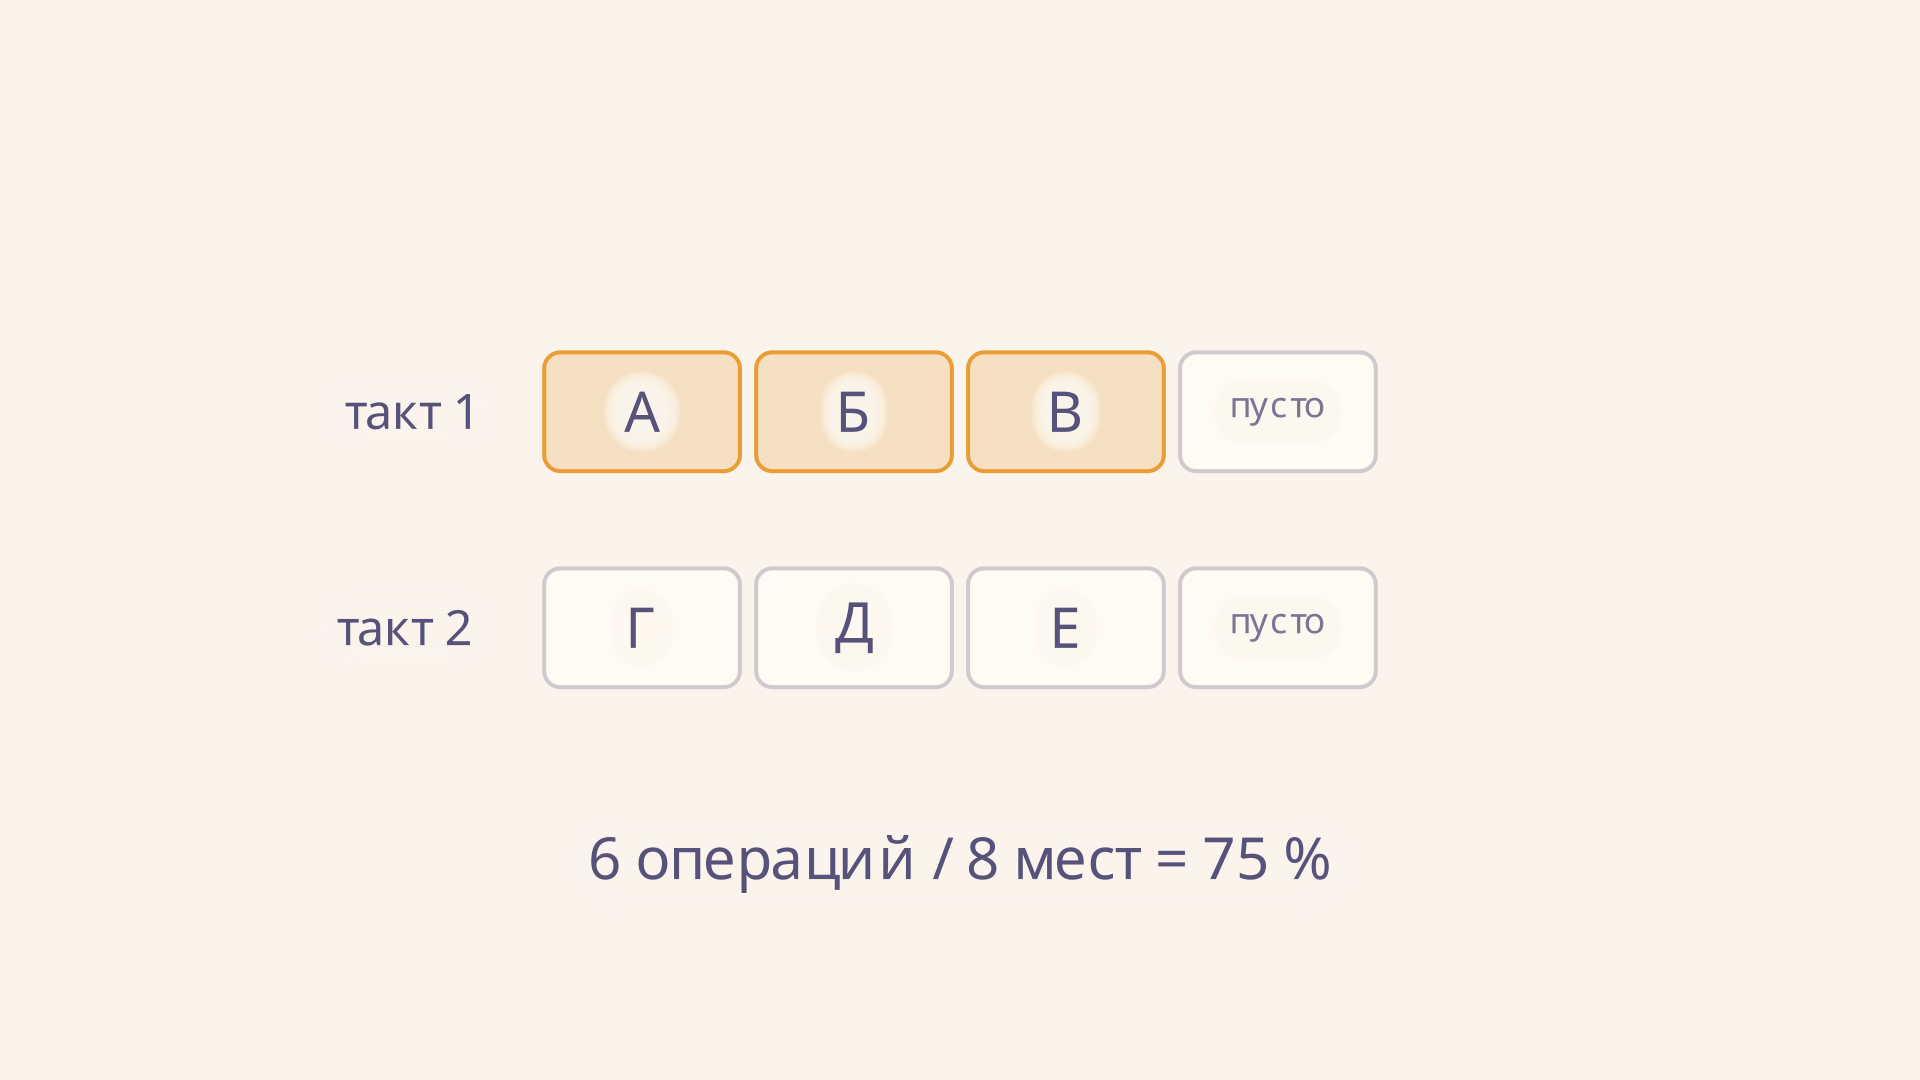
При трёх слотах те же два уровня занимают два такта и заполняют все шесть мест. При двух слотах каждый уровень делится на два пакета: потребуется четыре такта, а заполнение составит 75 %. При одном слоте нужно шесть тактов. Эти числа относятся только к указанной модели: реальная длительность зависит от типов блоков, задержек, памяти и других условий. Если разрешить запускать отдельную операцию второго уровня сразу после готовности её собственного входа, расписание в некоторых конфигурациях тоже может измениться.
Как компилятор составляет расписание
Сначала компилятор определяет отношения между операциями: какие результаты нужны следующим действиям и какие перестановки сохраняют смысл программы. Это удобно представить направленным графом: вершины - операции, стрелка от А к Г означает, что Г читает результат А. Подробнее о свойствах графов можно прочитать в статье про радиус и диаметр графа; здесь граф нужен для выявления порядка, а не для вычисления расстояний.
Затем планировщик сопоставляет готовые операции доступным слотам и исполнительным блокам. Он учитывает, например, что умножение может занимать отдельный блок, а загрузка данных выдаёт результат через несколько тактов. Когда подходящей операции нет, место остаётся незанятым либо кодируется как операция без действия. Конкретный формат пустых мест зависит от ISA; нельзя считать, что все VLIW-машины хранят одинаковые явные NOP.
Планирование может выходить за пределы одного простого участка программы. Развёртывание цикла создаёт несколько копий его тела, открывая больше независимых операций из разных итераций. Программный конвейер совмещает стадии разных итераций, если зависимости это разрешают. Цена таких преобразований - дополнительный код, потребность в регистрах и сложность обработки границ цикла. Руководство компилятора Texas Instruments для C6000 описывает инструменты компиляции для конкретного семейства; параметры его реальных инструкций нужно брать из документации этого семейства, а не из нашей модели.
Что мешает заполнить пакет
Главное ограничение - зависимость по данным. Если операция читает значение, которое ещё не вычислено, запускать её рано. Кроме того, две операции могут конкурировать за единственный блок умножения или порт памяти. Даже при наличии свободного арифметического слота это не создаст второй порт. Зависимости по записи и чтению регистров также требуют внимания; часть ложных зависимостей можно устранить переименованием регистров, если доступных регистров достаточно.
Ветвление осложняет задачу: заранее не всегда известно, какой участок будет выполняться. Доступ к памяти тоже может иметь переменную задержку, а анализ того, указывают ли два адреса на одну область, бывает неубедительным. Компилятор обязан сохранять корректность, поэтому не каждую операцию можно безопасно перенести через другую. В многопоточной программе к этому добавляются правила видимости памяти и синхронизации; общую интуицию о конфликте доступа помогает развить задача обедающих философов, хотя она разбирает другую грань параллелизма.
Пустые места показывают не обязательно плохой компилятор: программа может просто не содержать достаточно независимой работы. А заполненный пакет сам по себе не гарантирует высокой скорости - операции могут ждать память или выполнять разный объём полезной работы. Как и в любой модели в науке, результат нужно читать вместе с её допущениями.
VLIW и суперскалярный процессор
Оба подхода способны запускать несколько операций за такт. Основное различие - где выражается и выбирается параллелизм. В VLIW совместно запускаемые операции представлены явно, а компилятор заранее составляет расписание для целевой машины. В типичном динамически планируемом суперскалярном процессоре аппаратная логика во время исполнения определяет готовность операций и доступность ресурсов, иногда меняя порядок их выполнения при сохранении видимого результата программы.
Это сравнение описывает тенденцию, а не абсолютный запрет: конкретные реализации могут сочетать статические и динамические механизмы, в том числе ожидание при непредсказуемой задержке. VLIW может упростить часть аппаратной логики выбора операций, но предъявляет высокие требования к компилятору и предсказуемости машины. Изменение числа блоков или задержек в следующем поколении может потребовать новой компиляции для хорошей эффективности; совместимость зависит от архитектурного контракта, а не только от названия подхода.
Где полезен VLIW
Такой подход уместен там, где повторяющиеся вычисления хорошо анализируются заранее и известны особенности целевого устройства. Пример направления применения - цифровая обработка сигналов: компилятор может извлекать параллелизм из циклов фильтрации и других регулярных вычислений. При этом семейства и конкретные ядра различаются, поэтому по одному слову VLIW нельзя восстановить ни число блоков, ни формат команды, ни гарантированную производительность.
Оценивать устройство стоит по задаче целиком: важны качество компилятора, доступ к памяти, размер кода, энергопотребление и то, насколько часто программа меняет поток управления. Ширина пакета - лишь одна характеристика. Её полезно сравнивать с реально доступным параллелизмом, а не воспринимать как прямой множитель ускорения.
Частые ошибки
- Считать все слоты универсальными. В примере они одинаковые по условию, но реальные слоты и блоки могут поддерживать разные операции.
- Забывать о задержке результата. Одновременная выдача допустима только при соблюдении зависимостей и правил конкретного процессора.
- Приравнивать заполнение к ускорению. Доля занятых мест не измеряет время ожидания памяти и полезную работу программы.
- Считать параллельность пакета многопоточностью. Здесь речь об операциях одного потока команд, хотя система может поддерживать и другие формы параллелизма.
FAQ
Зачем нужно длинное командное слово?
Оно представляет несколько операций, предназначенных для совместной выдачи. Название описывает принцип упаковки; точная длина и формат зависят от конкретной ISA.
Всегда ли четыре слота дают ускорение в четыре раза?
Нет. Зависимости, ограниченные ресурсы и ожидание памяти мешают постоянно использовать все четыре слота. Для корректного сравнения нужна конкретная программа и базовая машина.
Чем VLIW отличается от SIMD?
VLIW объединяет потенциально разные независимые операции в пакет. SIMD применяет одну операцию к нескольким элементам данных; некоторые процессоры могут сочетать оба механизма.
Коротко
VLIW делает параллелизм операций явным в пакетах, которые обычно формирует компилятор. Он должен соблюдать зависимости и ограничения блоков; поэтому ширина пакета задаёт лишь верхнюю границу числа выдаваемых операций. В учебной схеме с четырьмя слотами и двумя уровнями по три операции шесть из восьми мест заняты, то есть заполнение равно 75 %.
Читайте также
Суперскалярный процессор: принцип работы и IPC
Как суперскалярный процессор выполняет несколько команд за такт, почему зависимости мешают параллелизму и как рассчитать IPC на наглядном учебном примере с цепочками операций.
Арифметико-логическое устройство АЛУ: функции
Что делает арифметико-логическое устройство: операции над битами, сложение с переносом, флаги и пример четырёхразрядного АЛУ с интерактивным расчётом.
Конвейер команд процессора: стадии и расчёт
Как работает конвейер команд процессора: пять стадий, расчёт тактов и ускорения на примере, зависимости данных, остановки и влияние условных переходов на результат.
Сравнение RISC и CISC: команды и производительность
Сравниваем RISC и CISC по набору команд, работе с памятью и кодированию. На учебном примере считаем время выполнения и разбираем распространённые мифы.
Шина адреса, данных и управления процессора: разрядность
Шина адреса, данных и управления процессора связывает ЦП с памятью: как разрядность каждой шины определяет адресуемую память, объём передачи за такт и пропускную способность.
Абсолютно неупругий удар: сохранение импульса
Как найти скорость тел после абсолютно неупругого удара, применить закон сохранения импульса и вычислить потерю кинетической энергии на понятных примерах с формулами.