Проверочная матрица линейного кода: синдром и пример
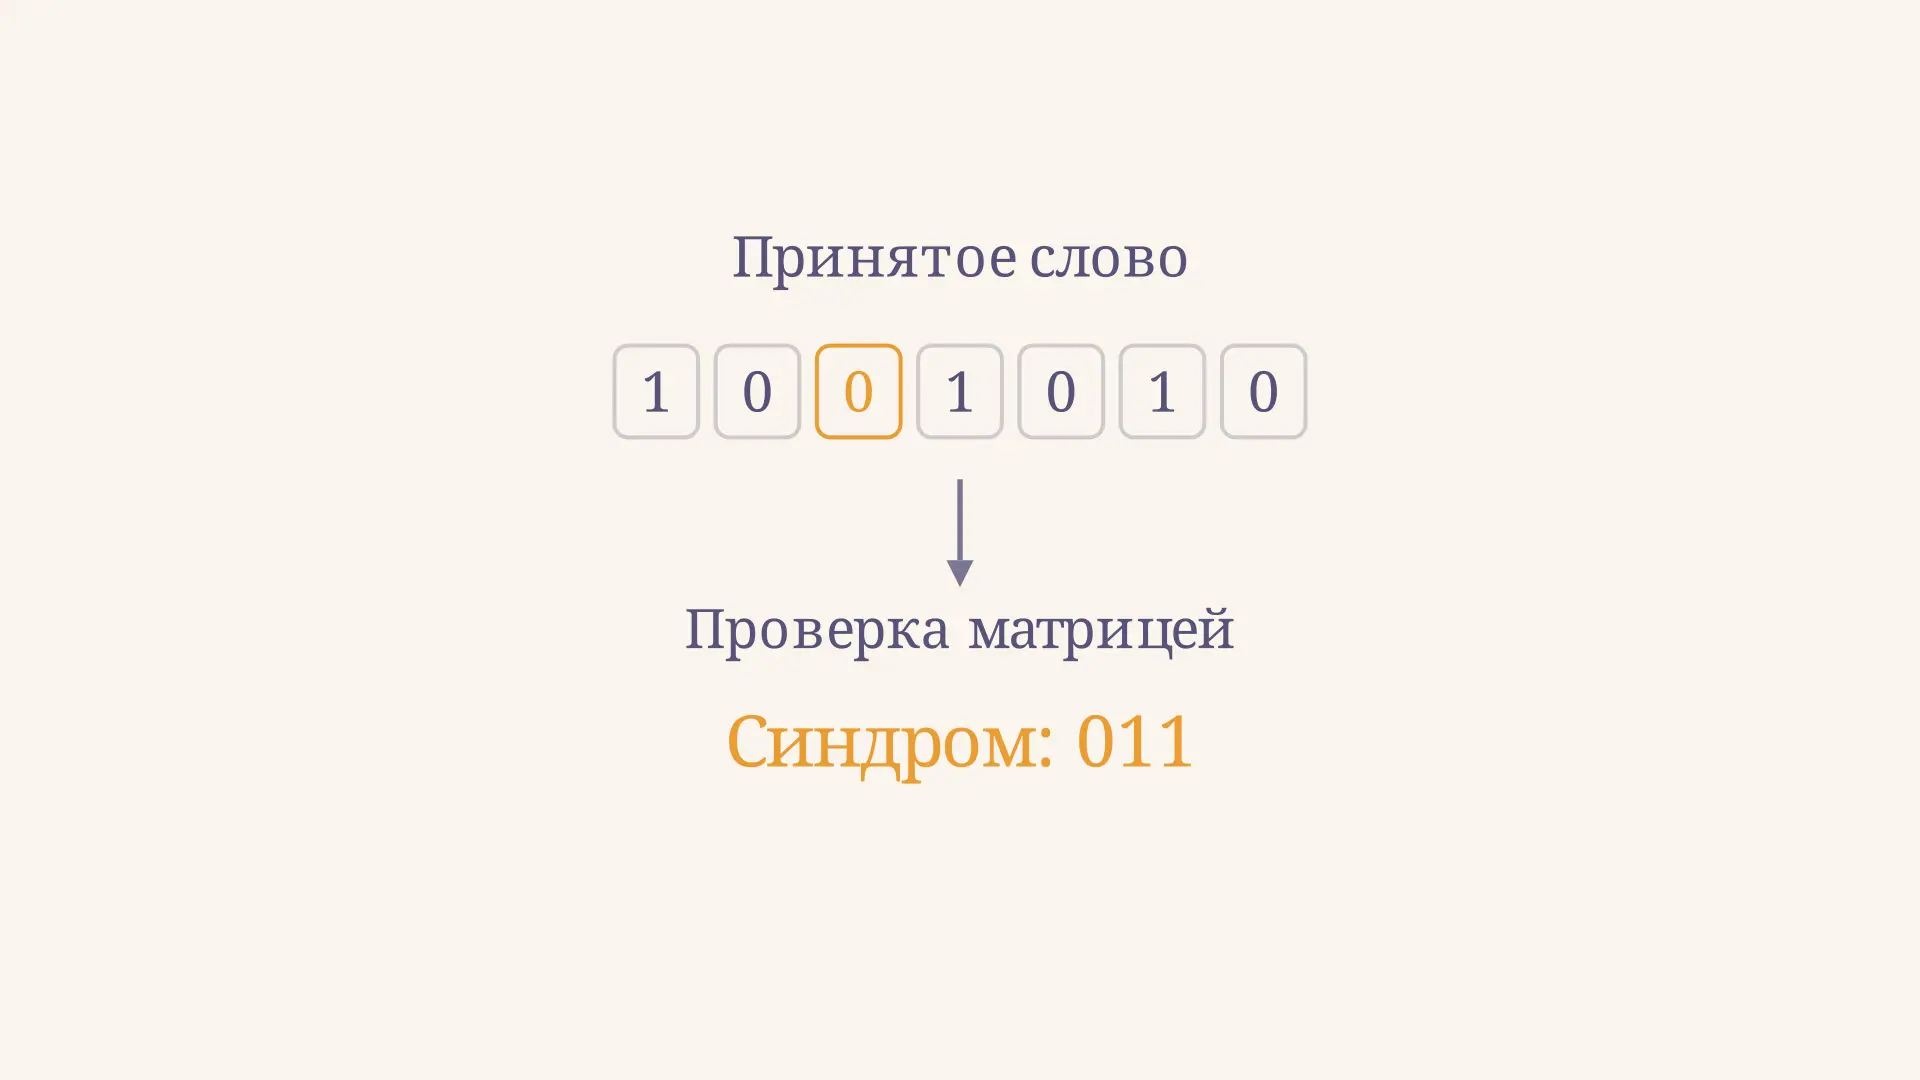
Проверочная матрица линейного кода - это набор уравнений, которым должно удовлетворять каждое кодовое слово. Умножив на неё принятое слово, получают синдром: он показывает, какие проверки нарушены. На примере двоичного кода Хэмминга разберём вычисление и увидим, когда синдром помогает найти ошибочный бит. В интерактиве можно менять его позицию и сравнивать результат со столбцами матрицы.
Что проверяет матрица
Линейный код длины и размерности над полем - подпространство множества двоичных векторов длины . Его элементы называют кодовыми словами. Сложение здесь выполняется по модулю 2: , а вычитание совпадает со сложением. Близкая запись чисел объясняется в статье о двоичной системе счисления.
Проверочная матрица размера полного строкового ранга задаёт код как множество решений
Здесь - строка из битов, - столбец. Каждая строка задаёт одну проверку чётности: единицы в ней выбирают позиции, сумма которых должна быть чётной. Так, строка требует по модулю 2. Необязательно хранить все допустимые слова списком: достаточно проверить уравнения. В более общем определении допускаются и избыточные строки; тогда их число может превышать , но ранг остаётся .
Пример матрицы кода Хэмминга
Возьмём код длины семь с матрицей
Её семь столбцов - все ненулевые трёхбитовые векторы от до в указанном порядке. Три строки независимы: столбцы 1, 2 и 4 образуют единичную матрицу с переставленными столбцами. Поэтому ранг равен трём, размерность кода , а число кодовых слов равно . Число независимых проверок показывает, сколько степеней свободы они убирают, но позиции информационных и проверочных битов зависят от выбранного представления.
Проверим . Три суммы по выбранным строками позициям равны соответственно , и . Остаток каждой от деления на два равен нулю, следовательно, . Это конкретное слово допустимо. Обычное правило умножения матриц по строкам и столбцам сохраняется, меняется только арифметика поля.
Как получить допустимое слово
Проверочную матрицу можно использовать и для построения слова, решив её уравнения относительно выбранных проверочных позиций. Для нашей матрицы удобно оставить информационными позиции 3, 5, 6 и 7: они могут принимать любые значения. Тогда проверки имеют вид
В двоичном поле перенос через знак равенства не меняет знак. Поэтому , , а . Все суммы вновь берутся по модулю 2. Например, для информационных битов получаем , и . Записывая все семь позиций в исходном порядке, получаем уже знакомое слово .
Важно не приклеивать вычисленные биты к концу без перестановки остальных: в этой матрице проверочные позиции находятся в начале и середине слова. В другой систематической записи они могут стоять в конце, и формулы будут выглядеть иначе. Сам код при согласованной перестановке координат имеет те же параметры и расстояние, но значения синдрома для заданного номера позиции следует читать по новой матрице.
Как найти синдром принятого слова
Пусть передано , но третий бит изменился. Получатель видит и вычисляет
По строкам это , и ; остатки дают . Вектор ошибки содержит единицу только на третьей позиции. Поскольку , линейность даёт
Для одиночной ошибки произведение выбирает соответствующий столбец . Столбец стоит третьим, поэтому при условии не более одной ошибки меняем третий бит обратно и получаем .
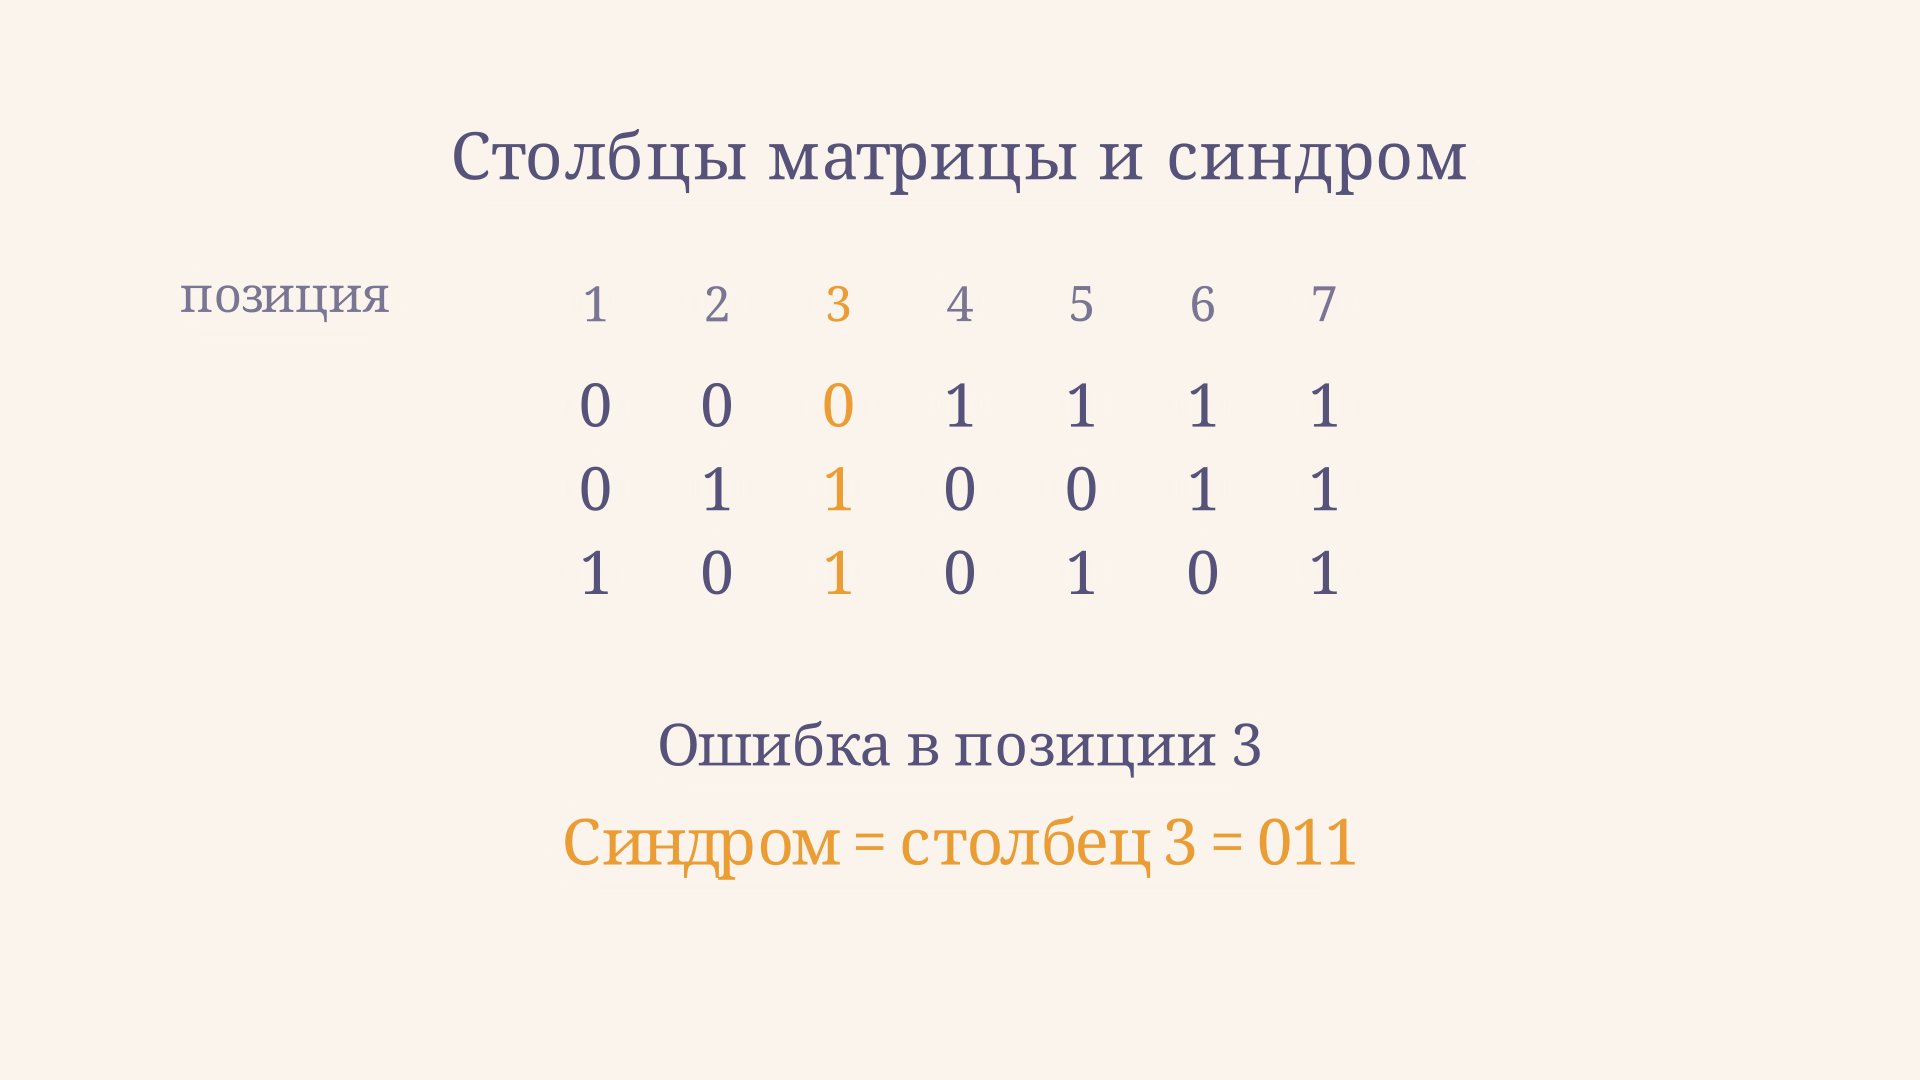
Порядок битов синдрома важен: его читают сверху вниз в том же порядке, в каком записаны строки матрицы. Если переставить строки, изменится запись синдрома и столбцов, но не множество слов, проходящих проверки. Если переставить столбцы, одновременно нужно переставить соответствующие позиции слов. Разные соглашения объясняют, почему в учебниках матрица того же кода может выглядеть иначе.
Что синдром может и чего не может показать
Ненулевой синдром доказывает, что принятое слово не принадлежит коду. Нулевой означает лишь, что оно удовлетворяет всем проверкам; он не гарантирует отсутствия ошибок при передаче. Если вектор ошибки сам является ненулевым кодовым словом, то , и получатель не заметит подмену только по синдрому.
Для двух ошибок синдром равен сумме двух столбцов. В нашем примере ошибки в позициях 1 и 2 дают - тот же синдром, что и одиночная ошибка в позиции 3. Если безусловно исправить третий бит, результат окажется другим кодовым словом. Поэтому правило «синдром равен номеру ошибки» действует здесь только в выбранном порядке столбцов и при предположении об одной ошибке. В общем случае декодер выбирает предполагаемый вектор ошибки по модели канала или использует другие сведения.
Синдром как результат нескольких проверок
Синдром удобно читать не только как двоичное число, но и как список ответов отдельных проверок. Первый разряд отвечает первой строке матрицы, второй - второй, третий - третьей. Единица означает нечётную сумму на выбранных этой строкой позициях, а ноль - чётную. Сами по себе эти ответы не говорят, какой именно бит изменился: для вывода нужно сравнить весь вектор с известными последствиями возможных ошибок.
В учебном примере у каждой позиции свой ненулевой столбец, поэтому семь одиночных ошибок дают семь разных синдромов. Восьмой синдром, , соответствует отсутствию ошибки в рассматриваемом наборе вариантов. Это не перечисление всех возможных векторов ошибки: всего их , поэтому многие дают одинаковый результат проверки. Такой подход к декодированию описан в учебных материалах MIT.
Как построить H по порождающей матрице
Порождающая матрица описывает код с другой стороны: из информационной строки получают . Для систематической двоичной матрицы
можно взять
Действительно, по модулю 2, а единичный блок обеспечивает полный ранг . В поле иной характеристики вместо первого блока пишут . Для несистематической найдите базис решений системы над нужным полем и запишите эти векторы строками . Убедитесь, что строк ровно и они независимы: одного условия недостаточно, если проверок слишком мало.
Та же логика применяется к другим семействам, например к кодам Рида - Маллера. Строковые преобразования над полем сохраняют её ядро, если обратимы; потому проверочная матрица одного кода не единственна.
Как по столбцам определить расстояние
Расстояние Хэмминга между словами - число различающихся позиций. Для линейного кода минимальное расстояние равно минимальному числу ненулевых позиций ненулевого кодового слова. Условие говорит, что сумма столбцов с номерами ненулевых координат равна нулю. Поэтому - наименьшее число линейно зависимых столбцов .
В нашей матрице нет нулевого столбца и одинаковых столбцов, значит зависимость из одного или двух столбцов невозможна. Но , поэтому . Такой код гарантированно обнаруживает до двух ошибок или исправляет одну; одновременно обещать исправление одной и обнаружение любой второй ошибки стандартным декодером нельзя. Общий принцип - исправление до ошибок. Подробнее устройство этого семейства разобрано в статье о коде Хэмминга.
Где встречаются проверочные матрицы
Проверки чётности используют при передаче и хранении цифровых данных, когда избыточность помогает выявить и исправить искажения. Для длинных кодов важна не только исправляющая способность, но и стоимость вычислений. У LDPC-кодов матрица проверок разрежена: в ней относительно мало единиц, что позволяет строить эффективные итеративные алгоритмы. Однако разреженность сама по себе не гарантирует исправления любой конкретной ошибки: результат зависит от кода и декодера.
Частые ошибки
- Считать в обычной арифметике до конца. Суммы нужно уменьшить по модулю 2: например, превращается в .
- Путать и . Одна матрица задаёт проверки, другая порождает слова; их размеры и роли различны.
- Принимать нулевой синдром за доказательство безошибочной передачи. Ошибка может перевести одно кодовое слово в другое.
- Исправлять любую ненулевую комбинацию как одиночную ошибку. При нескольких ошибках синдром может совпасть с одиночным.
FAQ
Всегда ли у синдрома есть единственная позиция ошибки?
Нет. Для одиночных ошибок это верно, когда все столбцы ненулевые и различны. При нескольких ошибках совпадения синдромов возможны даже тогда.
Сколько строк должно быть у H?
У полной по рангу матрицы без избыточных проверок для кода ровно строк. Можно добавить зависимые проверки, сохранив тот же код.
Можно ли восстановить код по H?
Да. Его слова - все решения над заданным полем. Базис этого ядра можно записать строками порождающей матрицы.
Коротко
Проверочная матрица задаёт линейный код через систему проверок, а синдром показывает их результат для принятого слова. В выбранном коде Хэмминга синдром одиночной ошибки совпадает со столбцом её позиции; вывод об исправлении зависит от предположения о числе ошибок.
Читайте также
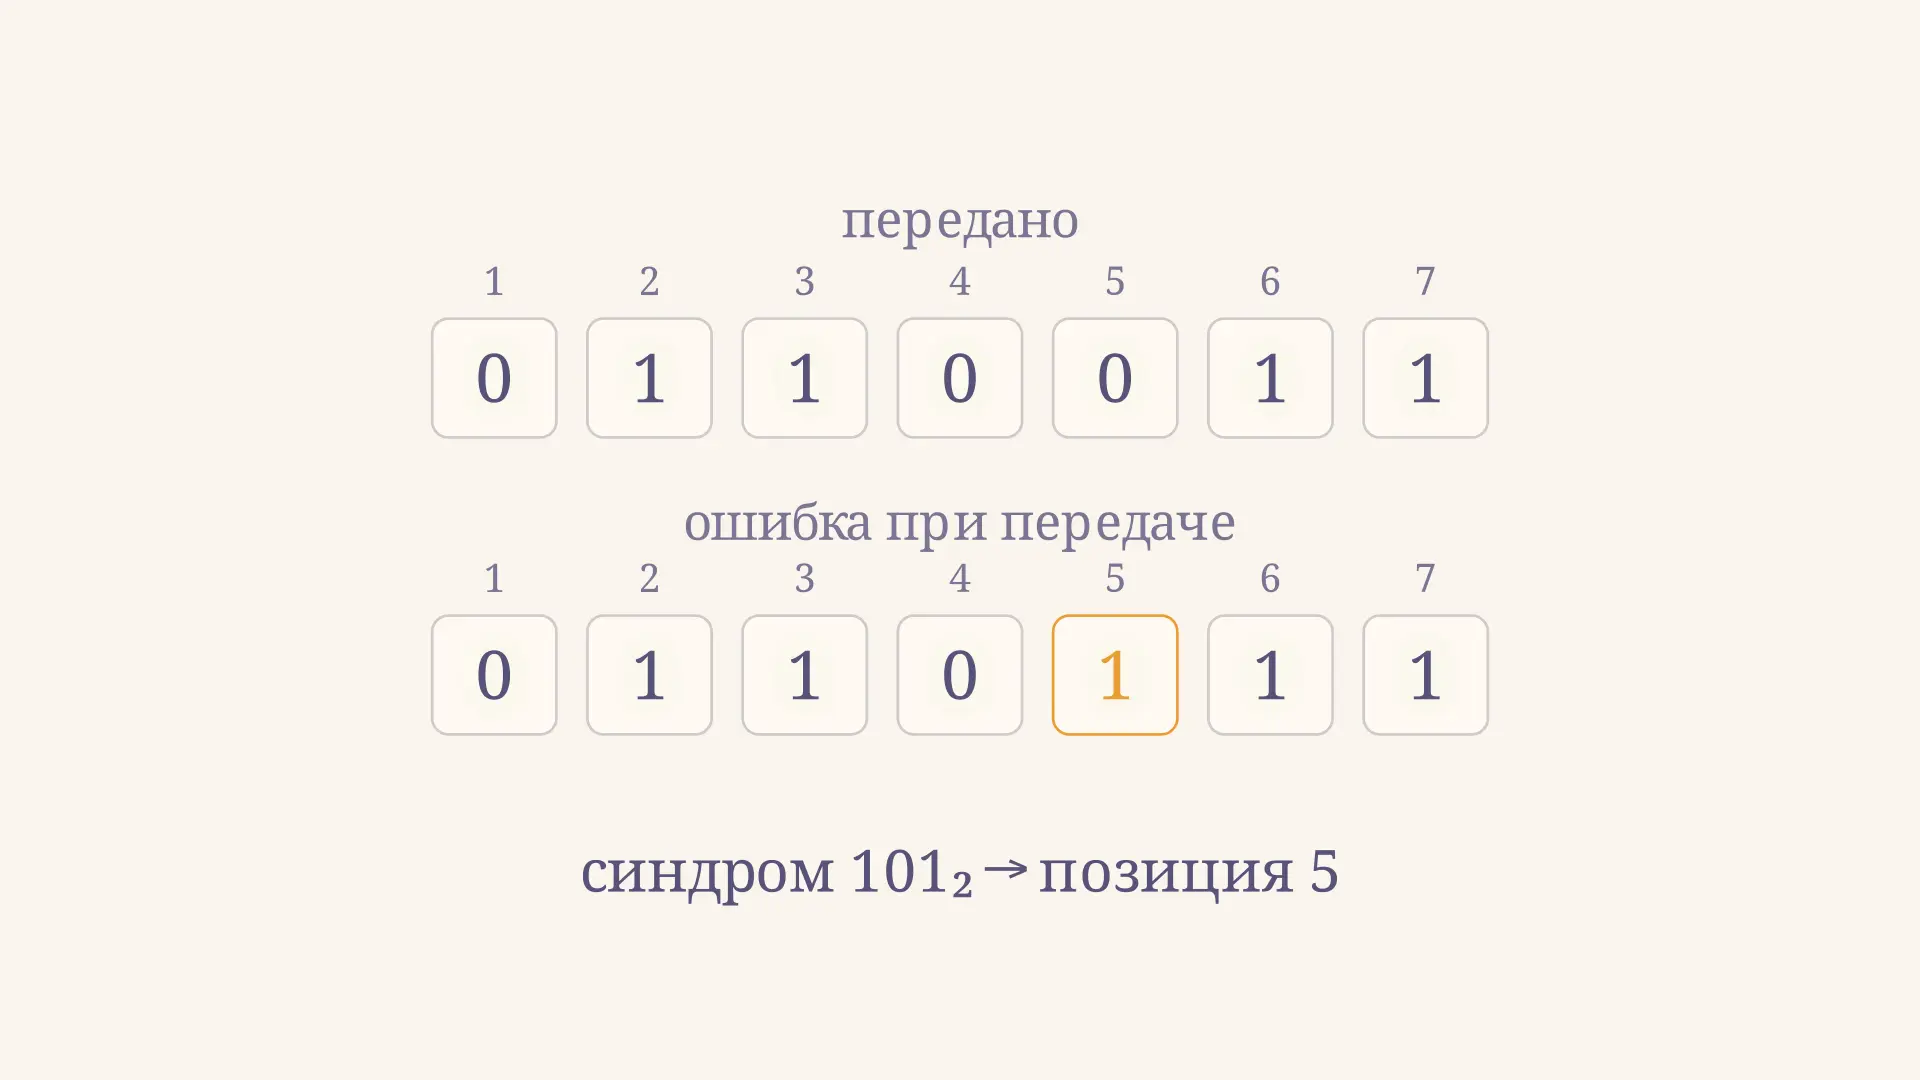
Код Хэмминга: исправление ошибок на примере
Код Хэмминга для исправления ошибок: как расставить проверочные биты, вычислить синдром и восстановить данные на примере кода (7, 4), а также каковы его ограничения.
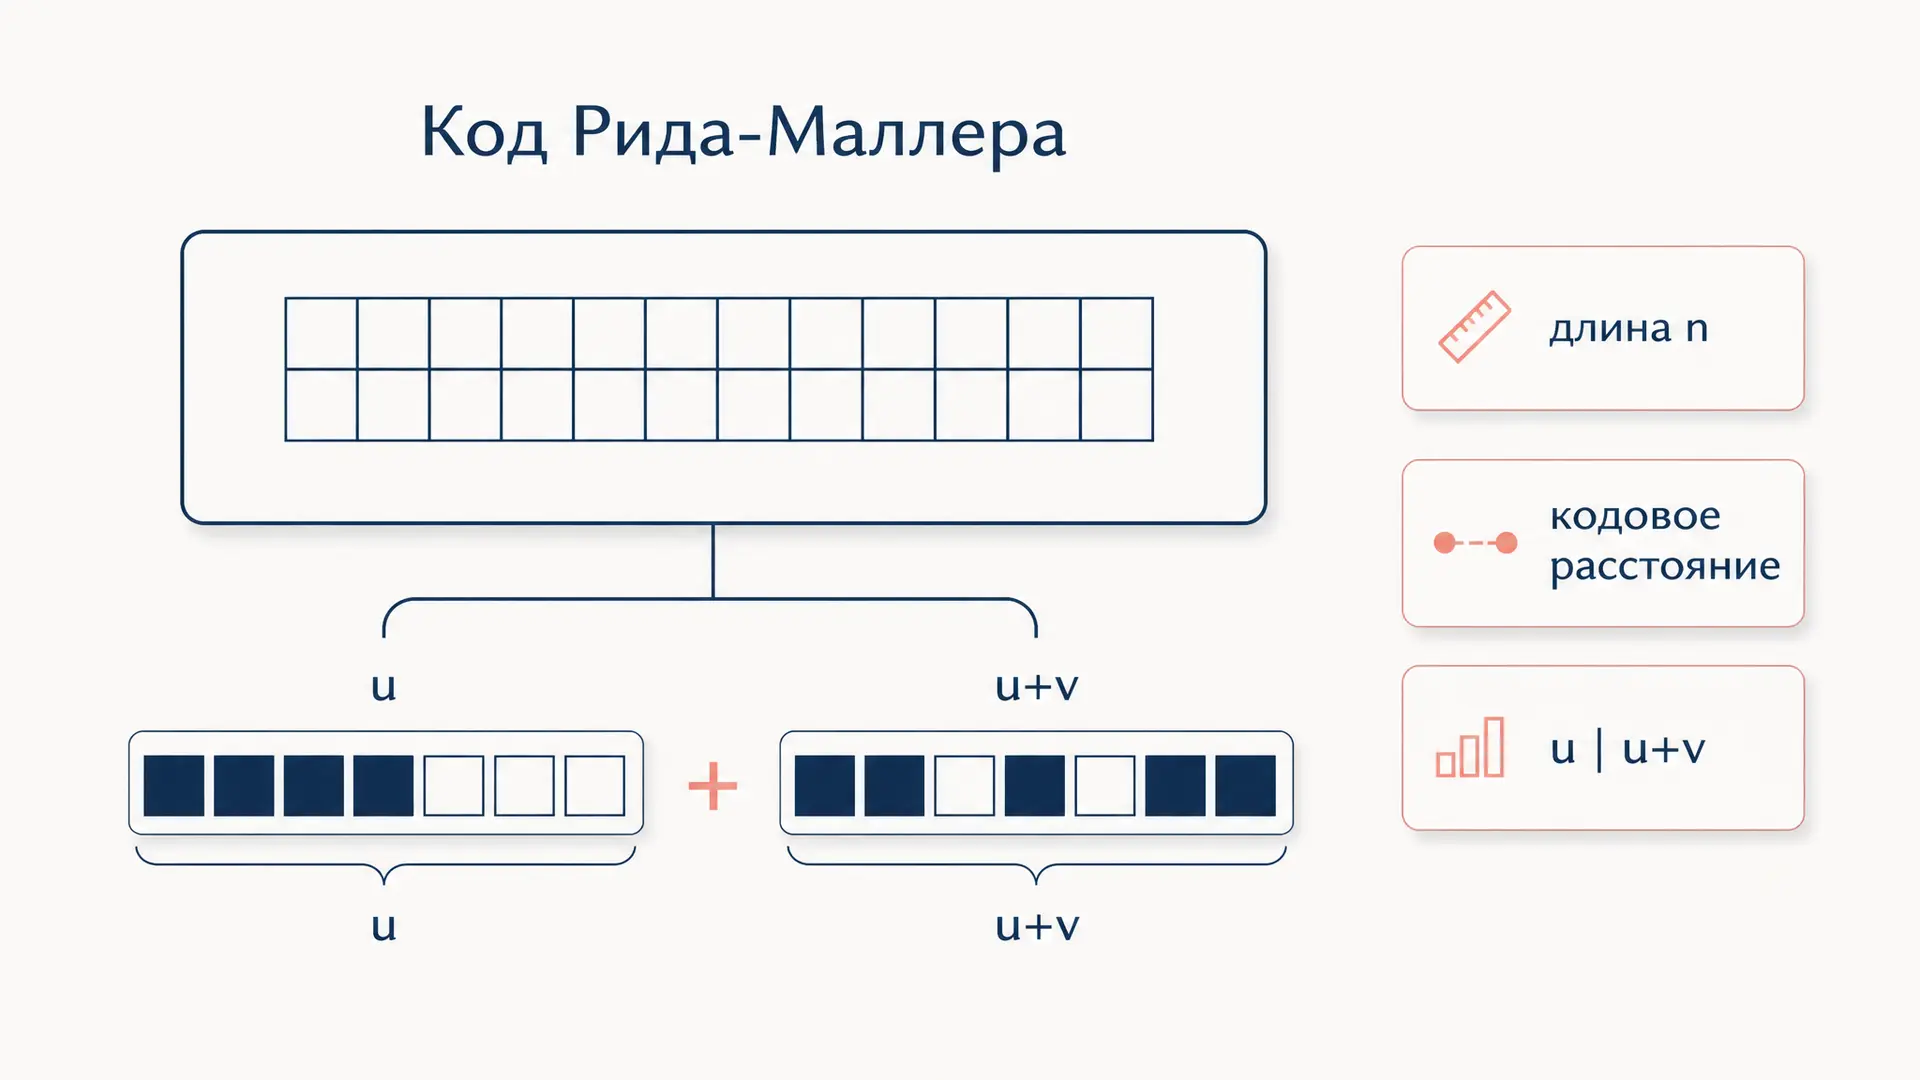
Код Рида-Маллера: параметры, построение и декодирование
Код Рида-Маллера простыми словами: как считать длину, размерность и кодовое расстояние RM(r, m), рекурсивное построение u, u+v и мажоритарное декодирование с примерами и калькулятором.
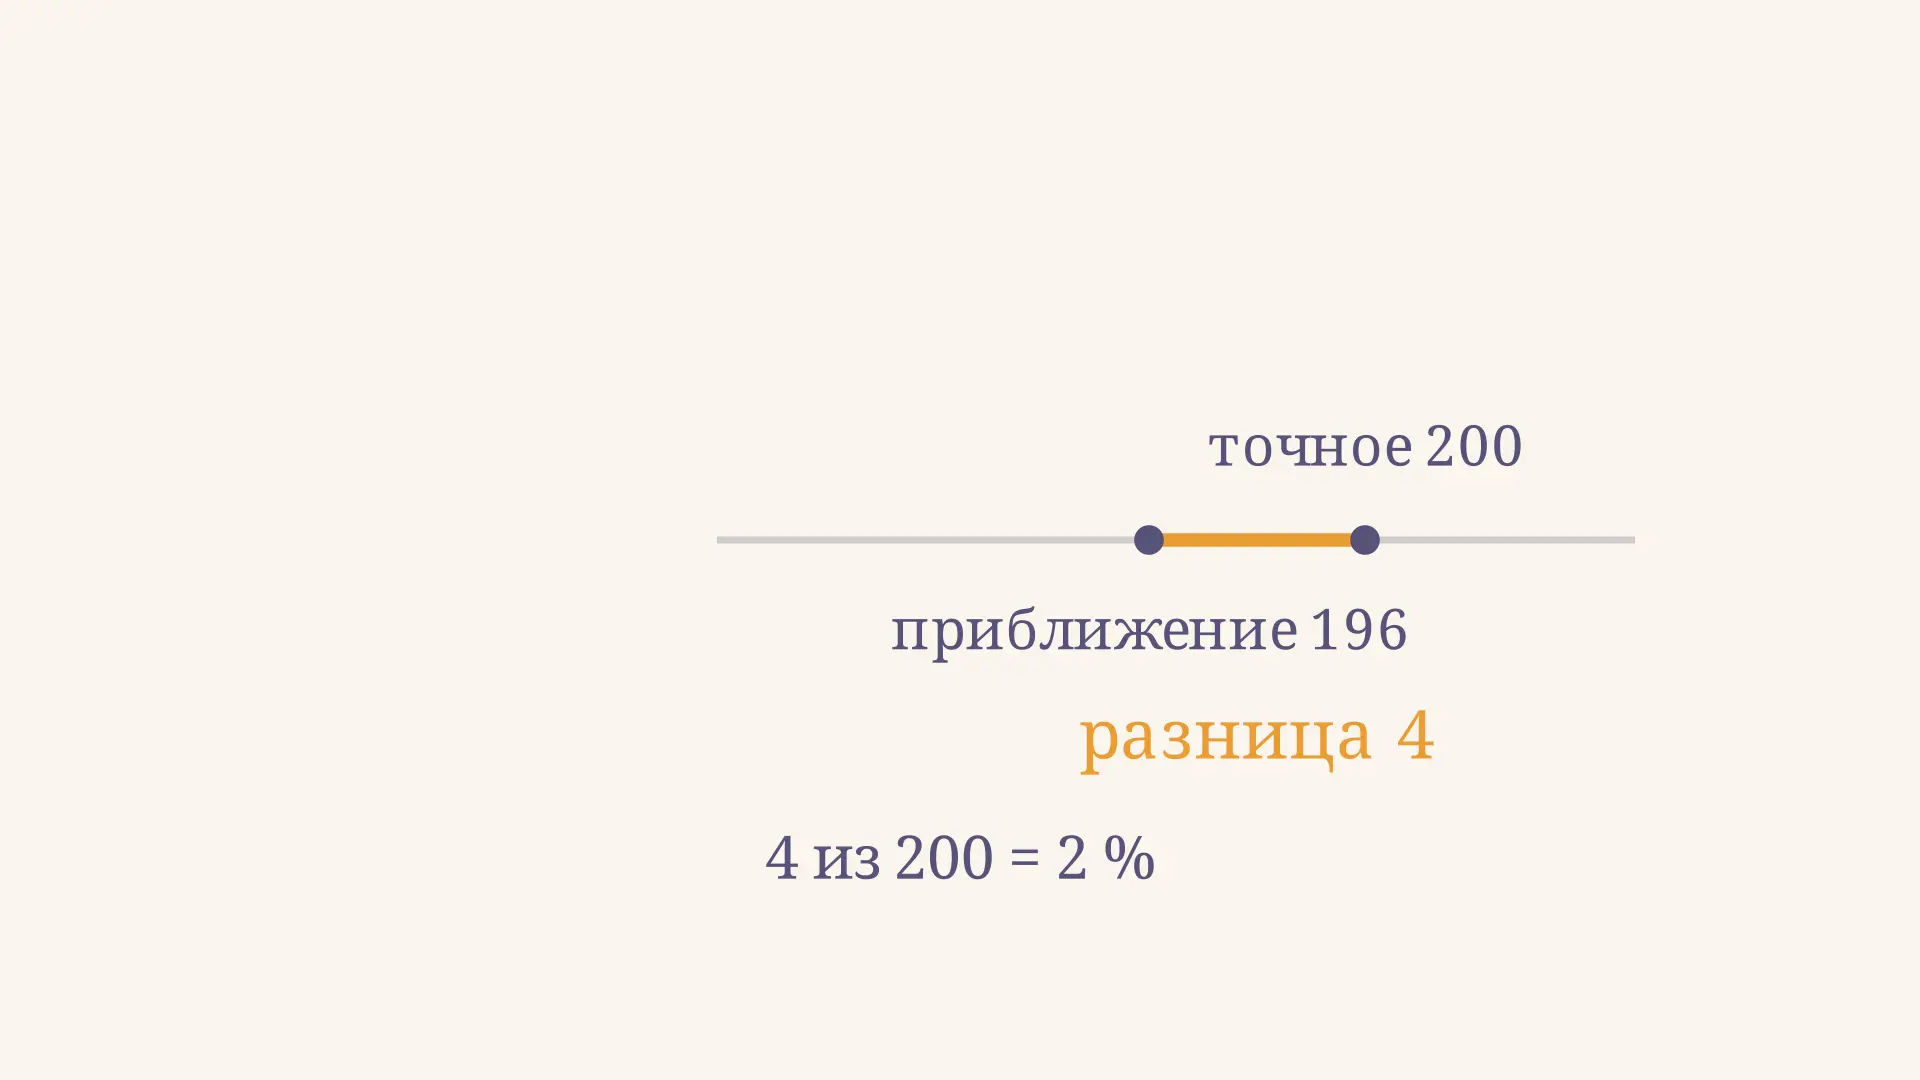
Абсолютная и относительная погрешность числа
Абсолютная и относительная погрешность приближённого числа: формулы, расчёт в процентах, оценка при округлении и подробные примеры сравнения точности.
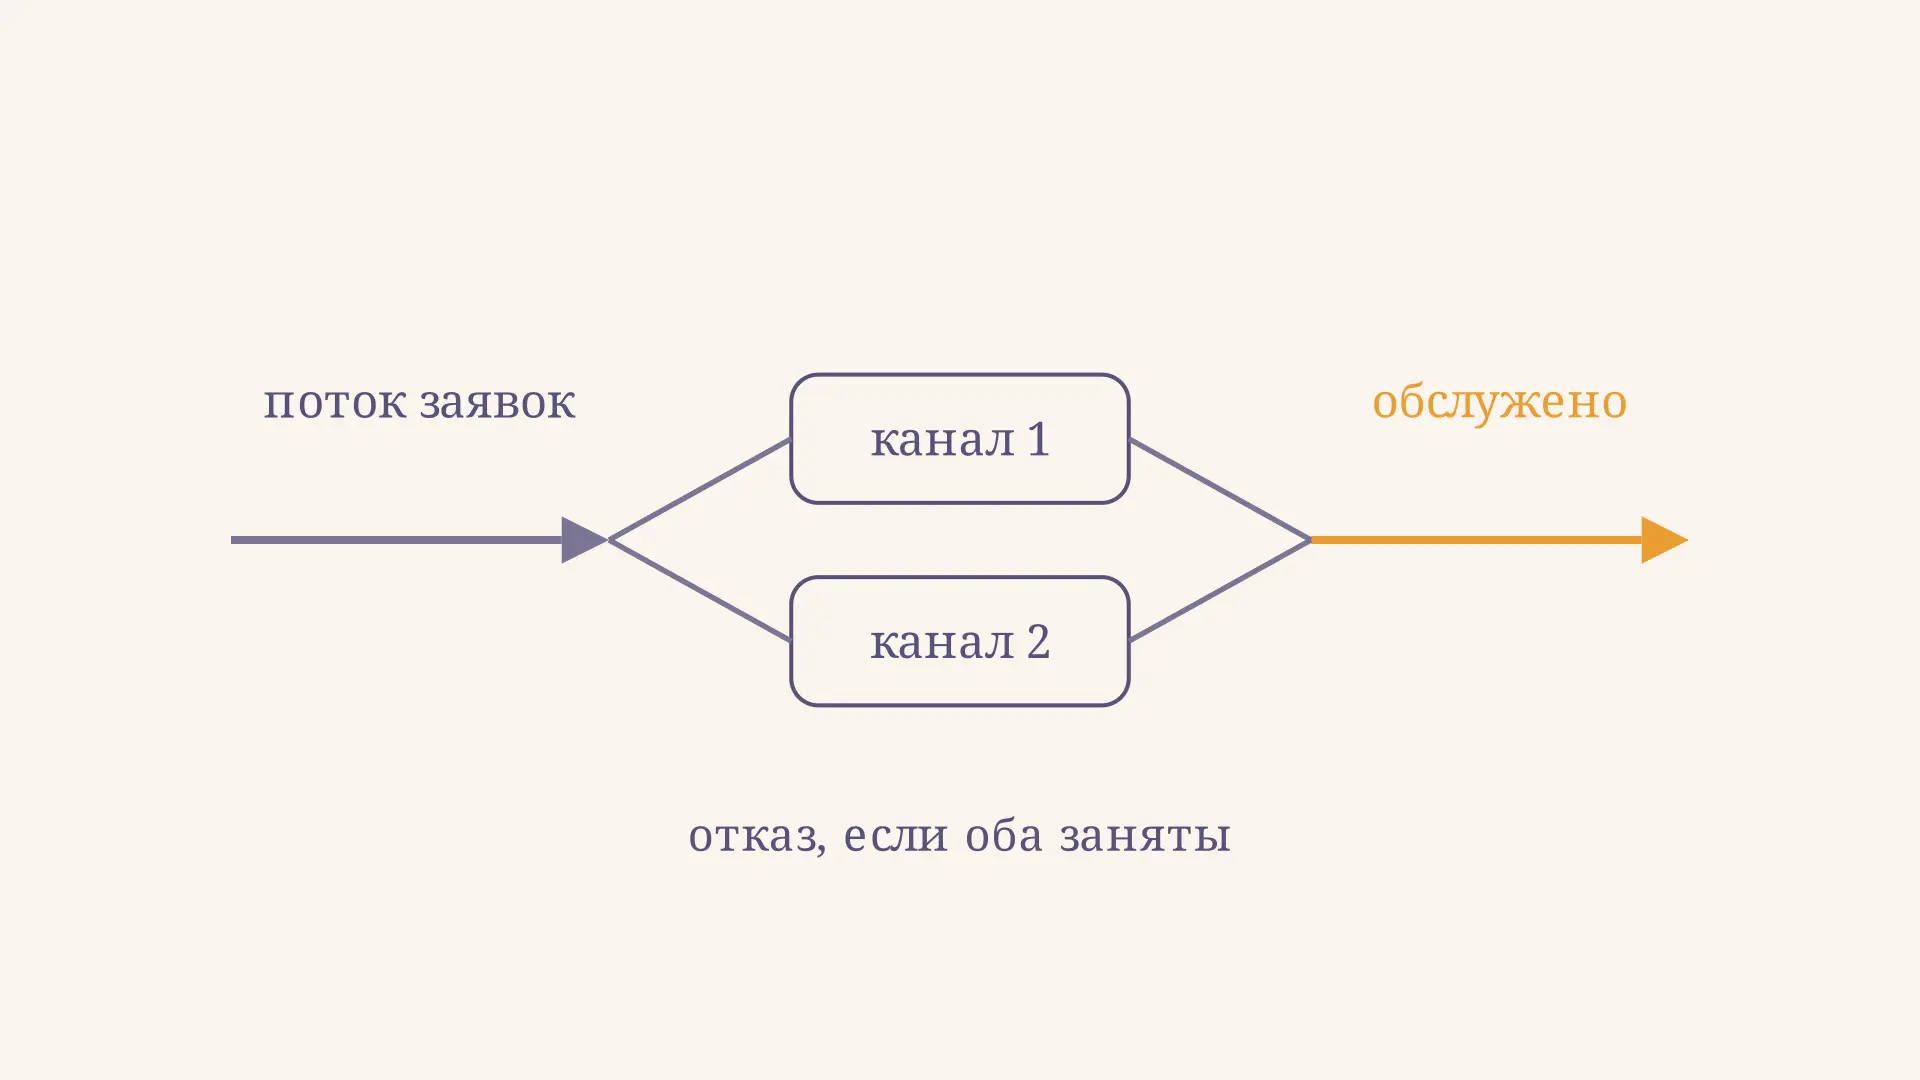
Абсолютная пропускная способность СМО: формула
Как найти абсолютную пропускную способность СМО через интенсивность потока и вероятность отказа: формула, пример расчёта и отличие от относительной способности.
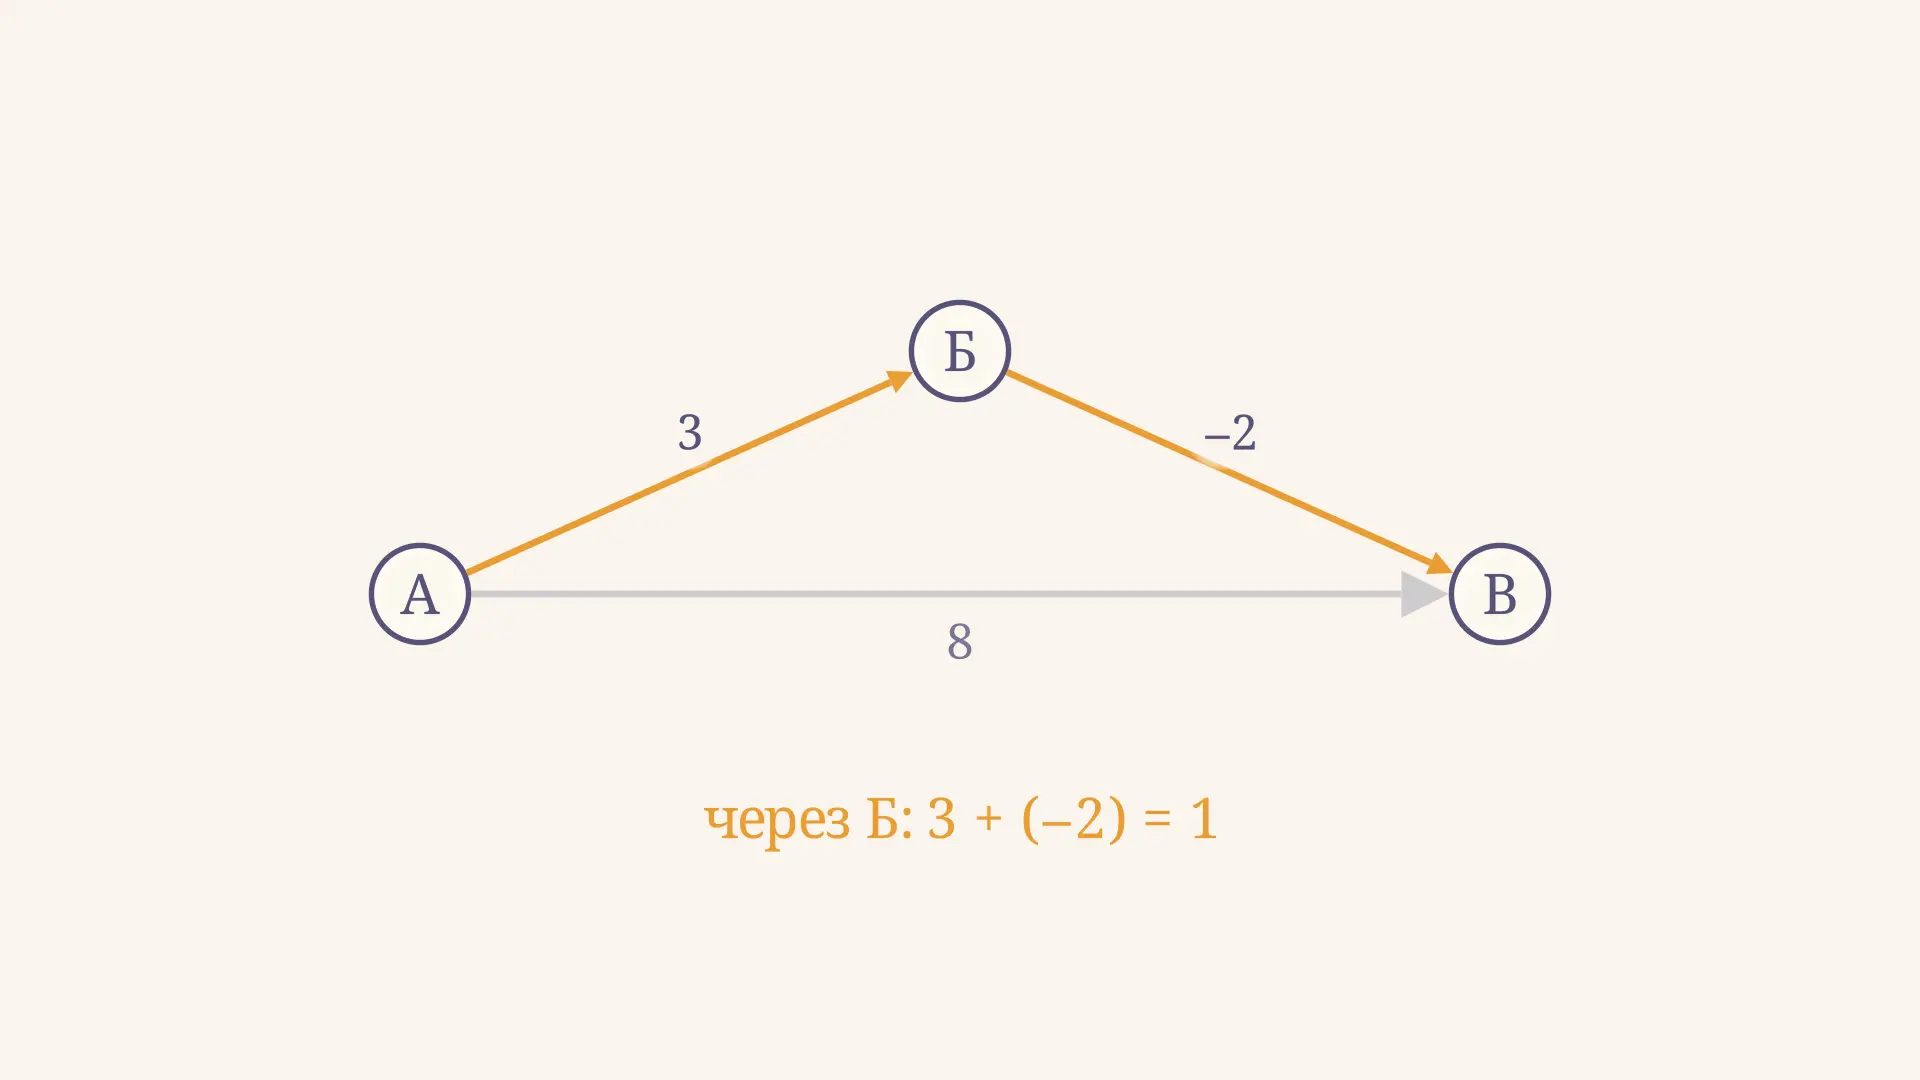
Алгоритм Флойда-Уоршелла: кратчайшие пути в графе
Алгоритм Флойда-Уоршелла на примере: как получить матрицу кратчайших путей для всех пар вершин, восстановить маршрут и вовремя обнаружить отрицательный цикл.
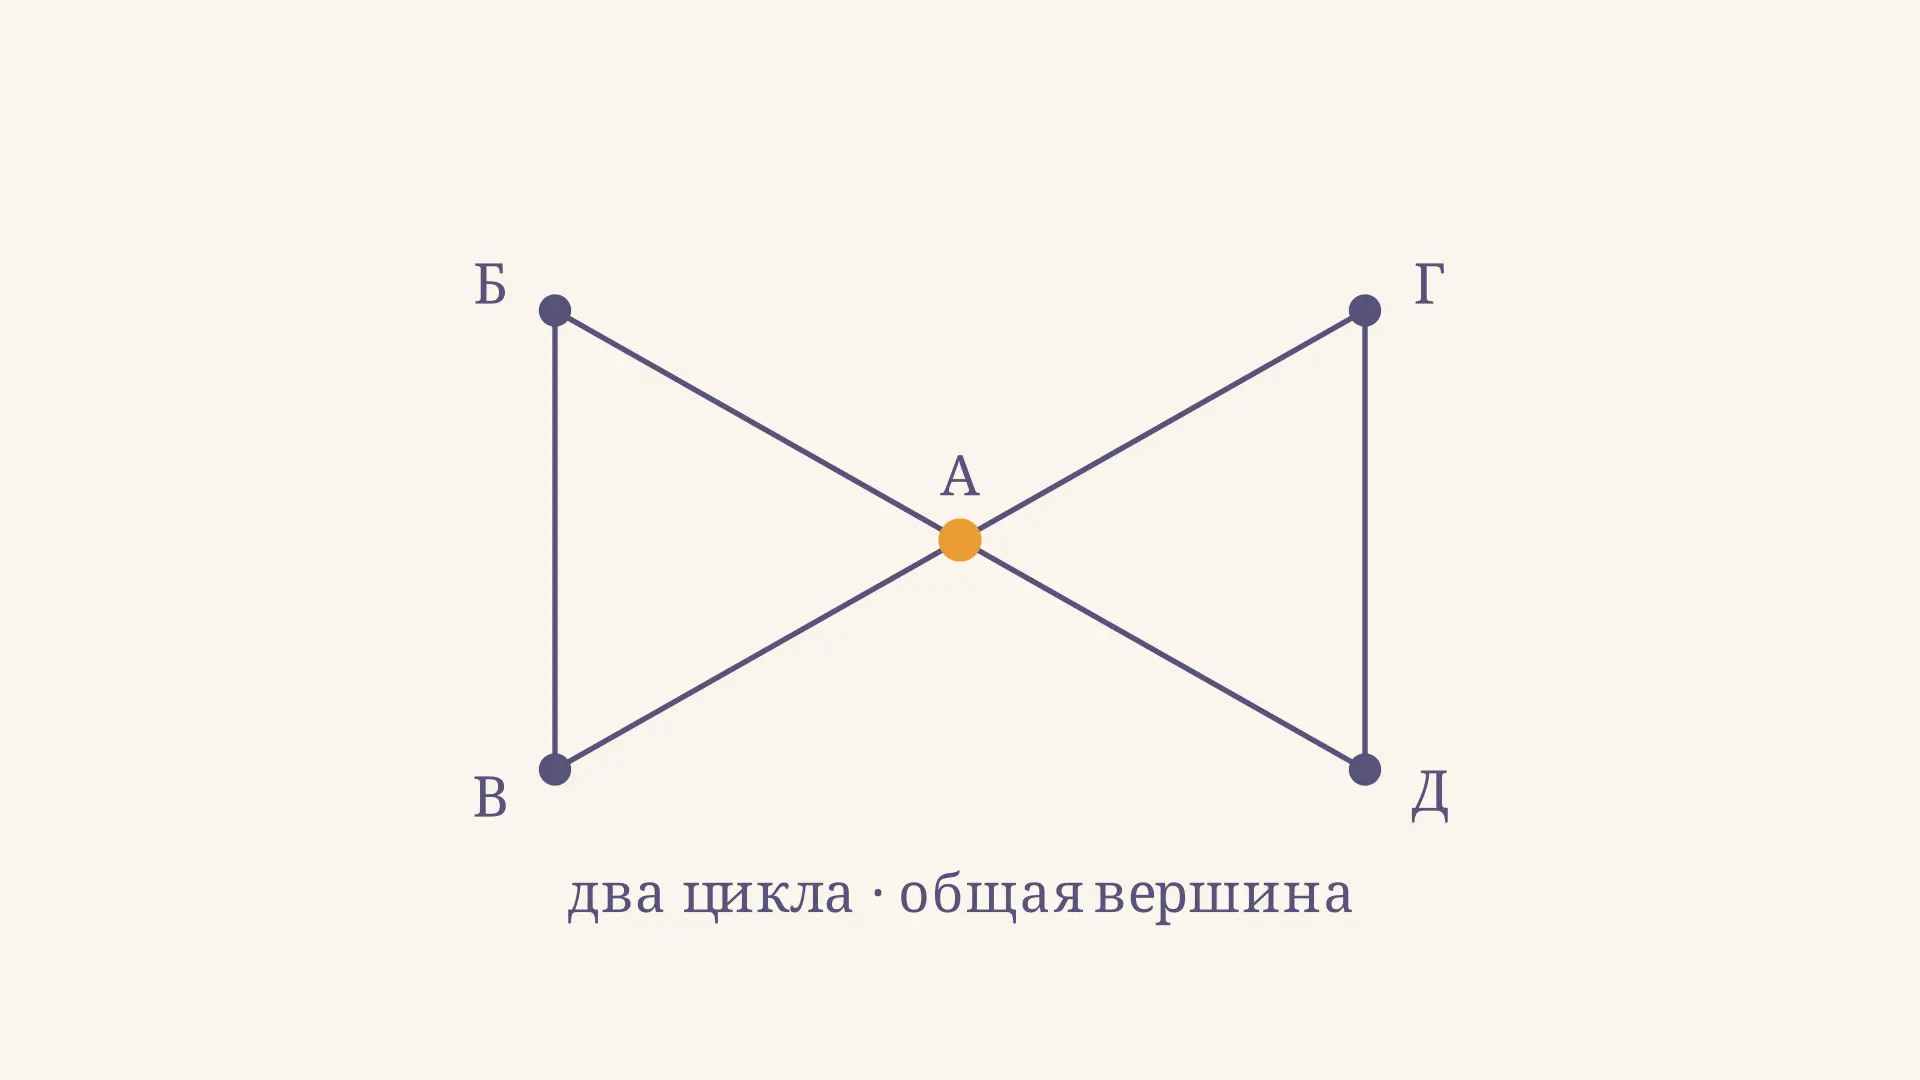
Алгоритм Хирхольцера: как найти эйлеров путь
Алгоритм Хирхольцера строит эйлеров путь или цикл в графе. Разбираем условия существования, работу стека, пример с двумя циклами и сложность алгоритма.