Код Хэмминга: исправление ошибок на примере
Код Хэмминга добавляет к данным проверочные биты так, чтобы приёмник мог найти и исправить одну ошибку в кодовом слове. Например, четыре информационных бита превращаются в семь, а результаты трёх проверок указывают номер повреждённой позиции. Ниже разберём кодирование и исправление на одном примере, а также выясним, почему две ошибки требуют осторожности. В калькуляторе можно менять данные и позицию одиночной ошибки: все позиции нумеруются слева направо.
Зачем добавлять проверочные биты
При передаче или хранении двоичной последовательности отдельный бит может измениться: вместо нуля будет прочитана единица или наоборот. Если отправить только сами данные, получатель не всегда узнает о подмене. Дополнительные разряды создают связи между битами: при нарушении этих связей возникает признак ошибки.
Один общий бит чётности обнаруживает нечётное число инверсий, но не сообщает, какой именно бит изменился. Код Хэмминга использует несколько перекрывающихся проверок. Каждая позиция входит в собственную комбинацию групп, и по набору нарушенных проверок можно определить место одиночной ошибки. Идею таких кодов Ричард Хэмминг изложил в работе 1950 года.
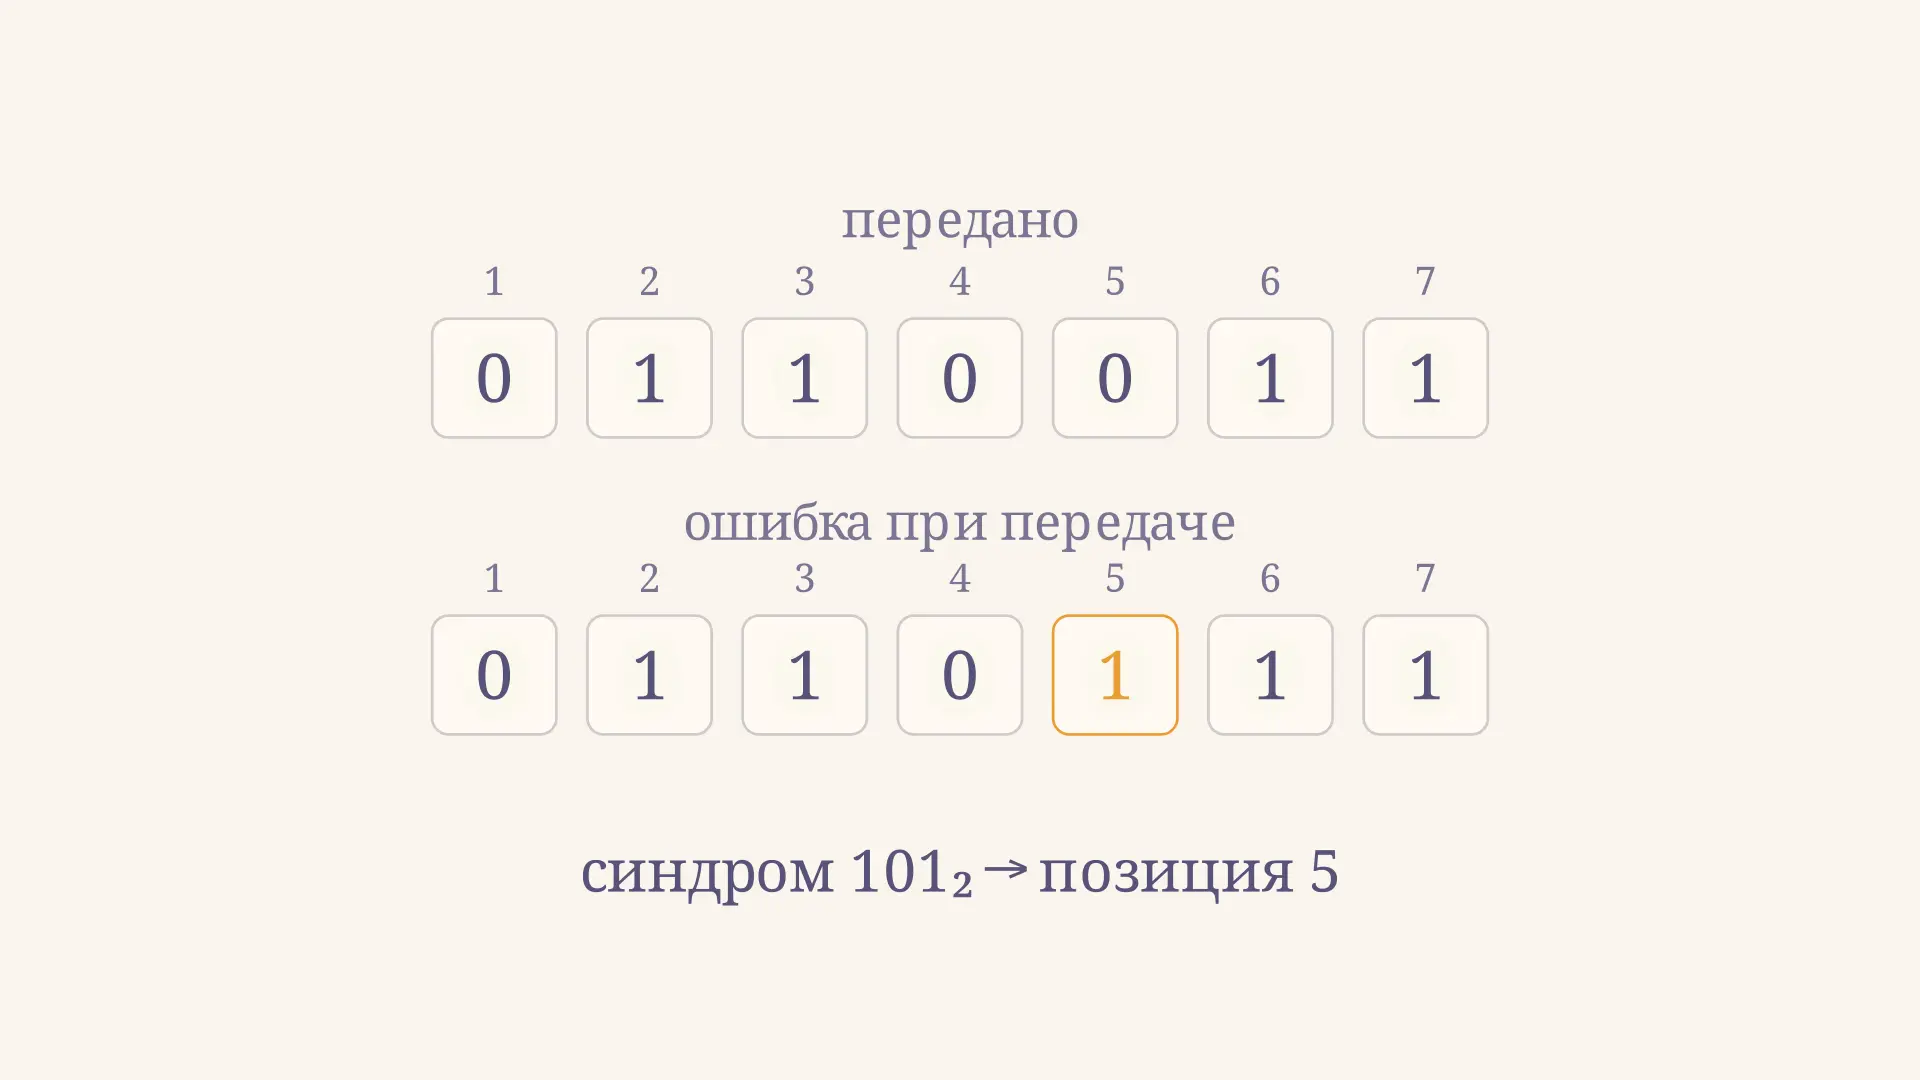
В этом примере движение показывает порядок событий: сначала передано корректное слово, затем появилась одна ошибка, а проверка помогла исправить её. Это не шифрование: задача кода состоит в защите от ошибок, а не в сокрытии содержания.
Как устроен код Хэмминга (7, 4)
Обозначение означает семь битов кодового слова, из которых четыре информационные. Остальные три - проверочные. Выберем чётную проверку: в каждой группе общее число единиц, включая проверочный бит, должно быть чётным. Существуют и другие соглашения, поэтому их важно зафиксировать до решения.
Позиции нумеруем от 1 до 7 слева направо. Проверочные биты занимают степени двойки: 1, 2 и 4. Данные ставим на оставшиеся места 3, 5, 6 и 7. Такое расположение связано с двоичной записью номеров: бит проверки участвует в позициях, где младший разряд номера равен единице; и отвечают следующим разрядам.
| Проверка | Позиции в группе | Условие |
|---|---|---|
| 1, 3, 5, 7 | чётная сумма | |
| 2, 3, 6, 7 | чётная сумма | |
| 4, 5, 6, 7 | чётная сумма |
Вычисления выполняются по модулю 2: , а сложение совпадает с операцией XOR. При необходимости сначала разберите построение логической схемы по выражению: XOR также можно реализовать логическими элементами.
Как закодировать сообщение 1011
Разместим данные по позициям 3, 5, 6, 7. Получим схему . Теперь подберём проверочные значения:
- В группе 1, 3, 5, 7 информационные биты равны . Единиц две, поэтому .
- В группе 2, 3, 6, 7 стоят три информационные единицы. Для чётности нужно .
- В группе 4, 5, 6, 7 данные равны . Их сумма чётная, поэтому .
Итоговое слово - 0110011. Например, первая группа содержит : сумма равна двум. Аналогично для двух других групп сумма равна четырём и двум. Важно включать в проверку и сам проверочный бит: иначе приёмник не заметит ошибку в нём.
Синдром: как найти позицию ошибки
Пусть по каналу передано 0110011, но пятый бит изменился с 0 на 1. Получено 0110111. Приёмник заново складывает биты в каждой группе по модулю 2. Запишем результаты как , , в порядке проверок из таблицы.
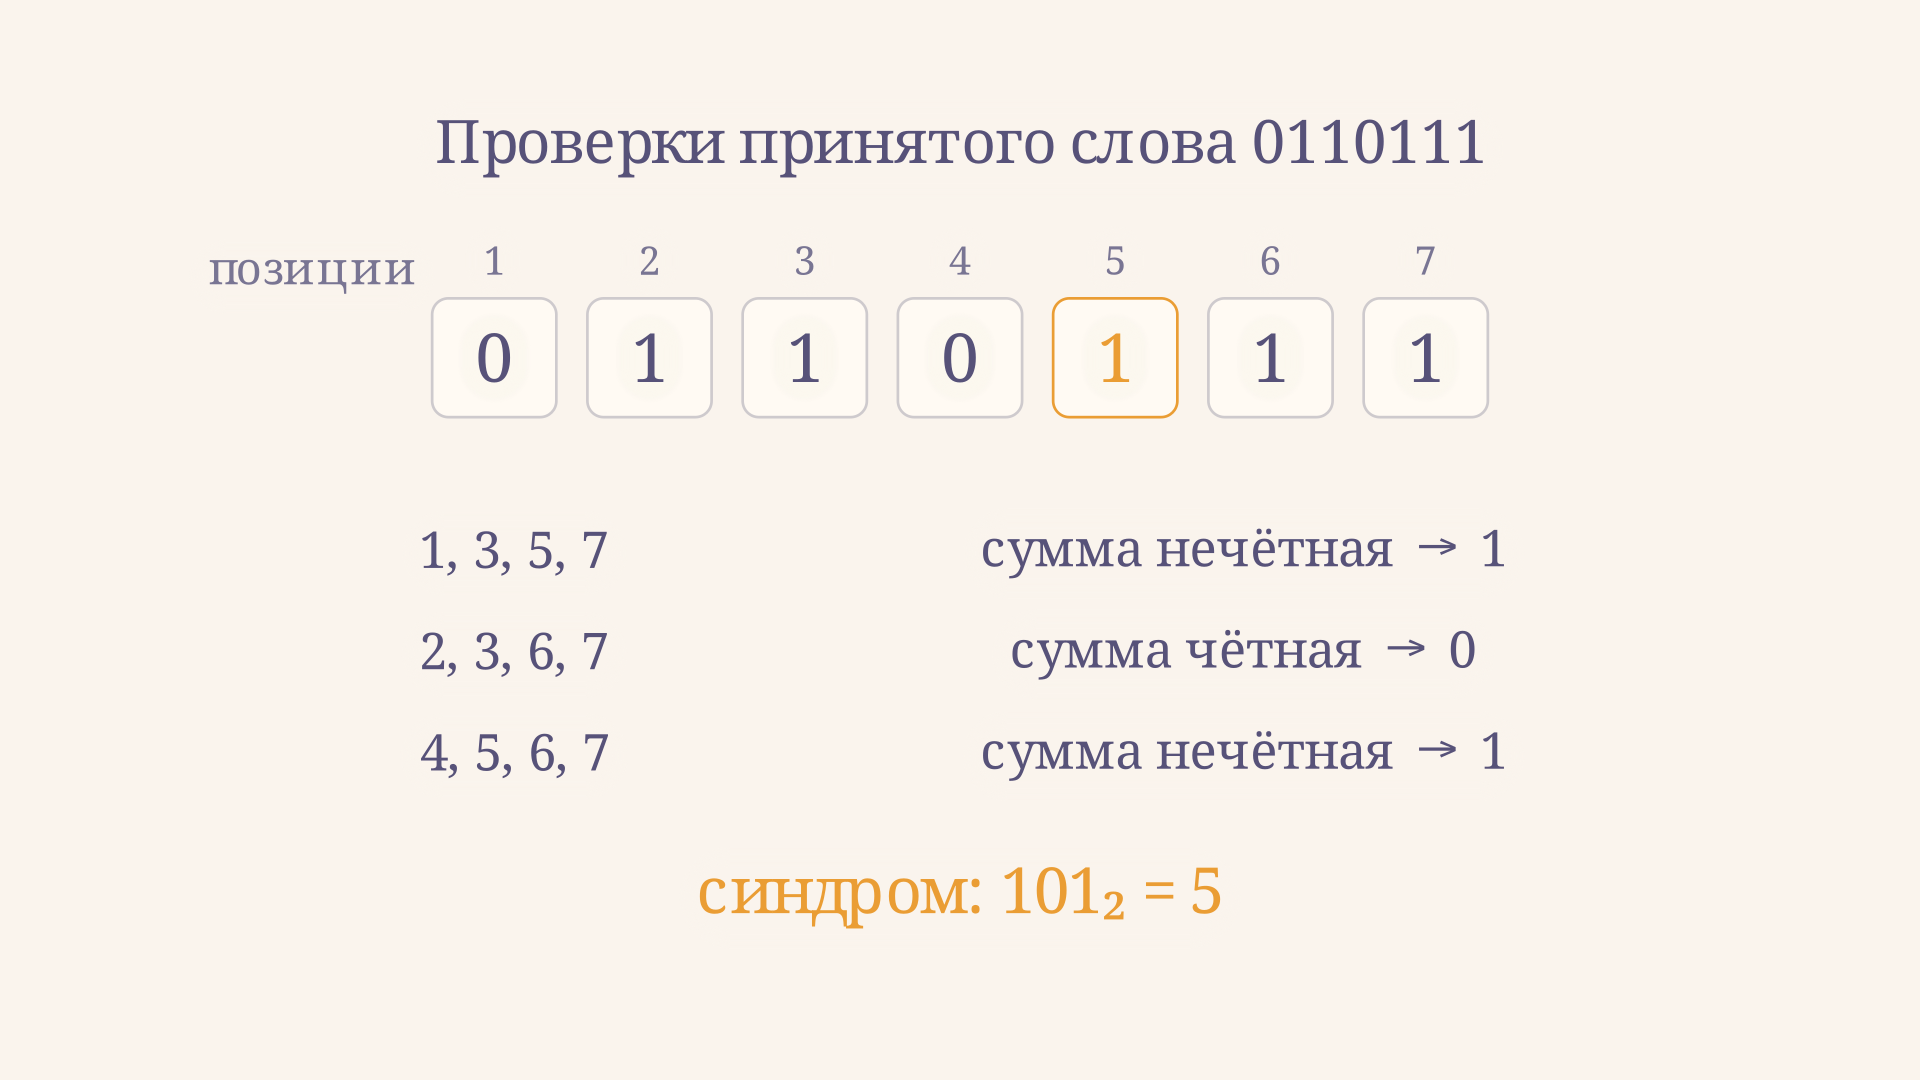
Для первой группы сумма , значит . Для второй , значит . Для третьей , значит . Записывая старший разряд первым, получаем синдром .
При допущении, что ошибка не более чем одна, нужно инвертировать пятый бит: снова получается 0110011. Из позиций 3, 5, 6, 7 извлекаем исходные данные 1011. Если синдром равен 000, все три проверки выполнены; это соответствует отсутствию ошибки при указанном допущении, хотя при большем числе ошибок возможны и необнаруженные искажения.
Почему номер работает? Пятая позиция имеет двоичный номер и входит в проверки 1 и 4, но не входит в проверку 2. Инверсия меняет чётность ровно тех групп, в которые входит бит. Поэтому нарушенные проверки воспроизводят двоичную запись его номера. Это относится и к ошибке в проверочной позиции, например синдром указывает на позицию 2.
Матрица проверок и расстояние Хэмминга
Тот же алгоритм удобно записать матрицей. Столбец с номером содержит биты двоичной записи : в строках снизу вверх стоят веса 1, 2 и 4. Для принятого столбца синдром равен по модулю 2:
Для каждого корректного слова выполнено . Одиночная ошибка добавляет к слову вектор с одной единицей; умножение выделяет соответствующий столбец . Здесь умножение и сложение отличаются от обычной арифметики правилом ; порядок строк и столбцов важно сохранять. Общий принцип операции разобран в статье об умножении матриц.
Расстояние Хэмминга двух слов - число позиций, в которых они различаются. Минимальное расстояние кода равно трём. Значит, шары радиуса один вокруг допустимых слов не пересекаются: слово с одной ошибкой однозначно ближе к исходному кодовому слову. Другие семейства строятся иначе: например, у кода Рида - Маллера параметры зависят от выбранного порядка и числа переменных.
Сколько проверочных битов нужно
Для информационных и проверочных битов общее число позиций равно . Синдром должен различать отсутствие ошибки и ошибку в каждой позиции. Поэтому необходимо
Например, при двух проверочных битов мало: . Трёх достаточно: . При получаем , то есть можно построить код длины 15 с четырьмя проверками. Условие само по себе подсчитывает доступные синдромы; конкретное построение ещё должно назначить позициям разные ненулевые столбцы проверки.
Дополнительные биты занимают место: в полезная доля составляет . Это плата за возможность восстановить одну ошибку без повторной передачи. На практике выбор кода зависит от ожидаемого характера помех и допустимой избыточности.
При построении более длинного кода тот же принцип применяют к каждому номеру позиции. Сначала записывают номера в двоичной системе, затем помещают проверочные разряды на позиции со степенями двойки. Каждая проверочная группа собирает позиции с единицей в соответствующем разряде номера. Так можно составить таблицу даже тогда, когда готовой схемы перед глазами нет.
Полезно разделять две операции: кодирование и декодирование. При кодировании известны данные, а проверочные биты выбирают так, чтобы все условия выполнялись. При декодировании уже получено всё слово, и значения проверок вычисляют заново, не предполагая, что проверочные разряды сохранились правильно. Только после этого по синдрому выбирают действие. Если задача требует показать решение, выпишите группы и остатки отдельно: это позволяет проверить и арифметику, и порядок разрядов результата.
Для практической проверки примера можно изменить в калькуляторе позицию ошибки на любую от первой до седьмой. Синдром должен совпасть с выбранным номером, а строка после исправления - с отправленным словом. Положение без ошибки даёт нулевой синдром. Калькулятор намеренно моделирует не более одной инверсии; вывод о двойной ошибке нужно исследовать отдельно, поскольку в этой модели её выбрать нельзя.
Что происходит при двух ошибках
Расстояние три позволяет обнаружить до двух ошибок, если задача только в проверке принадлежности слова коду. Но обычный декодер, который принимает любой ненулевой синдром за одиночную ошибку, не различает её от двойной. Например, инверсии позиций 1 и 2 дают синдром , как одиночная ошибка позиции 3. Исправление третьего бита приведёт к другому допустимому слову, а не восстановит исходное.
Для режима SECDED к семи битам добавляют общую проверку чётности. При предположении не более двух ошибок сочетание синдрома и общей чётности позволяет исправить одну ошибку и обнаружить две. Самого исходного варианта для такого одновременного обещания недостаточно. Двоичные биты в этой задаче обозначают данные и проверки; их роль отличается от представления знака в дополнительном коде.
Частые ошибки
- Читать синдром в обратном порядке. При весах запись числа - , а не наоборот.
- Менять соглашение о нумерации. Здесь позиция 1 находится слева; в другой записи она может быть справа.
- Исключать проверочный бит из проверки на приёме. Тогда ошибка в нём может остаться незамеченной.
- Всегда считать ненулевой синдром доказательством одной ошибки. При двух и более инверсиях он может указывать на другую позицию.
FAQ
Можно ли исправить ошибку в проверочном бите?
Да. Его позиция тоже имеет ненулевой двоичный номер, поэтому при единственной ошибке синдром укажет на неё. После инверсии информационные биты извлекаются обычным способом.
Означает ли нулевой синдром, что ошибок точно нет?
Нет. Он означает, что полученное слово удовлетворяет проверкам. При трёх и более ошибках оно иногда может превратиться в другое корректное слово. При ограничении не более одной ошибки нулевой синдром означает отсутствие ошибки.
Можно ли исправить две ошибки кодом (7, 4)?
Гарантированно нет. Двойная ошибка обнаруживается проверками, но её синдром совпадает с синдромом некоторой одиночной ошибки. Для различения этих случаев используют дополнительную общую проверку чётности и оговаривают предел числа ошибок.
Коротко
Код Хэмминга размещает четыре бита данных и три проверочных бита в семи позициях. При чётной проверке синдром из трёх битов указывает номер единственной ошибки: для принятого 0110111 это . Исправление надёжно только в рамках принятой модели числа ошибок.
Читайте также
Проверочная матрица линейного кода: синдром и пример
Как устроена проверочная матрица линейного кода, как вычислить синдром по модулю 2 и найти одиночную ошибку. Разбираем построение H и пример кода Хэмминга.
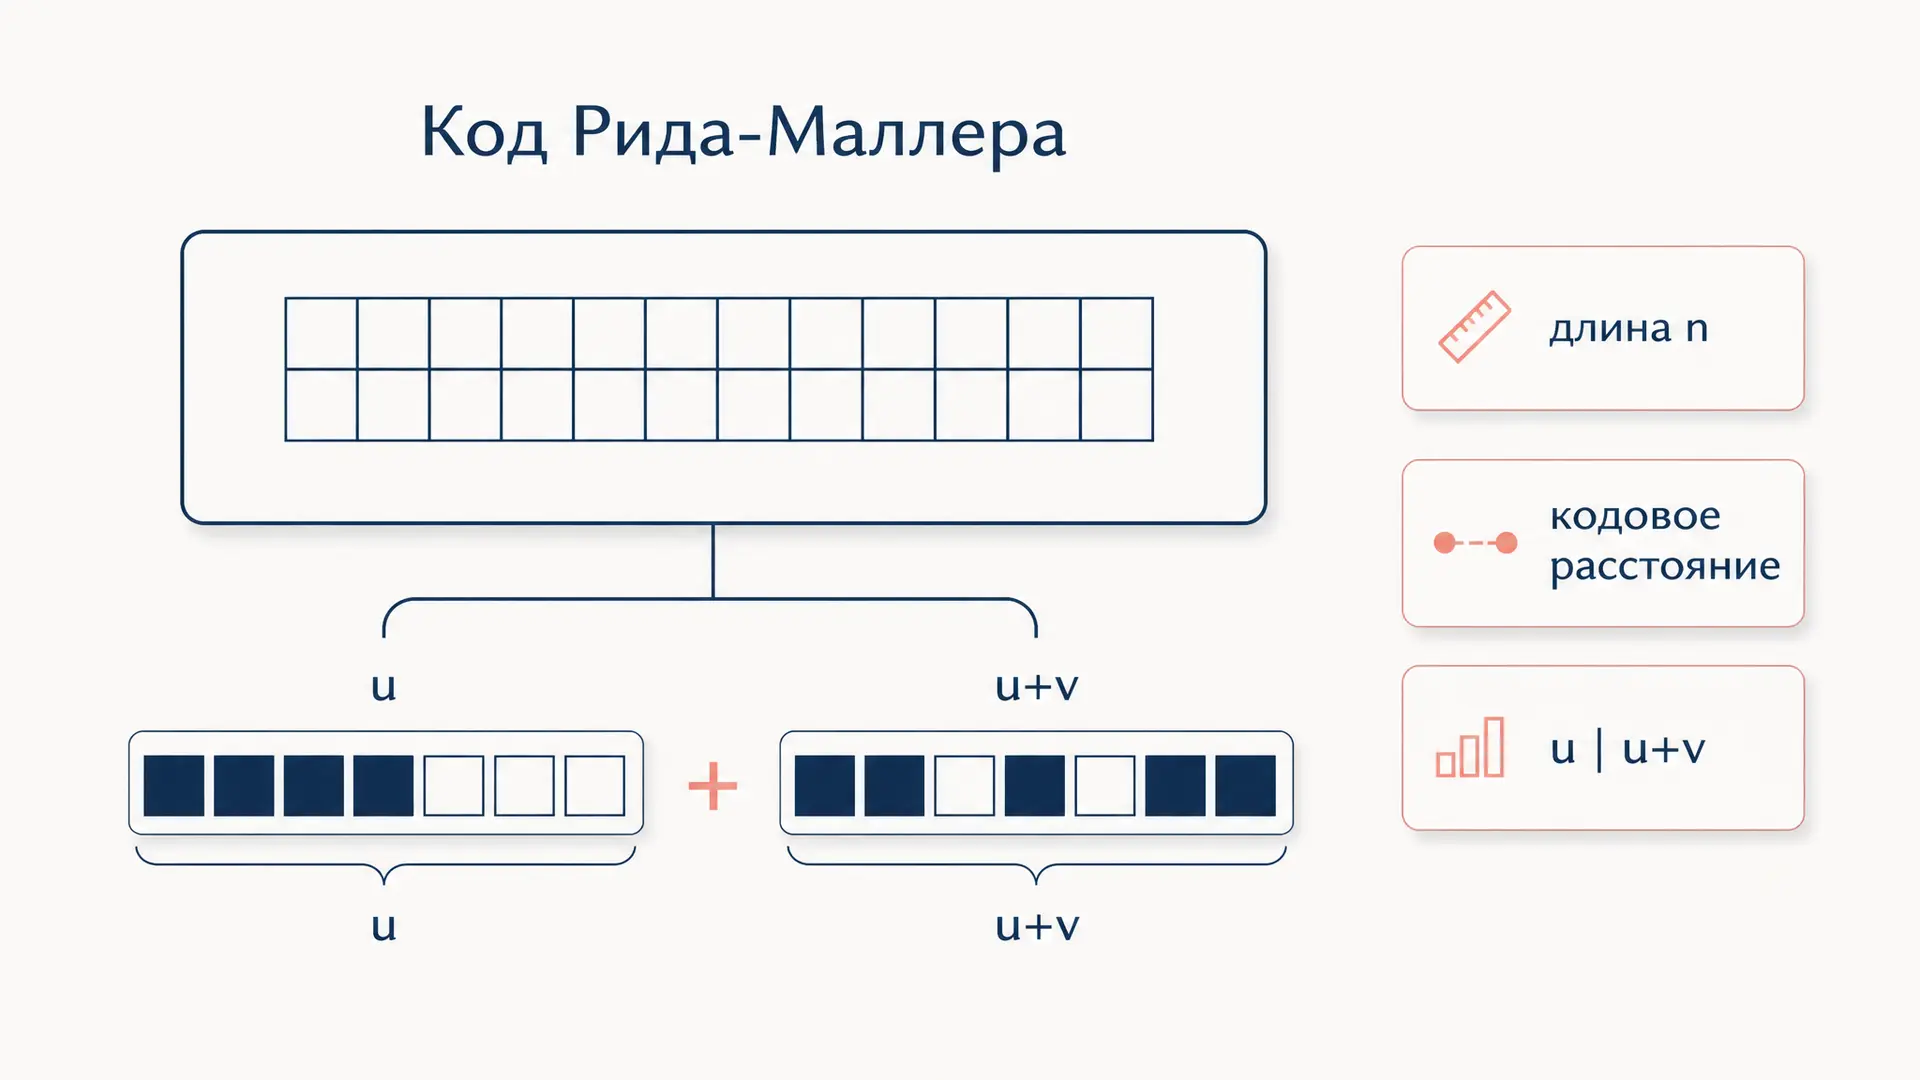
Код Рида-Маллера: параметры, построение и декодирование
Код Рида-Маллера простыми словами: как считать длину, размерность и кодовое расстояние RM(r, m), рекурсивное построение u, u+v и мажоритарное декодирование с примерами и калькулятором.
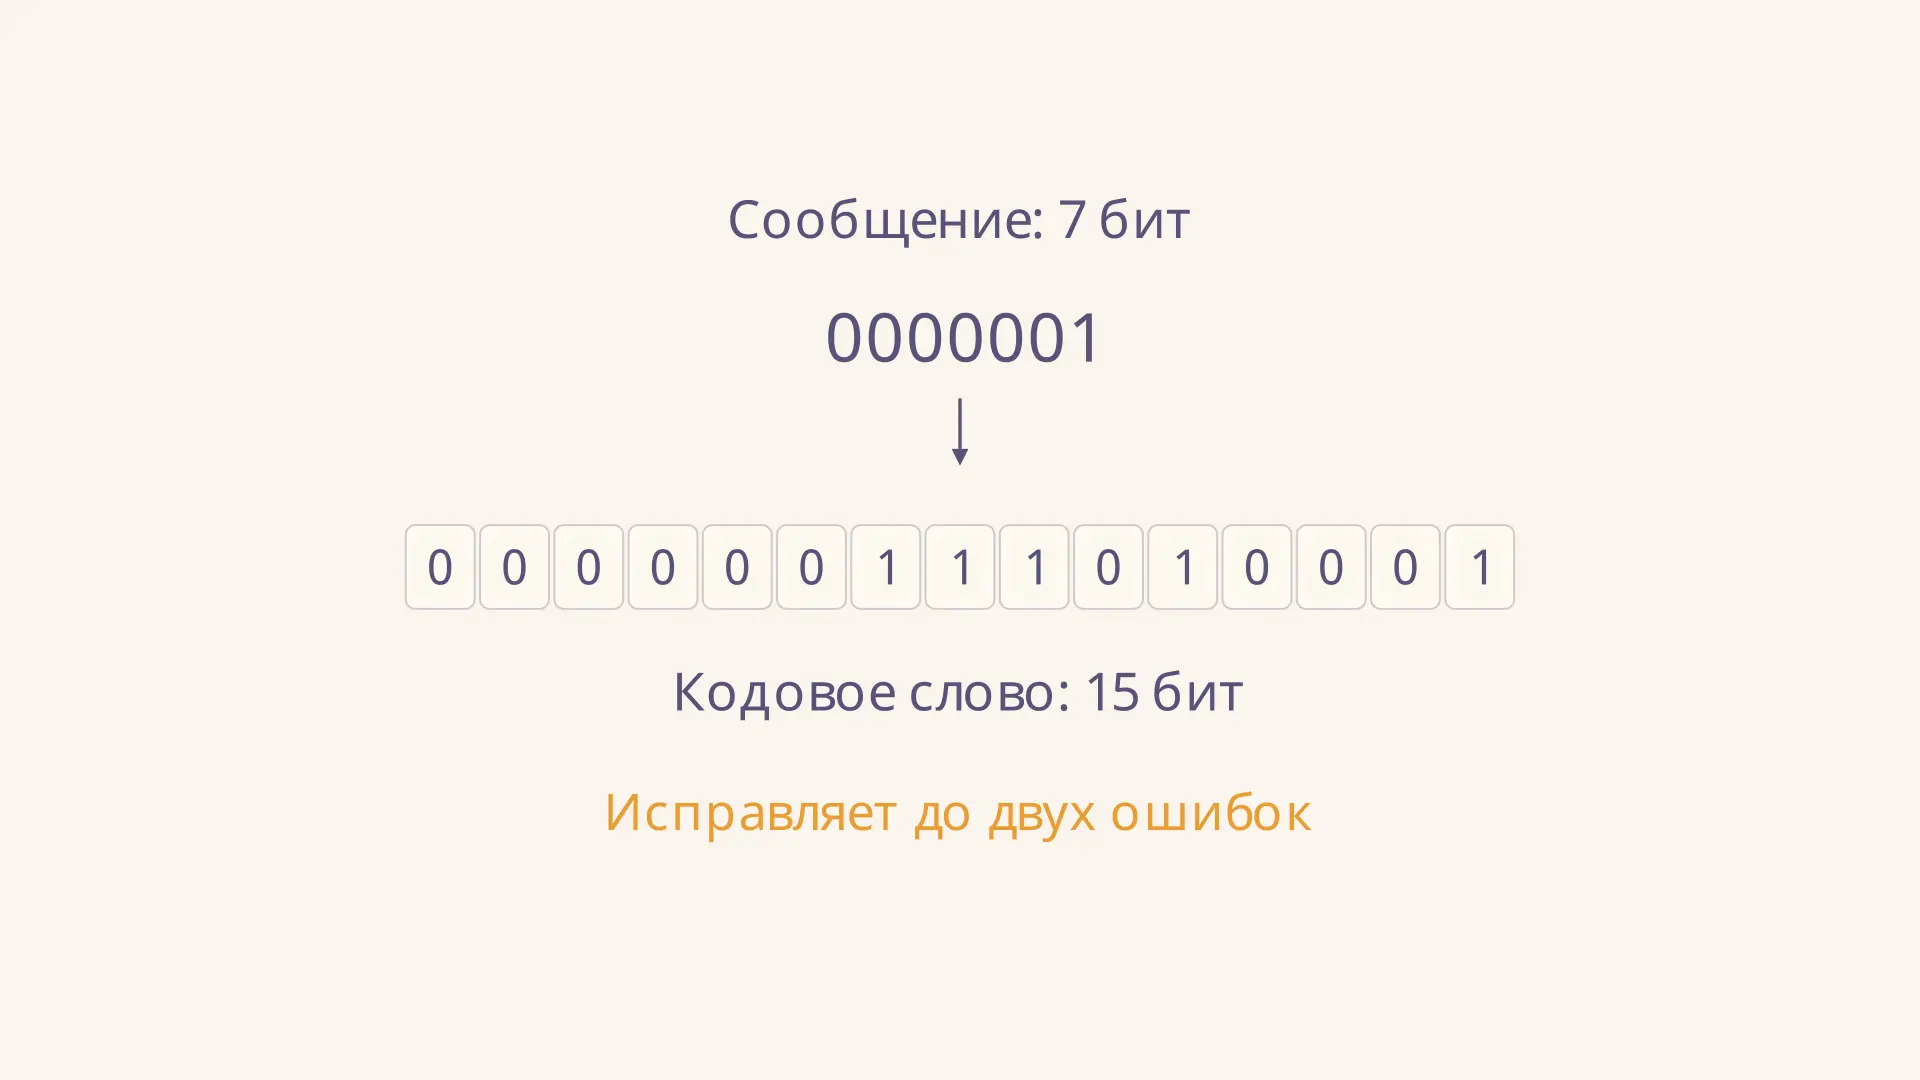
Код БЧХ: построение и исправление ошибок
Код БЧХ простыми словами: как построить двоичный код, вычислить синдром и исправить ошибки. Разбираем пример БЧХ (15, 7, 5) с порождающим многочленом.
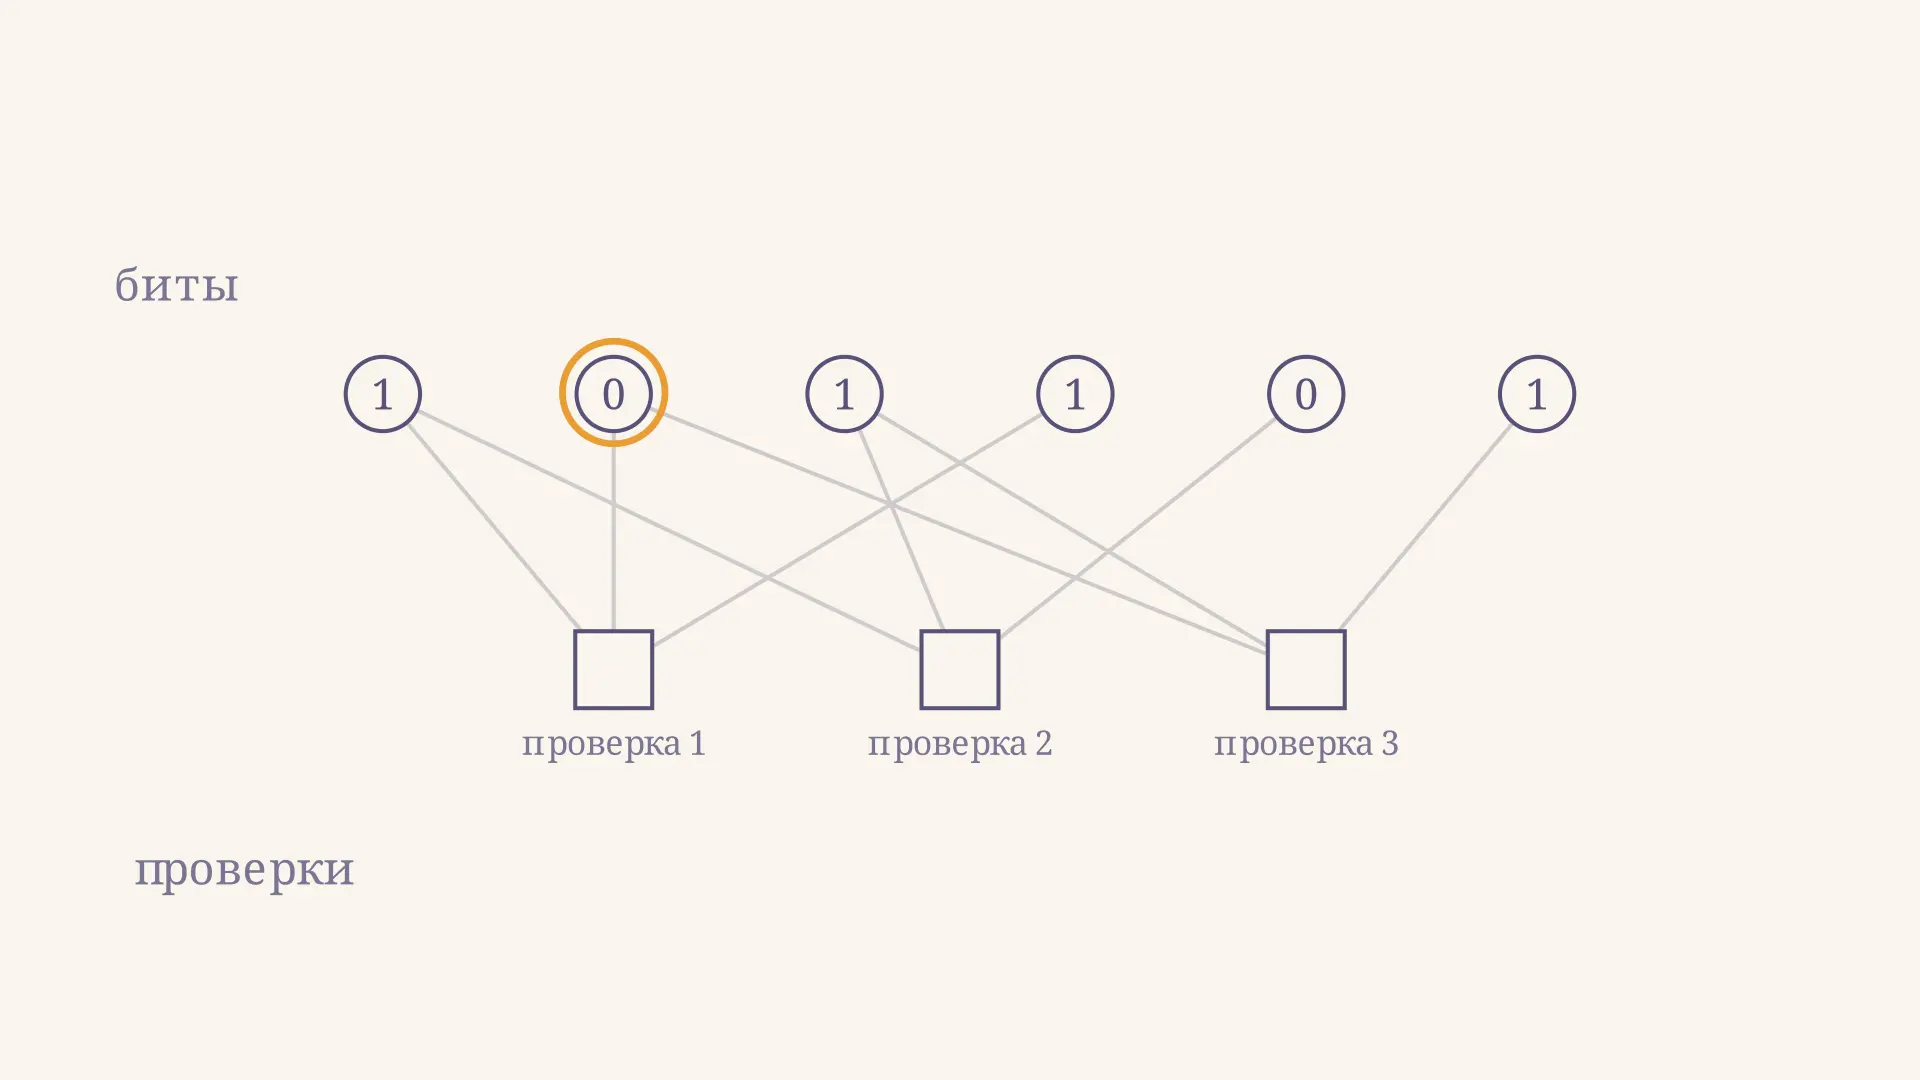
LDPC-коды: проверки чётности и исправление ошибок
LDPC-коды простыми словами: разреженная матрица проверок, граф Таннера и итеративное декодирование. Разбираем синдром и одиночную ошибку на числовом примере.
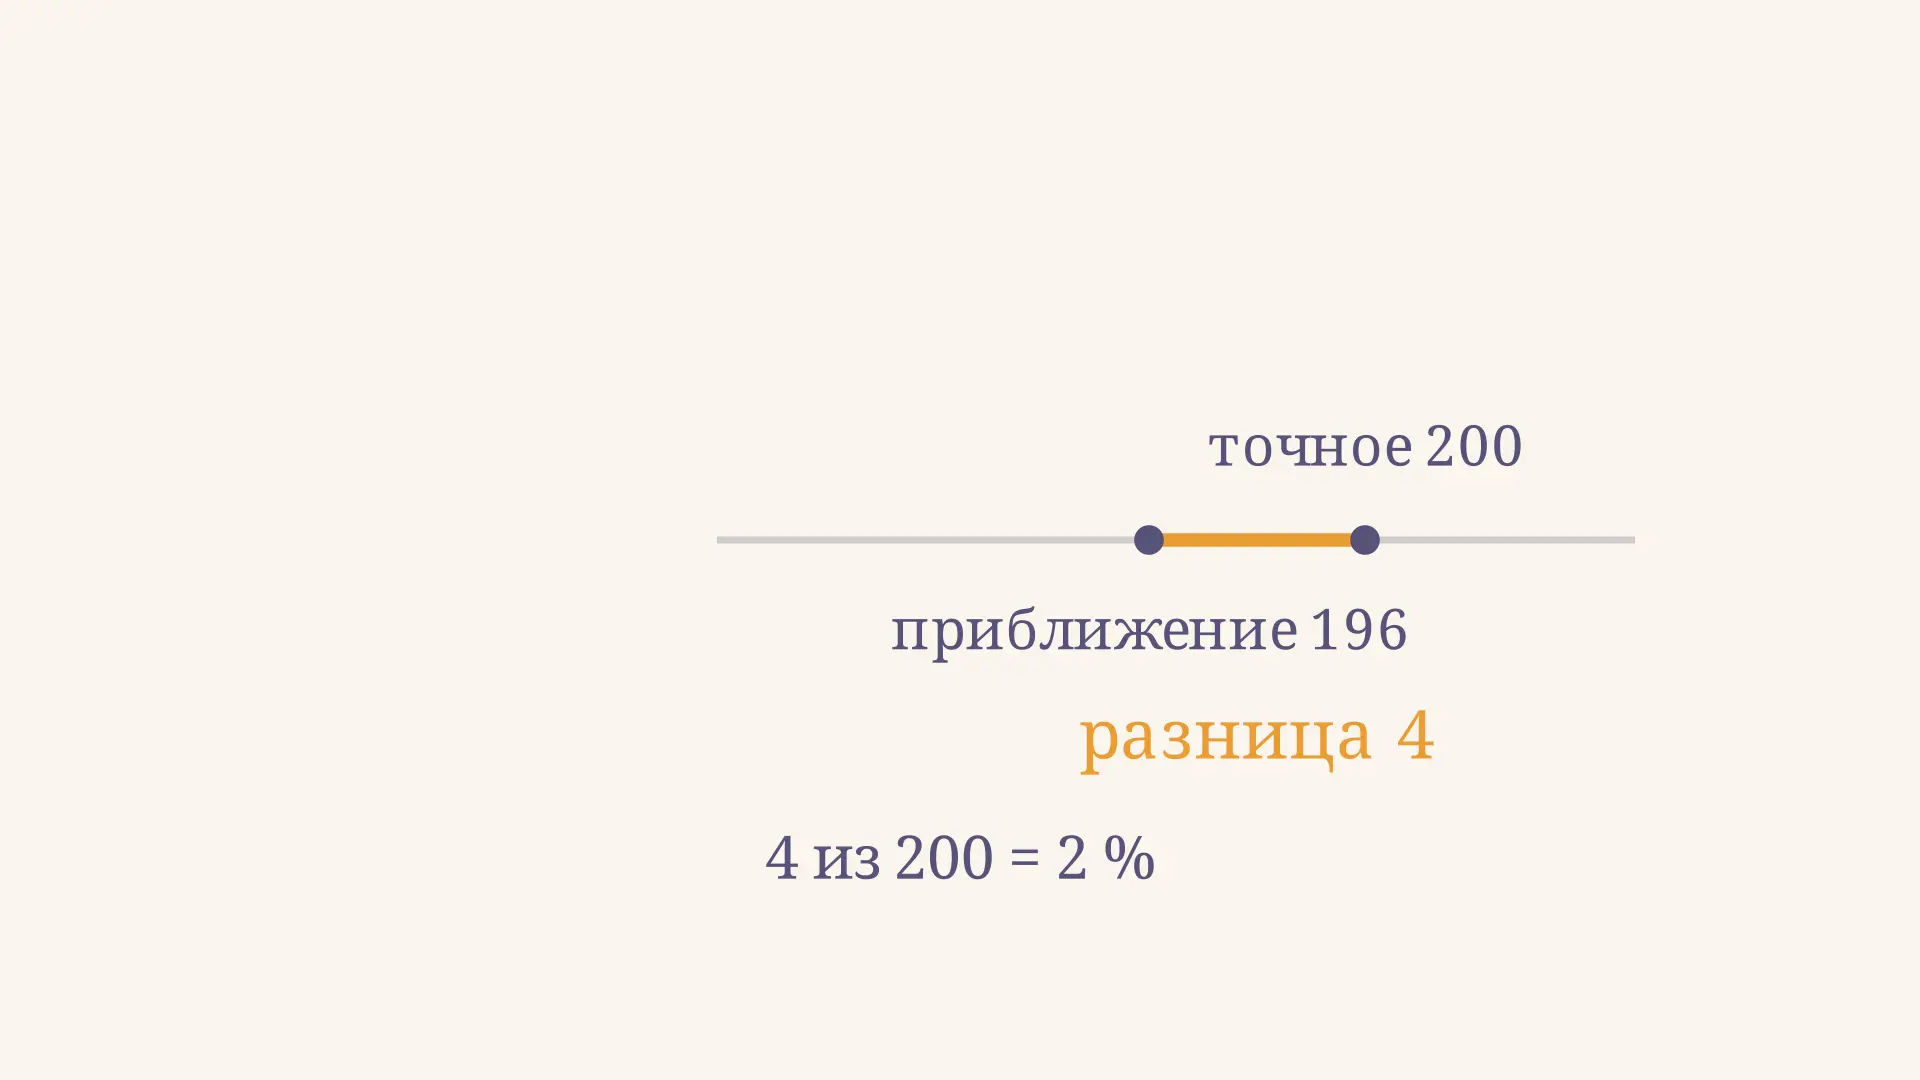
Абсолютная и относительная погрешность числа
Абсолютная и относительная погрешность приближённого числа: формулы, расчёт в процентах, оценка при округлении и подробные примеры сравнения точности.
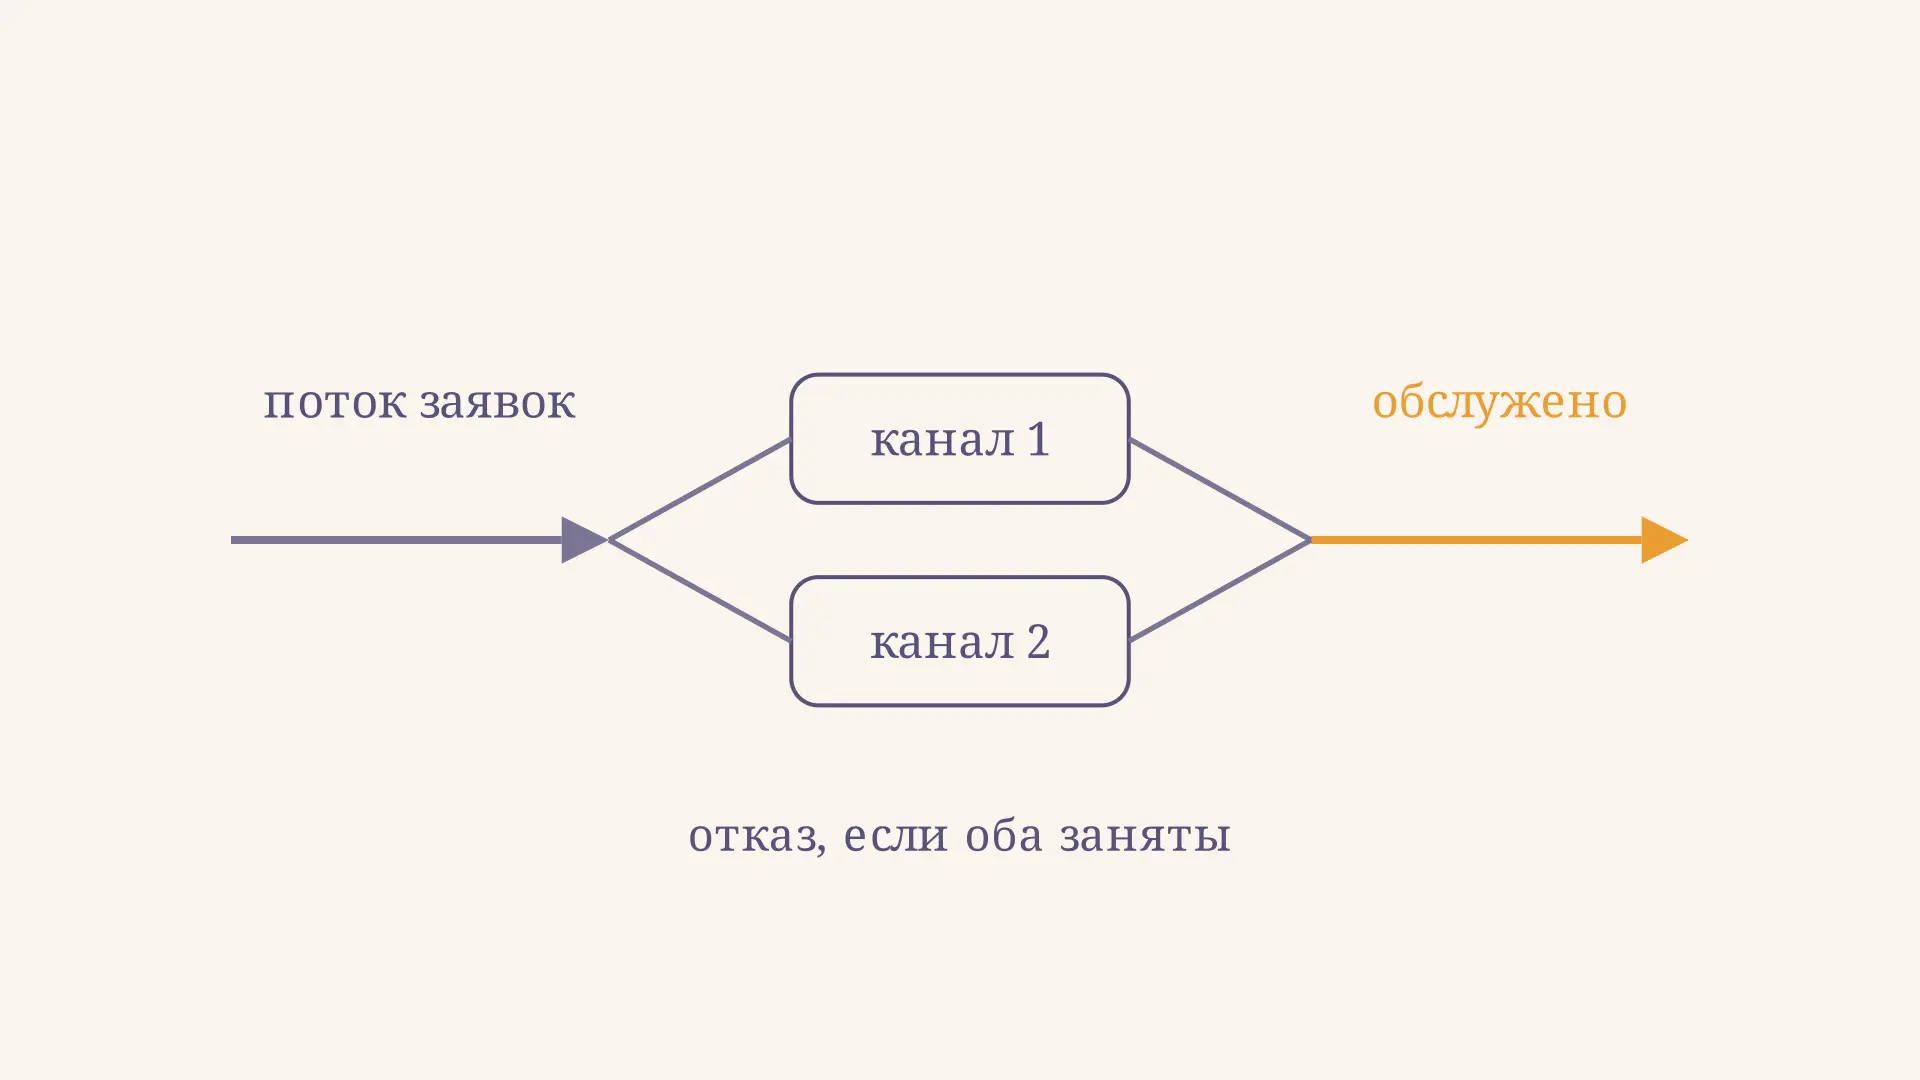
Абсолютная пропускная способность СМО: формула
Как найти абсолютную пропускную способность СМО через интенсивность потока и вероятность отказа: формула, пример расчёта и отличие от относительной способности.