LDPC-коды: проверки чётности и исправление ошибок
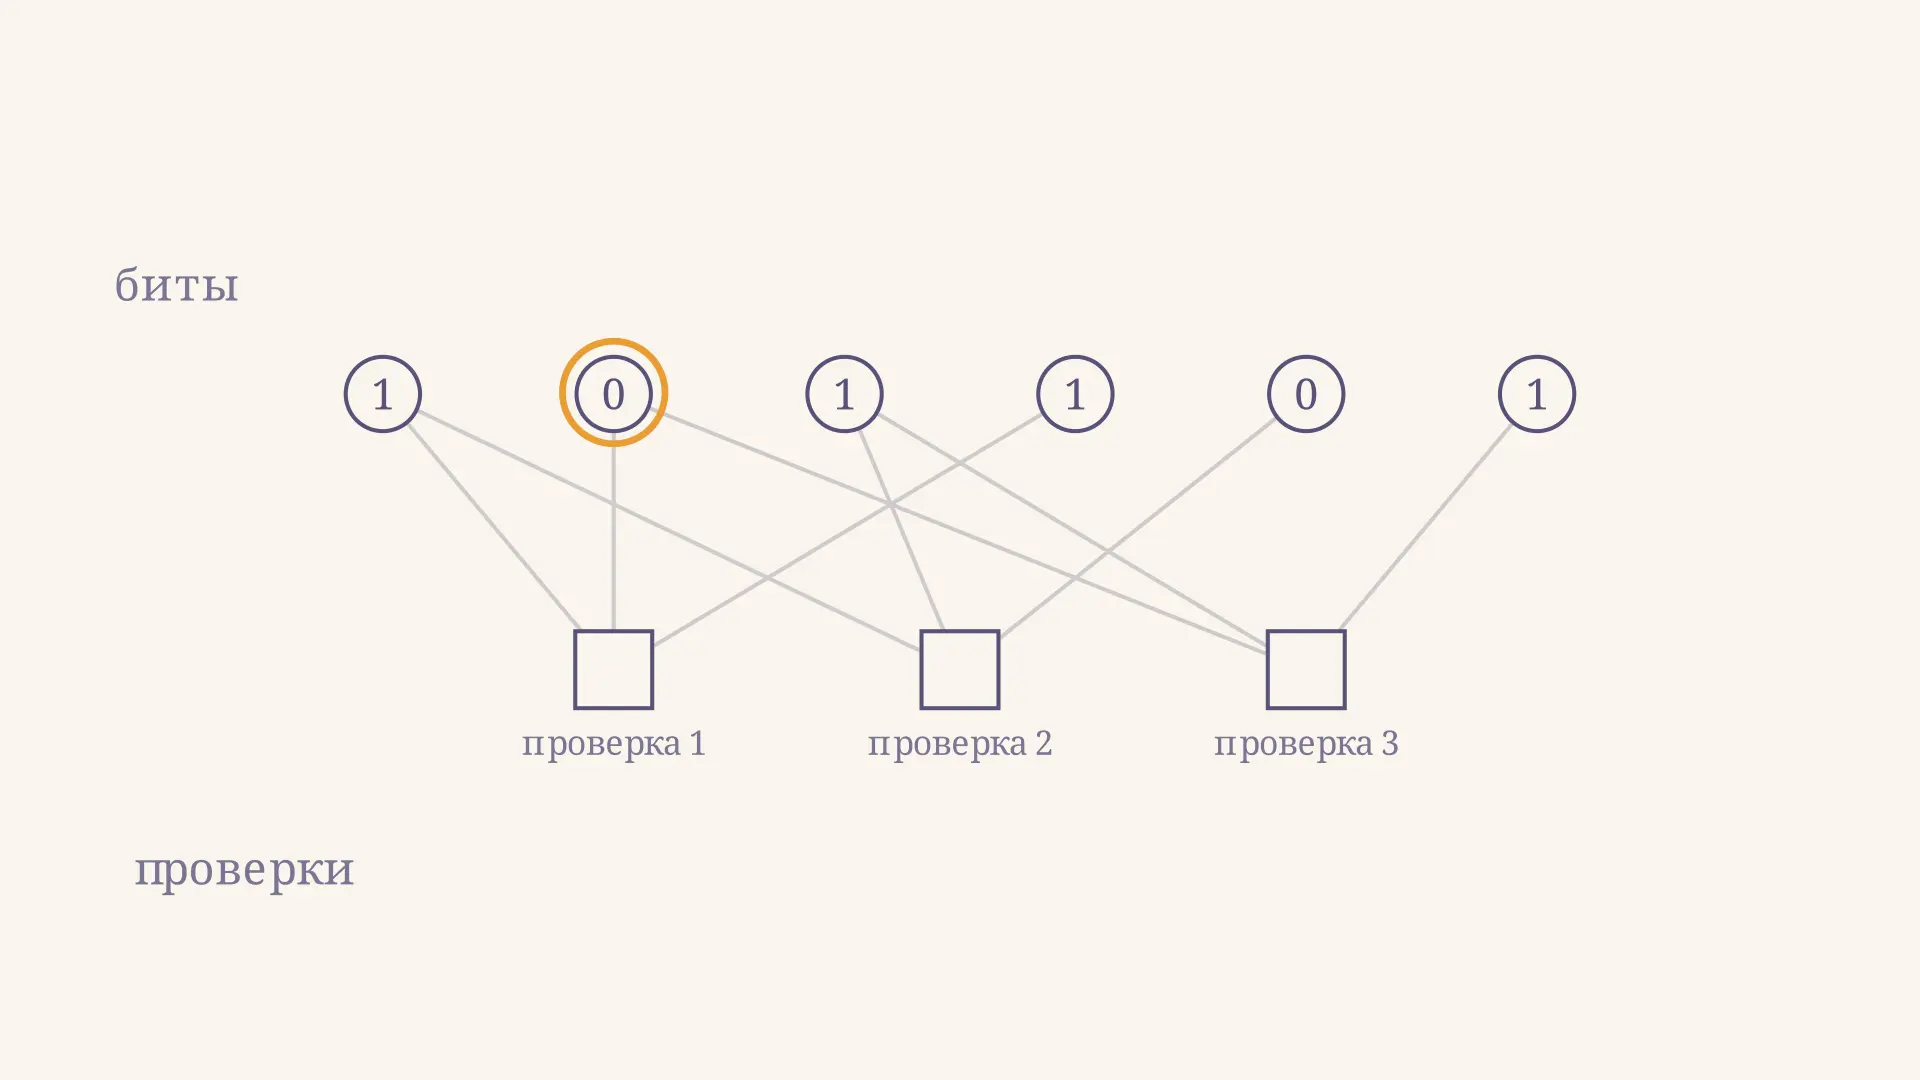
При передаче данных отдельные биты могут измениться из-за шума. LDPC-коды добавляют к сообщению избыточность так, чтобы приёмник мог обнаруживать и исправлять многие ошибки. Их особенность - система локальных проверок: каждая связывает лишь небольшую часть длинного блока, а каждый бит участвует в нескольких проверках. Ниже разберём матрицу, синдром и обмен сообщениями на графе. Сначала выберите позицию ошибки в калькуляторе: он покажет, какие проверки нарушены в маленькой учебной модели.
Зачем нужна избыточность
При помехоустойчивом кодировании отправитель преобразует сообщение в более длинное кодовое слово. Приёмник использует заложенные ограничения, чтобы отличить допустимые слова от многих искажённых. Это другая задача, чем представление текста в ASCII: код символа определяет его двоичное представление, а код канала защищает последовательность бит при передаче.
Если один бит просто повторить трижды, слово 000 при одной ошибке превратится, например, в 010. Голосование вернёт ноль, но на один информационный бит уйдут три переданных. Более сложный код распределяет проверки между битами и позволяет выбирать компромисс между надёжностью, избыточностью и сложностью обработки. Скорость блока - отношение числа информационных бит к длине кодового слова . Это не скорость передачи в битах в секунду.
LDPC расшифровывается как low-density parity-check: код с проверками чётности низкой плотности. Семейство предложил Роберт Галлагер; его исходная работа описывает коды через разреженные проверочные матрицы. В длинном блоке разреженность означает, что единиц в матрице мало относительно общего числа её элементов.
Матрица проверок чётности
Пусть - двоичная матрица, а - столбец кодового слова. Слово допустимо, если
Каждая строка задаёт проверку: нужно сложить биты, под которыми в строке стоят единицы, и взять остаток по модулю два. Результат ноль означает чётную сумму. Например, проверка допускает и три нуля, и две единицы. Умножение выполняется над полем из двух элементов: .
Столбец матрицы относится к одному биту, строка - к одной проверке. Единица на пересечении создаёт связь между ними. Если бит участвует сразу в нескольких проверках, его искажение может оставить узнаваемый след в нескольких строках. Разреженность делает локальные вычисления и обмен сообщениями на графе удобными даже для длинных блоков.
Ролик показывает структуру связей, а не полный алгоритм декодирования. В реальном декодере по таким связям многократно передаются оценки, а не просто включается подсветка.
При построении кода важно различать два описания одного множества слов. Проверочная матрица позволяет проверить готового кандидата, но сама по себе не всегда показывает удобный способ быстро получить слово из сообщения. Для кодирования можно построить порождающую матрицу или использовать специальную структуру проверок. Разреженная проверочная матрица не обязана иметь разреженную порождающую матрицу, поэтому вычислительная стоимость кодирования тоже имеет значение.
В регулярной конструкции число связей у каждого битового узла одинаково, как и число связей у каждого узла проверок. В нерегулярной эти степени могут различаться. Самой доли единиц недостаточно, чтобы предсказать качество: расположение связей, длина блока и выбранный декодер тоже существенны.
Пример: от сообщения к кодовому слову
Для ручного счёта возьмём всего шесть бит и три проверки:
Эта маленькая матрица иллюстрирует принцип, но её плотность слишком велика, чтобы считать её типичным практическим примером LDPC. Первые три бита примем за сообщение , а последние три выберем так, чтобы выполнялись проверки. Получится . Проверим по строкам:
- ;
- ;
- .
Все три результата нулевые. Строки этой матрицы независимы: в последних трёх столбцах стоит единичная матрица. Поэтому её ранг равен трём, размерность кода , а скорость . Общее правило использует именно ранг: число строк не всегда равно числу независимых ограничений.
Синдром и поиск одиночной ошибки
Предположим, второй бит изменился в канале: вместо принято . Приёмник умножает принятое слово на ту же матрицу:
В первой проверке теперь три единицы, во второй две, в третьей одна. Поэтому синдром : нарушены первая и третья проверки. На схеме показано это измеримое различие между отправленным и принятым словами.
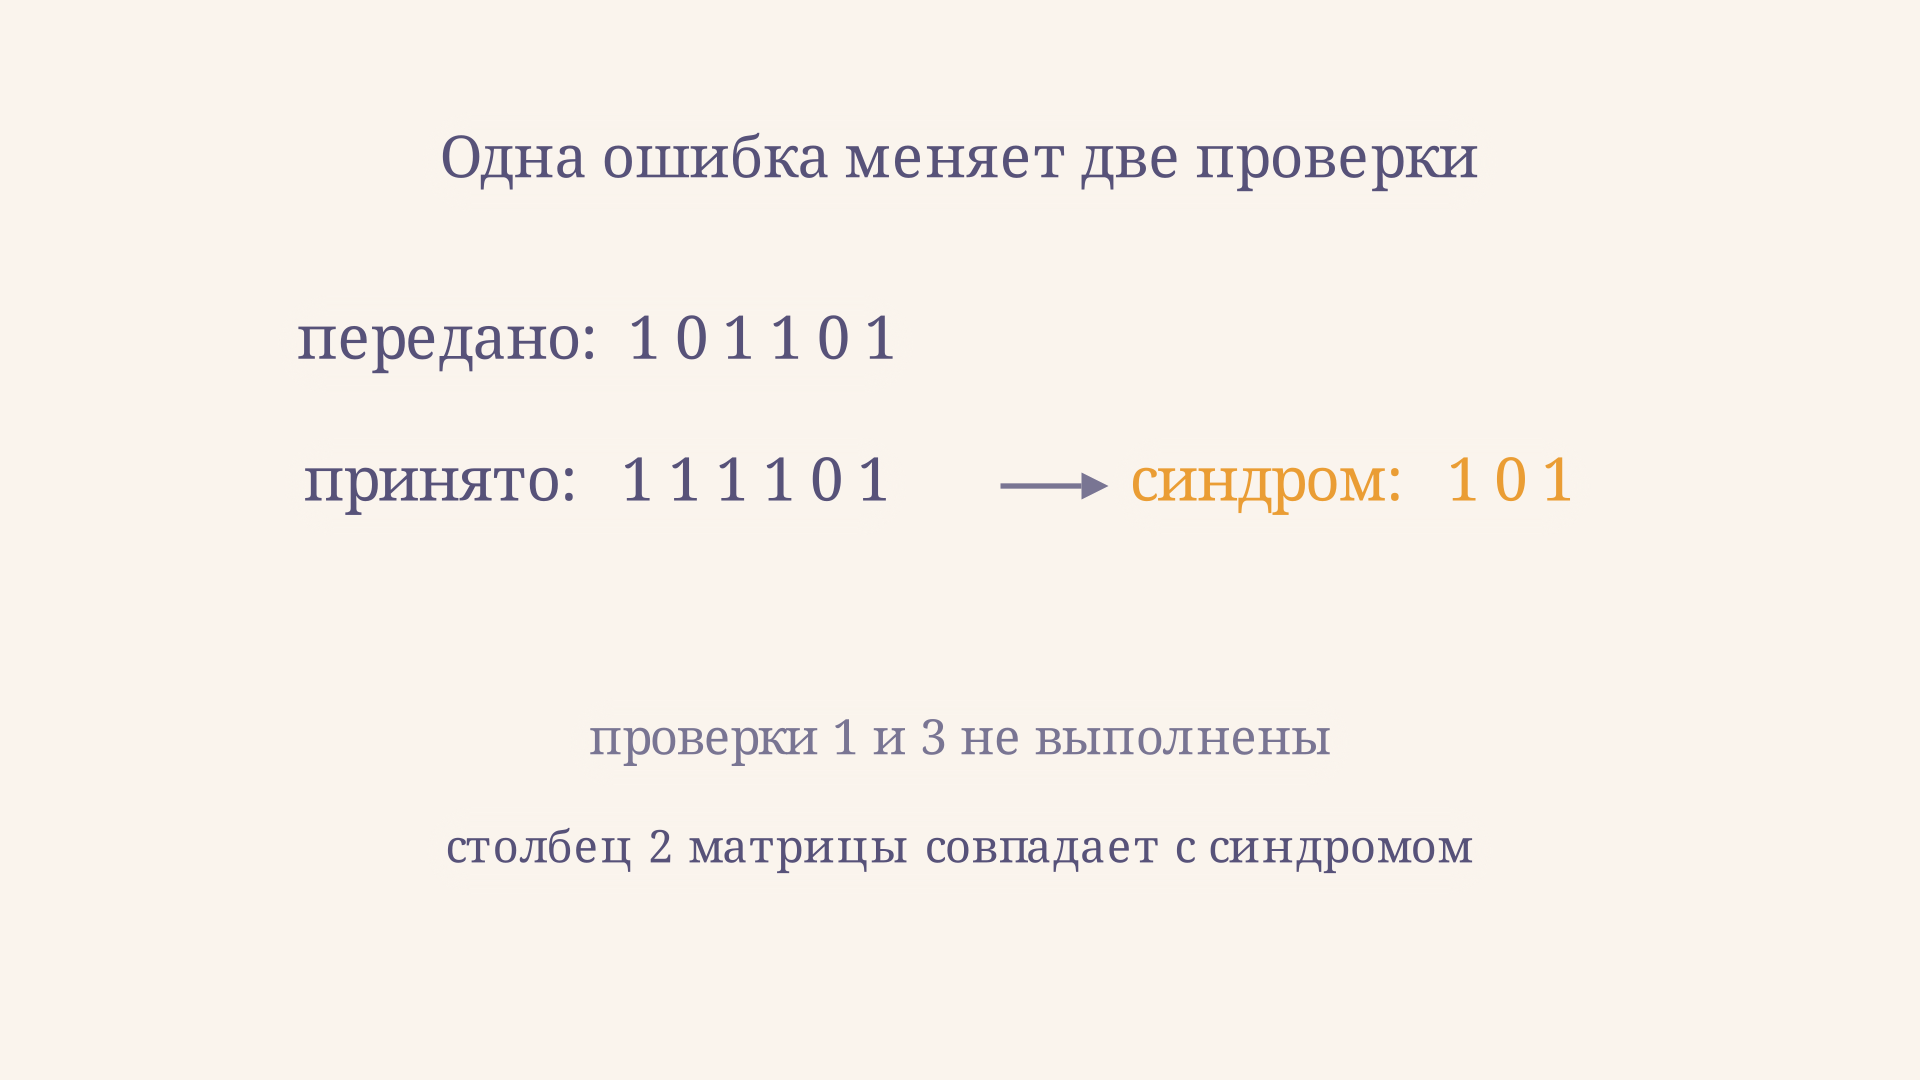
Почему синдром помогает найти позицию? Если по модулю два, то . Для единственной ошибки в позиции вектор содержит там единицу, а синдром равен -му столбцу . В нашем случае совпадает со вторым столбцом. Все шесть столбцов различны и ненулевые, поэтому при условии не более одной ошибки можно определить её позицию и перевернуть бит обратно.
Без этого условия вывод не гарантирован. Например, ошибки в первом и третьем битах дают сумму столбцов , тот же синдром, что и ошибка во втором. Исправление второго бита тогда приведёт к другому допустимому слову. Даже нулевой синдром доказывает лишь выполнение проверок, а не совпадение с исходным словом: принятое слово может оказаться другим кодовым словом.
Граф Таннера и итеративное декодирование
Ту же матрицу изображают двудольным графом Таннера. С одной стороны стоят узлы битов, с другой - узлы проверок; ребро проводят там, где в стоит единица. Во втором столбце нашей матрицы две единицы, поэтому второй бит соединён с проверками 1 и 3. Это удобное представление для понимания того, какие вычисления можно выполнять локально.
В практическом итеративном декодере приёмник сначала получает от канала оценку каждого бита. Мягкое решение учитывает не только предполагаемый ноль или единицу, но и уверенность в нём. Далее узлы битов передают соседним проверкам оценки; проверки сопоставляют их с условием чётности и отправляют обратно новую информацию. Затем узлы битов обновляют свои оценки, и обмен повторяется. Описание вероятностного распространения по строкам и столбцам матрицы есть в материалах Радфорда Нила.
Есть и более грубые схемы с жёстким решением, которые начинают только с нулей и единиц. Например, правило переворота бита может ориентироваться на число связанных с ним нарушенных проверок. Однако одновременные ошибки способны исказить такое голосование, а конкретный порог и порядок обновления влияют на результат. Мягкие оценки сохраняют больше информации о сигнале, но требуют более сложных вычислений и памяти. Ни один из этих вариантов не следует смешивать с простым поиском столбца в примере выше.
После итерации декодер может проверить синдром текущего решения и остановиться при нулевом результате; также задают предел числа итераций. Такой процесс не гарантирует успеха при любом наборе помех. Циклы графа, структура кода и качество сигнала влияют на результат, а нулевой синдром сам по себе не исключает ошибочного кодового слова.
Где применяют LDPC и что сравнивать
Разреженные коды применяются в системах связи и хранения, где важны пропускная способность и устойчивость к шуму. В частности, спецификация 3GPP TS 38.212 задаёт канальное кодирование 5G NR, включая LDPC для каналов данных. Практический код имеет структуру и ограничения стандарта; учебная матрица выше их не воспроизводит.
Сравнивая варианты, смотрят не только на скорость . Важны длина блока, вероятность ошибки при конкретном канале и отношении сигнал/шум, задержка, число итераций и стоимость реализации. Слишком короткий блок или слишком маленький лимит итераций могут изменить результат. Теоретические ограничения передачи информации помогают понять компромисс; подробнее об информационных величинах см. формулу Шеннона. Для сравнения другого семейства линейных кодов полезен код Рида - Маллера, а для работы с двоичными представлениями - дополнительный код отрицательных чисел.
Частые ошибки
- Считать синдром исправленным словом. Синдром показывает нарушения проверок; для выбора исправления нужны модель ошибок и правило декодирования.
- Считать нулевой синдром доказательством отсутствия ошибок. Другое допустимое слово тоже имеет нулевой синдром.
- Приравнивать число строк к числу независимых проверок. Зависимые строки не увеличивают ранг, поэтому размерность считают через .
- Переносить результат для одной ошибки на несколько. Разные наборы ошибок могут иметь одинаковый синдром.
- Путать скорость кода с пропускной способностью канала. Доля не выражается в битах в секунду.
FAQ
LDPC всегда исправляет любую одиночную ошибку?
Не обязательно. Для однозначного исправления одной ошибки по синдрому столбцы должны быть ненулевыми и различными; кроме того, конкретный алгоритм декодирования должен действительно использовать эту возможность. Свойства зависят от выбранного кода.
Почему матрицу называют разреженной?
Потому что в длинной матрице доля единиц мала. Это свойство матрицы проверок, а не утверждение, что сами кодовые слова содержат мало единиц.
Проверка чётности и синдром - одно и то же?
Одна проверка даёт один бит результата. Синдром собирает результаты всех проверок в вектор и позволяет сопоставить их друг с другом.
Коротко
LDPC-код задаётся разреженной матрицей проверок чётности и часто декодируется итеративно на графе Таннера. В учебном примере ошибка второго бита меняет синдром с 000 на 101; при известном ограничении на одну ошибку этот синдром указывает на второй столбец матрицы. При нескольких ошибках такой вывод уже может быть неверным.
Читайте также
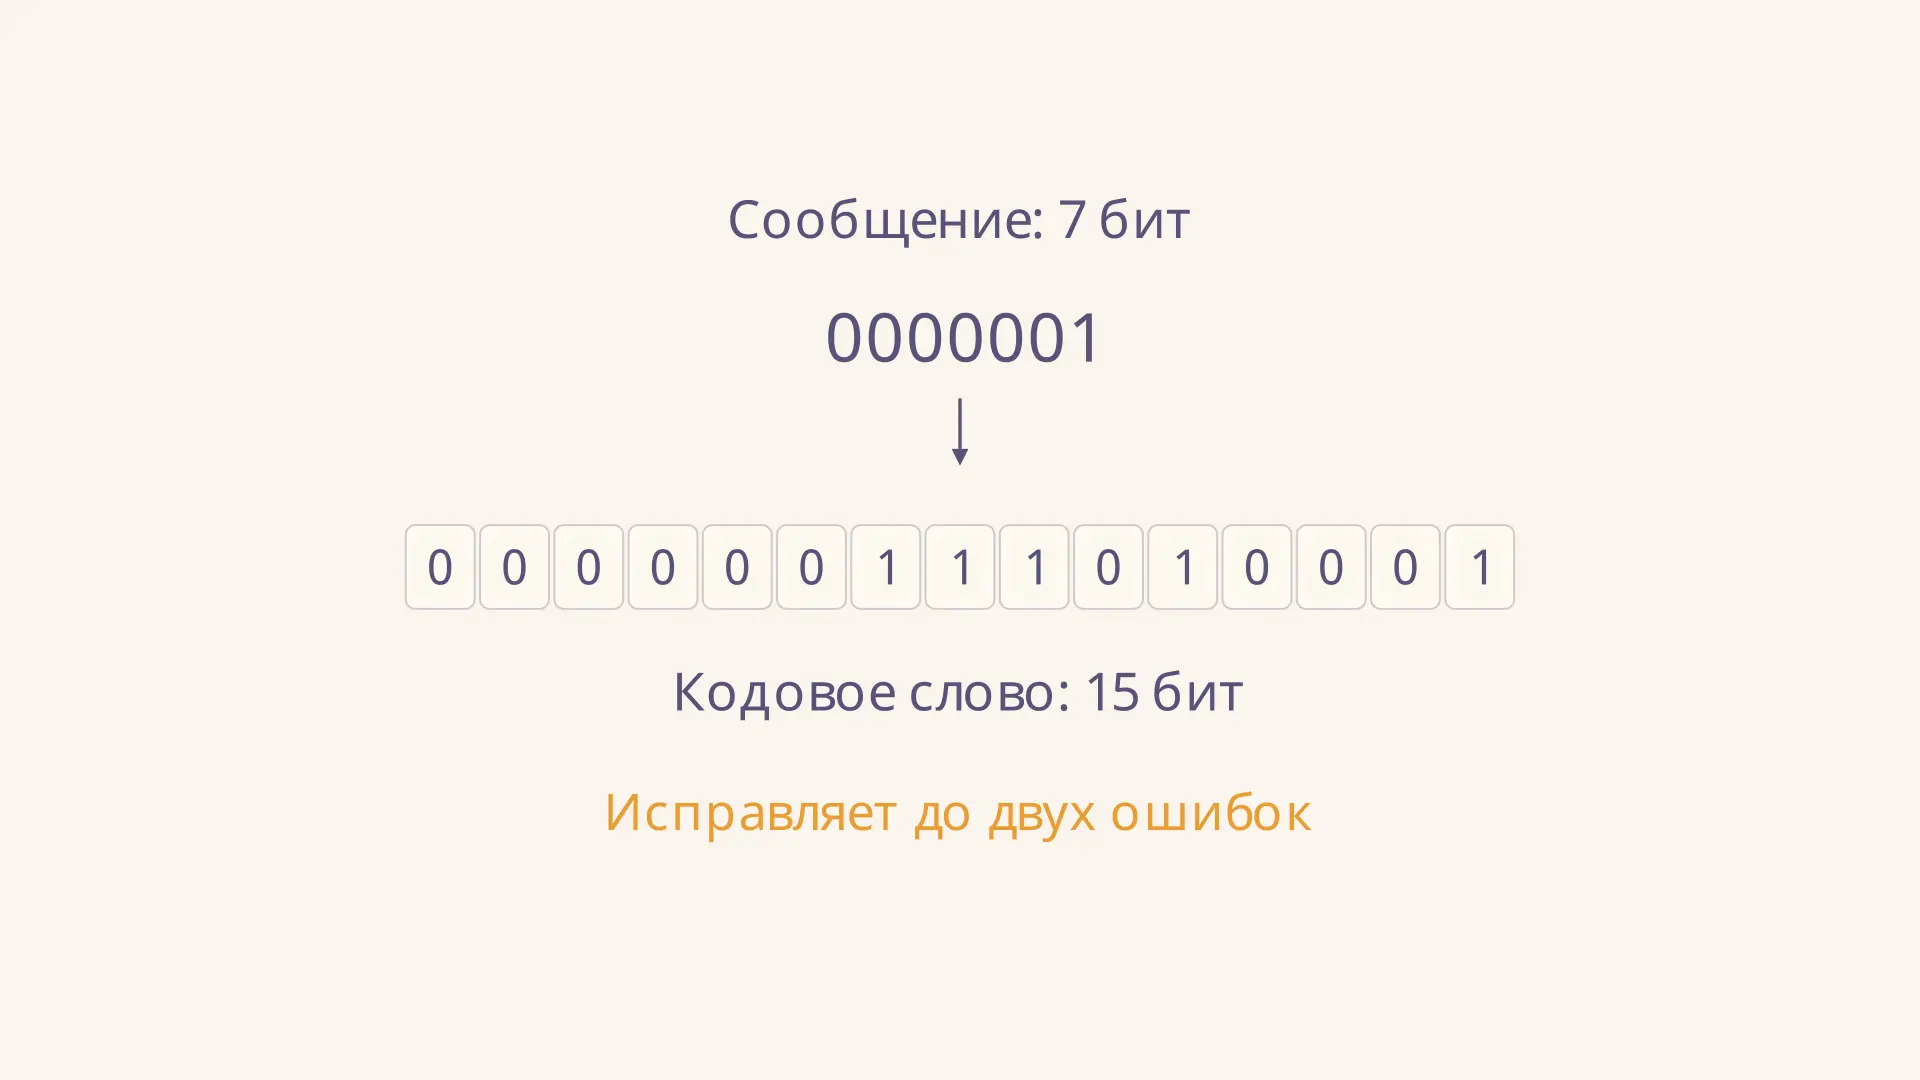
Код БЧХ: построение и исправление ошибок
Код БЧХ простыми словами: как построить двоичный код, вычислить синдром и исправить ошибки. Разбираем пример БЧХ (15, 7, 5) с порождающим многочленом.
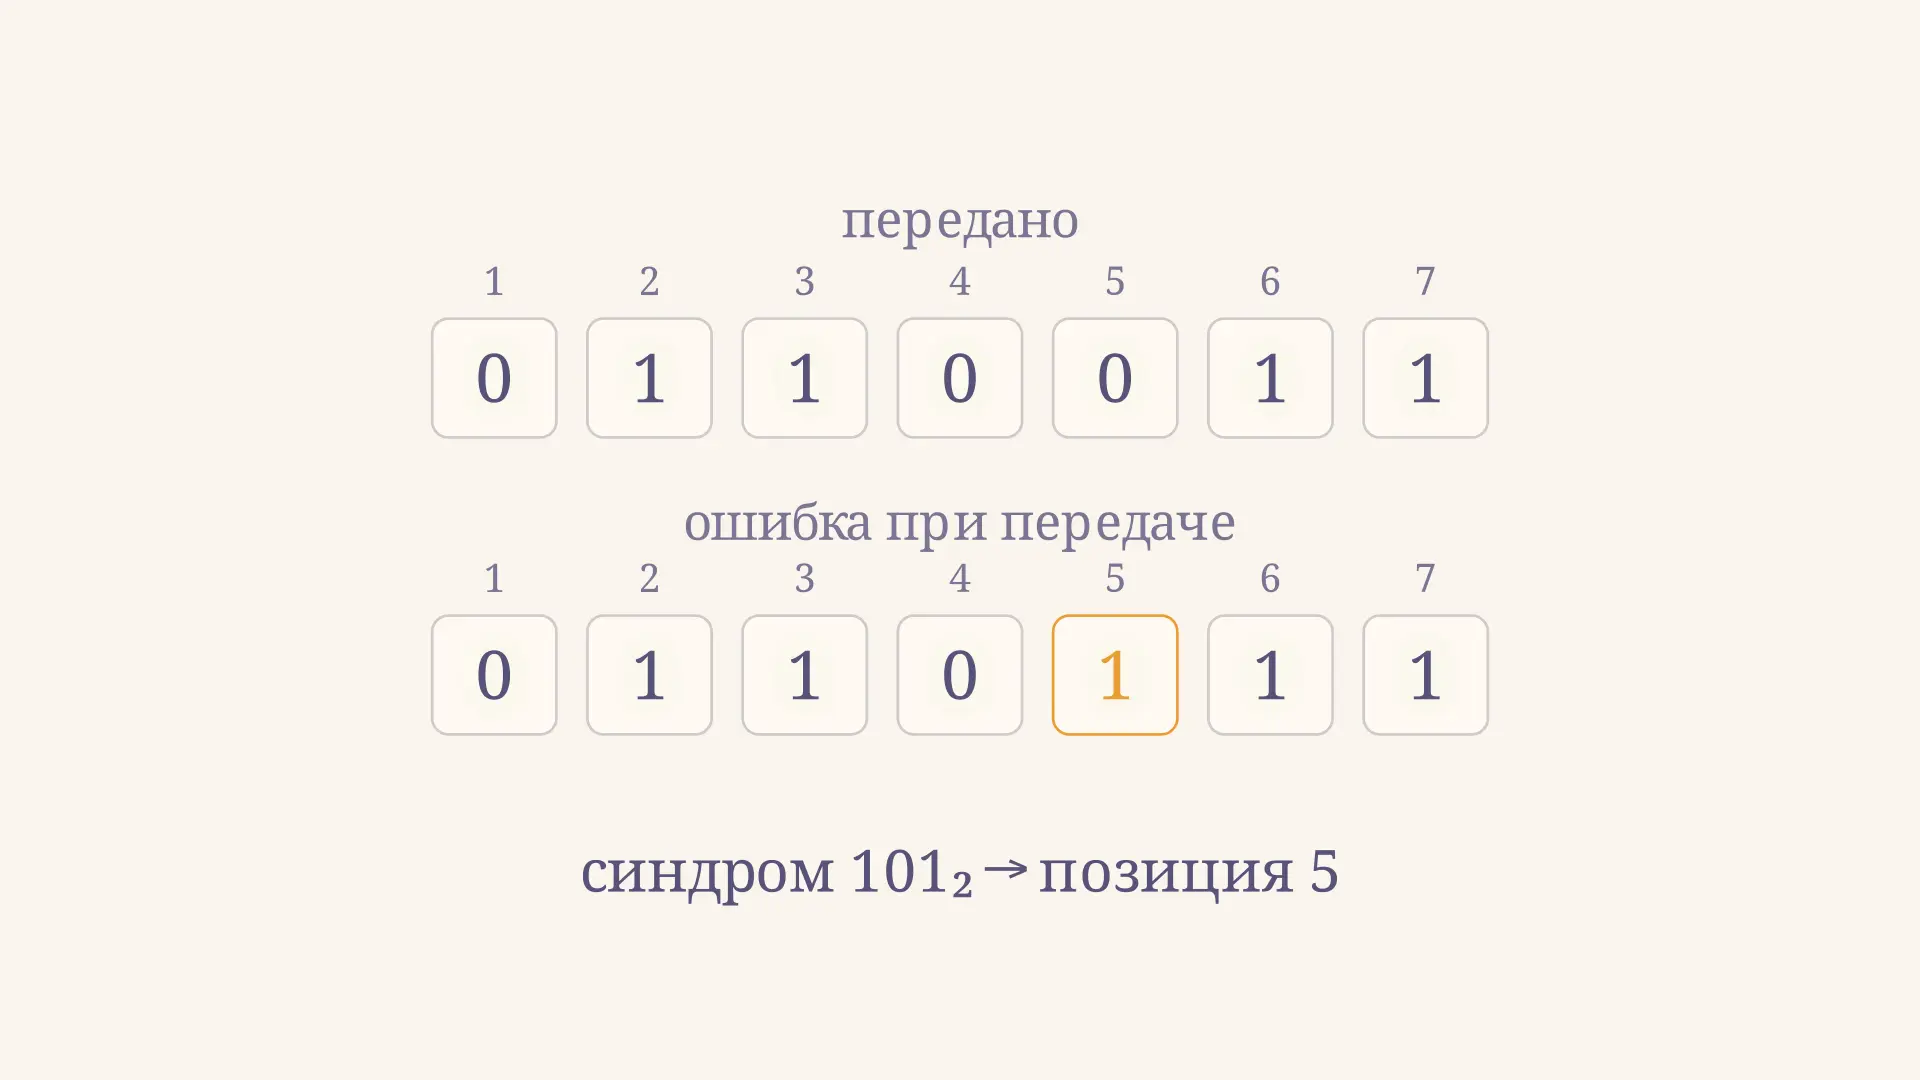
Код Хэмминга: исправление ошибок на примере
Код Хэмминга для исправления ошибок: как расставить проверочные биты, вычислить синдром и восстановить данные на примере кода (7, 4), а также каковы его ограничения.
Код Рида-Маллера: параметры, построение и декодирование
Код Рида-Маллера простыми словами: как считать длину, размерность и кодовое расстояние RM(r, m), рекурсивное построение u, u+v и мажоритарное декодирование с примерами и калькулятором.
Абсолютно неупругий удар: сохранение импульса
Как найти скорость тел после абсолютно неупругого удара, применить закон сохранения импульса и вычислить потерю кинетической энергии на понятных примерах с формулами.
Абсолютное и избыточное давление: формулы и вакуум
Абсолютное и избыточное давление, разрежение и вакуум: как выбрать начало отсчёта, перевести показания манометра и решить задачи с примерами в килопаскалях.
АЦП последовательного приближения: схема и принцип работы
Разберите схему АЦП последовательного приближения: как компаратор, ЦАП и регистр определяют код по битам, как вычислить шаг квантования и оценить погрешность.