Поиск максимума и минимума в массиве
Поиск максимума и минимума в массиве нужен, когда требуется узнать границы набора значений: например, самую низкую и высокую температуру среди измерений. Сортировать данные для этого необязательно. Достаточно один раз пройти по элементам и запоминать наименьший и наибольший из уже просмотренных. В интерактиве ниже можно менять длину просмотренной части и следить, когда обновляются оба результата.
Идея одного прохода
Пусть массив непустой. Первый элемент уже является и минимумом, и максимумом среди одного просмотренного элемента. Поэтому запишем его в две переменные. Затем для каждого следующего значения проверим, меньше ли оно текущего минимума и больше ли текущего максимума. При необходимости обновим соответствующую переменную.
Важно различать весь массив и его префикс: пока просмотрена только часть данных, найденные числа гарантированно являются экстремумами именно этой части. Когда достигнут последний элемент, префикс совпадает со всем массивом. Анимация возвращается назад для повторного просмотра; обычный алгоритм при выполнении идёт только вперёд.
Такой приём полезен и для потока данных: хранить все предыдущие значения не обязательно, если нужны только текущие границы и элементы поступают по одному. В отличие от кольцевого буфера, здесь не требуется сохранять фиксированное окно последних элементов. Если же старые элементы удаляются из окна, одного текущего минимума может быть недостаточно: после удаления придётся иметь дополнительную структуру или искать заново.
Пример с индексами
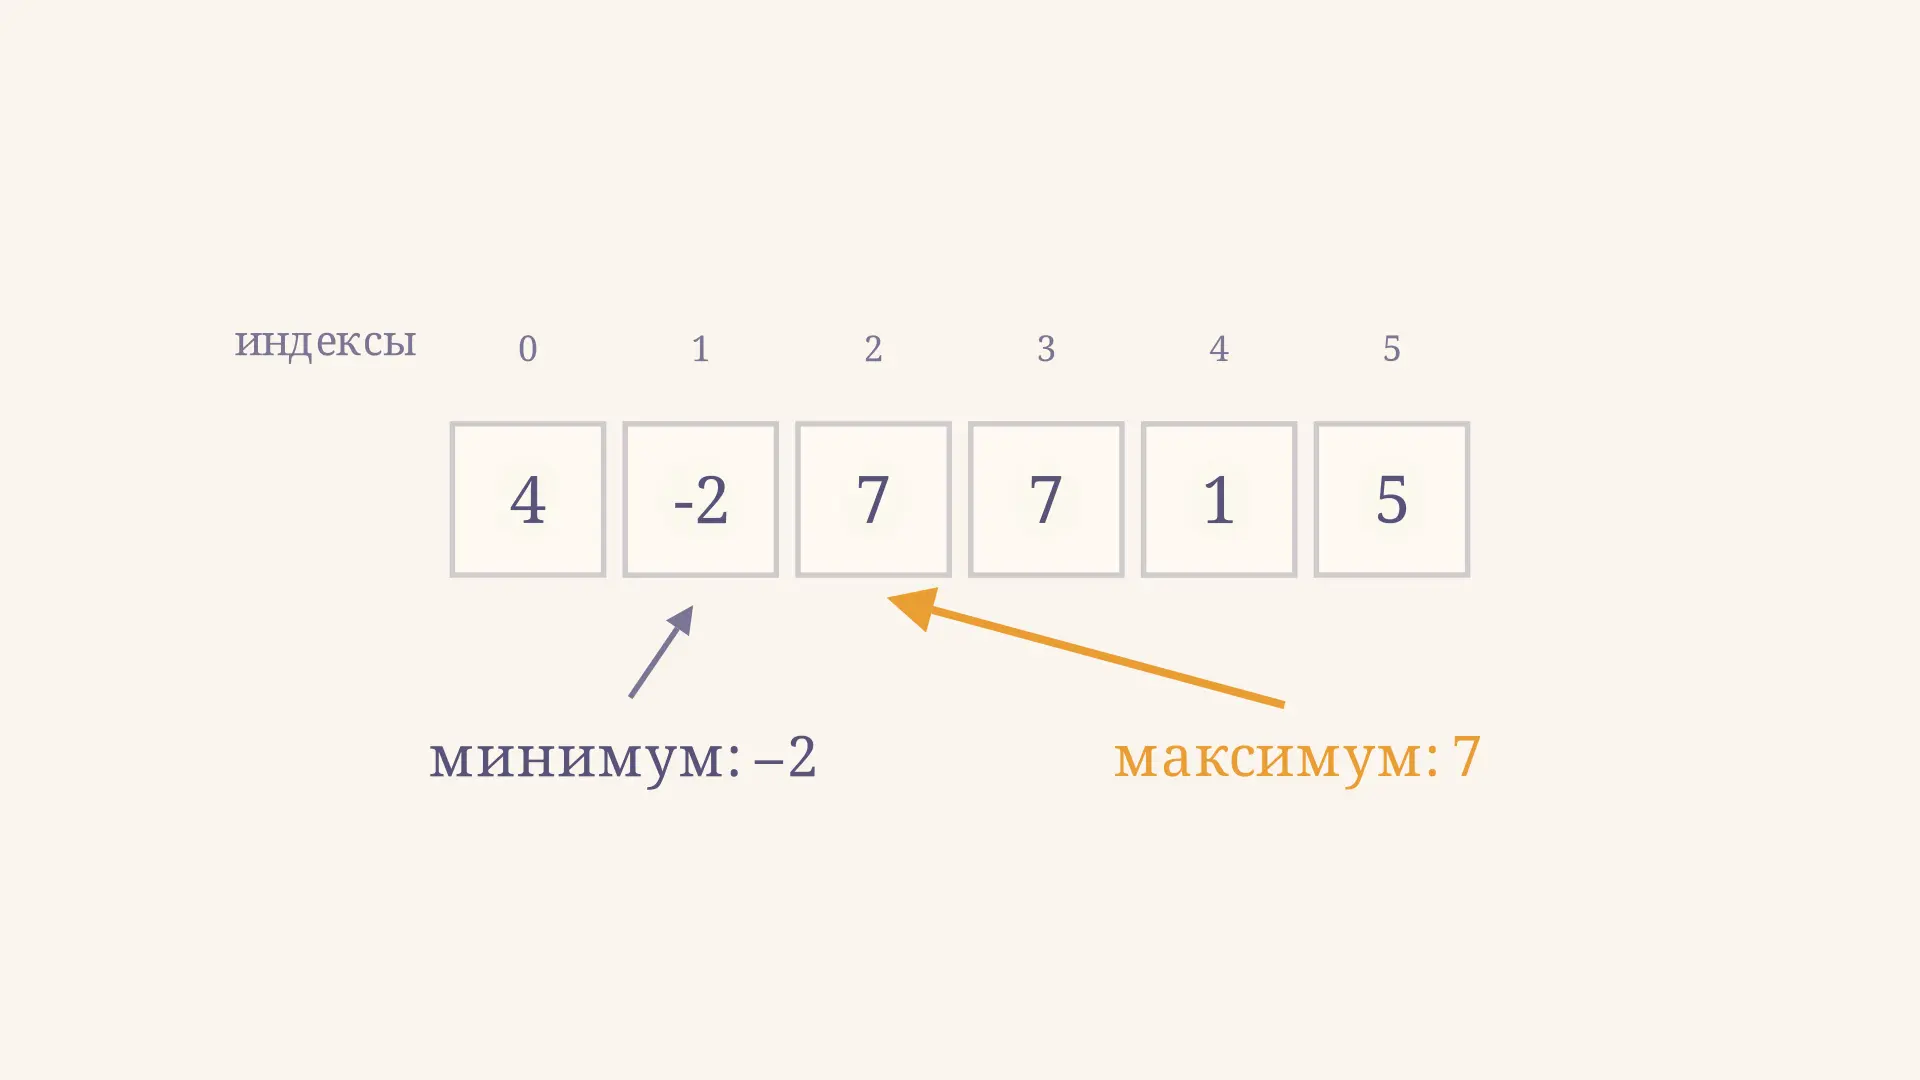
Рассмотрим массив . Индексация начинается с нуля. После первого элемента обе переменные равны 4. Число уменьшает минимум, первое 7 увеличивает максимум; второе 7 не меняет значение максимума. Оставшиеся 1 и 5 лежат между текущими границами.
| Просмотренный элемент | Минимум | Максимум |
|---|---|---|
| 4 | 4 | 4 |
| −2 | −2 | 4 |
| 7 | −2 | 7 |
| 7 | −2 | 7 |
| 1 | −2 | 7 |
| 5 | −2 | 7 |
Итог: минимум находится по индексу 1, максимум 7 встречается по индексам 2 и 3. Если хранить один индекс и обновлять его только при строгом улучшении, останется первое вхождение: индекс 2. При нестрогом сравнении максимум будет обновлён и для равного значения, поэтому сохранится последнее вхождение. Правило необходимо выбрать до написания кода.
Реализация на Python
Функция ниже возвращает значения и первые индексы. Два независимых условия намеренно выполняются для каждого элемента после первого: это упрощает подсчёт сравнений.
def extrema(a):
    if not a:
        raise ValueError("Массив пуст")

    min_value = max_value = a[0]
    min_index = max_index = 0
    for i in range(1, len(a)):
        x = a[i]
        if x < min_value:
            min_value, min_index = x, i
        if x > max_value:
            max_value, max_index = x, i
    return min_value, min_index, max_value, max_index

print(extrema([4, -2, 7, 7, 1, 5]))
# (-2, 1, 7, 2)
В цикле индекс идёт от 1 до включительно. Первый элемент не сравнивается сам с собой: он уже использован для начальных значений. Переменные хранят числа и их позиции, но сам массив функция не изменяет. Например, для массива из одного элемента она сразу вернёт это значение дважды и оба индекса 0.
Если нужны только значения, в Python доступны min(a) и max(a). Согласно документации Python, для пустого итерируемого объекта без аргумента default возникает ValueError. Два отдельных вызова независимо обходят данные; для одноразового итератора второй вызов после первого уже не получит исходную последовательность. Однопроходный вариант удобен, когда элементы нельзя прочитать повторно.
Почему алгоритм правильный
Для доказательства используем инвариант: после обработки элемента с индексом переменные содержат минимум и максимум элементов с индексами от 0 до . В начале это верно для единственного элемента .
Предположим, что утверждение верно до очередного шага. Новый элемент либо меньше сохранённого минимума, либо нет. В первом случае он становится новым минимумом, во втором прежний минимум остаётся наименьшим. Аналогично сравнение с максимумом сохраняет правильный максимум расширенного префикса. Значит, инвариант верен и после этого шага. Когда цикл закончится, он относится ко всему массиву.
Инвариант помогает проверять и более сложные проходы. Например, алгоритм Кадане тоже поддерживает состояние при последовательном чтении, но решает другую задачу: ищет максимальную сумму непрерывного подмассива, а не отдельный максимальный элемент.
Время, память и число сравнений
Для приведённая функция выполняет два сравнения значений на каждом из шагов, всего . Для шести элементов это 10 сравнений. Проверки границ цикла и пустоты здесь не включены: мы считаем только сравнения элементов с текущими экстремумами. Число таких сравнений не зависит от порядка входа, потому что в коде стоят два отдельных if.
Временная сложность - , дополнительная память - : число переменных не растёт с длиной входа. Без предварительной информации каждый элемент в общем случае необходимо учесть: непросмотренный элемент мог бы оказаться новым минимумом или максимумом. Сортировка тоже позволяет прочитать крайние значения, но ради одного поиска выполняет лишнюю работу и может изменить порядок исходных данных.
На практике структура данных зависит от дальнейших операций. Если необходимо многократно извлекать наибольший элемент из изменяющегося набора, рассмотрите кучу. Для однократного поиска в обычном массиве линейный проход проще и не требует построения структуры.
Попарный способ: меньше сравнений
Можно обрабатывать значения парами. Сначала сравним два элемента пары между собой, затем меньший сравним только с текущим минимумом, а больший - только с текущим максимумом. На очередную пару приходится три сравнения вместо четырёх. При равенстве любой из равных элементов подходит для нахождения значений; для первых индексов нужно отдельно сохранять более раннюю позицию.
Для чётного начнём с одной пары: одно сравнение задаёт начальные минимум и максимум. Оставшиеся пар требуют по три сравнения. Получаем
Для нечётного начнём с первого элемента в обеих ролях, а остальные обработаем парами: получится сравнений. При формула даёт ноль. Это подсчёт сравнений значений в описанной схеме; проверки индексов в него не входят.
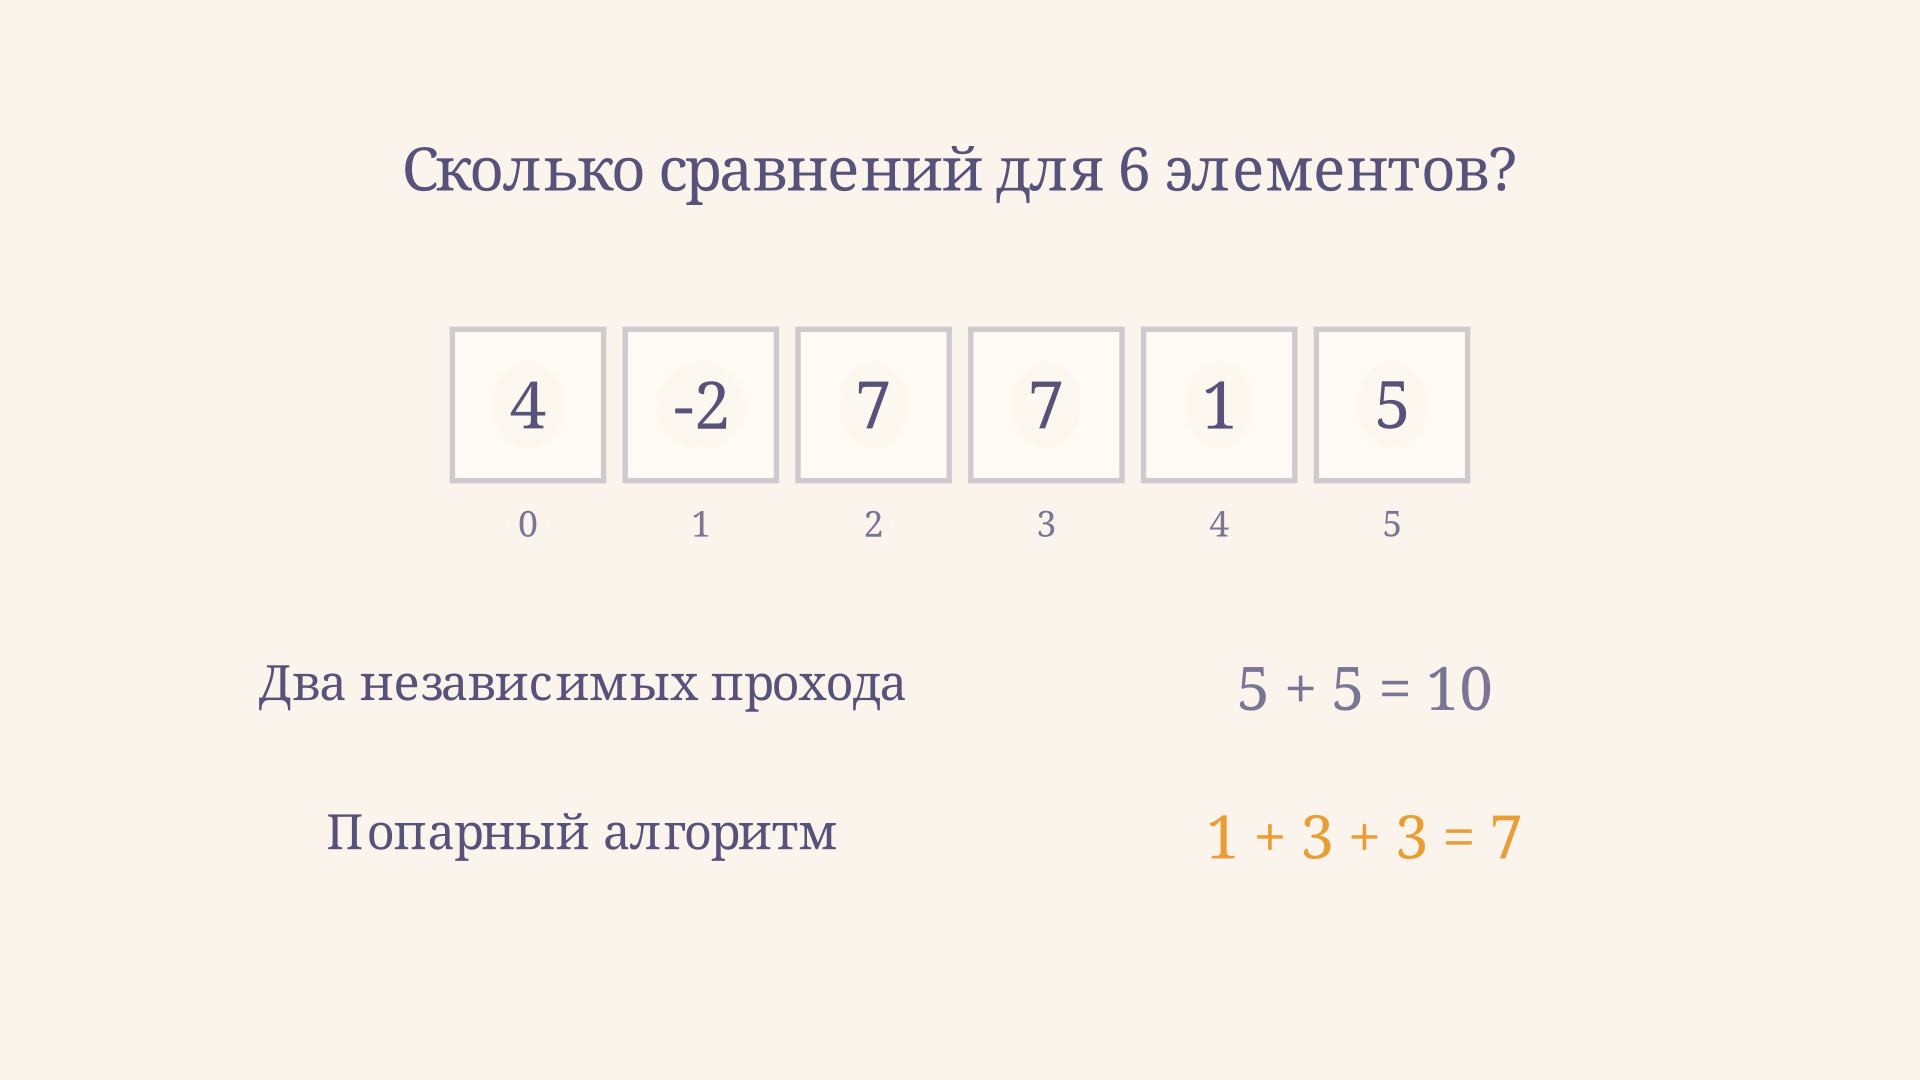
В нашем примере первая пара и задаёт границы за одно сравнение. На пары и расходуется ещё по три, итого 7. Асимптотика остаётся линейной, зато сравнений меньше. Для небольших массивов простой код может быть предпочтительнее; выбор стоит измерять на реальных данных, если производительность важна.
Пустой массив, повторы и типы данных
У пустого массива нет ни минимального, ни максимального элемента. Возможные контракты функции - исключение, специальное значение или отдельный признак отсутствия результата. Главное, чтобы вызывающий код знал выбранное правило. Инициализация нулём вместо первого элемента опасна: в массиве отрицательных чисел ноль станет ложным максимумом, хотя его вообще нет среди данных.
Если нужны все позиции экстремума, можно сначала найти значение, затем вторым проходом собрать совпадающие индексы. Либо поддерживать списки индексов сразу, очищая их при появлении нового экстремума. Память для ответа тогда может вырасти до , например когда все элементы равны.
Сравниваемые значения должны иметь согласованный порядок. Для вещественных чисел отдельно определите обработку NaN: обычные сравнения с ним не ведут себя как сравнения конечных чисел. Для записей с полями сравнивайте нужный ключ, например температуру, сохраняя при необходимости всю запись. Использование массива как основы других структур рассмотрено в статье о стеке; порядок сравнения при этом определяется задачей, а не устройством массива.
Как проверить реализацию на примерах
Подберите входы, которые заставляют алгоритм обновлять разные переменные. В возрастающем массиве новый максимум появляется на каждом шаге, а минимум остаётся первым элементом. В убывающем происходит обратное. Массив из одинаковых значений показывает, правильно ли выбрано правило для повторов. Для каждого случая проверьте не только число, но и его индекс: по этому индексу в исходном массиве действительно должно находиться возвращённое значение.
Полезна и проверка на крайних размерах: пустой ввод должен привести к оговорённому результату, а один элемент не должен вызывать обращение за пределы массива. Затем сравните ответ на нескольких небольших смешанных массивах с результатами встроенных функций. Такая проверка не заменяет доказательство инварианта, но помогает обнаружить ошибки в границах цикла и присваиваниях.
Частые ошибки
- Начинать минимум и максимум с нуля. Берите первый элемент после проверки непустоты: тогда отрицательные и положительные данные обрабатываются одинаково.
- Забывать про последний элемент. В Python правая граница
rangeне включается, поэтому используйтеrange(1, len(a)). - Путать значение с индексом. Число 7 в примере - максимум, а 2 и 3 - его позиции при индексации с нуля.
- Не оговорить повторы. Строгие и нестрогие сравнения дают разные позиции при равных значениях.
FAQ
Можно ли найти оба экстремума за один проход?
Да. Достаточно хранить текущие минимум и максимум и обновлять их после каждого нового элемента. Это работает и при последовательном чтении потока.
Что вернуть для массива из одного числа?
Единственный элемент является одновременно минимумом и максимумом. При индексации с нуля обе позиции равны 0, сравнений значений не требуется.
Всегда ли попарный алгоритм быстрее?
Нет. Он уменьшает число сравнений значений, но фактическое время зависит от языка, реализации и стоимости сравнений. При простых числах разница может не оправдать усложнение кода.
Коротко
Для непустого массива начните с первого элемента и последовательно обновляйте две границы. Простой вариант делает сравнений и использует постоянную дополнительную память. Попарный способ уменьшает число сравнений, а правило для пустого ввода и повторяющихся экстремумов следует явно указать в контракте функции.
Читайте также
Ханойские башни и рекурсия: решение по шагам
Ханойские башни и рекурсия: разберём правила, семь ходов для трёх дисков, рекурсивный алгоритм, доказательство минимального числа ходов и его сложность.
Стек на списке: реализация push и pop через массив
Как реализовать стек на списке: индекс вершины, амортизированная сложность push O(1), расширение массива вдвое при переполнении и почему pop не освобождает память сразу.
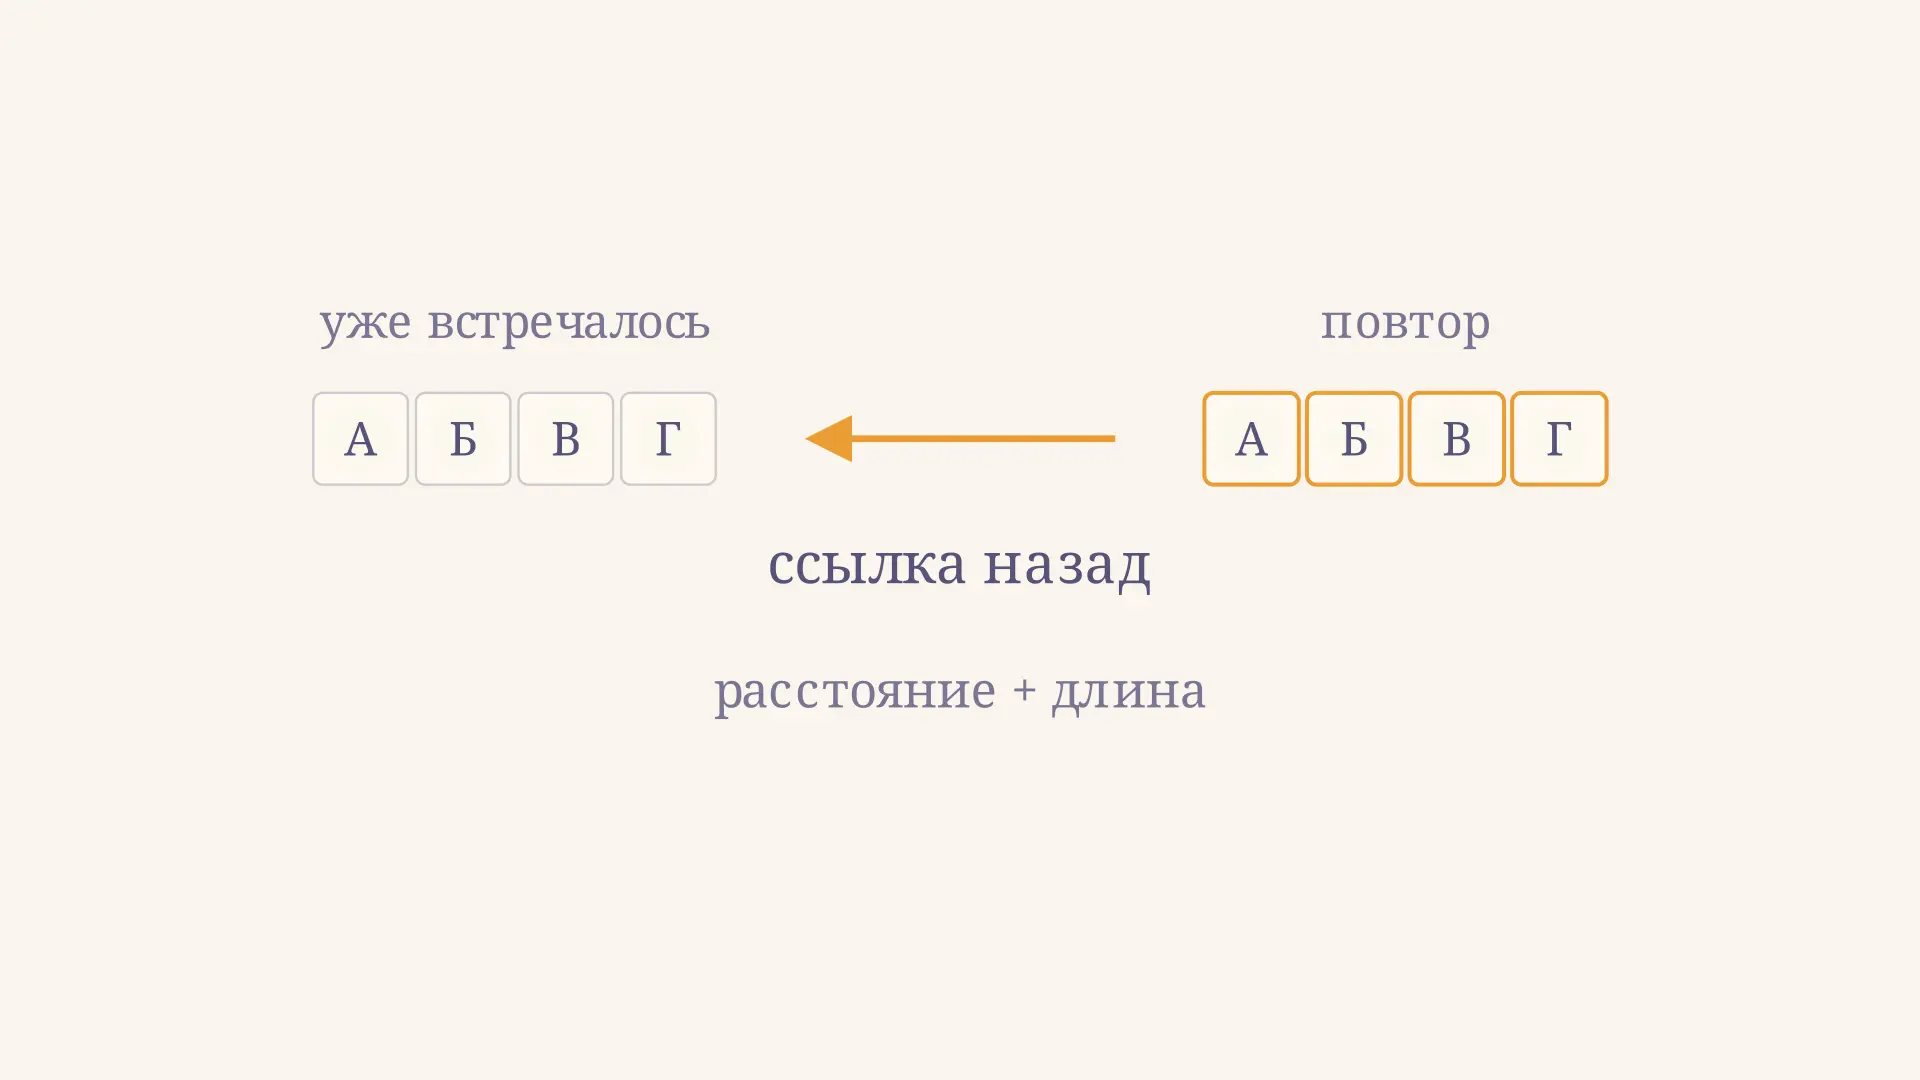
Алгоритм LZ77: сжатие с помощью ссылок назад
Алгоритм LZ77 на пошаговом примере: как скользящее окно находит повторы, что означают расстояние и длина, как работает перекрытие и от чего зависит размер результата.
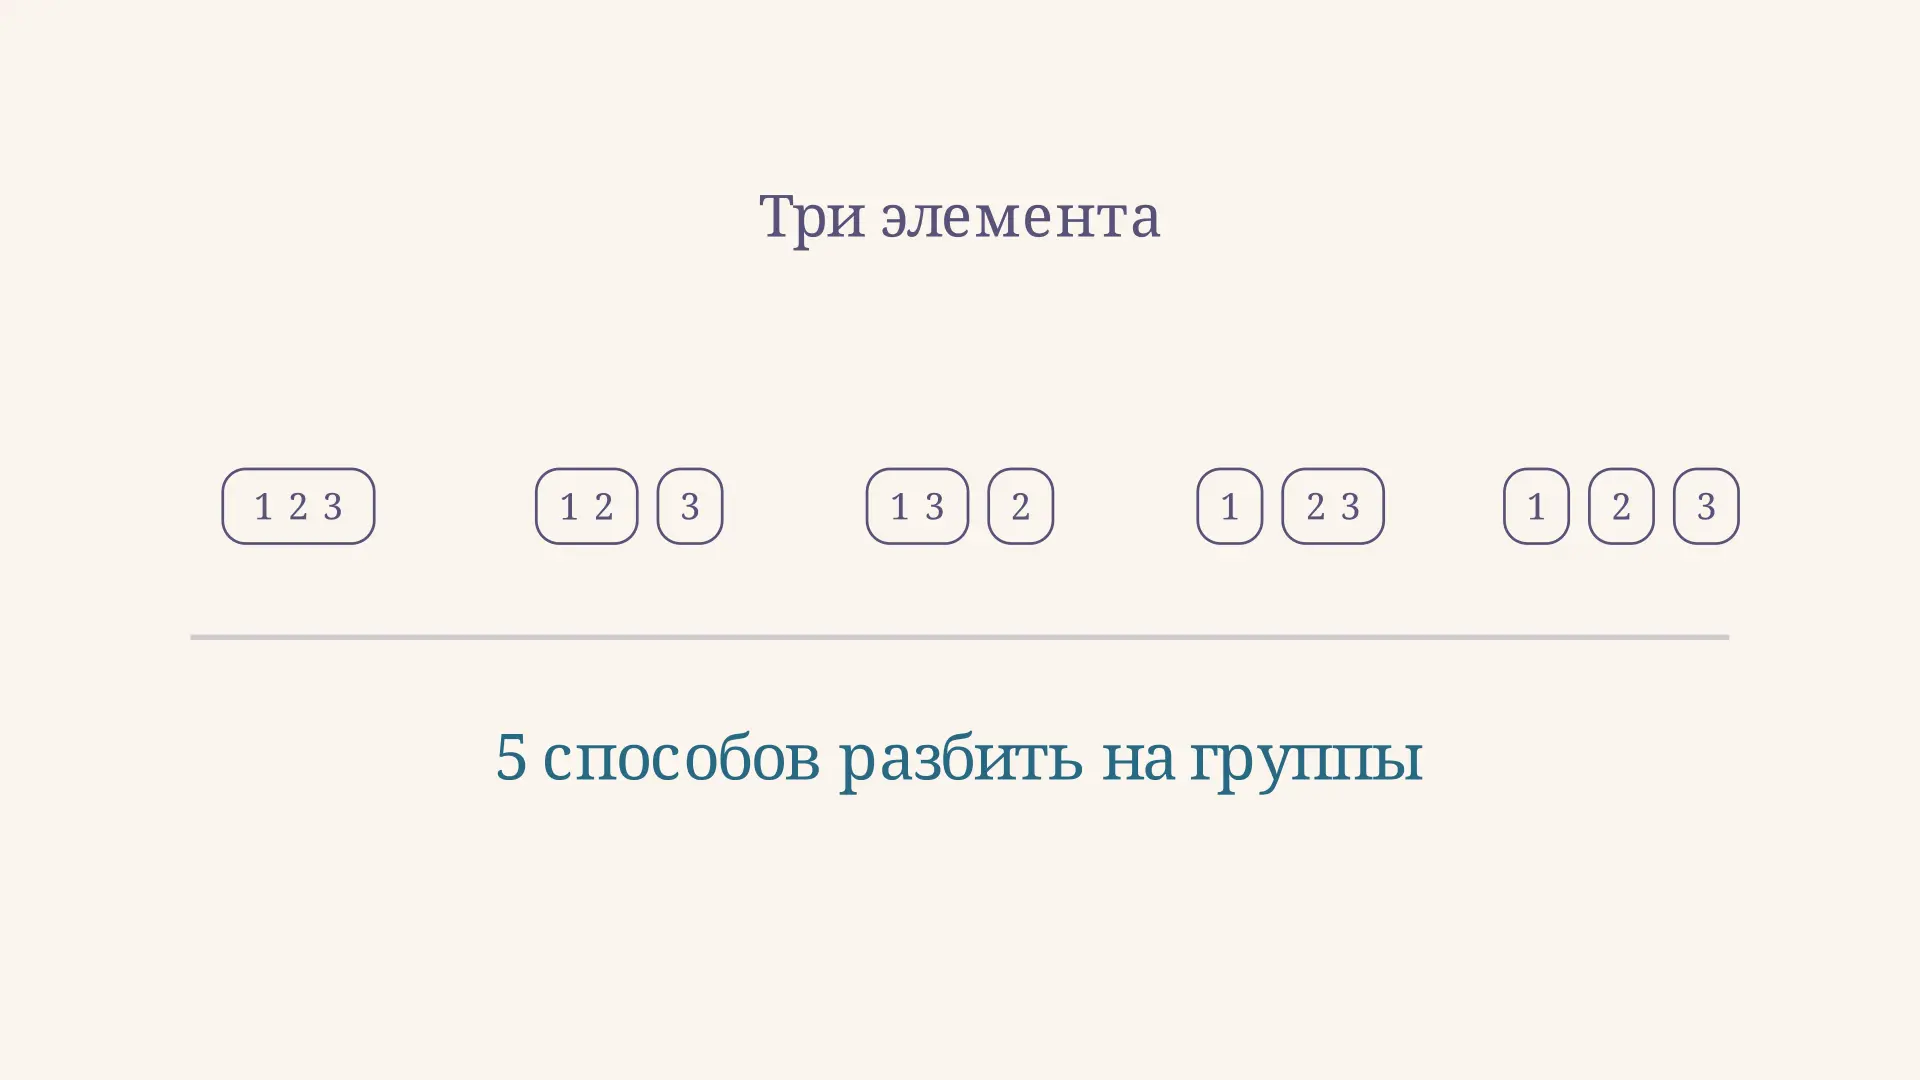
Числа Белла: разбиения множества и формула
Числа Белла считают разбиения множества на непустые группы. Разбираем подробные примеры, рекуррентную формулу, связь с числами Стирлинга и алгоритм вычисления.
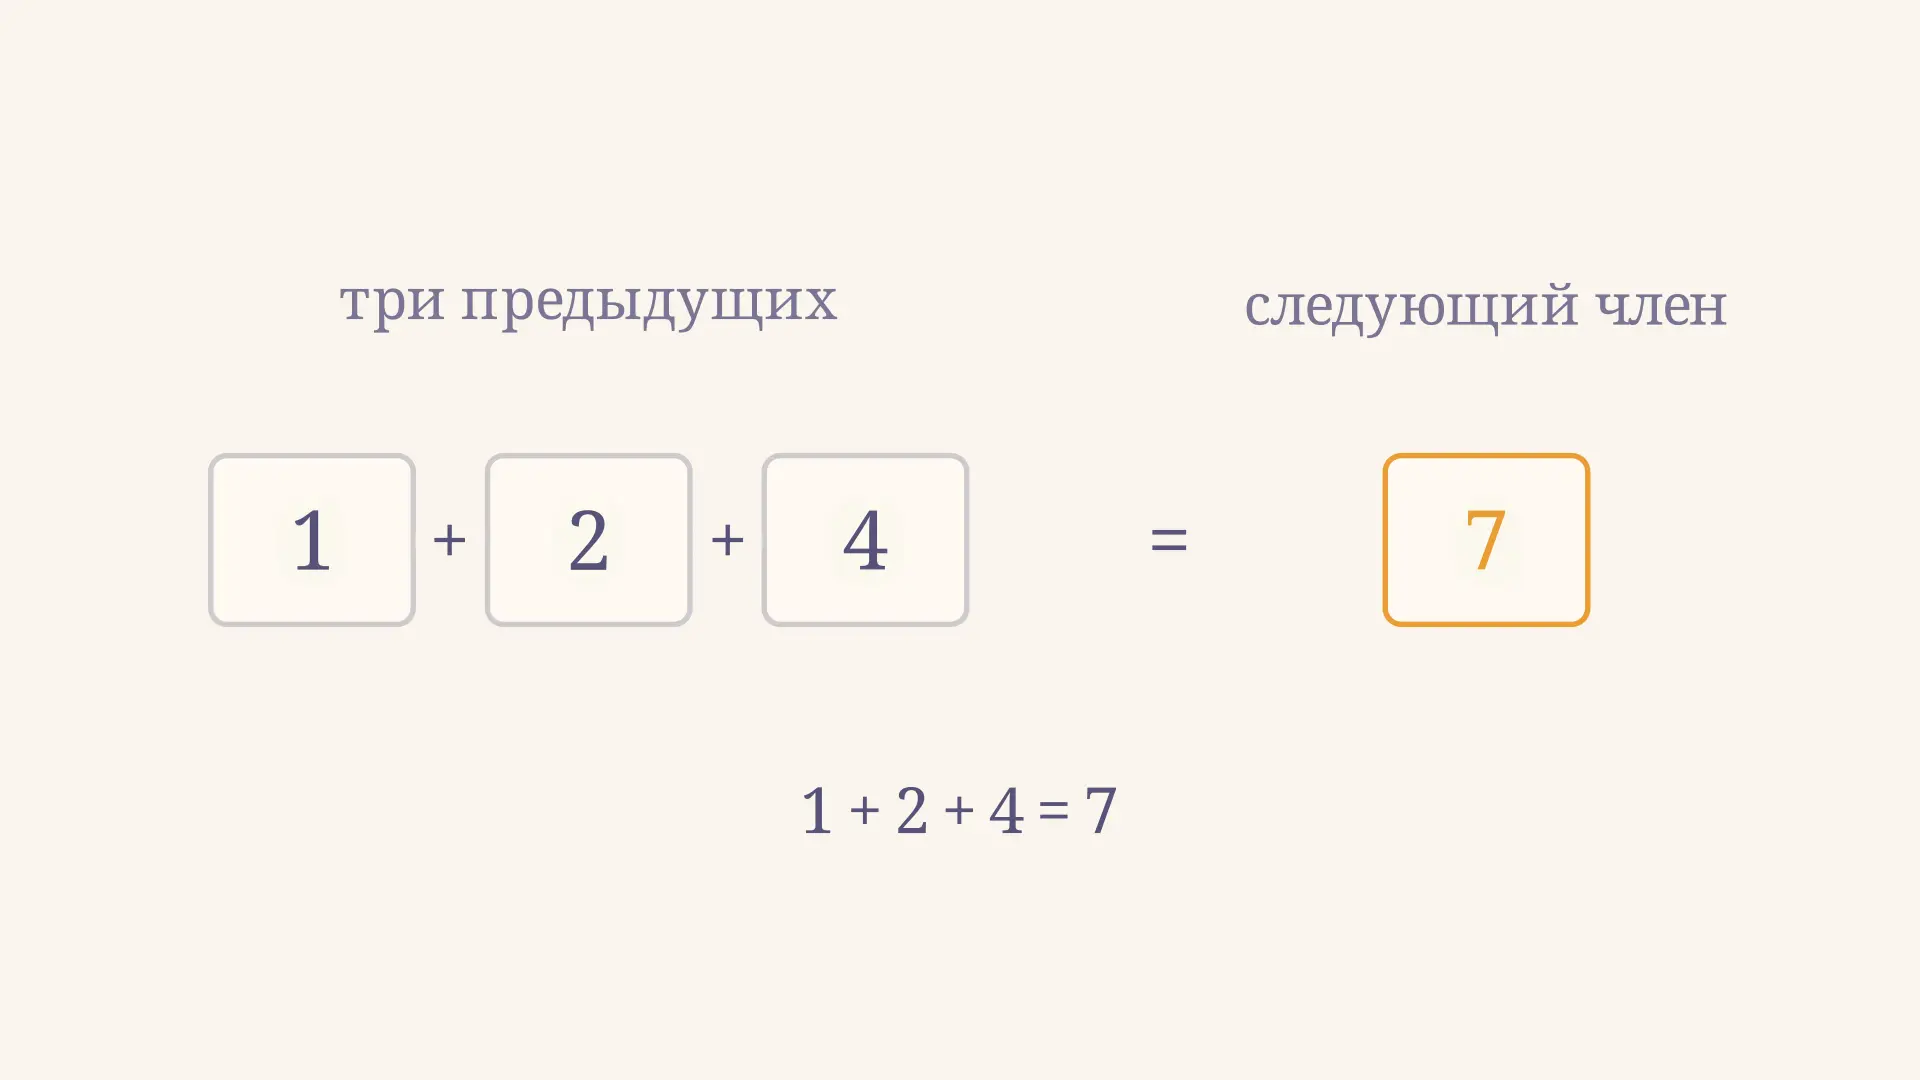
Числа трибоначчи: формула и примеры вычисления
Числа трибоначчи: три начальных значения, рекуррентная формула и расчёт по шагам. Как последовательность считает пути по ступенькам и как написать эффективный алгоритм.
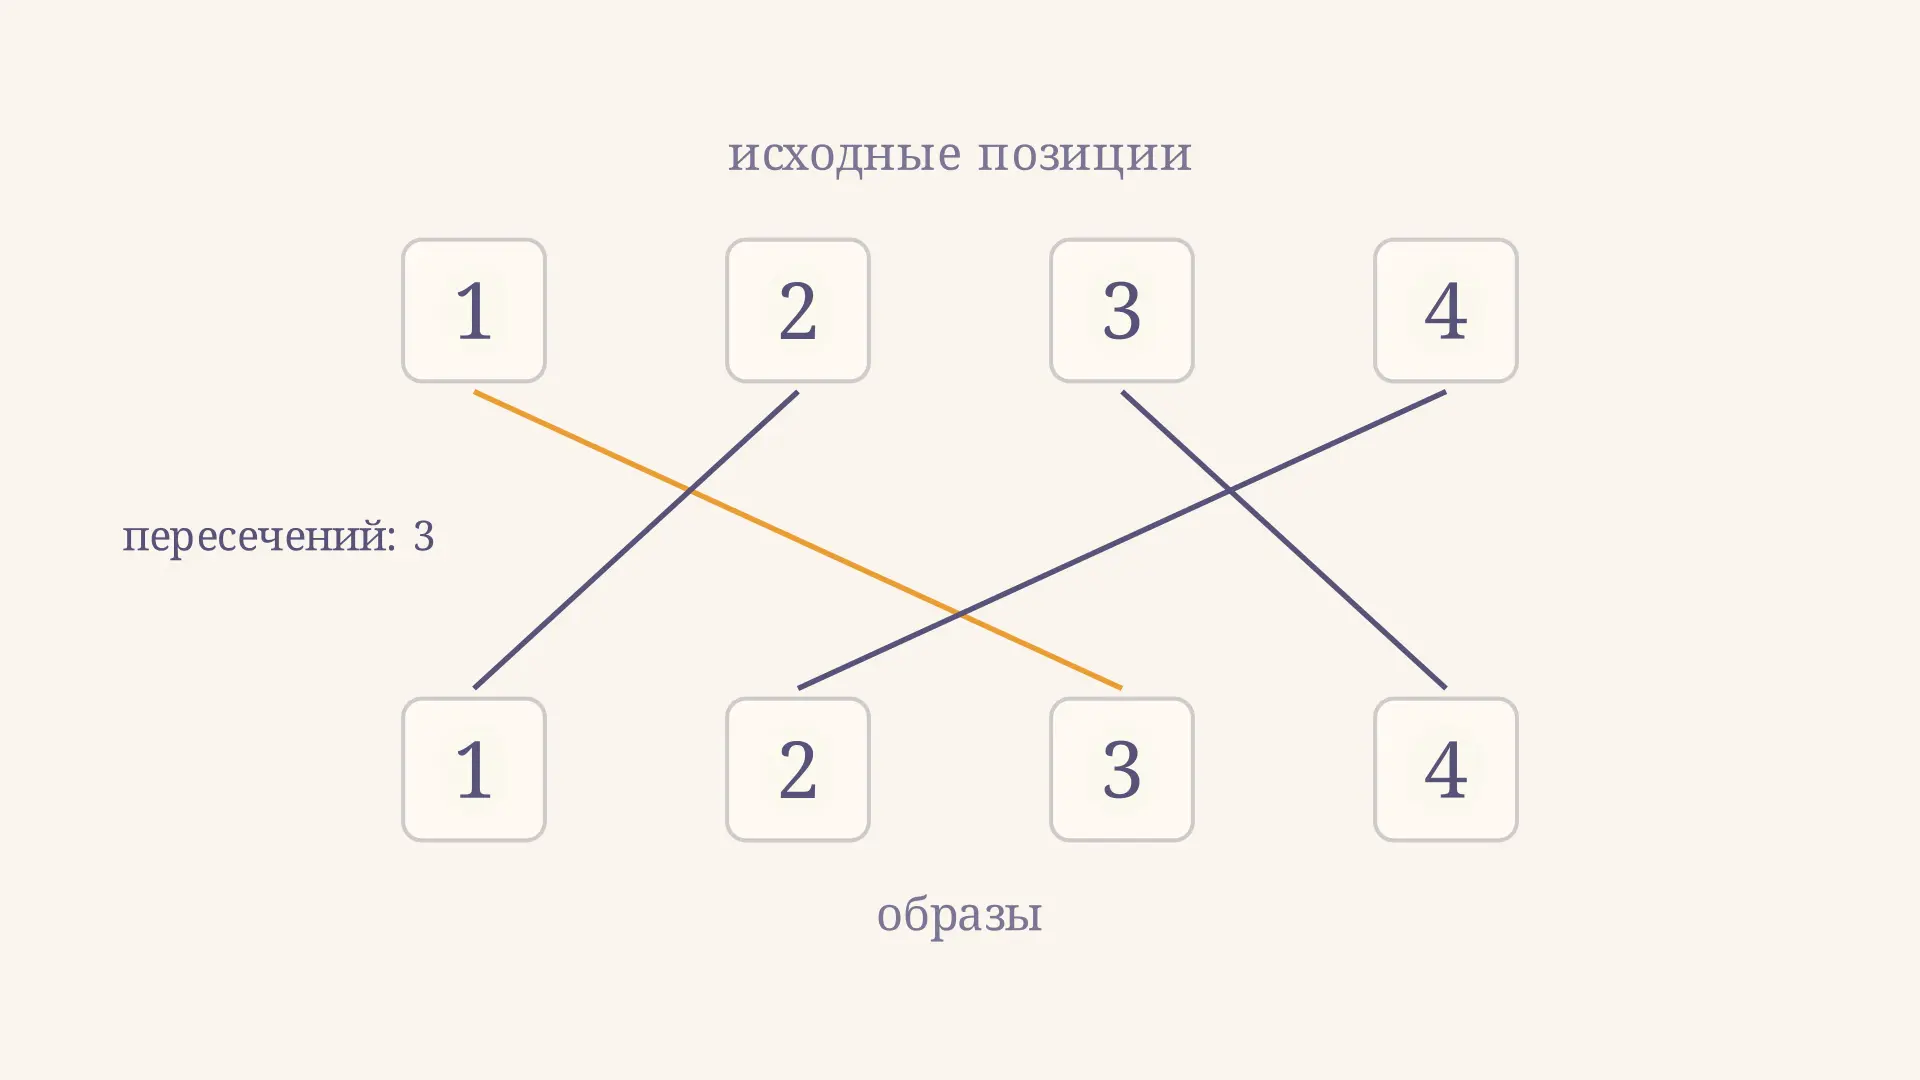
Чётность подстановки: инверсии и знак
Чётность подстановки через инверсии, транспозиции и циклы: пошаговый подсчёт, доказательство независимости разложения и применение в алгоритмах и определителях.