Метод параллельных рядов в статистике: пример
Метод параллельных рядов помогает предварительно увидеть связь двух признаков: значения одного располагают по порядку, а рядом записывают соответствующие значения другого для тех же объектов. Например, можно сопоставить часы обучения работников и выпуск на разных предприятиях. Главное здесь - не потерять пары при сортировке. Ниже разберём учебную таблицу, направление связи и пределы вывода. В интерактиве измените выпуск одного предприятия и посмотрите, как отдельное отклонение меняет общую картину.
Что показывают параллельные ряды
В экономической статистике исследователя часто интересует, как различия одного показателя связаны с различиями другого. Факторным условно называют признак, по которому упорядочивают наблюдения; результативным - показатель, изменения которого рассматривают рядом с ним. Это роли в анализе, а не заранее доказанные причина и следствие.
Каждому предприятию, человеку или региону отвечает пара чисел. Первую последовательность располагают по возрастанию или убыванию, а вторую переставляют вместе с первой. В результате легко проследить, имеют ли большие значения одного признака тенденцию сопровождаться большими или меньшими значениями другого. Метод удобен для первого просмотра небольшой совокупности; так его описывают и в учебнике по статистике Нижегородского университета.
В математическом анализе словом «ряд» называют сумму последовательности. Здесь же речь о двух последовательностях статистических наблюдений. Их не суммируют как бесконечный ряд и не проверяют на сходимость.
Пример: обучение и выпуск
Рассмотрим пять условных предприятий за один и тот же период. Пусть фактор - часы обучения на работника, а результат - средний выпуск в условных единицах на работника за смену. Данные придуманы для упражнения, они не описывают реальную выборку и не оценивают отдачу от обучения.
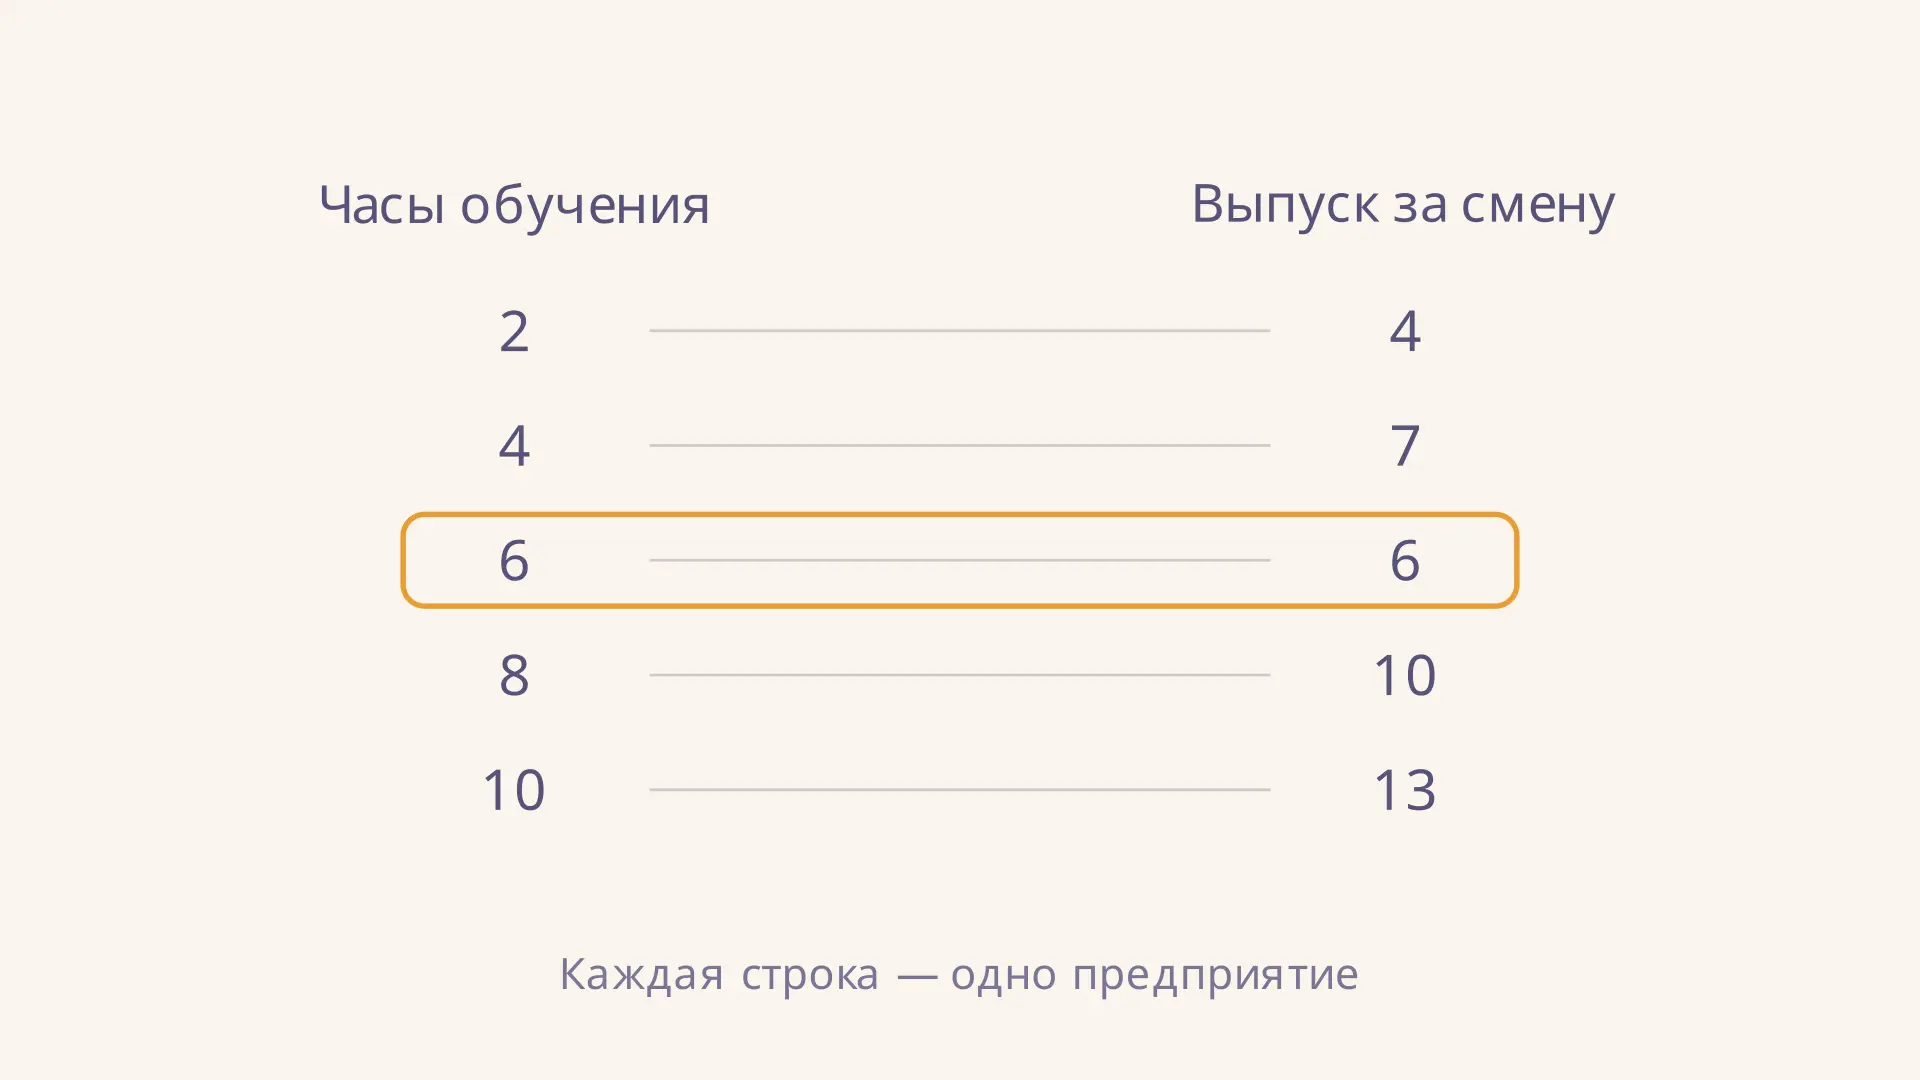
| Предприятие | Обучение, часов на работника | Выпуск, единиц на работника за смену |
|---|---|---|
| А | 2 | 4 |
| Б | 4 | 7 |
| В | 6 | 6 |
| Г | 8 | 10 |
| Д | 10 | 13 |
Первый ряд уже упорядочен: . Параллельный ему ряд выпуска - . В целом большие значения часов здесь сопровождаются большим выпуском: от первой строки к последней показатель повышается с 4 до 13. Но закономерность не строгая: при переходе от предприятия Б к В часы увеличиваются, а выпуск снижается с 7 до 6. Это наблюдение нужно сохранить, а не исправлять ради красивого тренда.
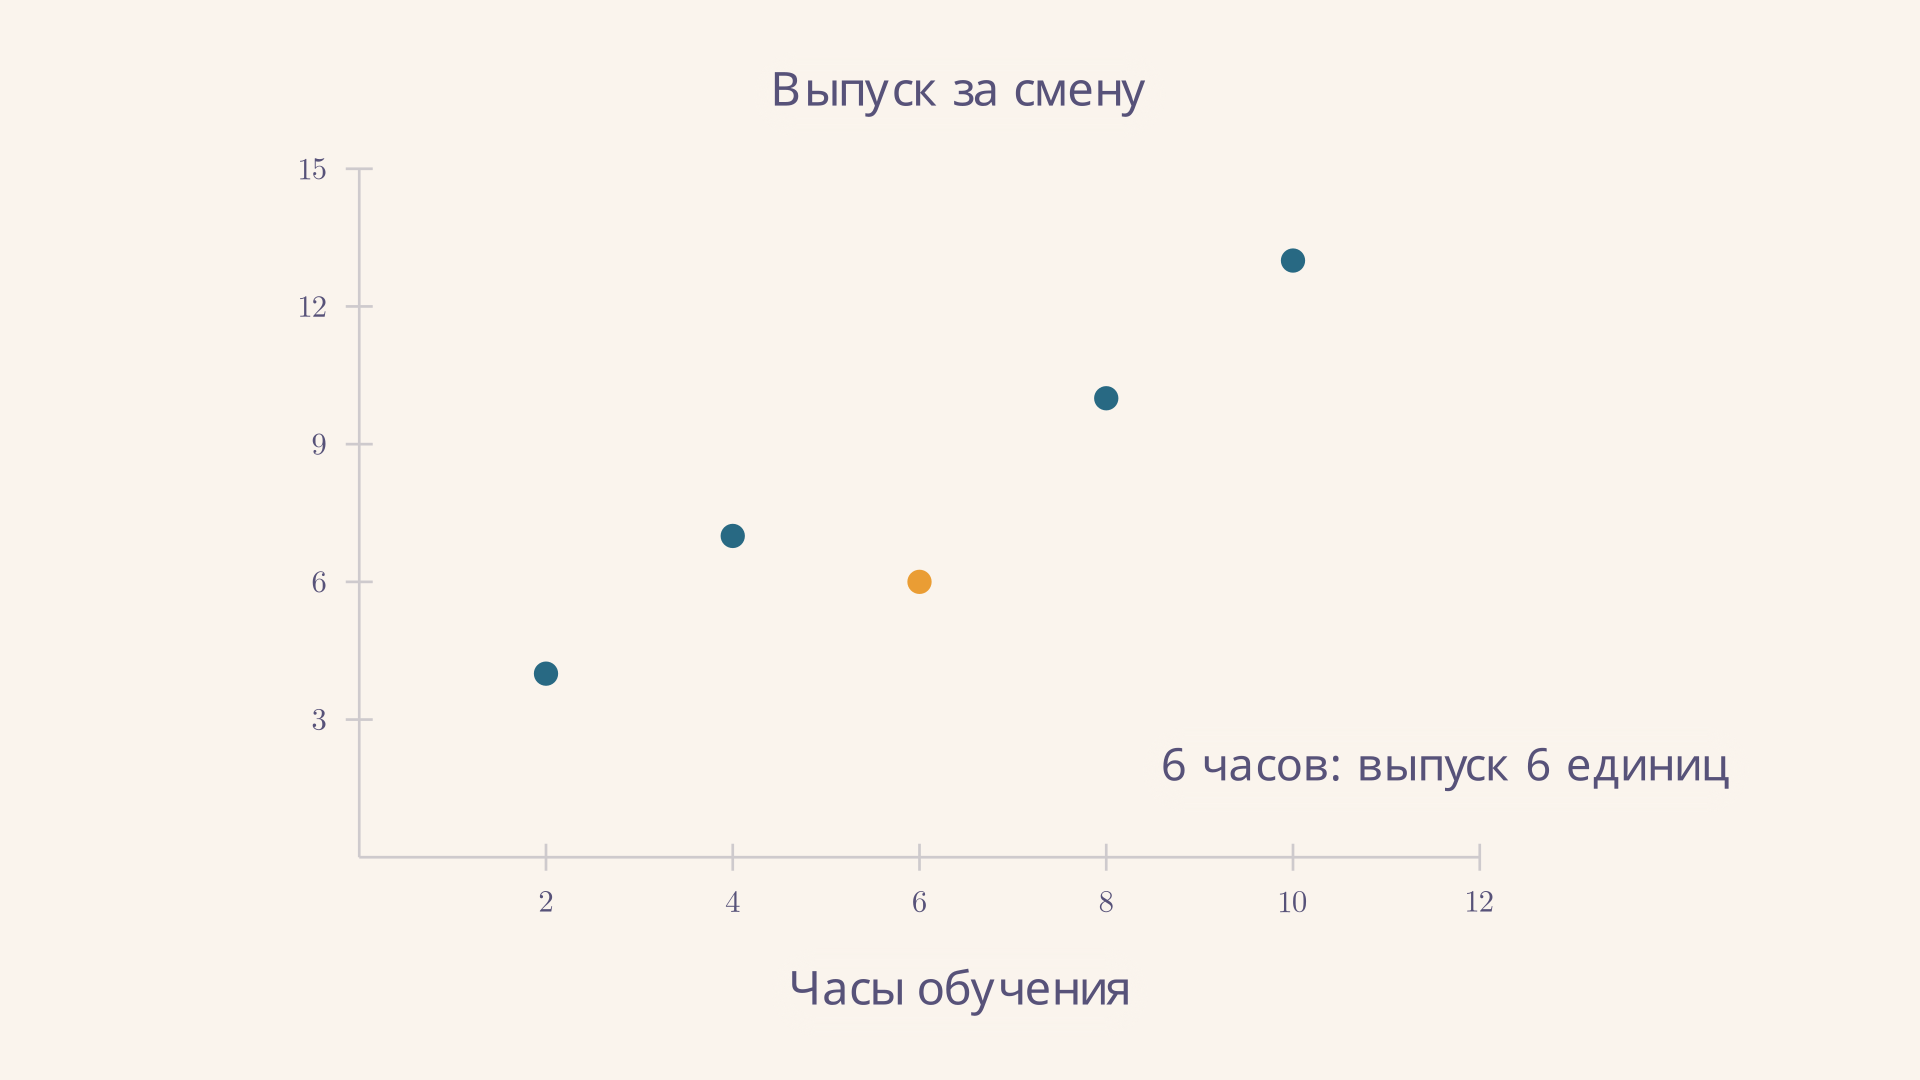
На диаграмме каждая точка - одна пара. Выделенная точка показывает локальное отклонение от роста между соседними строками. Она не отменяет общий рисунок, но напоминает, что связь статистическая и при одинаковой учебной постановке другие обстоятельства могут различаться.
Как построить ряды по исходной таблице
Начните с единицы наблюдения: одна строка должна означать одно предприятие за определённый период. Уточните единицы измерения и убедитесь, что сравниваемые показатели относятся к сопоставимым объектам и времени. Например, общий выпуск крупных и малых предприятий нельзя безоговорочно сравнивать как производительность работника.
Затем выберите признак для сортировки. Если в исходной таблице предприятия записаны в порядке Д, Б, А, Г, В, отсортируйте всю строку по часам. Получится порядок А, Б, В, Г, Д, а соответствующие значения выпуска переместятся вместе с названиями предприятий. При равных значениях часов порядок внутри такой группы не определяет направление связи; полезно отдельно посмотреть разброс выпуска в группе.
Наконец, прочитайте второй ряд слева направо. Отметьте общую тенденцию, возможные перегибы, повторы и отклонения. Сформулируйте вывод словами «наблюдается тенденция» или «данные допускают гипотезу», указав число объектов и условия примера. Если исходных наблюдений много, длинный список труднее читать: тогда пригодится группировка статистических данных, но важно не скрыть разброс внутри групп.
Для самостоятельной проверки можно временно закрыть названия предприятий и попытаться восстановить их после сортировки. Для каждой строки должно сохраниться исходное сочетание часов и выпуска. Если вместо пары предприятия Б появляется сочетание четырёх часов и шести единиц, при перестановке потерялась связь между столбцами. Проверка особенно полезна при копировании таблицы в электронные таблицы: диапазон сортировки должен охватывать идентификатор и оба показателя.
Отдельно проверьте пропущенные значения. Если часы известны, а выпуск отсутствует, дополнять его соседним числом нельзя: это создало бы искусственную пару. Такую строку сохраняют в исходных данных, обозначают пропуск и сообщают, сколько полных пар осталось для сопоставления. Причины пропусков тоже могут влиять на результат, например когда показатели не представили именно предприятия с низким выпуском.
Прямая, обратная и неясная связь
При прямой связи большим значениям первого признака обычно соответствуют большие значения второго. Наш учебный пример указывает на такую тенденцию, хотя одна соседняя пара идёт против неё. Строгого увеличения в каждой строке для предварительного вывода о тенденции не требуется.
При обратной связи большие значения первого признака обычно сочетаются с меньшими значениями второго. Например, если для сопоставимых товаров цены возрастают, а продажи в выбранный период обычно снижаются, таблица может навести на гипотезу об обратной связи. Различия качества товаров, рекламных расходов и состава покупателей при этом остаются возможными объяснениями.
Если второй ряд меняется без заметной последовательности, из таблицы может быть трудно сделать направленный вывод. Это не доказывает полного отсутствия зависимости: наблюдений мало, связь может быть нелинейной или проявляться только внутри сопоставимых групп. И наоборот, видимый порядок в малой выборке может возникнуть случайно.
Как проверить предварительный вывод
Параллельные ряды прежде всего показывают данные. Для дальнейшего анализа полезно построить диаграмму рассеяния: она позволяет увидеть форму облака, необычные точки и группы, которые трудно заметить в длинной таблице. Не соединяйте точки линией как временной ряд, если порядок обозначает только сортировку объектов: промежуточные точки на линии не являются новыми предприятиями.
Для численной характеристики линейной связи можно изучить выборочный коэффициент корреляции. Для монотонной связи и порядка наблюдений применяют ранговую корреляцию Спирмена, учитывая особенности связанных рангов. Каждый коэффициент отвечает на свой вопрос: один показатель не заменяет просмотр исходных данных и проверку формы зависимости.
Если задача состоит в оценке связи с несколькими факторами одновременно, можно обратиться к множественной регрессии. Её результат тоже зависит от модели, качества измерений и состава наблюдений. Особенно осторожно следует интерпретировать малые выборки, выбросы и взаимосвязанные факторы: формальная точность вычисления не гарантирует надёжности экономического вывода.
Почему совпадение не доказывает причину
Предприятия с большим обучением могут одновременно иметь более современное оборудование, опытных сотрудников или другую структуру продукции. Эти обстоятельства способны влиять и на обучение, и на выпуск. Возможна и обратная последовательность: успешное предприятие направляет часть дохода на обучение. Таблица сама по себе не различает такие объяснения.
Для причинного вопроса нужен дизайн исследования: например, обоснованное сравнение сопоставимых групп или эксперимент, если он возможен. Даже в таком исследовании заранее определяют результат, период и способ учёта пропущенных наблюдений. Параллельные ряды полезны как начало этой работы: они помогают заметить вопрос и проверить, правильно ли собраны пары.
Частые ошибки
- Сортировать два столбца отдельно. Тогда значения оказываются рядом случайно и исходные пары исчезают; почти любой результат такого сопоставления бессмыслен.
- Объявлять фактор причиной. Название столбца показывает роль в анализе, но не исключает обратную связь или влияние третьего признака.
- Игнорировать отклонения. Спад выпуска с 7 до 6 в примере - часть данных; его стоит проверить, а не удалять без основания.
- Смешивать несопоставимые величины. Периоды, единицы измерения и состав объектов должны позволять осмысленное сравнение.
- Считать визуальную тенденцию точной мерой силы связи. Для количественного анализа нужны отдельные показатели и оценка их применимости.
FAQ
Обязательно ли оба ряда должны возрастать?
Нет. Первый упорядочивают для удобства, а второй сохраняет фактический порядок соответствующих значений. Он может расти, убывать или колебаться.
Можно ли использовать метод для временных данных?
Да, показатели можно сопоставлять по одним и тем же датам. Но общий тренд и запаздывание способны создать обманчивую картину, поэтому хронологический анализ требует дополнительных проверок.
Что делать, если значения фактора совпадают?
Сохранять все пары и рассматривать объекты с одинаковым значением вместе. Различия результата внутри такой группы показывают разброс, который один фактор не объясняет.
Коротко
Метод параллельных рядов упорядочивает наблюдения по одному признаку и показывает соответствующие значения другого. Он помогает увидеть возможное направление связи и отклонения на конкретных объектах. Результат - предварительная гипотеза: для измерения связи, оценки неопределённости и причинных выводов нужны дополнительные методы и данные.
Читайте также
Аналитическое выравнивание ряда по прямой: пример
Как выровнять динамический ряд по прямой методом наименьших квадратов: кодировка времени, расчёт коэффициентов, таблица уровней, проверка остатков и пример прогноза на следующий период.
Бесповторный отбор: формулы и пример расчёта
Бесповторный отбор в статистике: как меняются вероятности, рассчитать состав случайной выборки и учесть конечную совокупность на примере контроля партии.
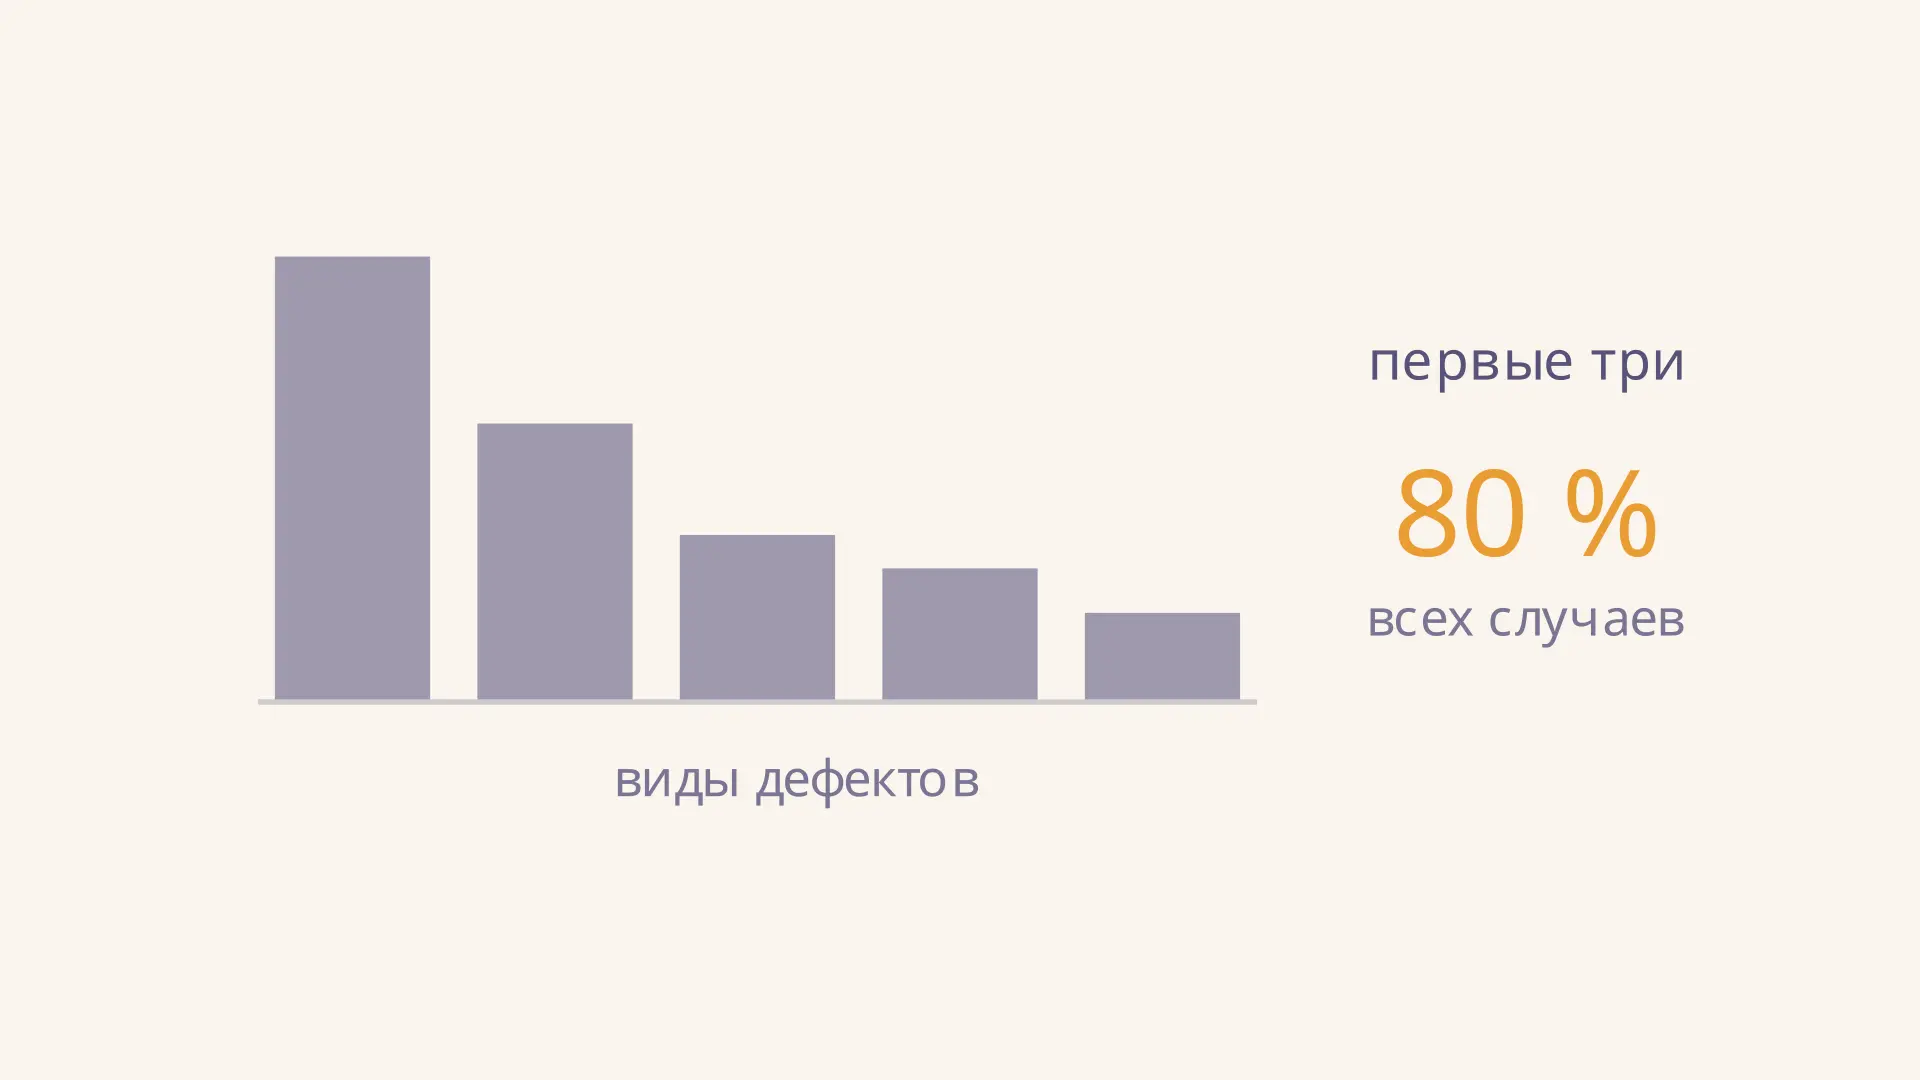
Диаграмма Парето в контроле качества: пример расчёта
Диаграмма Парето в контроле качества: как собрать данные о дефектах, рассчитать накопленные проценты, построить график и выбрать приоритет улучшения на наглядном примере.
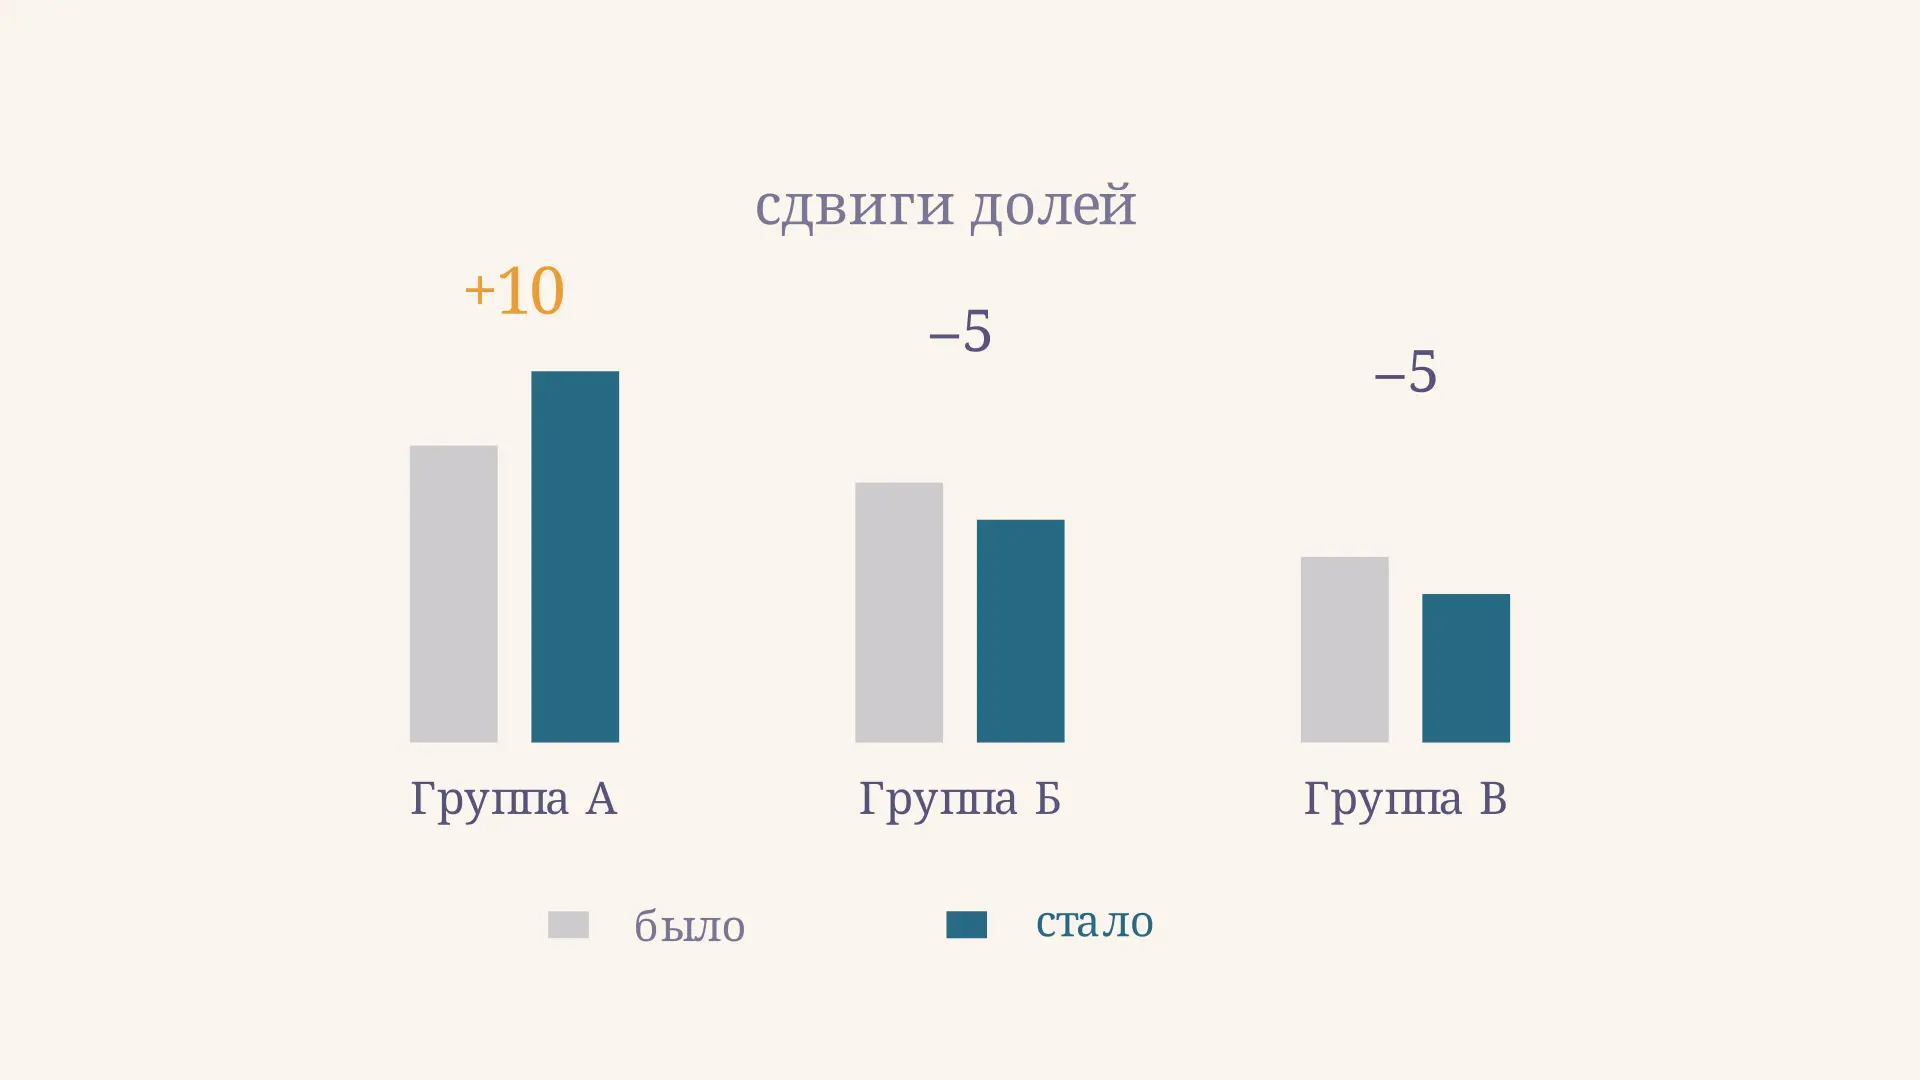
Индекс Казинца: формула и расчёт структурных сдвигов
Индекс Казинца показывает среднеквадратическое изменение долей. Разбираем формулу, расчёт по шагам, процентные пункты и ограничения сравнения структур.
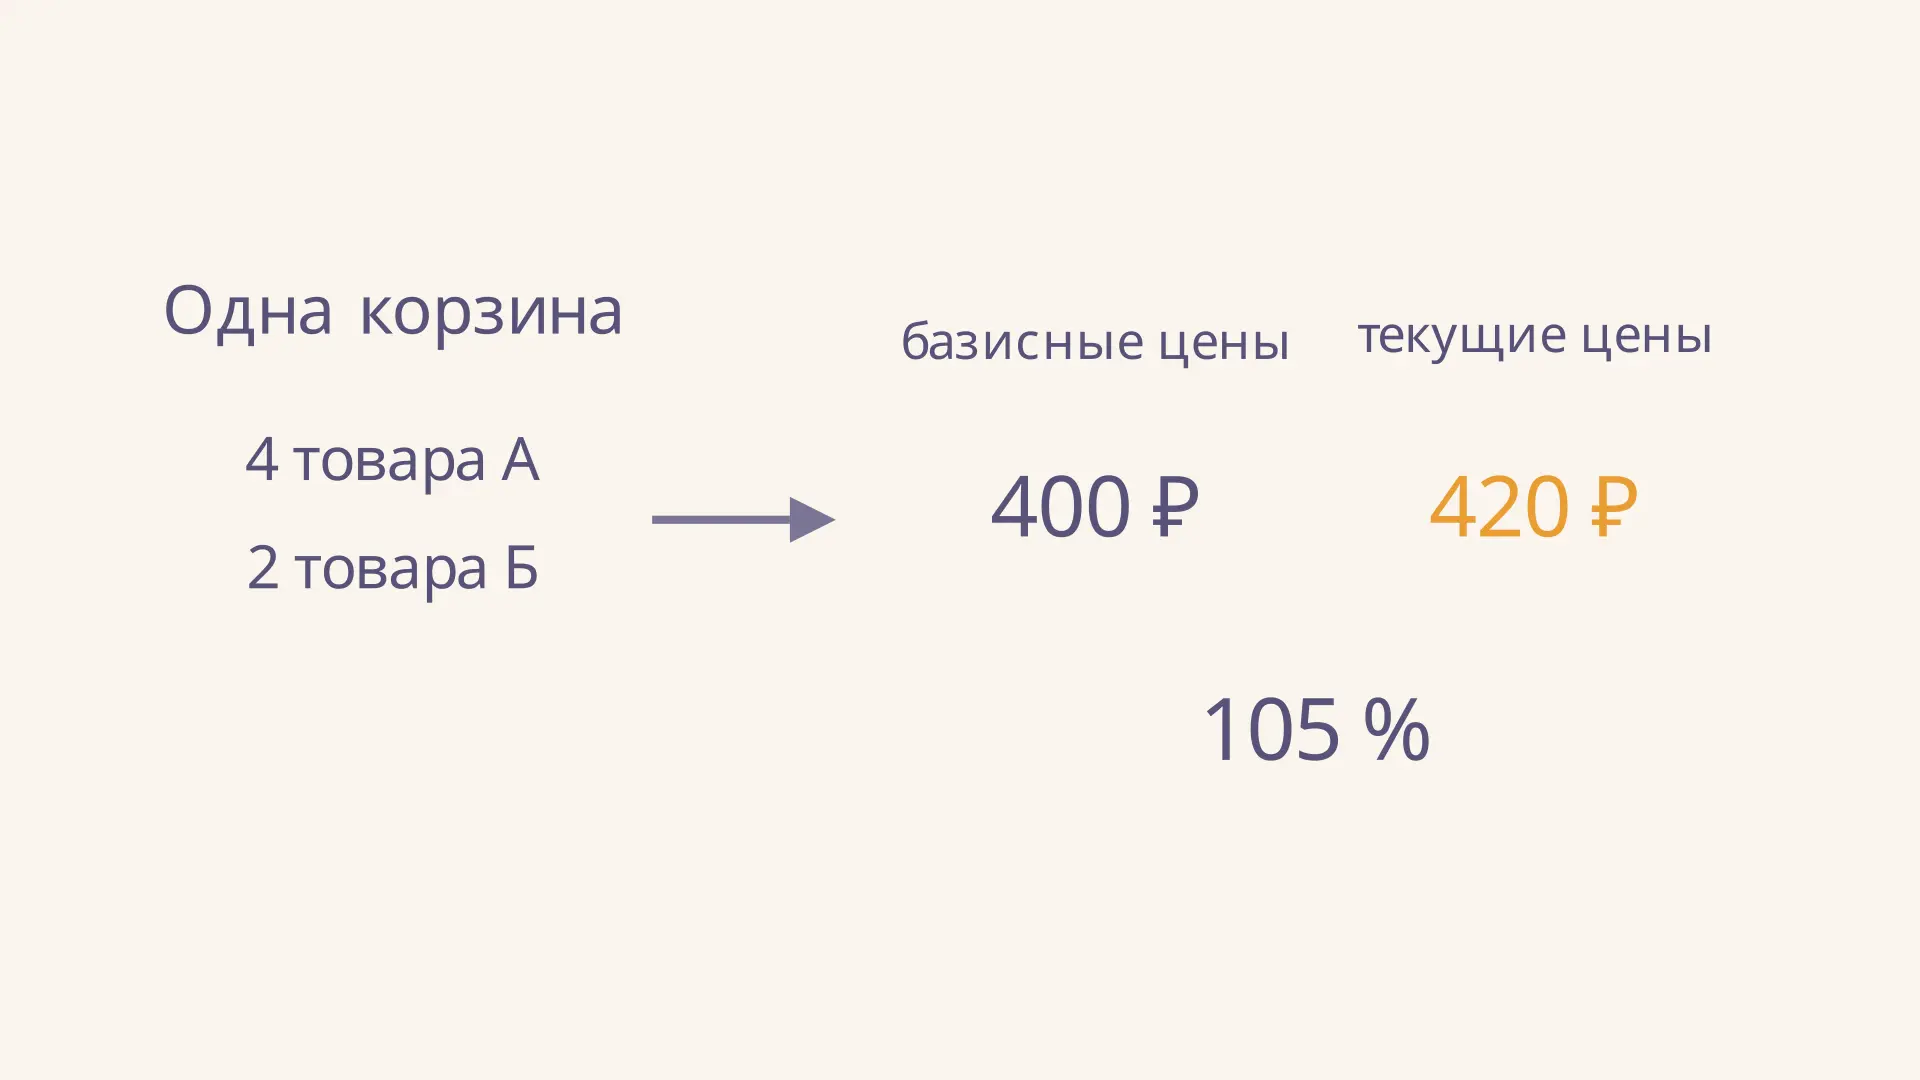
Индекс Лоу: формула, веса и пример расчёта
Индекс Лоу показывает изменение стоимости фиксированной корзины. Разбираем формулу, периоды цен и весов, обновление долей расходов и расчёт на примере.
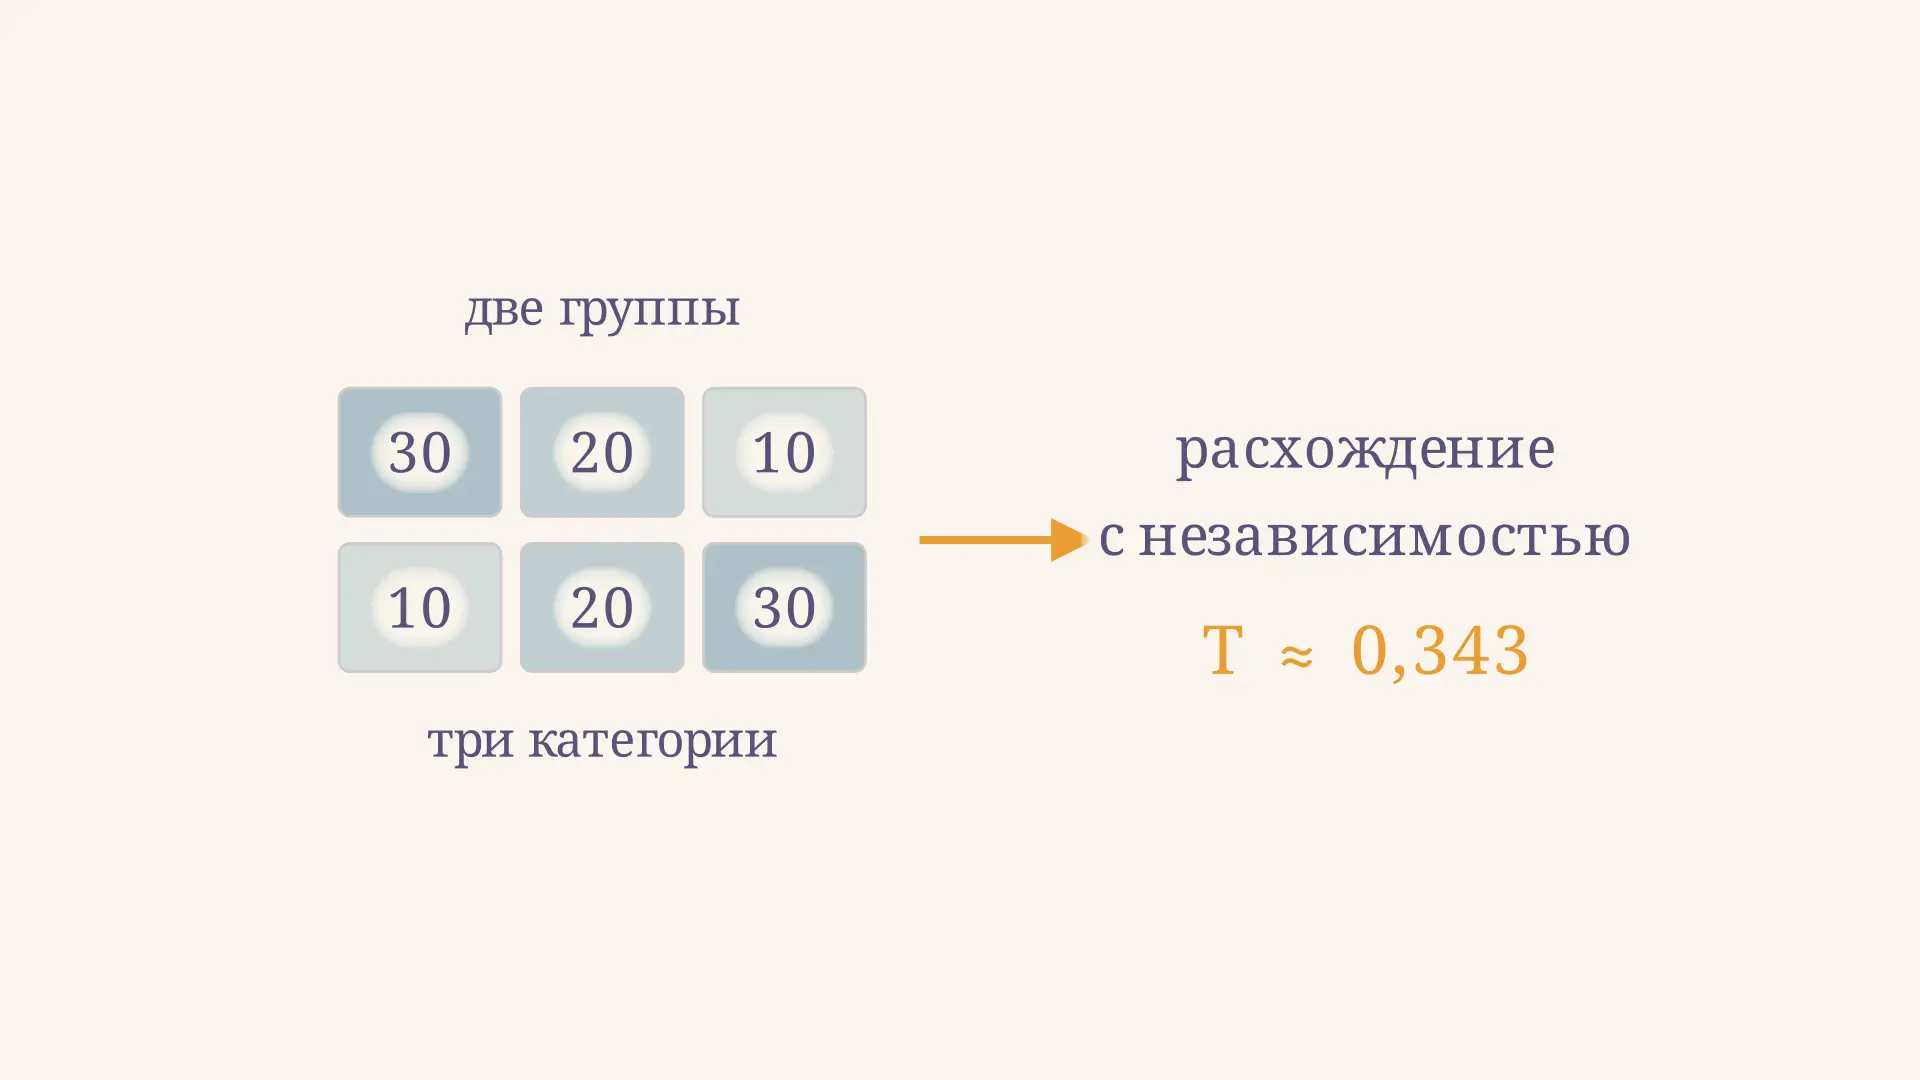
Коэффициент Чупрова: формула и пример расчёта
Как рассчитать коэффициент Чупрова по таблице сопряжённости: ожидаемые частоты, хи-квадрат, пример для экономики, интерпретация результата и ограничения прямоугольных таблиц.