Лексикографический порядок: сравнение строк и кортежей
Лексикографический порядок - способ сравнивать последовательности поэлементно слева направо. Первое различие решает исход: если в нём элемент первой последовательности меньше, то и вся первая последовательность меньше. Так сравнивают строки, кортежи и перестановки. Но сначала нужно договориться, как упорядочены сами элементы: порядок букв алфавита и порядок числовых кодов символов могут расходиться. Выберите пару в инструменте и проследите, какая позиция определит результат.
Правило первого различия
Пусть есть две конечные последовательности и , а их элементы можно сравнивать. Идём по позициям от первой. Пока элементы равны, переходим дальше. Если впервые встретили , то знак сравнения последовательностей совпадает со знаком сравнения и . Всё, что стоит правее, уже не влияет на ответ.
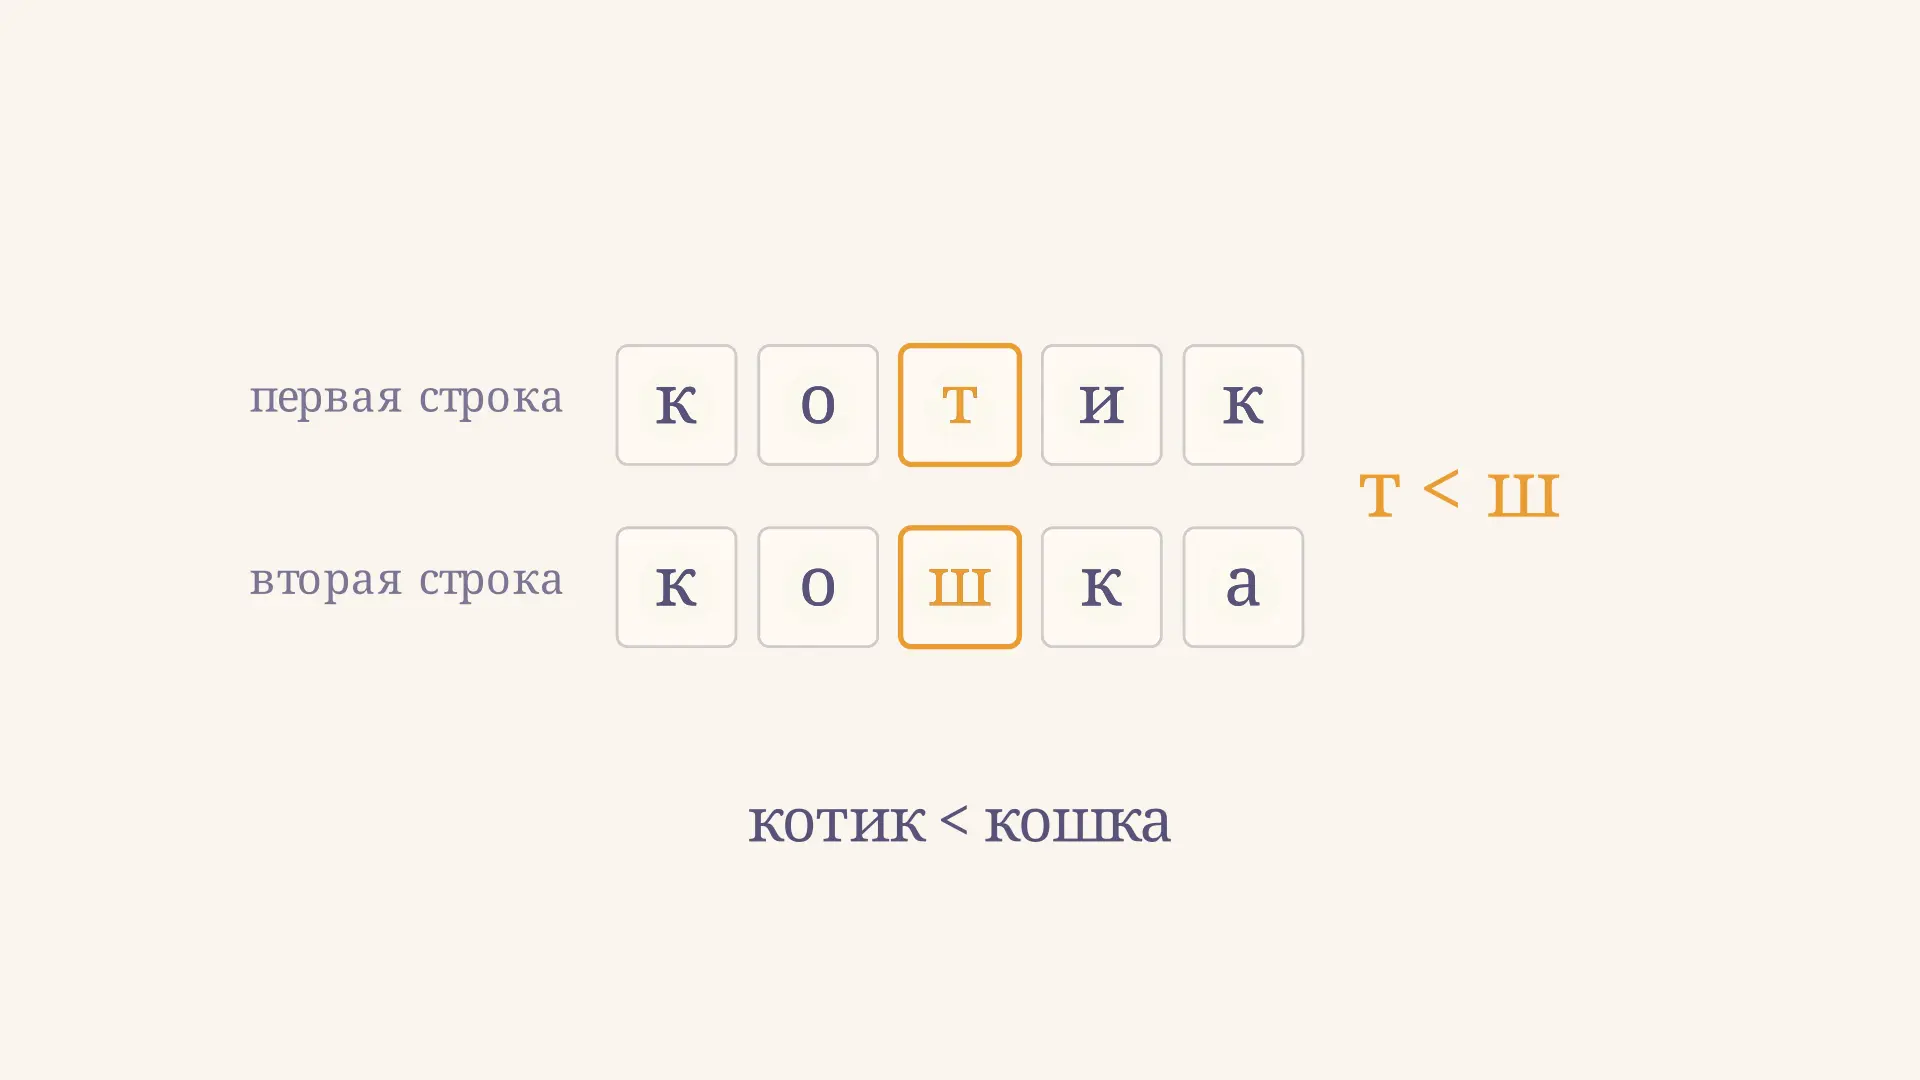
Сравним «котик» и «кошка» по порядку строчных русских букв. Первые буквы «к» совпадают, вторые «о» тоже. На третьем месте стоит «т» против «ш»; поскольку «т» раньше «ш», получаем «котик» < «кошка». Последующие буквы можно не проверять. В примере результат совпадает и с порядком кодовых точек Unicode, который использует инструмент.
Это похоже на поиск слова в словаре, но математическое правило применимо шире слов: элементами могут быть числа, символы или даже другие последовательности. Важно лишь заранее задать их порядок. Например, для чисел используется обычное сравнение, а для текста выбор зависит от задачи и программной среды.
Если одна последовательность является началом другой
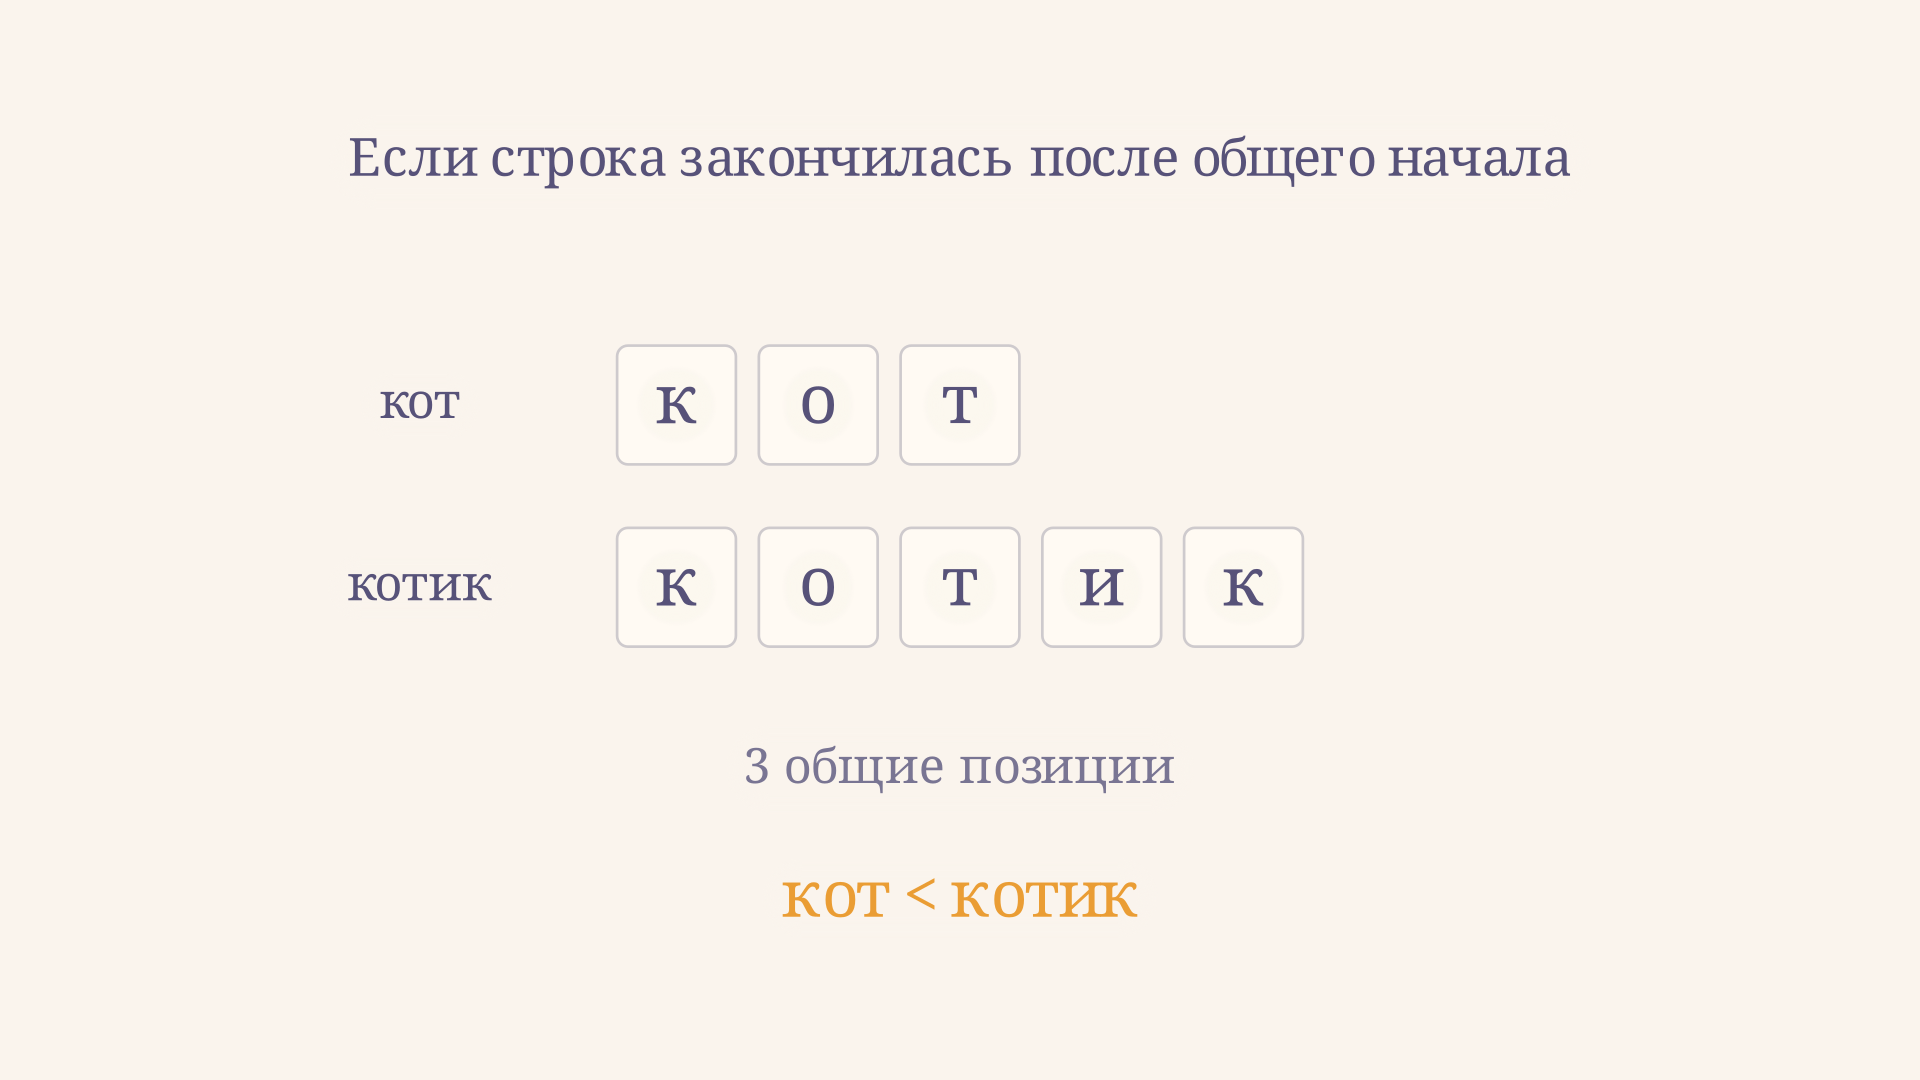
Что делать, если первое различие не встретилось, а одна из строк уже закончилась? Тогда она является префиксом другой и считается меньшей. Так, «кот» < «котик»: все три буквы короткой строки совпадают с началом длинной, после чего короткая строка заканчивается. Пустая строка является префиксом любой строки и меньше любой непустой. Если обе строки закончились одновременно после совпадения всех элементов, они равны.
Заметьте порядок проверок: правило длины применяется только после совпадения общего начала. Нельзя утверждать, что любая короткая строка меньше любой длинной. Например, «я» больше «абрикос»: результат уже определён первыми буквами, и длина не играет роли.
Сравнение кортежей и числовых записей
Для кортежей правило то же, но сравнивают значения компонентов. Упорядочим , и . Первый компонент меньше , поэтому идёт первым. Для двух оставшихся первые компоненты равны; второй компонент , значит итоговый порядок: . Приоритет первого компонента можно понимать как сортировку по нескольким ключам: сначала по первому полю, при равенстве - по второму.
Ключи не обязаны иметь одинаковое направление. Если результаты участников нужно расположить по убыванию балла, а при равенстве по возрастанию номера, сравнение первого поля должно быть обратным. Это уже порядок по специально выбранному составному ключу; его правила стоит записать до сортировки. Сам алгоритм сортировки, например пирамидальная сортировка, затем использует заданный компаратор для сравнения элементов.
Числа и их текстовые записи тоже различаются. Как числа , но как строки «10» < «2»: первый символ «1» меньше символа «2». Если в таблице номера хранятся текстом, сортировка может дать именно такой результат. Для числового порядка преобразуйте корректные записи в числа или задайте подходящий ключ; добавление ведущих нулей тоже работает для ограниченного диапазона с фиксированной шириной, но меняет представление данных.
Как это устроено в программах
В Python строки сравниваются лексикографически по числовым значениям кодовых точек Unicode; последовательности одного типа, например кортежи чисел, также сравниваются поэлементно. Это описано в документации Python. Например:
'котик' < 'кошка'  # True
'кот' < 'котик'    # True
'10' < '2'         # True
(2, 1) < (2, 4)    # True
Индекс первого различия в программе часто считают с нуля: для «котик» и «кошка» это индекс 2, хотя в обычном счёте позиция третья. Сравнение останавливается на первом различии или после просмотра общего префикса. Если длины строк равны и , в худшем случае нужно проверить до пар элементов и затем учесть длины: сложность одного сравнения - . При сортировке многих строк стоимость зависит и от числа сравнений, и от длины общих префиксов.
Сравнение строк полезно отличать от поиска образца внутри текста. Алгоритм поиска может проверять совпадения в разных положениях; например, алгоритм Кнута - Морриса - Пратта использует информацию о префиксах, чтобы не возвращаться к уже проверенным символам. Цель такого поиска иная: найти вхождения, а не упорядочить пару строк.
Unicode и алфавитный порядок
Числовой порядок кодовых точек не является универсальным словарным порядком. Например, в Unicode прописная латинская «A» имеет код 65, а строчная «a» - 97, поэтому при прямом сравнении первая меньше второй. Но при сортировке имён пользователю может понадобиться считать регистр второстепенным или учитывать правила конкретного языка. Консорциум Unicode описывает языковую сортировку через веса и настройки, а не простое сравнение кодов.
Даже одинаково выглядящий текст может иметь разное представление: символ с диакритическим знаком иногда записывается одной кодовой точкой, а иногда как базовая буква и отдельный знак. Нормализация помогает привести канонически эквивалентные записи к выбранной форме, но сама по себе не задаёт все языковые правила сортировки. Для пользовательских списков следует выбрать локаль и механизм сопоставления, а для протоколов и ключей хранения - явно зафиксировать точное правило. Иначе сортировка на разных этапах обработки может не совпасть.
Инструмент в начале намеренно показывает ограниченную модель: он сравнивает кодовые точки без нормализации и локальных настроек. Высота столбца - числовой код, а золотой цвет указывает на первую различающуюся позицию. При отношении префикса решает конец строки, поэтому золотого столбца нет.
Следующая перестановка
Лексикографический порядок позволяет перечислять перестановки без пропусков. Например, для элементов последовательность начинается так: . После следующей перестановки в этом порядке нет. Общее число вариантов и смысл перестановки разобраны в статье о сочетаниях и перестановках.
Чтобы получить следующий вариант после , найдите справа первый подъём: . Это опорный элемент. Справа от него выберите самый правый элемент, больший опорного, то есть , и поменяйте их: получится . Затем разверните суффикс после опорной позиции: превращается в , итог - 213. Замена делает последовательность больше, а разворот даёт наименьший возможный хвост после неё. Если подъёма нет, весь массив не возрастает и текущая перестановка последняя. При повторяющихся элементах тот же приём перечисляет различные последовательности значений.
Где ещё применяют порядок
Составные ключи помогают организовать записи: например, сначала по году, затем по номеру документа. Строковые ключи с общим началом удобно группировать при индексировании, если порядок в индексе согласован с порядком запроса. В задачах на строки сравнение суффиксов помогает упорядочить фрагменты одного текста; понимание общих префиксов пригодится и при изучении Z-функции строки.
При разборе задачи полезно сначала выписать пару последовательностей друг под другом и отметить одинаковое начало. Затем подчеркните первую пару разных элементов и укажите, какое исходное правило сравнения применили. Если отличия нет, отдельно запишите, закончились ли обе последовательности одновременно. Такой протокол позволяет проверить ответ и для слов, и для составных числовых ключей, не полагаясь только на интуитивный порядок в списке.
Практический результат зависит от контракта сравнения. Перед реализацией укажите тип элементов, направление по каждому полю, обработку регистра и представления Unicode, а также правило для пустых значений. Для надёжной сортировки компаратор должен задавать согласованный порядок: нельзя, например, считать , и одновременно . Иначе результат сортировки не имеет ясного смысла.
Частые ошибки
- Сравнивать длины до первого различия. «я» больше «абрикос», хотя короче.
- Продолжать сравнение после решающей позиции. В «котик» и «кошка» буквы после третьей уже не меняют исход.
- Принимать порядок кодов Unicode за словарный для любого языка. Для имён нужна подходящая локаль и её правила.
- Считать числовое и строковое сравнение одинаковыми: , но «10» < «2».
- Путать номер позиции и индекс: третья позиция имеет индекс 2 при нумерации с нуля.
FAQ
Всегда ли короткая строка меньше длинной?
Нет. Она меньше, когда полностью совпадает с началом более длинной. При различии раньше конца решает первая неодинаковая пара элементов.
Можно ли сравнивать последовательности чисел?
Да. Сначала сравните первые числа, затем при равенстве вторые и так далее. Если один кортеж закончился после совпадающего начала, он меньше другого.
Зачем нужен отдельный порядок для разных языков?
Порядок кодовых точек отражает числовое представление символов, а языковые соглашения могут иначе учитывать регистр, диакритику и сочетания букв. Нужные правила выбирают под аудиторию и задачу.
Коротко
Лексикографическое сравнение идёт слева направо до первого различия; при совпадении общего начала меньшим считается более короткий префикс. Один принцип работает для строк, числовых кортежей и перестановок, но результат зависит от порядка самих элементов и выбранных правил обработки текста.
Читайте также
Алгоритм LZ77: сжатие с помощью ссылок назад
Алгоритм LZ77 на пошаговом примере: как скользящее окно находит повторы, что означают расстояние и длина, как работает перекрытие и от чего зависит размер результата.
Числа Белла: разбиения множества и формула
Числа Белла считают разбиения множества на непустые группы. Разбираем подробные примеры, рекуррентную формулу, связь с числами Стирлинга и алгоритм вычисления.
Числа трибоначчи: формула и примеры вычисления
Числа трибоначчи: три начальных значения, рекуррентная формула и расчёт по шагам. Как последовательность считает пути по ступенькам и как написать эффективный алгоритм.
Чётность подстановки: инверсии и знак
Чётность подстановки через инверсии, транспозиции и циклы: пошаговый подсчёт, доказательство независимости разложения и применение в алгоритмах и определителях.
Дерево двоичного поиска: построение и операции
Дерево двоичного поиска: как устроены узлы, как построить BST по ключам, выполнить обход и удалить элемент, от чего зависит высота и сложность операций.
Доминирующее множество в графе: определение и примеры
Как проверить доминирующее множество графа и найти число доминирования: разбираем путь из шести вершин, полный перебор, жадный подход и типичные ошибки.