Информационный объём текстового сообщения: расчёт
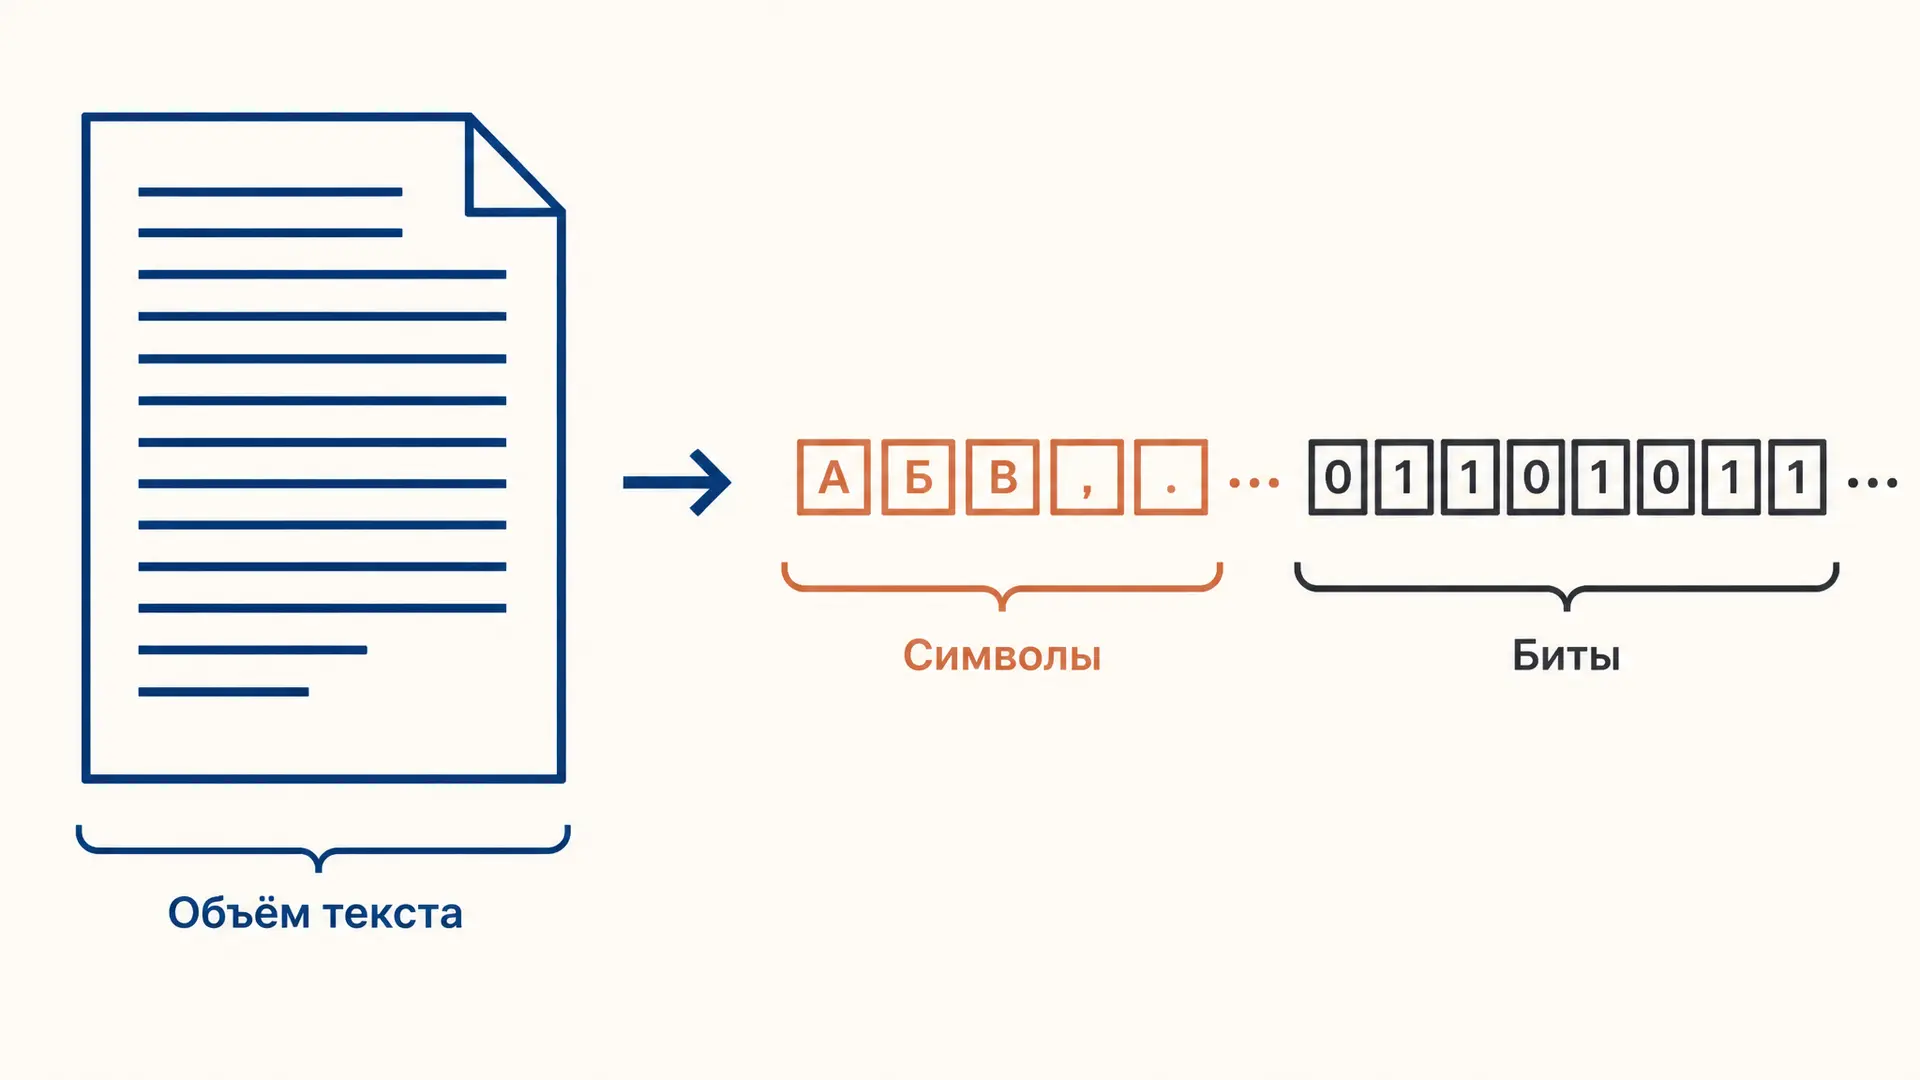
Сколько места займёт текст из 1200 символов, если для каждого выделено по 6 бит? Достаточно умножить длину на ширину кода: получится 7200 бит, или 900 байт. Но сначала важно понять, откуда взялись 6 бит и что именно включено в число символов. В учебной задаче обычно используют одинаковую длину кода; в настоящем файле размер зависит от кодировки и дополнительных данных. Разберём оба случая и научимся не смешивать их.
Что считается объёмом сообщения
Информационный объём текстового сообщения в задачах на кодирование - число бит, необходимых для записи его символов при заданном способе кодирования. Это характеристика представления текста, а не оценка того, насколько он содержателен. Строки одинаковой длины при одинаковом фиксированном коде займут одинаковое число бит, даже если одна состоит из повторяющихся букв, а другая осмысленна.
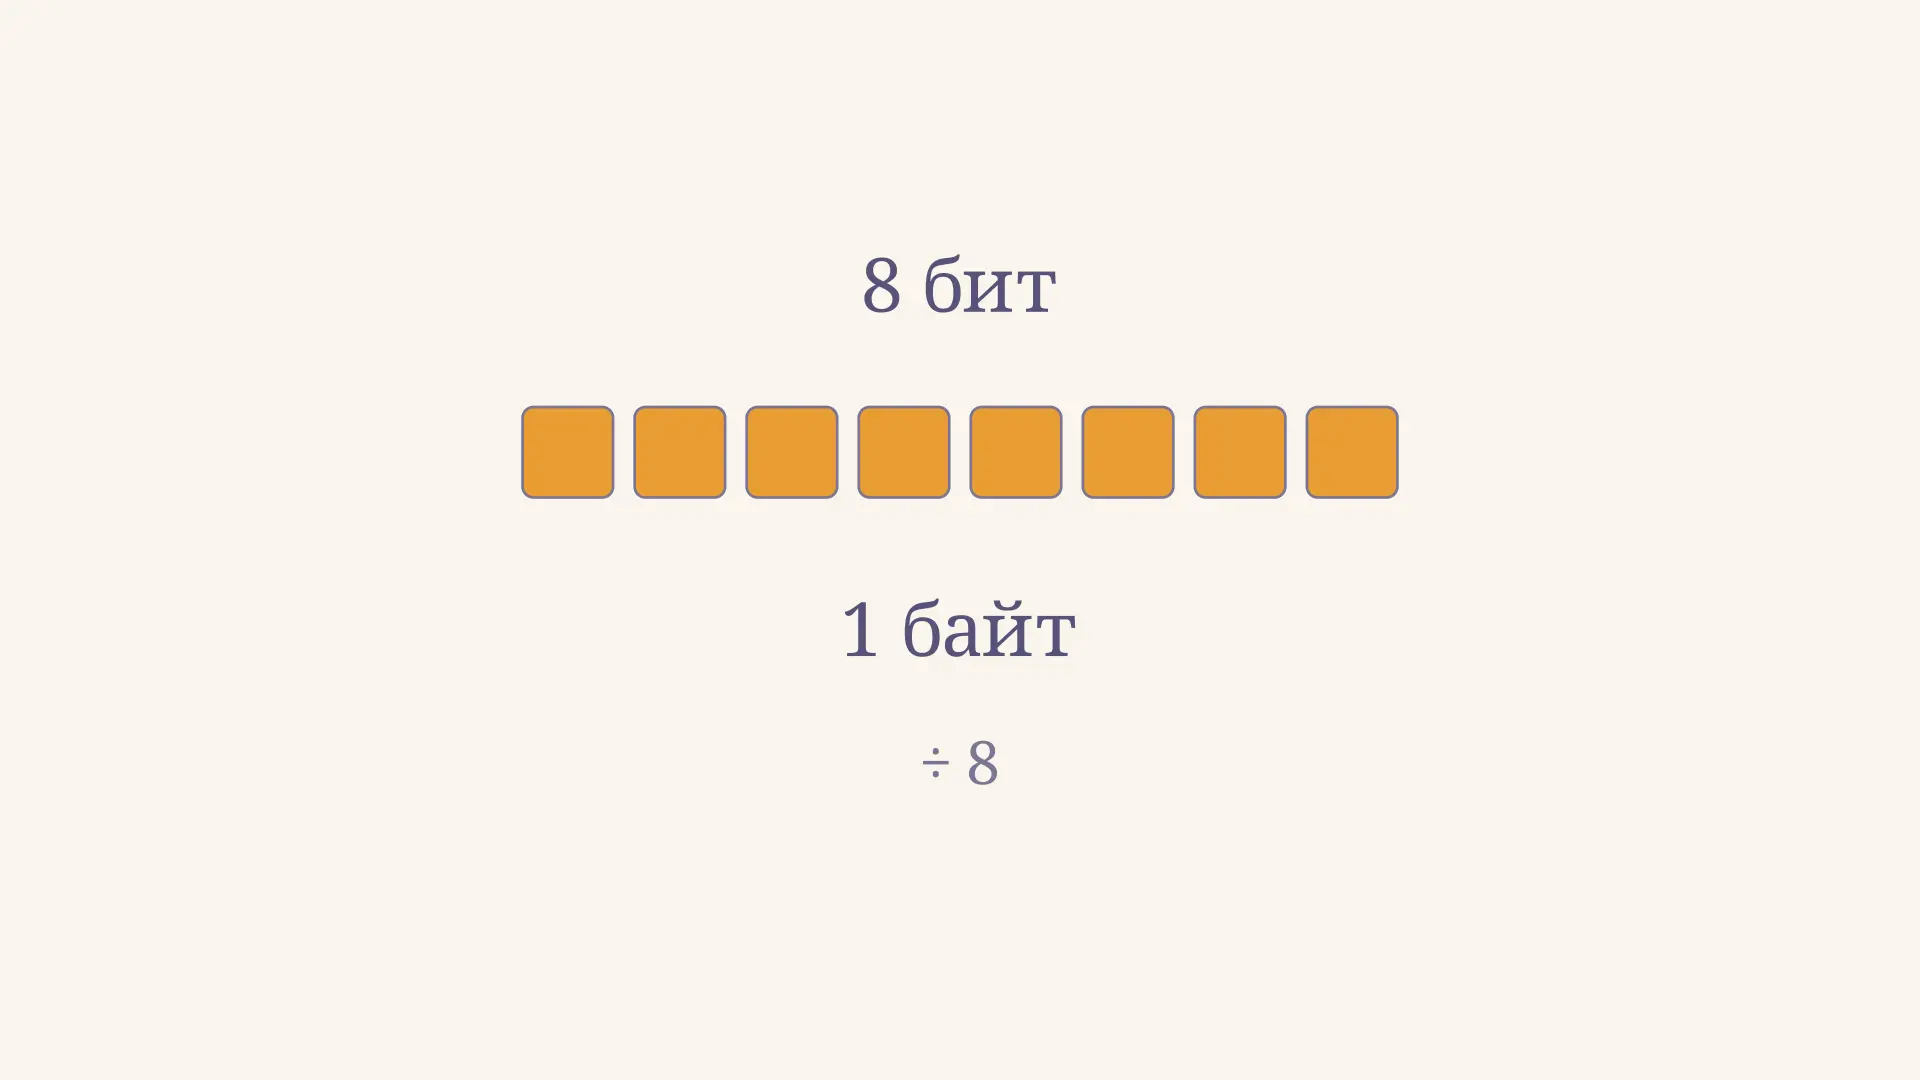
Единица измерения - бит: один двоичный разряд, принимающий значение 0 или 1. В рассматриваемых задачах 8 бит составляют байт. Чтобы перейти от бит к байтам, делят на 8; для обратного перехода умножают на 8. Если получилось нецелое число байт, это не ошибка в объёме битовой последовательности. При хранении в целых байтах понадобится округлить число байт вверх и указать, что оставшиеся биты не относятся к полезной записи.
Не путайте объём записи с количеством информации в сообщении о событии: там важна вероятность события, а здесь - длина и код. Физический размер файла также может отличаться из-за заголовков, форматирования, сжатия или служебных данных.
Формула для кода постоянной длины
Пусть текст содержит символов, а каждый записывается кодом длиной бит. Тогда объём равен:
Единица результата - бит. Формула применима, когда каждый символ действительно представлен одинаковым числом бит и в условии не требуется учитывать дополнительные данные. В входят не только буквы: пробелы, цифры, знаки препинания и переводы строки тоже учитываются, если они являются частью сообщения. При подсчёте конкретной строки полезно сначала выписать её без добавленных кавычек и сосчитать все позиции.
Например, строка «кот и пёс» содержит 9 символов: шесть букв, два пробела и одну букву между ними. При коде по 8 бит объём будет бита, или 9 байт. Кавычки в примере служат для выделения строки и в расчёт не включены. Если бы условие включало их в текст, длина увеличилась бы на два символа.
Как найти ширину кода по алфавиту
Мощность алфавита - число разных допустимых символов, а не число символов в конкретном тексте. Код из бит позволяет составить разных комбинаций. Поэтому для равномерного двоичного кода нужно найти наименьшее целое , для которого :
Например, для 64 символов достаточно 6 бит: . Для алфавита из 50 символов тоже нужны 6 бит: пяти недостаточно, поскольку , а шестибитных комбинаций уже 64. Часть возможных кодов останется неиспользованной. Округление здесь относится к длине каждого кода, а не к общему произведению. Если ширина кода прямо задана в условии, вычислять её по мощности не нужно.
Связь числа равновозможных вариантов и логарифма подробнее объясняет формула Хартли. Однако при построении посимвольного кода для 50 знаков нельзя назначить каждому дробное число бит: в этой модели длина двоичного кодового слова целая. Возможны другие схемы сжатия, но они требуют иных предпосылок.
Пример: текст из 1200 символов
Предположим, что сообщение содержит 1200 символов вместе с пробелами и знаками препинания. Мощность алфавита - 64 символа; используется минимальный равномерный код без заголовков и сжатия. Найдём объём:
- На один символ нужно бит, поскольку .
- На весь текст требуется бит.
- В байтах это байт.
Проверка размерности помогает заметить ошибки: символы сокращаются, остаются биты. Если бы для тех же 1200 позиций условие задавало 8 бит на символ, получилось бы 9600 бит, или 1200 байт. Меняется именно способ кодирования; количество символов при этом остаётся прежним. Калькулятор выше показывает эту зависимость для разных длин текста и мощности алфавита.
При переводе крупных величин читайте условие. В двоичной системе КиБ байта, а в десятичной кБ байт. В школьных задачах запись «Кбайт» нередко используют для 1024 байт, поэтому основание перевода следует уточнять по условию. Здесь 900 байт - это КиБ или кБ.
Как разобрать условие по шагам
Сначала отметьте, какие данные относятся к самому сообщению, а какие - к алфавиту. Фраза «текст содержит 1200 символов» задаёт длину, а «алфавит содержит 64 символа» описывает набор допустимых знаков. Один и тот же знак может повторяться в сообщении много раз, поэтому эти два числа не обязаны совпадать. Если длину приходится находить по строкам и символам в строке, перемножайте их только тогда, когда длины строк одинаковы. Переводы строк учитывайте отдельно, если они входят в сообщение по условию.
Далее определите модель кода. Когда задано, что один символ занимает фиксированное число бит, берите это число напрямую. Если дана только мощность алфавита и требуется минимальный равномерный код, подберите ближайшую подходящую степень двойки. Запишите промежуточное неравенство: оно покажет, почему разрядов достаточно и почему на один разряд меньше не хватит.
Наконец, умножьте ширину на длину и переведите ответ в запрошенные единицы. Полезно отдельно проверить, нужен ли точный объём в битах или число целых байтов для хранения. Например, 13 бит соответствуют 1,625 байта по объёму, но для размещения в целых байтах понадобятся два байта. Это округление не превращает полезную последовательность в 16 бит: три оставшихся разряда являются заполнением.
Обратные задачи и ограничения
Если известны объём в битах и ширина , максимальное число полных символов равно . Например, в 100 бит при ширине 6 бит поместятся 16 символов: они займут 96 бит, а 4 бита останутся. Если же сказано, что объём содержит только коды всех символов без остатка, числа должны делиться нацело; иначе исходные условия несовместимы.
Если известны объём и длина, деление даёт ширину кода только при одинаковой длине кодовых слов и отсутствии добавочных данных. Затем число вариантов такого кода равно , но это лишь верхняя граница мощности алфавита: некоторые комбинации могут не использоваться. Например, 6 бит допускают до 64 символов, но сам алфавит может содержать 50.
Почему размер реального файла может быть другим
В реальной кодировке длина записи символов не всегда постоянна. В UTF-8 разные кодовые точки занимают от одного до четырёх байт; символы ASCII занимают один байт. Это следует из спецификации RFC 3629. Например, строка «Кот!» без кавычек в UTF-8 занимает 7 байт: три русские буквы по два байта и восклицательный знак один байт. Умножать четыре видимых знака на одинаковую ширину здесь нельзя.
Unicode задаёт кодовые точки, а UTF-8 определяет, как представить их байтами. Даже понятие видимого символа не всегда совпадает с одной кодовой точкой: знак может состоять из нескольких. Подсчёт размера конкретного файла надёжнее проводить по полученной последовательности байт, учитывая возможные метки и переводы строк. О связи кодовых значений и байтов подробнее рассказано в статье про кодирование текста в ASCII.
Сжатие может уменьшить размер записи, используя повторения и закономерности текста; архив при этом добавляет собственные служебные данные. Поэтому формула - удобная учебная модель, а не универсальное предсказание размера документа или архива. Для вероятностного подхода к среднему количеству информации см. формулу Шеннона.
Частые ошибки
- Забывают пробелы и знаки. Уточните, включены ли они в указанную длину, и не добавляйте их повторно.
- Подставляют мощность вместо ширины кода. Алфавит из 64 символов требует 6 бит на знак, а не 64.
- Округляют логарифм вниз. Для 50 символов пятибитных кодов не хватит; нужны 6 бит.
- Путают биты и байты. Переводите результат только после умножения и подписывайте единицы.
- Применяют постоянную ширину к любому файлу. UTF-8 имеет переменную длину, а формат документа может добавлять данные.
FAQ
Нужно ли считать пробел символом?
Да, если он входит в текст сообщения. Если длина уже указана вместе с пробелами, отдельно прибавлять их не нужно.
Всегда ли один символ занимает один байт?
Нет. Это верно только для определённых символов и кодировок. В UTF-8 латинская буква ASCII занимает один байт, а русская буква из примера - два.
Почему для 50 символов требуется 6 бит?
Пять бит дают лишь 32 комбинации, шесть - 64. При фиксированном коде каждому допустимому символу нужна своя комбинация.
Коротко
Для текста с фиксированной шириной кода умножьте число символов на биты на символ. Если известна мощность алфавита, выберите минимальное целое с . Затем переведите биты в нужные единицы и проверьте, относится ли ответ к учебной модели или к конкретному файлу.
Читайте также
Алгоритм LZW: сжатие данных с помощью словаря
Алгоритм LZW по шагам: как строится словарь фраз, выдаются коды и восстанавливается исходная строка. Разберём пример, особый случай декодирования и оценку размера.
Блок-схема алгоритма: условный оператор
Как построить блок-схему алгоритма с условным оператором: обозначения, полное и неполное ветвление, пример проверки чётности и трассировка двух путей.
Исполнитель Черепаха: алгоритм рисования фигур
Как исполнитель Черепаха рисует фигуры по командам: положение, направление и перо, пошаговая трассировка квадрата, циклы и углы поворота многоугольников.
Кодирование длин серий RLE: примеры и расчёт
Как работает кодирование длин серий RLE: пошаговый разбор кодирования и декодирования, расчёт размера в байтах, условия эффективности и ограничения метода на примерах.
Обратная польская запись: как вычислять со стеком
Обратная польская запись простыми словами: как перевести выражение в постфиксную форму, вычислить его со стеком, сохранить порядок операндов и найти ошибку.
Перевод битов в байты и других единиц информации
Как перевести биты в байты и обратно, учитывать остаток, различать килобайты и кибибайты и пошагово решать задачи на размер файла и скорость передачи данных.