Сеть долгой краткосрочной памяти LSTM: вентили и состояние
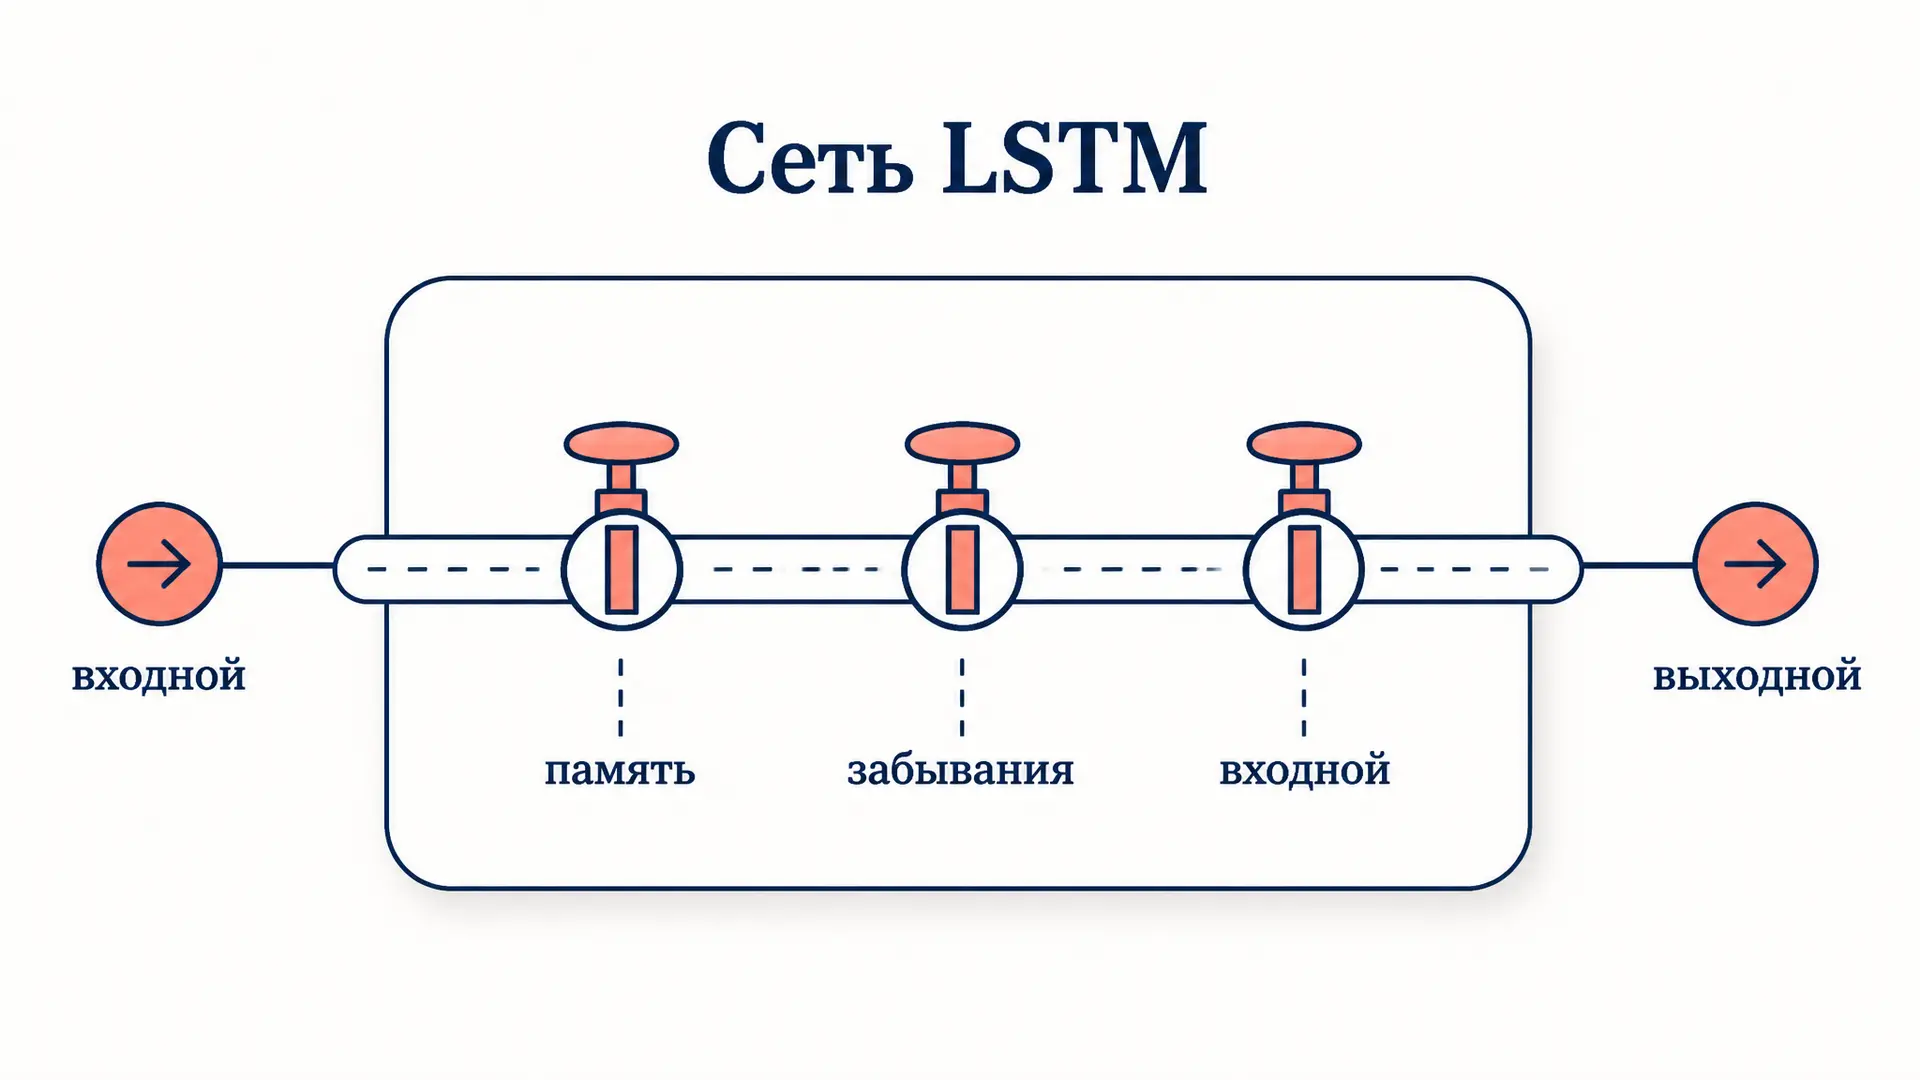
Обычная рекуррентная сеть умеет помнить контекст, но только короткий: чем дальше во времени нужная информация, тем сильнее её «размывает» при обучении из-за затухающего градиента. Сеть долгой краткосрочной памяти (Long Short-Term Memory, LSTM) была придумана именно для того, чтобы держать важный сигнал на десятки и сотни шагов. Достигается это не магией, а аккуратной конструкцией из состояния ячейки и трёх управляющих вентилей. Разберём, как именно ячейка решает, что забыть, что записать и что выдать наружу, и почему такая схема обходит главную болезнь простых RNN. Ниже можно прогнать один шаг ячейки по числам и увидеть, как меняется горизонт памяти.
Зачем понадобилась долгая краткосрочная память
Название кажется парадоксальным: «долгая краткосрочная». Смысл такой - это всё ещё краткосрочная память (внутреннее состояние, а не отдельная база знаний, как веса), но способная жить долго. В обычной рекуррентной сети скрытое состояние на каждом шаге целиком перезаписывается через нелинейность, и при обучении градиент, пробегая назад через много шагов, многократно умножается на близкие к нулю производные. Сигнал об ошибке тает экспоненциально - это и есть проблема затухающего градиента.
LSTM добавляет рядом со скрытым состоянием отдельную «магистраль памяти» - состояние ячейки . По ней информация течёт почти без искажений: на каждом шаге к ней применяются только покомпонентное умножение и сложение, без сжимающей нелинейности. Именно поэтому градиент по этой магистрали не затухает так быстро.

Состояние ячейки и три вентиля
Сердце LSTM - это состояние ячейки и три вентиля (gates). Вентиль - это вектор чисел от 0 до 1, полученный через сигмоиду ; он умножается покомпонентно на другой вектор и работает как набор «кранов»: 0 закрывает поток, 1 пропускает целиком.
Три вентиля решают три разные задачи:
- Вентиль забывания - сколько старой памяти оставить: .
- Входной вентиль - сколько новой информации записать: .
- Выходной вентиль - сколько из состояния ячейки выпустить наружу как скрытый выход: .
Здесь - конкатенация предыдущего скрытого состояния и нового входа; у каждого вентиля свои обучаемые веса и смещение . Калькулятор выше как раз показывает, во что превращаются логиты (значения до сигмоиды) после активации, и как от этого зависит дальнейшее поведение ячейки.
Кандидат состояния и обновление памяти
Кроме вентилей, ячейка вычисляет кандидата состояния - что в принципе можно было бы записать в память на этом шаге:
Гиперболический тангенс даёт значения в диапазоне от до , то есть кандидат может как увеличивать, так и уменьшать компоненты памяти. Само обновление состояния ячейки - ключевая формула LSTM:
Символ - покомпонентное (адамарово) умножение. Читается это так: новое состояние = (сколько оставили от старого) + (сколько записали нового). Если и , ячейка почти буквально копирует прошлую память дальше - сигнал едет по магистрали без изменений. Если , прошлое стирается, и память начинается «с чистого листа».

Скрытый выход и роль выходного вентиля
Состояние ячейки - это внутренняя память, наружу она не идёт напрямую. Наружу подаётся скрытое состояние , которое получается фильтрацией памяти через выходной вентиль:
Сначала состояние ячейки сжимается через в диапазон , затем выходной вентиль решает, какие компоненты этой памяти важны прямо сейчас. Так LSTM может хранить в много всего, но выдавать на каждом шаге только релевантную часть. Именно уходит на следующий шаг и в выходной слой сети (например, для предсказания следующего слова).
Полезно сравнить это с механизмом внимания: LSTM сжимает всю историю в фиксированный вектор состояния, тогда как внимание обращается к любому прошлому элементу напрямую. Поэтому современные трансформеры во многих задачах вытеснили рекуррентные сети, но LSTM по-прежнему силён там, где данные строго последовательны и память должна обновляться шаг за шагом.
Почему LSTM побеждает затухающий градиент
Главная причина устойчивости - аддитивное обновление по магистрали . При обратном распространении ошибки через много шагов градиент по состоянию ячейки умножается в основном на вентиль забывания , а не на производную сжимающей нелинейности. Если сеть научилась держать около единицы для нужной компоненты, произведение не схлопывается к нулю - путь для градиента остаётся открытым.
Удобная интуиция: записанный сигнал к шагу ослабляется примерно как . Горизонт памяти - число шагов, за которое сигнал падает в раз - равен
При горизонт всего около полутора шагов, при - почти 20 шагов, при - около ста. Сдвиньте слайдер вентиля забывания в калькуляторе и посмотрите на кривую затухания: она наглядно показывает, как одно число управляет длиной памяти. На практике, чтобы LSTM «по умолчанию» помнил, смещение часто инициализируют положительным - тогда в начале обучения вентиль забывания близок к единице.
Частые ошибки
- Путать состояние ячейки и скрытое состояние . - внутренняя память, течёт по магистрали; - отфильтрованный выходным вентилем сигнал наружу. На следующий шаг идут оба, но в выходной слой - только .
- Считать, что вентиль забывания «забывает». Наоборот: означает «помнить полностью», - «стереть». Имя про то, сколько оставить, а не сколько выбросить.
- Применять к состоянию ячейки при его обновлении. В формуле нелинейности к самому нет - это и есть секрет незатухающего градиента. применяется к кандидату и к выходу, но не к магистрали.
- Думать, что вентили - это отдельные слои. Все четыре преобразования (три вентиля и кандидат) считаются параллельно из одного и того же входа , просто с разными весами.
- Забывать про инициализацию . Нулевое смещение даёт и короткую память на старте обучения; положительный сдвиг помогает сети сразу удерживать длинные зависимости.
FAQ
Чем LSTM отличается от обычной RNN? В простой RNN скрытое состояние на каждом шаге целиком пропускается через сжимающую нелинейность, из-за чего градиент затухает на длинных последовательностях. LSTM добавляет отдельную магистраль состояния ячейки с аддитивным обновлением и три вентиля, которые управляют потоком памяти. Это позволяет хранить зависимости на десятки и сотни шагов.
Что такое вентиль забывания и зачем он нужен? Это вектор значений от 0 до 1, который покомпонентно умножается на прошлое состояние ячейки. Он решает, какую часть старой памяти сохранить, а какую стереть. Значение около единицы означает «помнить долго», около нуля - «начать заново». Именно произведение вентилей забывания вдоль шагов определяет, насколько далеко назад тянется память.
Чем LSTM отличается от GRU? GRU (Gated Recurrent Unit) - облегчённая версия с двумя вентилями вместо трёх и без отдельного состояния ячейки: память и скрытое состояние объединены. GRU обучается быстрее и имеет меньше параметров, часто показывает сопоставимое качество. LSTM же даёт более гибкое разделение «что хранить» и «что выдавать», что иногда важно на сложных длинных зависимостях.
Коротко
Сеть долгой краткосрочной памяти LSTM хранит информацию в отдельной магистрали - состоянии ячейки , которое обновляется аддитивно по формуле . Три вентиля решают, что забыть (вентиль забывания ), что записать (входной ) и что выдать наружу (выходной ). Поскольку к магистрали памяти не применяется сжимающая нелинейность, градиент по ней не затухает, и сеть удерживает зависимости на десятки шагов - там, где простая RNN всё забывает. Горизонт памяти задаётся вентилем забывания: чем ближе к единице, тем дольше живёт сигнал.
Читайте также
Агрегатные функции SQL: COUNT, SUM, AVG и GROUP BY
Как работают агрегатные функции SQL: COUNT, SUM, AVG, MIN и MAX, группировка GROUP BY, порядок выполнения запроса, разница HAVING и WHERE и поведение NULL внутри агрегата.
Интегральный синус Si(x): ряд Тейлора и максимум
Интегральный синус Si(x): почему интеграл sin t / t не берётся в элементарных функциях, разложение в ряд, предел π/2, максимум Si(π) и выброс Гиббса. С калькулятором.
Куча как структура данных: массив и просеивание
Куча как структура данных: свойство кучи, хранение в обычном массиве и индексы 2i+1 и 2i+2, просеивание sift-up и sift-down, построение за O(n) и приоритетная очередь.
Линейная зависимость векторов: критерии и примеры
Что такое линейная зависимость векторов, как проверить её определителем и рангом матрицы, чем коллинеарность отличается от компланарности и как всё это связано с базисом.
Линейное уравнение второго порядка: общее решение
Как решить линейное однородное уравнение второго порядка с постоянными коэффициентами: характеристическое уравнение, три случая корней, фундаментальная система и задача Коши с разбором.
Метод вариации постоянных: формулы и разбор примера
Метод вариации произвольных постоянных: как из решений однородного уравнения собрать частное, зачем здесь определитель Вронского и когда быстрее оказывается подбор по виду правой части.