Проверка палиндрома строки: два указателя и Python
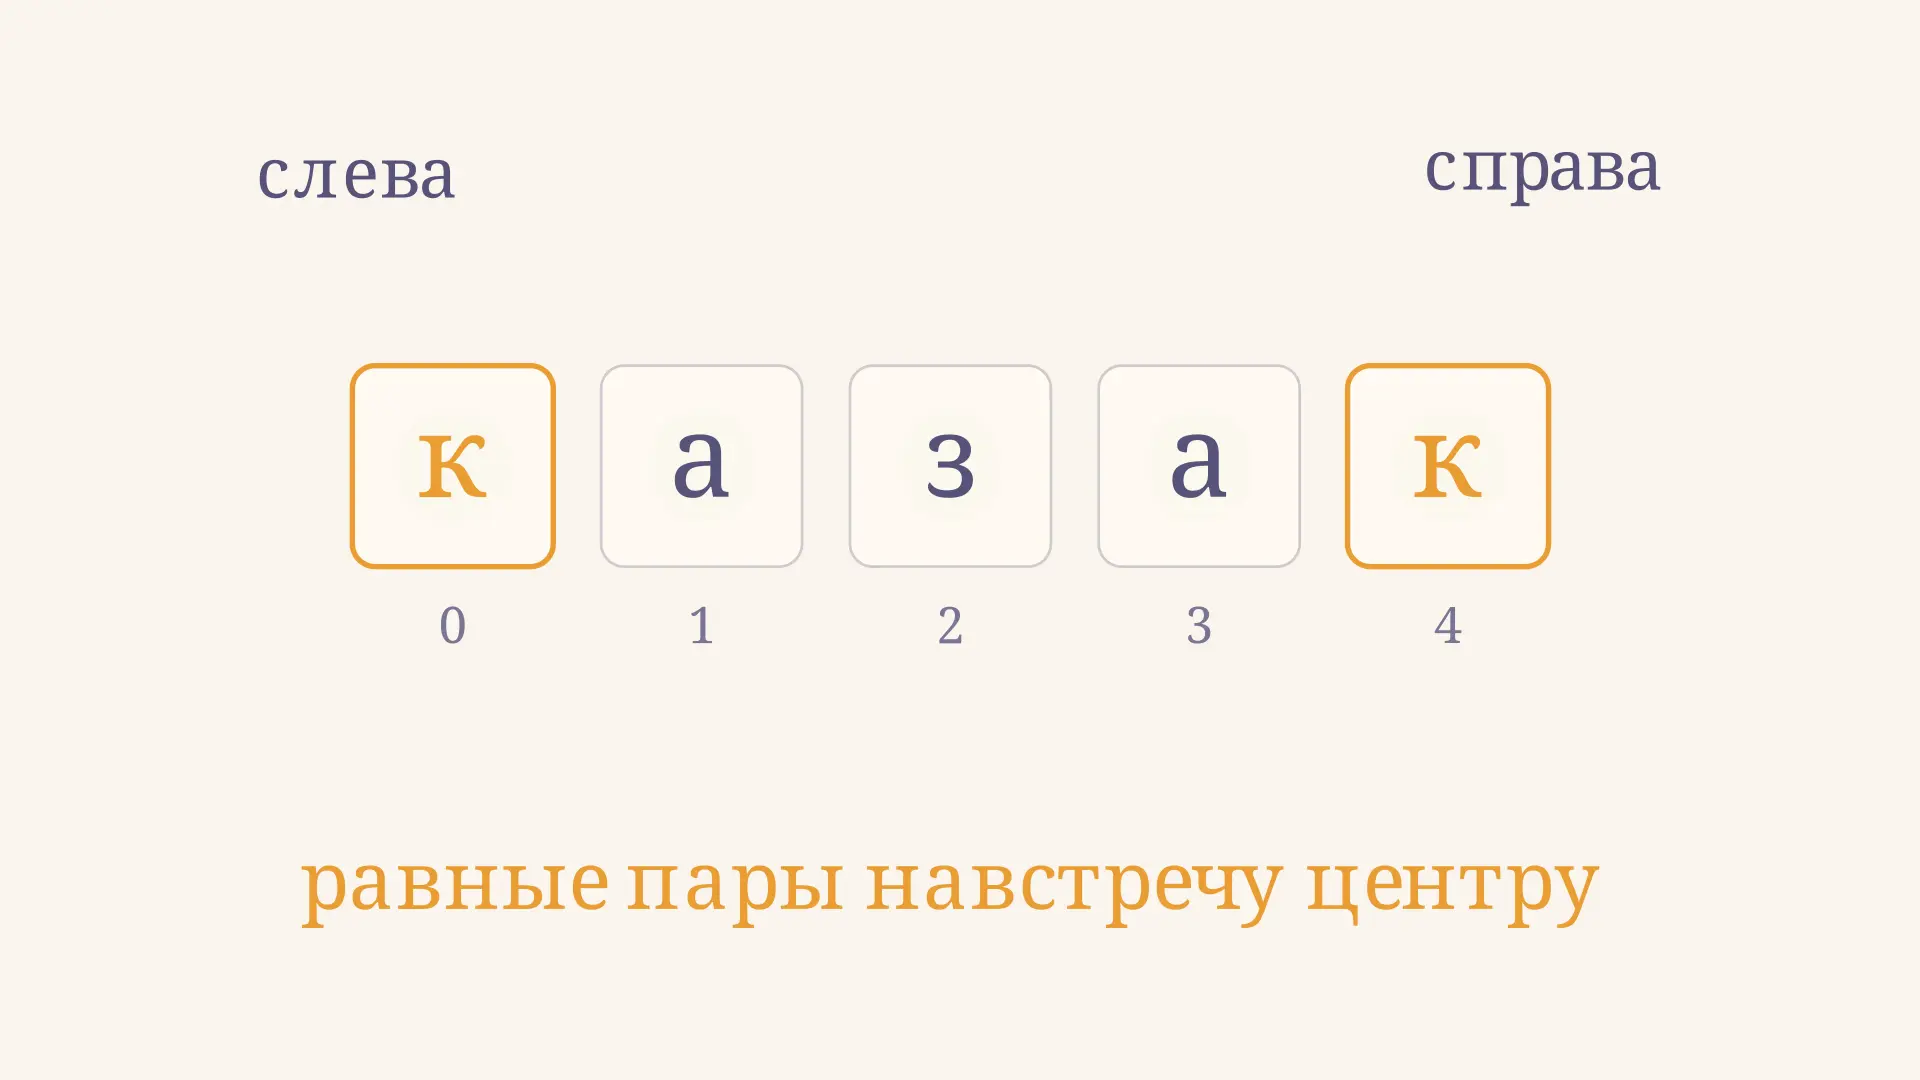
Проверка палиндрома строки отвечает на вопрос: совпадает ли последовательность символов с той же последовательностью в обратном порядке? Например, «казак» совпадает, а «кошка» нет. Достаточно сравнивать крайние символы и постепенно двигаться к середине: при первом различии ответ уже известен. В интерактиве можно ввести свою строку и увидеть, какие пары индексов проверяет алгоритм. Здесь сравнение точное: пробелы и регистр тоже имеют значение.
Что именно сравнивается
Палиндром читается одинаково слева направо и справа налево. Для строки длины с нумерацией от нуля условие записывается как для каждой позиции . Сравнивать каждую позицию отдельно избыточно: пара повторилась бы как . Достаточно проверить первые пар.
Определение зависит от того, что считать символом и какие различия игнорировать. В строгом варианте «Казак» не совпадает с обратной строкой из-за заглавной буквы, а пробел считается обычным символом. В задаче про фразы могут попросить не учитывать регистр и пунктуацию. Эти правила нужно выбрать до написания кода: иначе две правильные программы дадут разные ответы на один и тот же ввод.
Здесь основная модель сравнивает последовательность кодовых точек без предварительной обработки. Интерактив использует именно её: он не удаляет пробелы и показывает итог для всей строки, а ползунок позволяет просмотреть пары вплоть до первого несовпадения.
Два указателя навстречу друг другу
Поставим левый указатель в начало, а правый в конец. Если символы отличаются, строка не палиндром. Если равны, внешняя пара уже проверена: увеличиваем и уменьшаем . Продолжаем, пока . Встреча или пересечение указателей означает, что непроверенных пар больше нет.
В слове «казак» индексы идут от 0 до 4. Сначала сравниваются буквы «к» на позициях 0 и 4, затем «а» на позициях 1 и 3. Обе пары равны. Остаётся «з» на позиции 2: она находится напротив самой себя, поэтому отдельное сравнение не требуется. На ролике переход обратно возвращает указатели в начало для повторного просмотра; это не дополнительный шаг алгоритма.
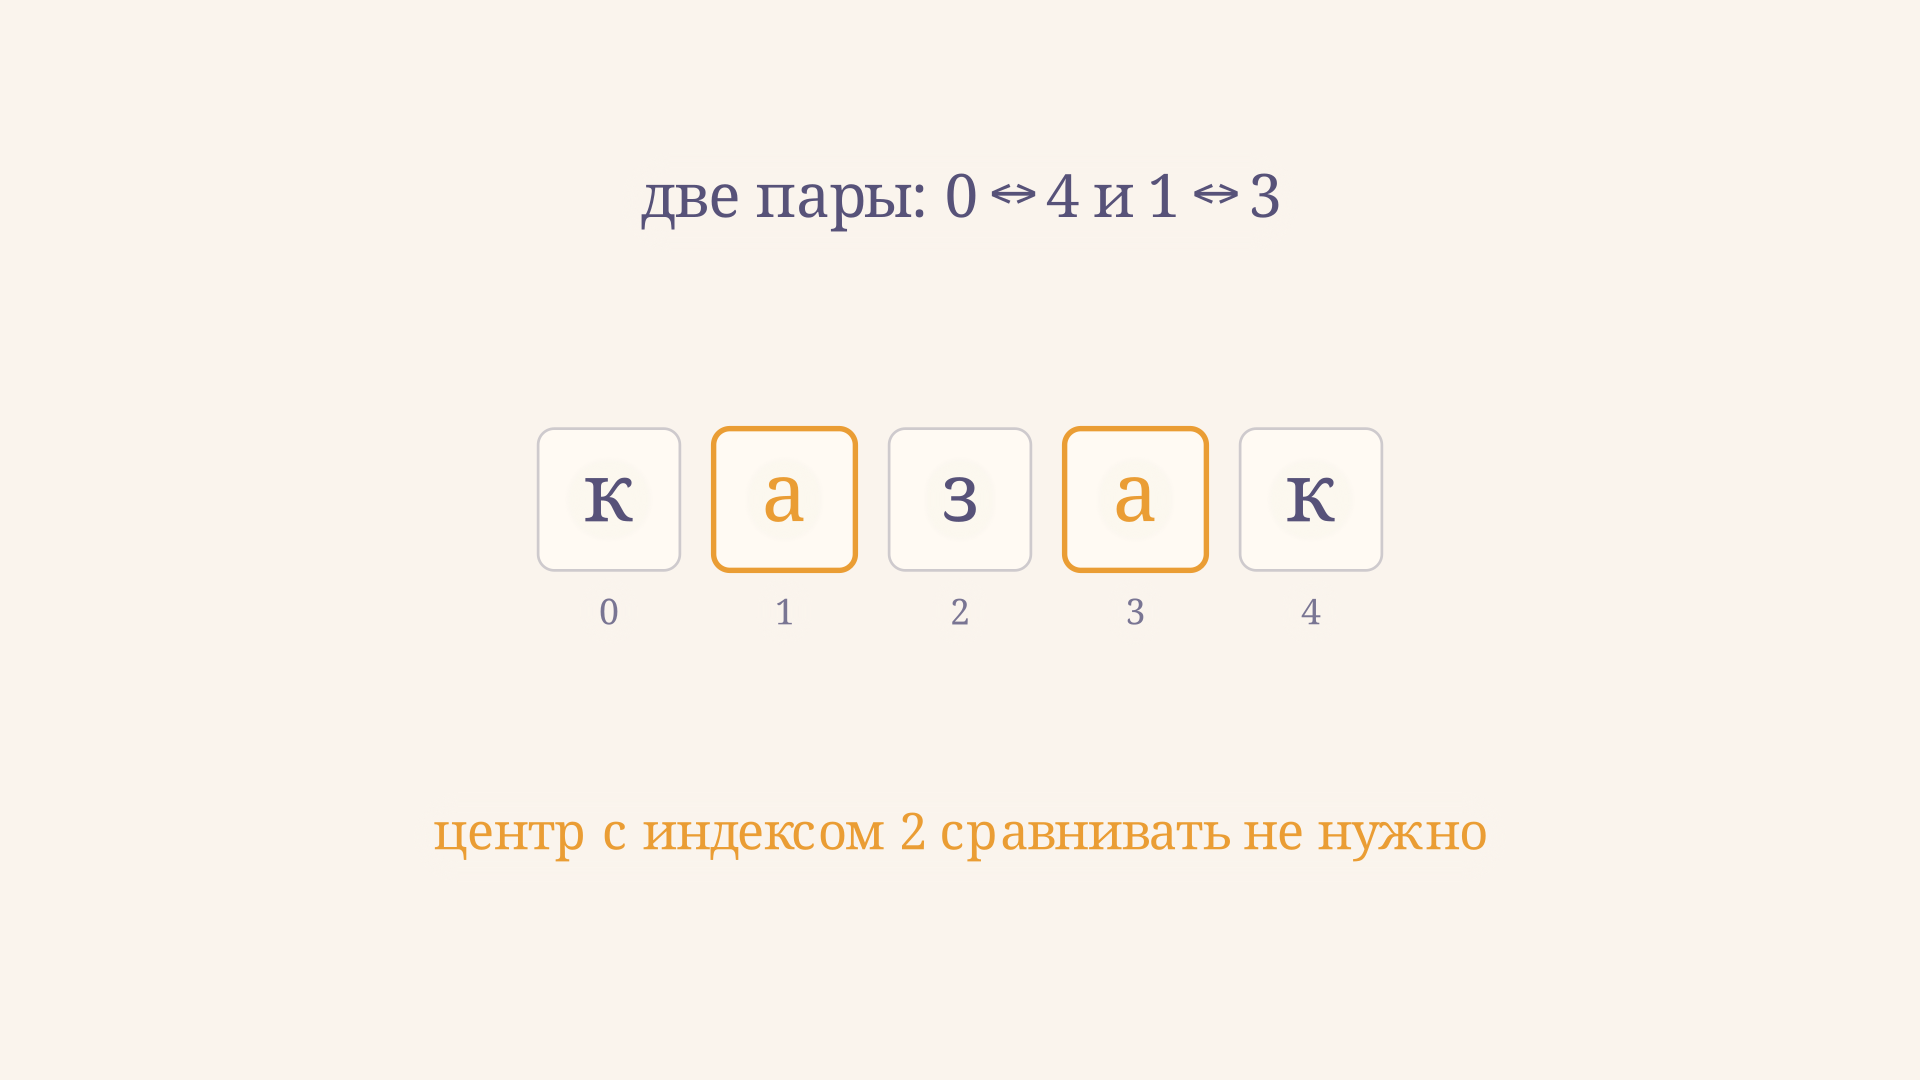
Для чётной длины центрального одиночного символа нет: после проверки последней пары указатели пересекутся. Пустая строка и строка из одного символа также считаются палиндромами: несовпадающих пар в них нет. Если конкретная задача требует отвергать пустой ввод, это отдельное условие перед основным циклом.
Реализация на Python
В Python индексация строки начинается с нуля, а len(s) - 1 задаёт индекс последней позиции. Функция ниже проверяет точное равенство без изменения входа:
def is_palindrome(s: str) -> bool:
    left, right = 0, len(s) - 1
    while left < right:
        if s[left] != s[right]:
            return False
        left += 1
        right -= 1
    return True

print(is_palindrome('казак'))  # True
print(is_palindrome('кошка'))  # False
print(is_palindrome(''))       # True
При пустой строке правый индекс равен −1, но тело цикла не запускается: условие ложно. Поэтому обращение к отсутствующему символу не происходит. Возврат False внутри цикла важен: первая несовпадающая пара уже опровергает условие, и оставшуюся часть просматривать не нужно.
Другой короткий вариант - s == s[::-1]: срез создаёт строку в обратном порядке, после чего выполняется сравнение. Он удобен для небольшого кода, но создаёт копию длины . Метод двух указателей показывает логику проверки и не требует такой копии. В обоих случаях результат зависит от выбранного представления символов и правил обработки текста.
Почему алгоритм работает
Перед каждой итерацией все пары снаружи диапазона от до уже равны. Это инвариант цикла. В начале внешних проверенных пар нет, поэтому утверждение выполняется. Если текущая пара равна, её можно добавить к уже проверенным, после чего сузить диапазон. Инвариант сохранится.
Если найдена разная пара, условие палиндрома нарушено: в обратной записи эти два символа поменялись бы местами. Если же цикл завершился без различий, каждая зеркальная пара проверена. При нечётной длине остался только центральный символ, который совпадает сам с собой. Значит, вся последовательность равна обратной.
Такое рассуждение помогает проверить границы цикла отдельно от примеров. Связанный приём с поддержанием границ встречается и в других задачах на строки, хотя их цель отличается: например, алгоритм Кнута - Морриса - Пратта ищет образец внутри текста.
Сколько требуется операций
Для строки длины алгоритм выполняет не более сравнений пар. В худшем случае, когда все пары равны или различие обнаруживается у центра, время линейно: . Если первые символы уже различаются, ответ находится за одно сравнение, то есть за . Для пустой и односимвольной строки сравнений ноль.
Помимо исходной строки хранятся два индекса и несколько служебных значений, поэтому дополнительная память - . Это оценка для уже находящейся в памяти строки и проверки без создания очищенной копии. Если сначала построить новую строку из подходящих символов, понадобится до дополнительной памяти. Если ввод приходит потоком и произвольного доступа к концу нет, описанный вариант напрямую неприменим: данные придётся сохранить или использовать другую модель доступа.
Фраза без пробелов и знаков
В учебных задачах часто сравнивают только буквы и цифры, игнорируя регистр. Тогда удобно сначала явно подготовить последовательность, а затем применить ту же функцию:
def is_phrase_palindrome(text: str) -> bool:
    cleaned = ''.join(ch for ch in text.casefold() if ch.isalnum())
    return is_palindrome(cleaned)

print(is_phrase_palindrome('А роза упала на лапу Азора'))  # True
В документации Python casefold() предназначен для сравнения текста без учёта регистра, а isalnum() определяет буквенно-цифровые символы. Например, пробелы и знаки препинания удаляются, но цифры остаются. Если по условию нужны только буквы, используют другое правило фильтрации. Фраза из одних знаков после очистки становится пустой и в этой реализации даст True; при необходимости её следует обработать отдельно.
В разных языках перевод регистра способен менять длину текста, поэтому сравниваются уже символы результата обработки, а не обязательно позиции исходной фразы. Сложность подготовки и проверки линейна по размеру обрабатываемых данных, память для очищенной строки тоже линейна. Нельзя одновременно заявлять, что создаётся копия, и оценивать всю функцию как использующую постоянную дополнительную память.
Unicode и видимые символы
Один видимый знак не всегда соответствует одной кодовой точке. Например, буква с диакритическим знаком может быть представлена одной кодовой точкой или сочетанием базовой буквы и отдельного знака. Визуально похожие строки при точном сравнении могут отличаться. Если требуется считать канонически эквивалентные записи одинаковыми, перед сравнением применяют нормализацию Unicode, например unicodedata.normalize('NFC', text), и оговаривают порядок нормализации, фильтрации и изменения регистра.
Даже нормализация не превращает любую последовательность кодовых точек в последовательность пользовательских символов: эмодзи и другие сочетания могут состоять из нескольких кодовых точек. Если задача просит сравнивать именно видимые графемные кластеры, сначала нужна их корректная сегментация: её правила описаны в Unicode UAX #29. Стандартная проверка выше этого не делает; для обычных учебных примеров с отдельными буквами достаточно заранее указанной модели кодовых точек.
Когда нужна другая задача
Проверка целой строки отличается от поиска палиндрома внутри неё. Если требуется найти самую длинную палиндромную подстроку или сведения о множестве центров, простая проверка одной строки не решает задачу целиком. Для неё существует алгоритм Манакера, обрабатывающий центры палиндромов за линейное время.
Похожим образом Z-функция строки и алгоритм Рабина - Карпа полезны в задачах сопоставления строк, но для одного точного ответа «да или нет» двум указателям не нужны ни массив дополнительных значений, ни хеширование. Выбор метода начинается с формулировки результата: проверить всю строку, найти вхождение или исследовать все подходящие подстроки.
Частые ошибки
- Сдвигать указатели до сравнения. Так пропускаются крайние символы, а несовпадение может остаться незамеченным.
- Использовать неверную границу. Последний индекс равен , а условие достаточно для обеих чётностей длины.
- Забывать правила ввода. Точное сравнение и проверка фразы без знаков дают разные результаты; очистку нужно прописать явно.
- Считать память копии бесплатной. Разворот срезом и построение очищенной строки расходуют дополнительную память.
- Путать кодовую точку с графемой. Для сложного Unicode-текста требуется отдельно определить единицу сравнения.
FAQ
Является ли пустая строка палиндромом? Да, в стандартном определении: ни одна зеркальная пара не нарушает равенство. Иное правило допустимо, если его явно задаёт условие.
Нужно ли сравнивать центральную букву? Нет. При нечётной длине она отражается в себя; при чётной указатели пересекаются после проверки средней пары.
Можно ли остановиться после первого отличия? Да. Одной несовпадающей пары достаточно, чтобы доказать, что вся последовательность не равна обратной.
Коротко
Сравнивайте крайние символы и двигайте указатели к центру. Первое различие даёт отрицательный ответ; отсутствие различий до встречи указателей означает палиндром. Время в худшем случае , дополнительная память при прямой проверке ; правила регистра, очистки и Unicode задаются отдельно.
Читайте также
Наибольшая общая подпоследовательность: алгоритм и пример
Как найти наибольшую общую подпоследовательность двух строк: таблица динамического программирования, восстановление ответа, пример на словах и оценка сложности.
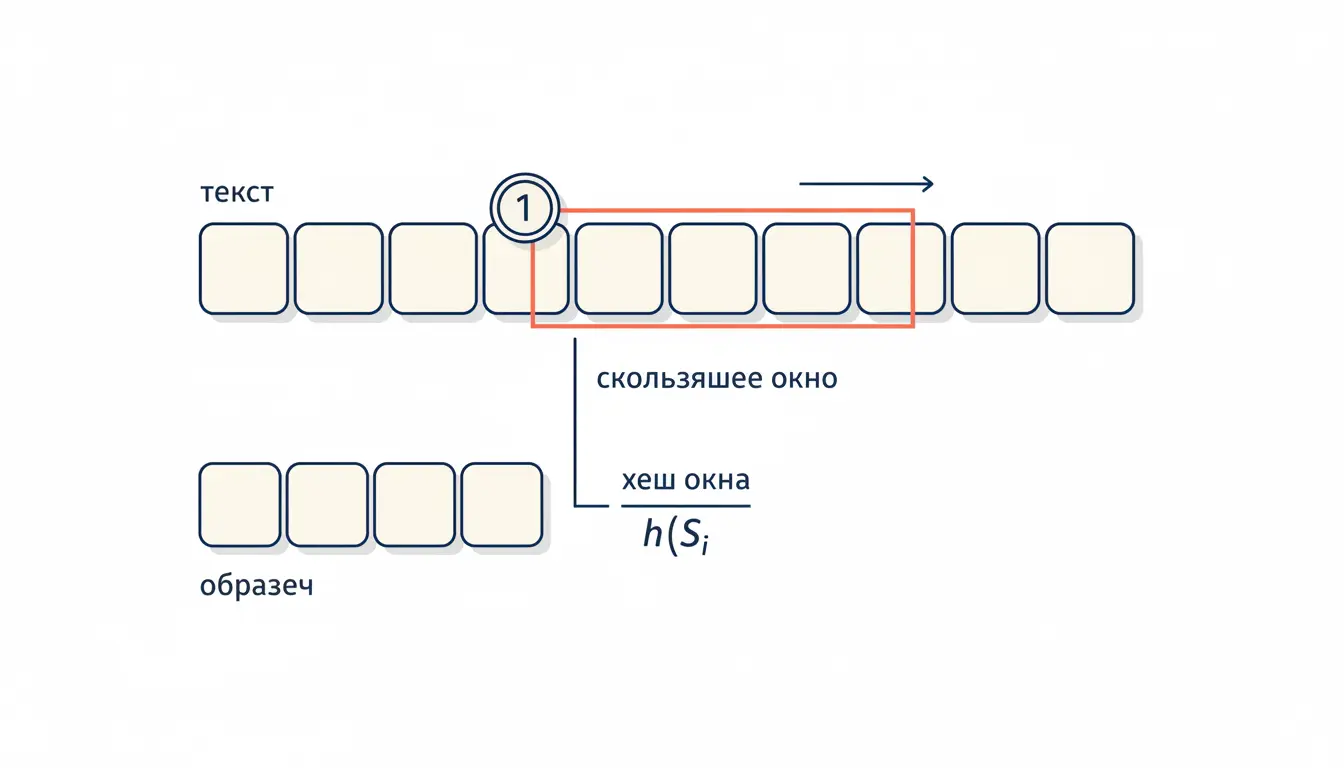
Алгоритм Рабина-Карпа: поиск подстроки за O(n+m)
Разбираем алгоритм Рабина-Карпа: как полиномиальный хеш и скользящее окно ускоряют поиск подстроки до O(n+m) в среднем, почему бывают ложные совпадения и при чём тут плагиат.
Алгоритм Ахо-Корасик: поиск множества образцов в тексте
Разбираем алгоритм Ахо-Корасик: как из бора паттернов и суффиксных ссылок собрать автомат и найти все вхождения множества образцов в тексте за один линейный проход.
Алгоритм Манакера: поиск всех палиндромов за O(n)
Алгоритм Манакера находит все палиндромные подстроки за линейное время O(n). Разбираем разделители, массив радиусов и зеркальную симметрию на понятном примере.
Алгоритм Кнута-Морриса-Пратта: поиск подстроки за O(n+m)
Алгоритм Кнута-Морриса-Пратта ищет подстроку без возвратов по тексту. Разбираем префикс-функцию по шагам, оцениваем сложность и смотрим понятный пример работы.
Алгоритм Бойера-Мура: почему он ищет подстроку так быстро
Разбираем алгоритм Бойера-Мура: зачем сравнивать паттерн справа налево, как работают эвристики плохого символа и хорошего суффикса и почему поиск выходит сублинейным.