Наибольшая общая подпоследовательность: алгоритм и пример
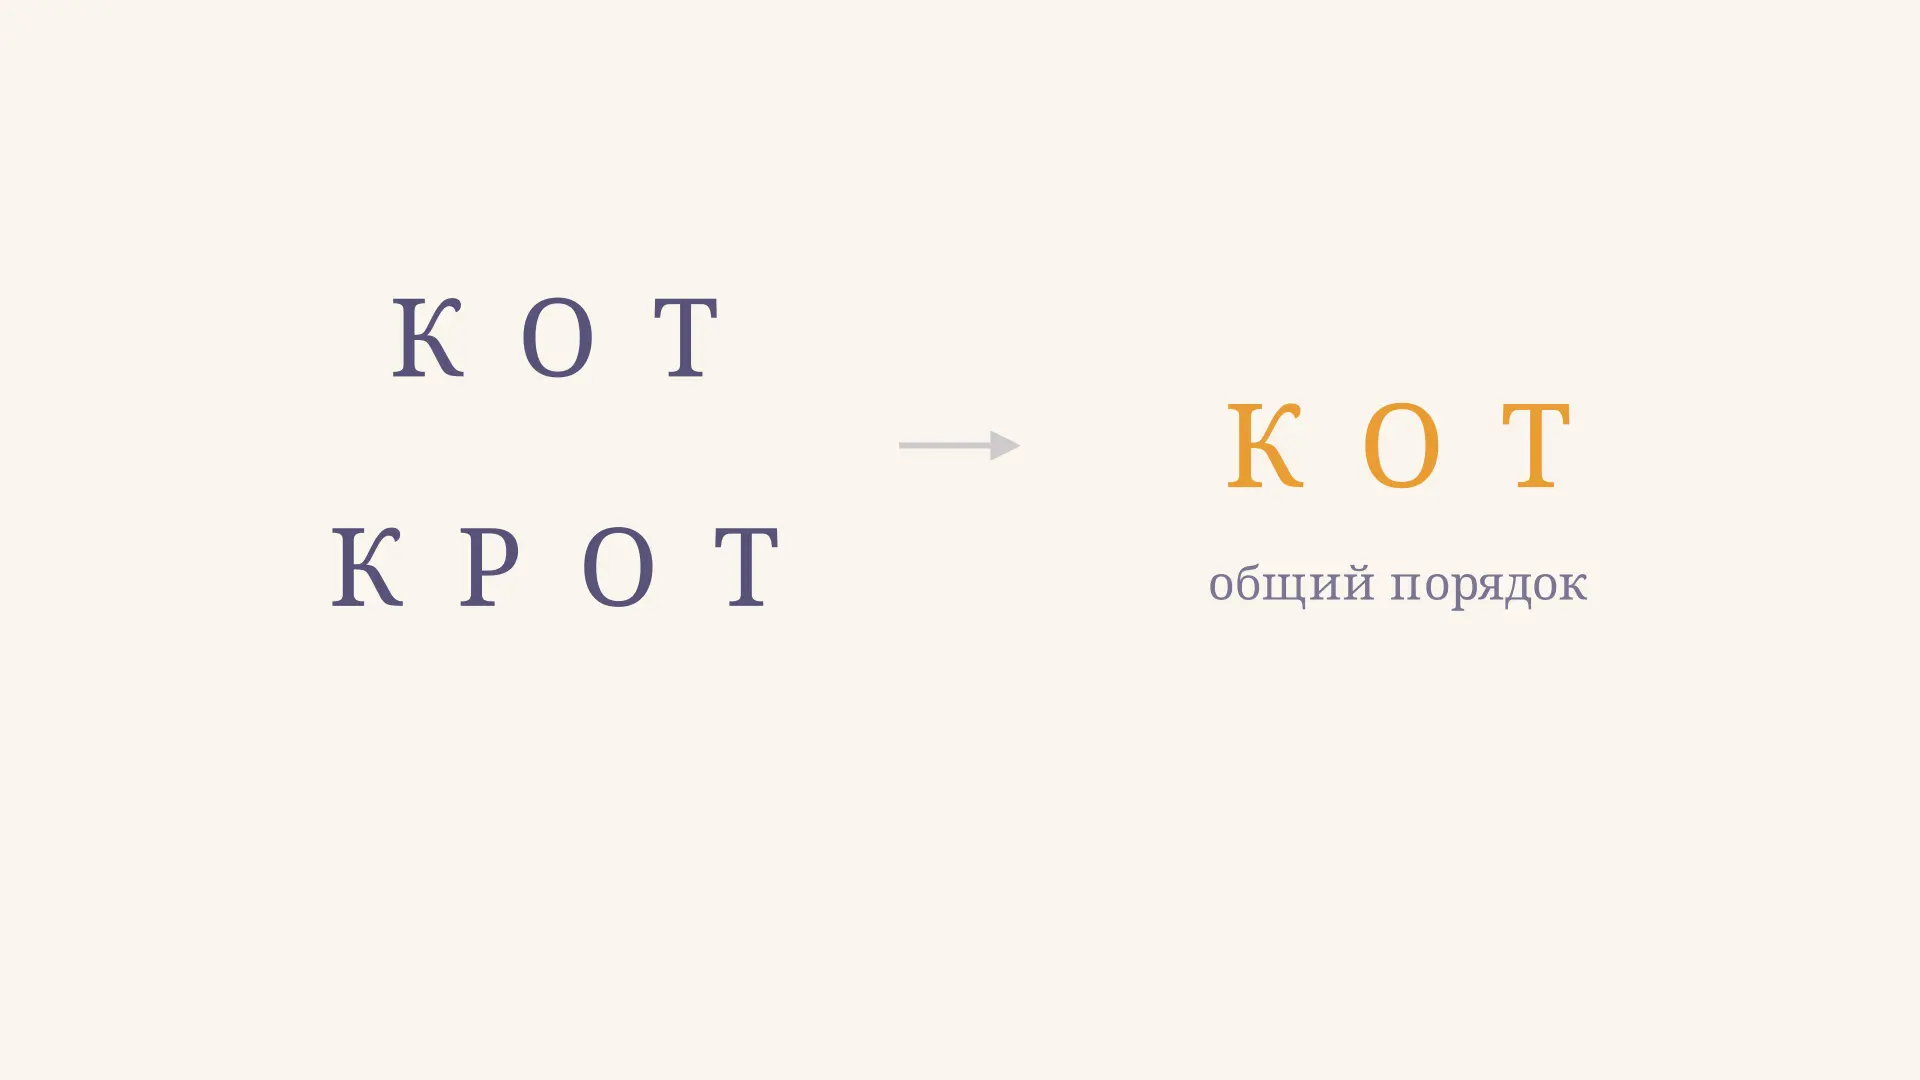
Наибольшая общая подпоследовательность двух последовательностей - самая длинная цепочка элементов, которая встречается в каждой из них в том же порядке. Элементы разрешено пропускать: например, для слов «КОТ» и «КРОТ» ответом будет «КОТ», если во втором слове удалить «Р». Задача возникает при сравнении текстов, последовательностей событий и данных. В калькуляторе можно менять длины исходных слов и смотреть, как растёт таблица ответов для их начальных частей.
Подпоследовательность и подстрока
Подпоследовательность получают из исходной последовательности удалением любого числа элементов без перестановки оставшихся. У слова «КРОТ» есть подпоследовательности «КОТ», «КРТ» и «РОТ». Пустая последовательность тоже допустима: она получается удалением всех символов.
Подстрока устроена строже: её символы должны идти подряд. «КОТ» - подпоследовательность «КРОТ», но не его подстрока, поскольку между «К» и «О» стоит «Р». Эта разница меняет и ответ, и алгоритм. Для сравнения, алгоритм Кнута - Морриса - Пратта ищет вхождение образца как непрерывного фрагмента текста, а здесь пропуски разрешены в обеих последовательностях.
В аббревиатуре LCS английское longest common subsequence означает именно наибольшую общую подпоследовательность. «Общая» требует одного и того же порядка в обеих строках: буквы «АБ» не образуют общую подпоследовательность строк «АБ» и «БА». Зато каждая из букв по отдельности подходит; обе дают максимальную длину 1. Поэтому корректнее говорить об одной из наибольших общих подпоследовательностей: ответ может быть не единственным.
Идея таблицы: решения для префиксов
Пусть первая строка имеет длину , вторая - длину . Префикс длины состоит из первых символов строки. Обозначим через длину наибольшей общей подпоследовательности префиксов длины и длины . Полный ответ по длине находится в клетке .
Если хотя бы один префикс пуст, общая подпоследовательность может быть только пустой: . Эти нули дают начальные значения. Каждая следующая клетка зависит от уже посчитанных соседей сверху, слева и по диагонали сверху слева. Поэтому таблицу удобно заполнять сверху вниз и слева направо.
Здесь проявляется приём динамического программирования: большая задача разбивается на повторяющиеся подзадачи, а их ответы сохраняются. Без запоминания наивная рекурсия многократно решает одни и те же задачи для одинаковых пар префиксов.
На обратном ходе видео шаги показаны в обратном порядке, чтобы цикл начинался и заканчивался в одной клетке. Рабочий алгоритм восстановления идёт от правого нижнего угла к левому верхнему.
Рекуррентная формула
Обозначим последние символы рассматриваемых префиксов через и , нумеруя символы с единицы. Тогда при :
Если последние символы равны, одну оптимальную подпоследовательность можно закончить этим общим символом. До него остаются два укороченных префикса, так что берём диагональную клетку и прибавляем единицу. Если символы различны, оба одновременно завершать общую подпоследовательность не могут. Достаточно сравнить два варианта: пропустить последний символ первой строки или последней второй. Большая из полученных длин и есть ответ.
Равенство соседних значений во втором случае не означает ошибку. Два направления могут вести к разным оптимальным ответам. Для вычисления длины достаточно выбрать любое из них; для перечисления всех ответов нужно изучать обе ветви и устранять повторы.
Пример: «КОТ» и «КРОТ»
Поместим «КОТ» по строкам, «КРОТ» по столбцам. Символ обозначает пустой префикс. Получается таблица:
| Префикс A / префикс B | ∅ | К | КР | КРО | КРОТ |
|---|---|---|---|---|---|
| ∅ | 0 | 0 | 0 | 0 | 0 |
| К | 0 | 1 | 1 | 1 | 1 |
| КО | 0 | 1 | 1 | 2 | 2 |
| КОТ | 0 | 1 | 1 | 2 | 3 |
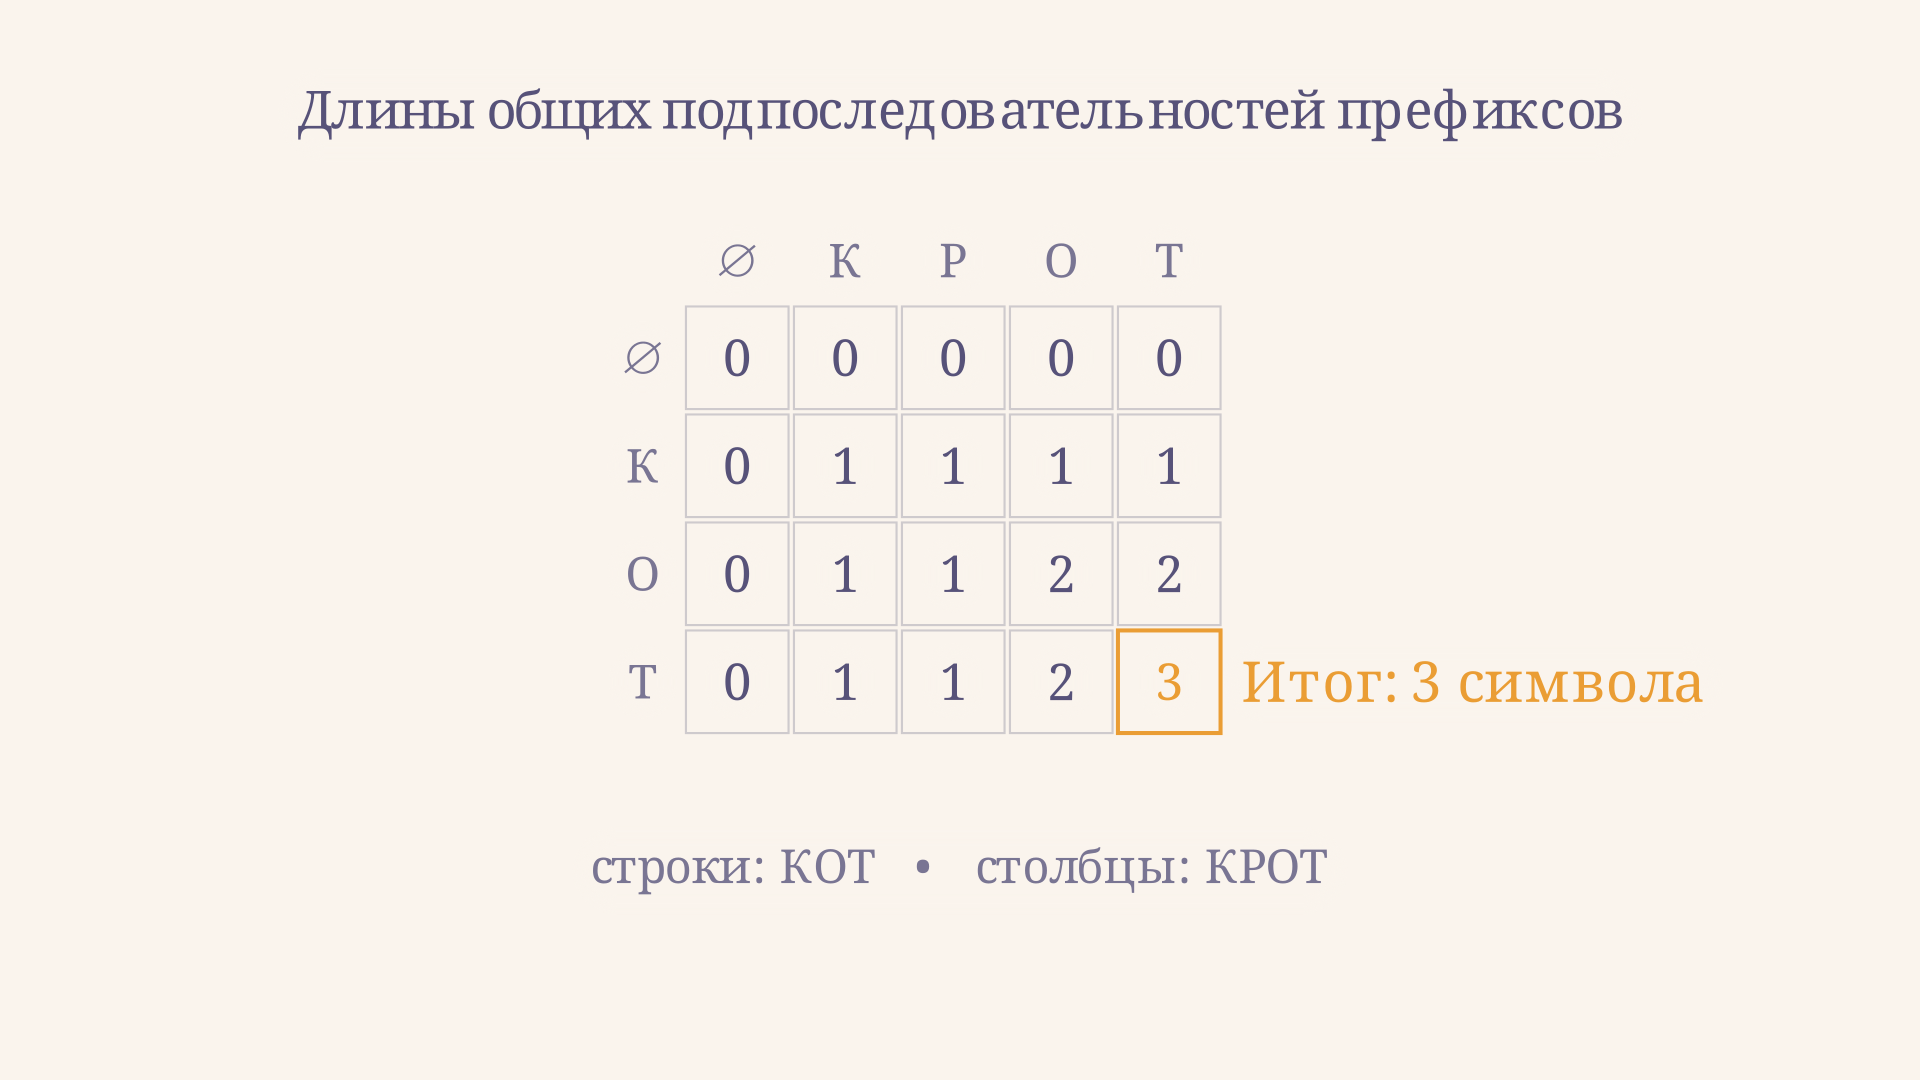
В клетке для «К» и «К» символы совпадают: диагональный ноль превращается в единицу. Для «КО» и «КР» последние символы различны, поэтому максимум верхней и левой клеток равен 1. Затем «О» совпадает с «О»: диагональная единица даёт 2. Наконец, совпадение «Т» с «Т» увеличивает диагональную двойку до 3.
Ответ не может быть длиннее трёх: первая строка состоит только из трёх символов. Мы уже нашли общую последовательность длины 3, значит, она оптимальна. В более сложном примере оптимальность обеспечивает заполненная таблица, даже когда простой верхней границы недостаточно.
Как восстановить сами символы
Число в последней клетке сообщает длину, но не выписывает последовательность. Начните с , и идите к границе таблицы. При равенстве символов запишите этот символ и перейдите по диагонали к . При несовпадении перейдите к большему из соседей сверху и слева; при равенстве выберите любой. Остановитесь, когда один индекс станет нулём, и переверните записанные символы: они собирались с конца.
Для нашего примера сначала совпадают последние «Т», затем «О». На паре префиксов «К» и «КР» символы различаются, и шаг влево пропускает «Р». После совпадения «К» получаем в обратном порядке «ТОК»; разворот даёт «КОТ». Позиции совпадений - 1, 2, 3 в первом слове и 1, 3, 4 во втором. Порядок строго возрастает в каждой строке.
В калькуляторе при равных соседях выбран переход вверх. Это правило делает результат воспроизводимым, но другой допустимый выбор тоже может дать оптимальную последовательность той же длины.
Убедиться в корректности конкретного ответа можно независимо от таблицы. Сначала выпишите индексы выбранных символов в первой строке, затем - во второй. В каждом списке индексы должны строго возрастать, а соответствующие символы совпадать. Так проверяется допустимость, но не максимальность: для неё требуется также доказать, что более длинного ответа нет, например с помощью итоговой клетки таблицы.
При повторяющихся символах одна и та же последовательность может получаться разными наборами позиций. Это ещё одно различие между подсчётом ответов и подсчётом способов их выбрать. Если задача просит все различные последовательности, повторяющиеся результаты из разных путей восстановления следует объединять.
Реализация и оценка сложности
Вот компактный вариант на Python. Он возвращает длину и один ответ; строки можно заменить списками сопоставимых элементов.
def lcs(a, b):
    m, n = len(a), len(b)
    d = [[0] * (n + 1) for _ in range(m + 1)]
    for i in range(1, m + 1):
        for j in range(1, n + 1):
            if a[i - 1] == b[j - 1]:
                d[i][j] = d[i - 1][j - 1] + 1
            else:
                d[i][j] = max(d[i - 1][j], d[i][j - 1])

    i, j, answer = m, n, []
    while i > 0 and j > 0:
        if a[i - 1] == b[j - 1]:
            answer.append(a[i - 1])
            i -= 1
            j -= 1
        elif d[i - 1][j] >= d[i][j - 1]:
            i -= 1
        else:
            j -= 1
    return d[m][n], answer[::-1]
В таблице клеток, а заполнение каждой внутренней клетки занимает постоянное время при постоянной стоимости сравнения элементов. Время - , что для непустых входов записывают как ; память полной таблицы - . Обратный проход занимает не более шагов, а сам ответ хранит до элементов.
Если нужна только длина, достаточно хранить предыдущую и текущую строки таблицы. Разместив более короткую последовательность по столбцам, можно сократить рабочую память до . Однако обычный обратный проход по полной таблице тогда недоступен: для восстановления придётся хранить дополнительную информацию или пересчитывать подзадачи. В лекции MIT о LCS та же идея изложена через подзадачи для суффиксов; выбор префиксов меняет направление обхода, но не суть.
Где применяется сравнение последовательностей
В сравнении версий текста общая подпоследовательность строк или символов помогает выделить сохранившиеся части. Если разрешены только вставки и удаления отдельных элементов, минимальное число таких операций для перехода от к равно , где - длина НОП. Для «КОТ» и «КРОТ» это : достаточно вставить «Р». При разрешённых заменах за одну операцию эта формула уже не описывает обычное расстояние редактирования.
В биоинформатике последовательности могут состоять из нуклеотидов или аминокислот; НОП служит одной из простых моделей сходства. Реальное выравнивание часто требует весов замен и штрафов за пропуски, которых в базовой постановке нет. Аналогично в задачах на палиндром строки важно сначала точно определить допустимые операции, а затем выбирать подходящий алгоритм.
Наконец, НОП отличается от поиска точного образца: алгоритм Рабина - Карпа сравнивает непрерывные фрагменты с помощью хеширования. Одинаковое слово «строка» в постановках не делает эти задачи взаимозаменяемыми.
Частые ошибки
- Запрещать пропуски. Тогда решается задача об общей подстроке, а не подпоследовательности.
- Переставлять символы. Общий набор букв ещё не гарантирует общего порядка.
- Считать совпадения по диагонали независимо от таблицы. Нужно брать длину для соответствующих предыдущих префиксов и прибавлять единицу.
- Ожидать единственного ответа. При равных вариантах могут существовать разные оптимальные цепочки.
- Читать записанные при восстановлении буквы сразу. Обход с конца выдаёт их в обратном порядке.
FAQ
Что будет, если общих символов нет?
Все значения таблицы останутся нулями, длина ответа равна нулю, а сама общая подпоследовательность пуста.
Можно ли применять алгоритм к числам?
Да. Элементами могут быть числа, слова или другие объекты, если определено их сравнение на равенство. Порядок элементов по-прежнему нужно сохранять.
Сколько существует оптимальных ответов?
Это зависит от входа: возможен один ответ или несколько. Таблица длин и описанный обратный проход находят один; перечисление всех требует дополнительных ветвлений и может породить очень много результатов.
Коротко
НОП сохраняет порядок элементов и допускает пропуски. Таблица динамического программирования находит оптимальную длину по парам префиксов, а обратный проход восстанавливает один ответ. Для «КОТ» и «КРОТ» длина равна 3, а ответ - «КОТ».
Читайте также
Числа трибоначчи: формула и примеры вычисления
Числа трибоначчи: три начальных значения, рекуррентная формула и расчёт по шагам. Как последовательность считает пути по ступенькам и как написать эффективный алгоритм.
Количество путей в ориентированном графе
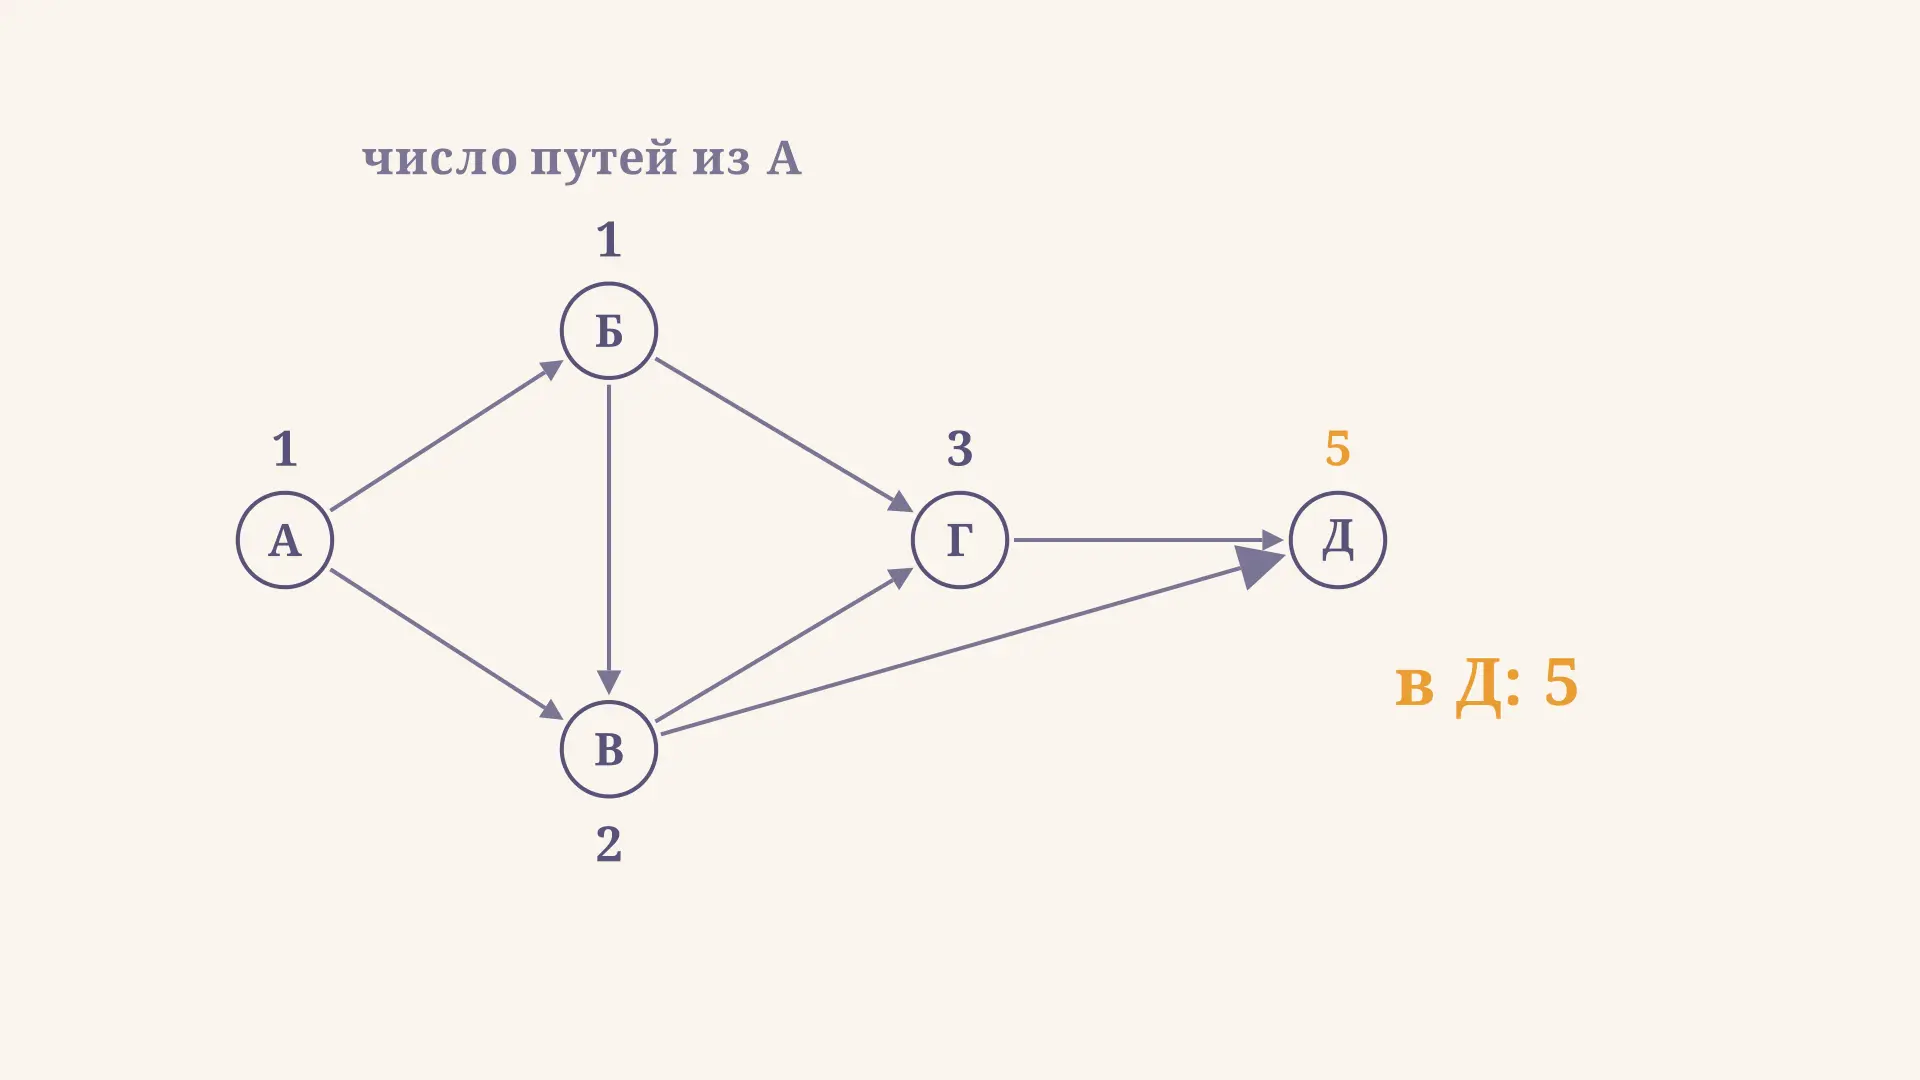
Как найти количество путей в ориентированном графе: подсчёт в DAG, динамическое программирование, матрица смежности, заданная длина и влияние циклов на ответ.
Проверка палиндрома строки: два указателя и Python
Проверка палиндрома строки двумя указателями: пошаговый пример, код на Python, сложность, обработка пробелов и регистра, граничные случаи и особенности Unicode.
Разбиение числа на слагаемые: подсчёт и алгоритм
Разбиение числа на слагаемые без учёта порядка: примеры, отличие от упорядоченных сумм, рекуррентная формула и алгоритм динамического программирования.
Задача о рюкзаке: динамическое программирование
Разбор задачи о рюкзаке (0/1 Knapsack) методом ДП: таблица dp[i][w], рекуррентный переход, traceback-восстановление набора. Пошаговые примеры и анализ сложности O(n*W).
Алгоритм Рабина-Карпа: поиск подстроки за O(n+m)
Разбираем алгоритм Рабина-Карпа: как полиномиальный хеш и скользящее окно ускоряют поиск подстроки до O(n+m) в среднем, почему бывают ложные совпадения и при чём тут плагиат.